برآورد بیشترین درستنمایی (MLE)
محمود امینطوسی، پاییز ۱۴۰۵
گروه علوم کامپیوتر، دانشگاه فردوسی مشهد
تعریفها و شکل این صفحه از فصل 3 کتاب Pattern Classification نوشتهٔ دودا، هارت و استورک (Duda et al. (2000)) گرفته شده است. برآوردهایی که اینجا استنتاج میشوند همانهایی هستند که صفحهٔ نظریهٔ تصمیم بیزی به کار میبرد، جایی که چگالیهای شرطی-دسته شناختهشده فرض میشوند.
هدفهای یادگیری. در پایان باید بتوانید
درستنمایی و لگاریتم درستنمایی یک نمونهٔ گاوسی را بنویسید و بگویید چرا لگاریتم میگیریم؛
برآورد MLE میانگین و واریانس یک گاوسی تکمتغیره را استنتاج کنید؛
برآورد MLE بردار میانگین و ماتریس کوواریانس یک گاوسی چندمتغیره را استنتاج کنید؛
بگویید این برآوردها به چه معنا اریبدارند و برآورد کوواریانس چه زمانی حتی تعریف نمیشود؛
توضیح دهید برآوردها چگونه در قاعدهٔ تصمیم بیز جای میگیرند و این کار چگونه LDA و QDA میدهد.
1. مقدمه
در دستهبندی آماری الگو، فرض رایج این است که داده با توزیع احتمالاتی زیربنایی با پارامترهای ناشناخته تولید میشود. مثلاً شاید فرض کنیم ویژگی از توزیع گاوسی (نرمال) پیروی میکند. برای گرفتن تصمیم بهینه (مثلاً دستهبندی با نظریهٔ تصمیم بیز)، باید پارامترهای این توزیعها را از مجموعهدادهٔ آموزش برآورد کنیم.
برآورد بیشترین درستنمایی (MLE) روشی پارامتری و استاندارد برای برآورد پارامترهای ناشناختهٔ در تابع چگالی احتمال با داشتن مجموعهدادهٔ است. اصل کار انتخاب مقدارهای پارامتری است که دادهٔ مشاهدهشده را محتملترین میکند.
2. تابع درستنمایی
تابع درستنمایی، که با نشان داده میشود، احتمال مشاهدهٔ مجموعهدادهٔ مشخص را بهعنوان تابعی از پارامترهای نشان میدهد.
تفاوت کلیدی: تمایز میان تابع چگالی احتمال و تابع درستنمایی بنیادی است:
: توزیع دادهٔ برای پارامترهای ثابت را توصیف میکند.
: احتمال مجموعهدادهٔ برای دادهٔ مشاهدهشدهٔ ثابت را، بهعنوان تابعی از ، توصیف میکند.
درستنمایی تابعی از است که روی فضای پارامتر تعریف میشود؛ چگالی تابعی از است که روی فضای ویژگی تعریف میشود. به گفتهٔ دودا، هارت و استورک، شکل تابعی درستنمایی لزوماً همان شکل تابعی چگالی نیست.
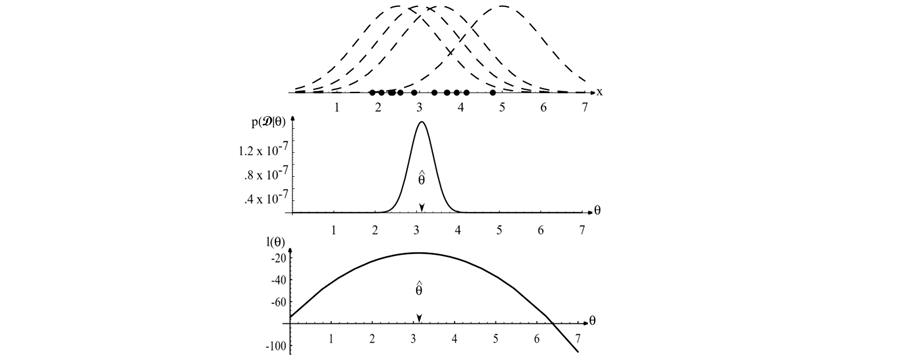
شکل 3.1: نمودار بالا چند نقطهٔ آموزش در یک بُعد را نشان میدهد که معلوم یا فرض شده از گاوسی با واریانس مشخص ولی میانگین ناشناخته گرفته شدهاند. چهار توزیع از بینهایت توزیع مبدأ ممکن با خطچین نشان داده شدهاند. شکل میانی درستنمایی را بهعنوان تابعی از میانگین نشان میدهد. اگر تعداد نقطههای آموزش بسیار زیاد بود، این درستنمایی بسیار باریک میشد. مقداری که درستنمایی را بیشینه میکند با نشان داده شده؛ همان مقدار لگاریتم درستنمایی — یعنی که پایین نشان داده شده — را هم بیشینه میکند. بهویژه توجه کنید درستنمایی در فضایی متفاوت از قرار دارد و این دو میتوانند شکل تابعی متفاوت داشته باشند.
3. استنتاج ریاضی: گاوسی تکمتغیره
با سادهترین حالت شروع میکنیم: برآورد پارامترهای یک توزیع گاوسی تکمتغیره. این کار بنیاد فهم حالت چندمتغیرهای است که در دستهبندی الگو به کار میرود.
3.1 تعریف مسئله
مجموعهدادهای شامل نمونهٔ مستقل و همتوزیع (i.i.d.) باشد. فرض میکنیم هر نمونه از توزیع گاوسی تکمتغیره گرفته شده است:
که:
میانگین (پارامتر مکان) است.
واریانس (پارامتر مقیاس) است.
3.2 تابع درستنمایی
تابع درستنمایی چگالی احتمال مشترک دادهٔ مشاهدهشده است، با فرض استقلال:
3.3 تابع لگاریتم درستنمایی
بیشینه کردن مستقیم بهدلیل ضرب نماییها از نظر محاسباتی سخت است. چون لگاریتم تابعی اکیداً یکنوا است، بیشینه کردن لگاریتم درستنمایی همان برآوردهای پارامتری را میدهد که بیشینه کردن درستنمایی.
3.4 برآورد میانگین ()
برای یافتن برآورد بیشترین درستنمایی ، مشتق جزئی نسبت به را میگیریم و صفر میگذاریم:
با حل برای :
نتیجه: برآورد MLE میانگین همان میانگین نمونه است.
3.5 برآورد واریانس ()
برای یافتن ، مشتق جزئی نسبت به را میگیریم. برای مشتقگیری سادهتر بگذارید :
با ضرب در :
با جایگذاری بهجای و :
نتیجه: MLE بر تقسیم میکند، نه بر . پس نسخهٔ اریب واریانس نمونه است؛ برآوردگر نااریب است (بخش 5).
4. گسترش به گاوسی چندمتغیره
در دستهبندی الگو، ویژگیها معمولاً بردارهای هستند. استنتاج تکمتغیره طبیعتاً به توزیع گاوسی چندمتغیره گسترش مییابد.
4.1 تابع چگالی
4.2 برآوردهای MLE
لگاریتم درستنمایی نسخهٔ برداری بیان بخش 3.3 است:
چون متقارن است و چون ، دو مشتق چنیناند
معادلهٔ اول بردار میانگین را میدهد و جایگذاریاش در دومی ماتریس کوواریانس را:
بردار میانگین ():
برآورد MLE همان بردار میانگین نمونه است.
ماتریس کوواریانس ():
برآورد MLE همان ماتریس کوواریانس نمونه است، باز هم با مخرج .
4.3 وقتی برآورد وجود ندارد
مجموع بالا ماتریسی است که از ضرب خارجی ساخته میشود، پس . اگر ، یا اگر دو ویژگی دقیقاً همخط باشند، تکین است و وجود ندارد: چگالی گاوسی، فاصلهٔ ماهالانوبیس و QDA همه تعریفنشده میشوند. دو چارهٔ استاندارد هست:
نخست بُعد را کم کنید (PCA، گزینش ویژگی)؛
برآورد را تنظیم کنید، با ، که همان کاری است «shrinkage» و پیادهسازی LDA در Scikit-Learn میکنند.
5. ویژگیها و محدودیتها
هرچند MLE ابزاری توانمند است، دودا، هارت و استورک چند ویژگی مهم این برآوردها را برجسته میکنند، بهویژه در بافت دستهبندی:
اریبی:
برآورد میانگین نااریب است.
برآورد واریانس (و ) اریب است. بهطور سیستماتیک واریانس واقعی را کمبرآورد میکند چون در مخرج از بهجای استفاده میکند.
برآوردگر نااریب: . ولی برای بزرگ تفاوت ناچیز است.
سازگاری:
با رفتن تعداد نمونهها ، برآوردهای MLE به مقدارهای واقعی پارامتر همگرا میشوند.
ناوردایی:
اگر برآورد MLE برای باشد، آنگاه برای هر تابع ، برآورد MLE برای برابر است.
حساسیت به دادههای پرت:
چون MLE فرض میکند داده از توزیع مشخصی (مثلاً گاوسی) پیروی میکند، دادههای پرت میتوانند برآورد میانگین و کوواریانس را بهشدت کج کنند و کارایی دستهبندی را کاهش دهند.
6. پیوند با دستهبندی بیزی
نقش اصلی MLE در این درس ممکن کردن دستهبندی بیزی وقتی پارامترها ناشناختهاند است.
6.1 رویکرد «جایگذاری»
آموزش: برای هر دستهٔ ، از دادهٔ آموزش برآوردهای MLE و را حساب کنید.
ساخت: چگالی شرطی-دستهٔ برآوردشده را بسازید: .
تصمیم: قاعدهٔ تصمیم بیز را با این چگالیهای برآوردشده اعمال کنید.
این را دستهبند جایگذاریشده (Plug-In Classifier) مینامند. با جایگذاری بهترین برآورد پارامترها، دستهبند بیز بهینه را تقریب میزند.
6.2 اثر بر مرزهای تصمیم
برآوردهای MLE هندسهٔ دستهبند را تعیین میکنند:
تحلیل تفکیکگر خطی (LDA): فرض میکند همهٔ دستهها کوواریانس مشترک دارند. مرز تصمیم خطی (ابرصفحه) میشود.
تحلیل تفکیکگر درجهدوم (QDA): فرض میکند دستهها کوواریانسهای یکتا دارند. مرز تصمیم سطحی درجهدوم میشود (در دو بُعد بیضی، هذلولی یا سهمی، و در حالت کلی ابرسطح درجهدوم).
7. پلی به موضوعهای پیشرفته
MLE به دستهبندی سادهٔ گاوسی محدود نیست. موتور بنیادی بسیاری از مدلهای پیشرفتهای است که بعداً میبینیم:
تحلیل مؤلفههای اصلی (PCA): میتوان آن را بهعنوان مسئلهٔ بیشترین درستنمایی برای مدلی گاوسی با قید (یافتن جهتهای بیشترین واریانس) استنتاج کرد.
مدلهای مخلوط گاوسی (GMM): گاوسیهای تکتایی را به مخلوطها گسترش میدهند. از MLE استفاده میشود، ولی برای حل تکراری به الگوریتم EM (امید-بیشینهسازی) نیاز دارد.
مدلهای مارکوف پنهان (HMM): پارامترها (احتمالهای گذار و تولید) با MLE و الگوریتم بام-ولش برآورد میشوند؛ گونهای EM که با بازگشتهای پسرو-پیشرو شمارشهای امیدریاضی را حساب میکند.
8. جمعبندی
روش برآورد بیشترین درستنمایی رویکردی اصولی برای یادگیری پارامترهای مدلهای احتمالاتی در یادگیری ماشین میدهد.
نکتههای کلیدی
درستنمایی در برابر احتمال: درستنمایی داده را بهشرط پارامترها بیشینه میکنیم، نه احتمال پارامترها را بهشرط داده.
لگاریتم درستنمایی: رفتن به دامنهٔ لگاریتمی ضربها را به جمع تبدیل میکند و بهینهسازی را سادهتر.
نتایج تکمتغیره:
، میانگین نمونه (نااریب)؛
، برآورد اریب واریانس (واریانس نمونهٔ نااریب بر تقسیم میکند).
ارتباط با دستهبندی: این برآوردها بلوکهای سازندهٔ تحلیل تفکیکگر خطی (LDA) و دیگر دستهبندهای گاوسیاند که بعداً در درس میبینیم.
منابع
Duda et al. (2000)
Duda, R. O., Hart, P. E., & Stork, D. G. (2000). Pattern Classification (2nd ed.). Wiley-Interscience, chapter 3.
- Duda, R. O., Hart, P. E., & Stork, D. G. (2000). Pattern Classification (2nd ed.). Wiley-Interscience.