دستهبندی Naive Bayes
محمود امینطوسی، پاییز ۱۴۰۵
گروه علوم کامپیوتر، دانشگاه فردوسی مشهد
قاعدهٔ تصمیم از فصل 2 کتاب Pattern Classification نوشتهٔ دودا، هارت و استورک (Duda et al. (2000)) گرفته شده است؛ مثال حشره از مجموعهٔ اسلایدهای ایمون کیوگ است. بخشهای گاوسی و چندجملهای از وندرفلاس (VanderPlas (2016)) پیروی میکنند.
هدفهای یادگیری. در پایان باید بتوانید
قضیهٔ بیز را برای یک مسئلهٔ دستهبندی بنویسید و چهار جملهاش را نام ببرید؛
یک شیء را از بافتنگار یک ویژگی دستهبندی کنید؛
فرض سادهکننده را اعمال کنید و پسین را از چند ویژگی گسسته حساب کنید؛
توضیح دهید یک شمارش صفر با ضرب چه میکند و آن را با هموارسازی لاپلاس درست کنید؛
دستهبند Naive Bayes گاوسی و چندجملهای را با Scikit-Learn برازش دهید و بخوانید؛
بگویید Naive Bayes چه زمانی خط پایهٔ خوبی است و فرض استقلالش چه زمانی میشکند.
قضیهٔ بیز
قضیهٔ بیز اصل بنیادی در نظریهٔ احتمال است که توضیح میدهد باورهایمان دربارهٔ یک رخداد را بر پایهٔ شواهد تازه چگونه بهروز کنیم. چارچوب ریاضی برای محاسبهٔ احتمالهای شرطی میدهد، بهویژه احتمال وقوع رخدادی بهشرط آنکه رخداد دیگری پیشتر رخ داده باشد. این قضیه به نام کشیش توماس بیز نامگذاری شده که نخستین بار این اصل را در قرن 18 صورتبندی کرد.
توماس بیز 1702 - 1761
فرمول ریاضی قضیهٔ بیز چنین بیان میشود:
که:
احتمال پسین است: احتمال وقوع رخداد A بهشرط درست بودن B
درستنمایی است: احتمال وقوع رخداد B بهشرط درست بودن A
احتمال پیشین است: احتمال اولیهٔ رخداد A
احتمال حاشیهای است: احتمال کل وقوع رخداد B
مثال با تاس
فرض کنید دو تاس داریم: یک تاس سالم (با احتمال برابر برای 1 تا 6) و یک تاس تقلبی که همیشه 6 میآید. تصادفی یکی را برمیگزینیم و میاندازیم، 6 میآید. احتمال اینکه تاس تقلبی را برگزیده باشیم چقدر است؟
رخدادها را تعریف میکنیم:
رخداد A: برگزیدن تاس تقلبی
رخداد B: آمدن 6
دادهها:
(شانس برابر برای برگزیدن هر تاس)
(تاس تقلبی همیشه 6 میآید)
(تاس سالم با احتمال 1/6 شش میآید)
با اعمال قضیهٔ بیز:
پس بهشرط آمدن 6، احتمال (تقریباً 85.7 درصد) هست که تاس تقلبی را برگزیده باشیم.
دستهبندهای بیزی
قضیهٔ بیز مدلی از داده را به قاعدهٔ تصمیم تبدیل میکند. برای دستهٔ و بردار ویژگی مشاهدهشدهٔ ،
پیشین است: دسته پیش از دیدن شیء چقدر فراوان است.
درستنمایی یا چگالی شرطی-دسته است: شیء برای آن دسته چقدر معمول است.
پسین است.
شاهد است. برای همهٔ دستهها یکسان است، پس فقط پسینها را مقیاس میدهد تا جمعشان یک شود و در تصمیم نقشی ندارد.
برای دو دسته شاهد حذف میشود و تصمیم به ضرب درستنمایی و پیشین بستگی دارد:
که همان قاعدهٔ تصمیم کمینهخطا است. نام Naive Bayes — و همچنین idiot Bayes یا simple Bayes — به کل خانوادهٔ دستهبندهای ساختهشده بر این قاعده اشاره دارد. ایده در یک جمله: احتمال شیء دیدهنشده را برای هر دسته بیاب، بعد بزرگترین را برگزین.
اسلایدهای دو بخش بعد بهجای دسته و بهجای شیء مشاهدهشده مینویسند؛ اینجا مثل صفحهٔ نظریهٔ تصمیم بیزی از و استفاده میکنیم.
مثالی دیداری: ملخها و کاتیدیدها
از ایمون کیوگ، علوم کامپیوتر، UCR.
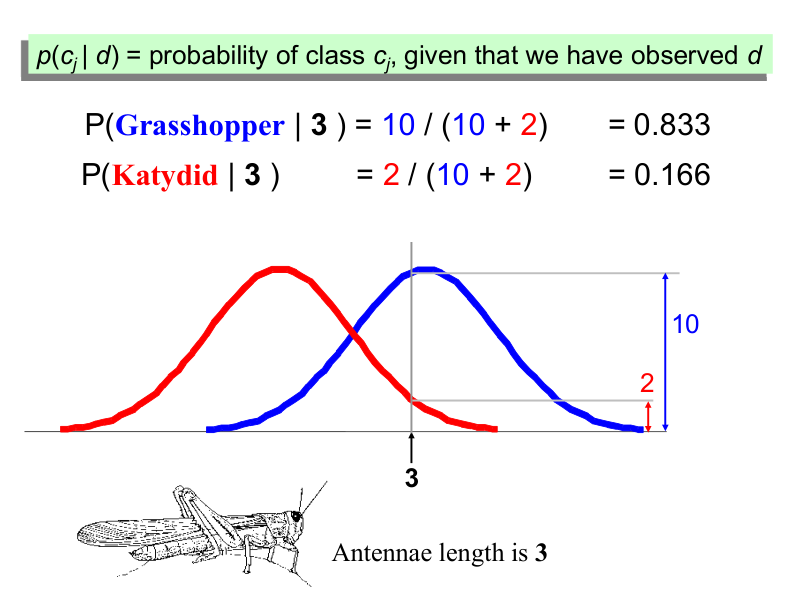
دو گونه داریم، ملخ و کاتیدید، و یک ویژگی: طول شاخک. با دادهٔ کافی میتوانیم برای هر گونه یک بافتنگار از طول شاخک بسازیم.
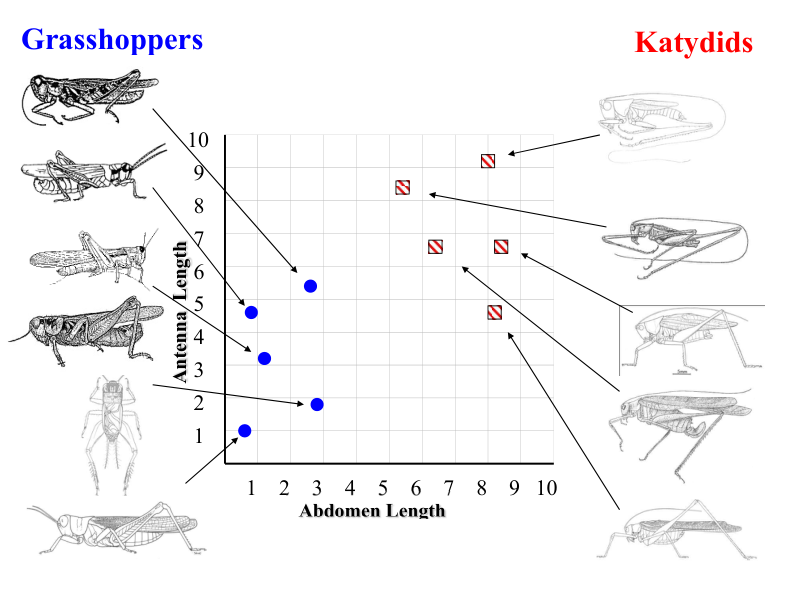
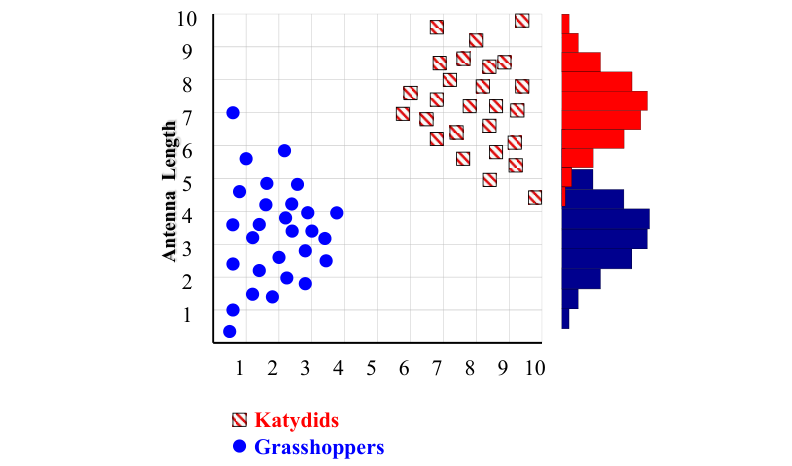
دستهبندی یک حشره
حشرهای میگیریم که شاخکش 3 واحد است. به احتمال بیشتر از کدام گونه است؟
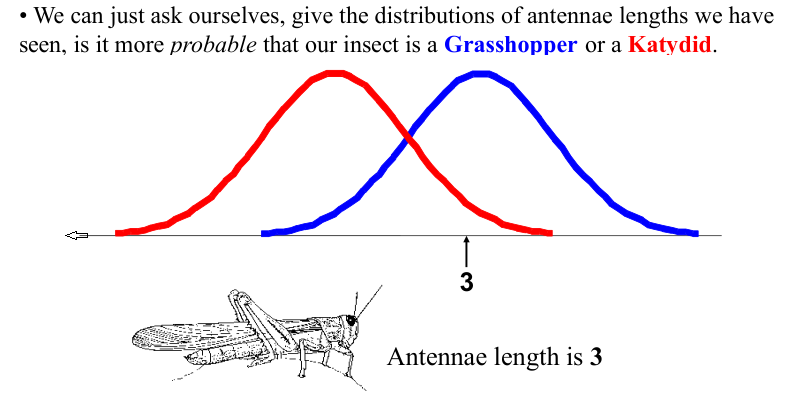
بهطور رسمی برای هر دسته احتمال شرطی
را میخواهیم و دو مقدار را با هم مقایسه میکنیم.
خواندن بافتنگار
با شمردن حشرههای بافتنگار در طول شاخک 3:
همین خواندن در طول شاخک 7 و 5:
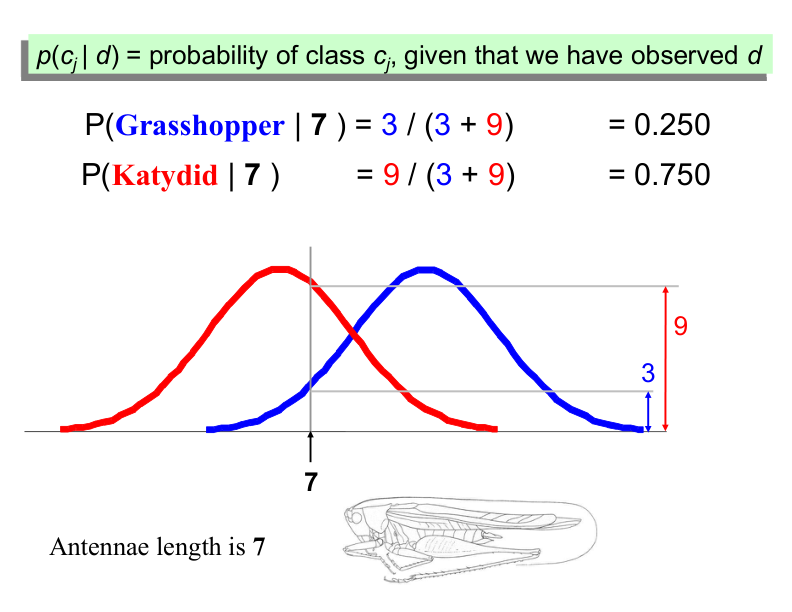
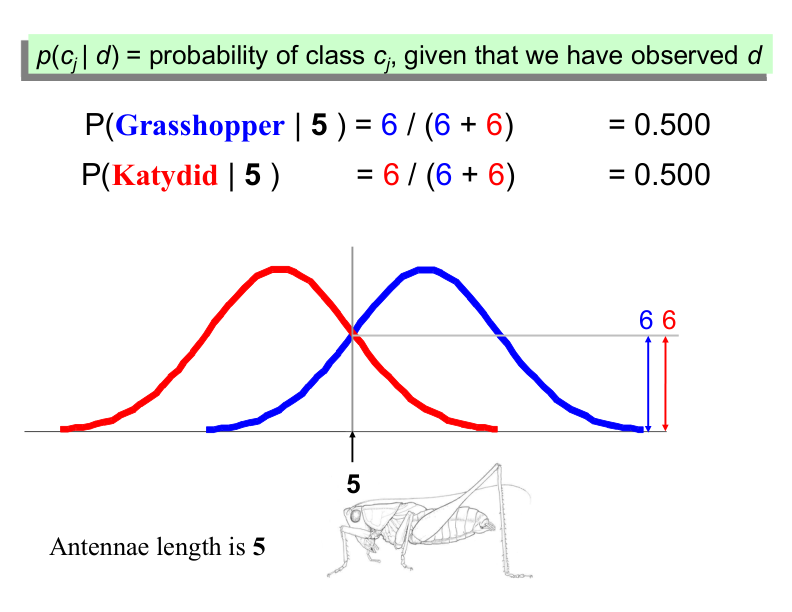
در 3 حشره ملخ است، در 7 کاتیدید، و در 5 دو دسته هماحتمالاند: جایی است که تصمیم برمیگردد. این نسبتها پسیناند چون دو شمارش در دادهشده بر مجموعشان تقسیم شدهاند، که همان شاهد بخش پیشین است.
مثال: دستهبندی بر پایهٔ نام
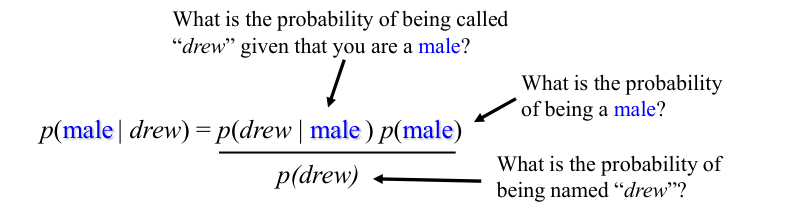
دو دسته، و ، و یک ویژگی گسسته: نام کوچک. با شخصی به نام Drew روبهرو میشویم و میپرسیم کدام پسین بزرگتر است، یا . کل پایگاه دادهٔ نام و جنسیت ما چنین است:
| نام | جنسیت |
|---|---|
| Drew | Male |
| Claudia | Female |
| Drew | Female |
| Drew | Female |
| Alberto | Male |
| Karin | Female |
| Nina | Female |
| Sergio | Male |
محاسبهٔ پسینها
از جدول، و ، و درون هر دسته
شاهد برای دو دسته یکسان است، پس مقایسهٔ صورتها کافی است:
تصمیم کمینهخطا برای Drew female است ().
چند ویژگی و فرض سادهکننده
با یک ویژگی میتوانستیم پسینها را از بافتنگار بخوانیم. با ویژگی، چگالی مشترک جدولی روی همهٔ ترکیبهای مقدارهای ویژگی است و آن جدول بهطور نمایی با رشد میکند. فرض Naive Bayes این است که ویژگیها بهشرط دسته مستقل شرطیاند:
پس قاعدهٔ تصمیم فقط به توزیع یکبعدی برای هر دسته نیاز دارد:
این فرض تقریباً هیچوقت درست نیست — در یک جمله واژهها آشکارا مستقل نیستند — ولی تعداد پارامترها را خطی در نگه میدارد و معمولاً حتی وقتی احتمالها بد برآورد میشوند رتبهبندی سودمندی از دستهها میدهد.
مثال حلشده: Drew با سه ویژگی
| نام | بالای 170 سانتیمتر | چشم | مو | جنسیت |
|---|---|---|---|---|
| Drew | No | Blue | Short | Male |
| Claudia | Yes | Brown | Long | Female |
| Drew | No | Blue | Long | Female |
| Drew | No | Blue | Long | Female |
| Alberto | Yes | Brown | Short | Male |
| Karin | No | Blue | Long | Female |
| Nina | Yes | Brown | Short | Female |
| Sergio | Yes | Blue | Long | Male |
پرسوجوی را بگیرید — قدبلند، چشم قهوهای، موی بلند — و درون هر دسته بشمارید:
| مقدار ویژگی | ||
|---|---|---|
| Over 170 = Yes | ||
| Eye = Brown | ||
| Hair = Long |
با پیشینهای و دو امتیاز چنیناند
تقسیم بر مجموع پسینهای 0.42 و 0.58 را میدهد و تصمیم female است. توجه کنید حساب چه کرد: همان یک ویژگی که برای زنها بسیار محتملتر است (موی بلند، ) بر سه ویژگی که همه به نفع مردها بودند غلبه کرد.
مسئلهٔ شمارش صفر
حالا را پرسوجو کنید. میان چهار زن هیچکس موی کوتاه ندارد، پس و ضرب برای زنها دقیقاً صفر میشود، هر چه دو ویژگی دیگر بگویند. در دامنهٔ لگاریتمی این از یک احتمال کوچک بدتر است: .
چارهٔ استاندارد هموارسازی لاپلاس (افزودن یک) است،
که تعداد مقدار از ویژگی در دستهٔ را میشمارد و تعداد مقدارهایی است که آن
ویژگی میتواند بگیرد. با +1 در هر خانه هیچ درستنماییای هرگز صفر نمیشود: مقداری که هرگز دیده
نشده احتمال کوچکی میگیرد، نه وتوی کامل. پیادهسازیهای Scikit-Learn این کار را برایتان میکنند
(MultinomialNB(alpha=1))؛ برای مدل گاوسی نگهبان مشابه GaussianNB(var_smoothing=...) است.
مثال حلشده: دستهبندی میوه
برگرفته از این پاسخ Stack Overflow. مجموعهٔ آموزش 1000 میوه، سه ویژگی دودویی (بلند، شیرین، زرد) و سه دسته دارد:
| نوع | بلند | نه بلند | شیرین | نه شیرین | زرد | نه زرد | کل |
|---|---|---|---|---|---|---|---|
| Banana | 400 | 100 | 350 | 150 | 450 | 50 | 500 |
| Orange | 0 | 300 | 150 | 150 | 300 | 0 | 300 |
| Other fruit | 100 | 100 | 150 | 50 | 50 | 150 | 200 |
| کل | 500 | 500 | 650 | 350 | 800 | 200 | 1000 |
پیشینها و درستنماییها
پیشینها همان کل دستهها هستند: ، و . تقسیم هر خانه بر کل سطرش درستنماییها را میدهد:
| مقدار ویژگی | Banana | Orange | Other fruit |
|---|---|---|---|
| Long | 0.80 | 0.00 | 0.50 |
| Sweet | 0.70 | 0.50 | 0.75 |
| Yellow | 0.90 | 1.00 | 0.25 |
کل ستونهای جدول آموزش — 500 بلند، 650 شیرین، 800 زرد — حاشیههای ویژگیاند. برای تصمیم لازم نیستند، چون شاهد برای سه دسته یکسان است و در مقایسه حذف میشود.
دستهبندی یک میوه
میوهٔ تازهای بلند، شیرین و زرد است. ضرب پیشین در درستنماییها:
| دسته | |
|---|---|
| Banana | |
| Orange | |
| Other fruit |
اینها امتیازهای نرمالنشدهاند: متناسب با پسینها با عامل مشترک . تقسیم بر مجموعشان، ، پسینها را میدهد
و تصمیم موز است.
چرا صفر مهم است
ستون پرتقال دو صفر دارد و اینها ساختاریاند نه تصادفی: هیچ پرتقالی بلند نیست و هیچ پرتقالی غیرزرد نیست. بهمحض اینکه پرسوجو یکی از آن مقدارها را داشته باشد امتیاز پرتقال دقیقاً صفر میشود و هیچ شاهدی از دو ویژگی دیگر نمیتواند زندهاش کند. هموارسازی افزودن یک از بخش پیشین 0 را با جایگزین میکند و دسته را زنده نگه میدارد. همین ضرب معمولاً بهصورت مجموع لگاریتمها حساب میشود،
که از سرریز زیرین (underflow) هنگام ضرب احتمالهای کوچک زیاد هم جلوگیری میکند.
Naive Bayes گاوسی
Naive Bayes گاوسی هر ویژگی را درون هر دسته نرمالتوزیع میگیرد، . پارامترها یک میانگین و یک واریانس برای هر ویژگی در هر دستهاند و آموزش فقط همین دو پارامتر گاوسی را حساب میکند. همین مدل هرویژگی جایی است که فرض سادهکننده مینشیند: چگالی شرطی-دسته جملهٔ کوواریانس ندارد، پس بیضیهایش همراستا با محورها هستند.
شکل زیر چنین مدلی را روی دو خوشهٔ داده نشان میدهد: یک بیضی برای هر دسته، با بیشترین احتمال در مرکز دسته.
%matplotlib inline
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
plt.style.use('seaborn-v0_8-whitegrid')  # the old 'seaborn-whitegrid' name was removed in Matplotlib 3.6;
from sklearn.datasets import make_blobs
X, y = make_blobs(100, 2, centers=2, random_state=2, cluster_std=1.5)
plt.scatter(X[:, 0], X[:, 1], c=y, s=50, cmap='RdBu');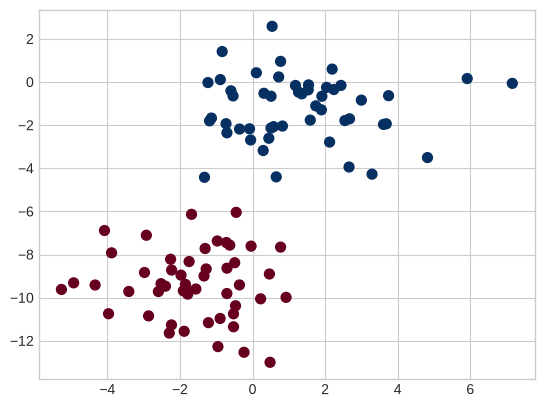
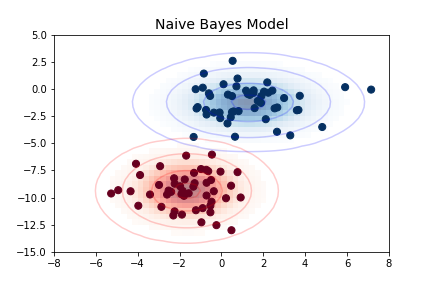
نسخهٔ ثابت شکل VanderPlas (2016)؛ سلولهای بالا آن را بازتولید میکنند.
بیضیهای اینجا مدل مولد گاوسی هر برچسب را نشان میدهند، با احتمال بیشتر بهسمت مرکز بیضیها. با این مدل مولد برای هر دسته، دستور سادهای برای حساب کردن درستنمایی برای هر نقطهٔ داده داریم و میتوانیم سریع نسبت پسین را حساب کنیم و بفهمیم کدام برچسب برای نقطهٔ دادهشده محتملترین است.
این رویه در برآوردگر sklearn.naive_bayes.GaussianNB در Scikit-Learn پیاده شده است:
from sklearn.naive_bayes import GaussianNB
model = GaussianNB()
model.fit(X, y);
دادهٔ تازهای تولید کنیم و برچسب را پیشبینی کنیم:
rng = np.random.RandomState(0)
Xnew = [-6, -14] + [14, 18] * rng.rand(2000, 2)
ynew = model.predict(Xnew)
اکنون میتوانیم این دادهٔ تازه را رسم کنیم و ببینیم مرز تصمیم کجا میافتد:
plt.scatter(X[:, 0], X[:, 1], c=y, s=50, cmap='RdBu')
lim = plt.axis()
plt.scatter(Xnew[:, 0], Xnew[:, 1], c=ynew, s=20, cmap='RdBu', alpha=0.1)
plt.axis(lim);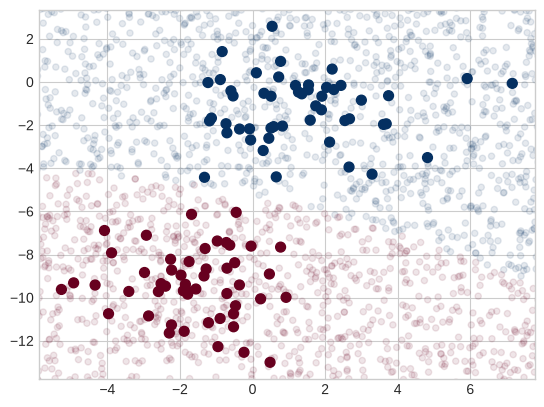
در دستهبندیها مرزی کمی منحنی میبینیم: بهطور کلی، مرزی که مدل Naive Bayes گاوسی میسازد درجهدوم است.
جنبهٔ خوب این صورتبندی این است که دستهبندی احتمالاتی هم میدهد، که با متد predict_proba
میخوانیم:
yprob = model.predict_proba(Xnew)
yprob[-8:].round(2)
array([[0.89, 0.11],
[1. , 0. ],
[1. , 0. ],
[1. , 0. ],
[1. , 0. ],
[1. , 0. ],
[0. , 1. ],
[0.15, 0.85]])ستونها بهترتیب احتمالهای پسین برچسب اول و دوم را میدهند. اگر به برآورد عدمقطعیت در دستهبندیتان نیاز دارید، رویکردهای بیزی مثل این میتوانند نقطهٔ شروع خوبی باشند.
بیشک دستهبندی نهایی فقط بهقدر فرضهای مدلی که به آن میرسد خوب است و همین دلیل است که Naive Bayes گاوسی اغلب نتیجهٔ چندان خوبی نمیدهد. با این حال در بسیاری از حالتها — بهویژه وقتی تعداد ویژگیها زیاد میشود — این فرض آنقدر زیانآور نیست که مانع روش قابلاعتماد بودن Naive Bayes گاوسی شود.
Naive Bayes چندجملهای
فرض گاوسی تنها فرض سادهٔ ممکن نیست. Naive Bayes چندجملهای هر ویژگی را از توزیع چندجملهای تولید شده میگیرد که احتمال مشاهدهٔ شمارشها در تعدادی دسته را توصیف میکند. پس وقتی ویژگیها شمارش یا نرخ شمارشاند گزینهٔ درست است — بیشتر وقتها شمارش واژهها در یک سند.
دستور تغییر نمیکند: گاوسی بهترینبرازش را با چندجملهای بهترینبرازش عوض کنید و درستنماییها را در همان قاعدهٔ تصمیم جای بگذارید.
مثال: دستهبندی متن
یکی از جاهایی که Naive Bayes چندجملهای به کار میرود دستهبندی متن است، که ویژگیها شمارش یا بسامد واژهها درون سندهاست. اینجا از ویژگیهای تُنُک شمارش واژهٔ پیکرهٔ 20 Newsgroups استفاده میکنیم که از طریق Scikit-Learn در دسترس است.
فراخوانی اول پیکره را دانلود میکند (حدود 20 مگابایت) و در ~/scikit_learn_data ذخیره میکند، پس
سلولهای زیر فقط یک بار به اتصال شبکه نیاز دارند:
from sklearn.datasets import fetch_20newsgroups

data = fetch_20newsgroups()
data.target_names
['alt.atheism',
'comp.graphics',
'comp.os.ms-windows.misc',
'comp.sys.ibm.pc.hardware',
'comp.sys.mac.hardware',
'comp.windows.x',
'misc.forsale',
'rec.autos',
'rec.motorcycles',
'rec.sport.baseball',
'rec.sport.hockey',
'sci.crypt',
'sci.electronics',
'sci.med',
'sci.space',
'soc.religion.christian',
'talk.politics.guns',
'talk.politics.mideast',
'talk.politics.misc',
'talk.religion.misc']برای سادگی اینجا فقط چند دسته از اینها را برمیگزینیم و مجموعههای آموزش و آزمون را دانلود میکنیم:
categories = ['talk.religion.misc', 'soc.religion.christian',
              'sci.space', 'comp.graphics']
train = fetch_20newsgroups(subset='train', categories=categories)
test = fetch_20newsgroups(subset='test', categories=categories)
این یک نمونهٔ نماینده از داده است:
print(train.data[5][48:])Subject: Federal Hearing
Originator: dmcgee@uluhe
Organization: School of Ocean and Earth Science and Technology
Distribution: usa
Lines: 10
Fact or rumor....? Madalyn Murray O'Hare an atheist who eliminated the
use of the bible reading and prayer in public schools 15 years ago is now
going to appear before the FCC with a petition to stop the reading of the
Gospel on the airways of America. And she is also campaigning to remove
Christmas programs, songs, etc from the public schools. If it is true
then mail to Federal Communications Commission 1919 H Street Washington DC
20054 expressing your opposition to her request. Reference Petition number
2493.
برای استفاده از این داده در یادگیری ماشین باید بتوانیم محتوای هر رشته را به برداری از عددها تبدیل کنیم. برای این کار از وکتورساز TF-IDF استفاده میکنیم و خط لولهای میسازیم که آن را به دستهبند Naive Bayes چندجملهای وصل کند:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.naive_bayes import MultinomialNB
from sklearn.pipeline import make_pipeline

model = make_pipeline(TfidfVectorizer(), MultinomialNB())
با این خط لوله میتوانیم مدل را روی دادهٔ آموزش اعمال کنیم و برچسبهای دادهٔ آزمون را پیشبینی کنیم:
model.fit(train.data, train.target)
labels = model.predict(test.data)
اکنون که برچسبهای دادهٔ آزمون را پیشبینی کردهایم، میتوانیم برآوردگر را ارزیابی کنیم. مثلاً ماتریس درهمریختگی میان برچسبهای واقعی و پیشبینیشده:
from sklearn.metrics import confusion_matrix
mat = confusion_matrix(test.target, labels)
sns.heatmap(mat.T, square=True, annot=True, fmt='d', cbar=False,
            xticklabels=train.target_names, yticklabels=train.target_names,
            cmap='Blues')
plt.xlabel('true label')
plt.ylabel('predicted label');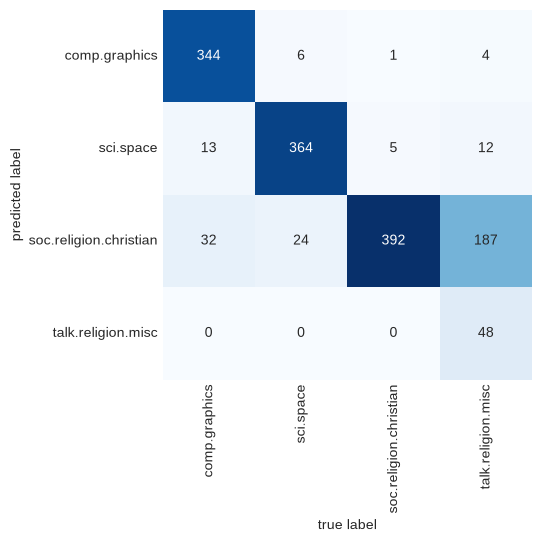
پیداست که حتی این دستهبند بسیار ساده میتواند بحثهای فضایی را از بحثهای رایانهای جدا کند، ولی میان بحثهای دین و بحثهای مسیحیت گیج میشود. که احتمالاً قابل انتظار است!
نکتهٔ جالب این است که اکنون ابزار تعیین دستهٔ هر رشتهای را با متد predict همین خط لوله داریم.
اینجا یک تابع کمکی است که پیشبینی برای یک رشتهٔ تنها را برمیگرداند:
def predict_category(s, train=train, model=model):
    pred = model.predict([s])
    return train.target_names[pred[0]]
بیایید امتحانش کنیم:
predict_category('sending a payload to the ISS')'sci.space'predict_category('discussing the existence of God')'soc.religion.christian'predict_category('determining the screen resolution')'comp.graphics'یادآوری میکنیم این چیزی پیچیدهتر از یک مدل احتمالاتی ساده برای بسامد (وزنی) هر واژه در رشته نیست؛ با این حال نتیجه خیرهکننده است. حتی الگوریتمی بسیار ساده، اگر با احتیاط به کار رود و روی مجموعهٔ بزرگی از دادهٔ پرابعاد آموزش ببیند، میتواند بهطور غافلگیرکنندهای کارآمد باشد.
Naive Bayes در برابر k-NN، و چه زمانی به کارش ببریم
k-NN و Naive Bayes هر دو دستهبندند، ولی «شباهت» را متفاوت میسازند. k-NN نزدیکی را مدل میکند — فاصلهٔ اقلیدسی یا کسینوسی — و دادهٔ آموزش را نگه میدارد؛ Naive Bayes احتمال را مدل میکند — توزیعی مولد برای هر دسته — و فقط پارامترهایش را نگه میدارد.
چون فرضهایش چنان قویاند، Naive Bayes بهندرت روی همان داده از مدلی انعطافپذیرتر بهتر میشود. در عوض اینها را میدهد:
آموزش و پیشبینی فقط یک گذر روی شمارشها یا میانگینهاست؛
خروجی یک احتمال است، نه فقط یک برچسب؛
پارامترها خواناست: میگویند کدام ویژگی به نفع کدام دسته بود؛
عملاً چیزی برای تنظیم نیست.
همین آن را خط پایهٔ اول خوبی میکند، همانطور که در Hastie et al. (2009) اشاره شده. اگر خوب عمل کند دستهبندی بسیار سریع و بسیار تفسیرپذیر دارید؛ اگر نه، نقطهٔ مرجعی دارید که میگوید یک مدل پیچیدهتر واقعاً چه چیزی میخرد. بهویژه در این حالتها خوب عمل میکند
وقتی فرض استقلال کمابیش برقرار است (کمیاب)؛
برای دستههای بهخوبی جدا، که پیچیدگی مدل کم اهمیت میشود؛
در بُعد بسیار بالا، که مدلهای انعطافپذیر به داده بسیار بیشتری از دادهٔ موجود نیاز دارند.
دو نکتهٔ آخر به هم مربوطاند: در بُعد بالا دو نقطه بهندرت نزدیک هماند، پس خوشهها دورتر از هم میافتند و مدل ساده میتواند جداشان کند.
جمعبندی
Naive Bayes با پسین دستهبندی میکند، ، و فرض سادهکننده درستنمایی را روی ویژگیها تجزیه میکند. بقیهٔ ماجرا انتخاب مدل یکبعدی است:
ویژگیهای گسسته: مقدارها را بشمارید، با هموارسازی لاپلاس؛
ویژگیهای پیوسته: یک گاوسی برای هر ویژگی در هر دسته (NB گاوسی)؛
شمارش واژهها: یک چندجملهای برای هر دسته (NB چندجملهای)، معمولاً روی ویژگیهای TF-IDF.
دو هشدار. فرض استقلال درستنمایی برآوردشدهٔ شاهد را بیش از حد کوچک میکند، پس احتمالها معمولاً بیشاعتمادند؛ رتبهبندی دستهها بسیار بهتر از عددهای چسبیده به آن است. و یک مقدار ویژگی دیدهنشده دسته را صفر میکند، مگر آنکه هموار شود.
- Duda, R. O., Hart, P. E., & Stork, D. G. (2000). Pattern Classification (2nd ed.). Wiley-Interscience.
- VanderPlas, J. (2016). Python Data Science Handbook: Essential Tools for Working with Data. O’Reilly Media. https://jakevdp.github.io/PythonDataScienceHandbook/
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: data mining, inference and prediction (2nd ed., p. 764). Springer. https://hastie.su.domains/ElemStatLearn/