فاصلهٔ ماهالانوبیس
محمود امینطوسی، پاییز ۱۴۰۵
گروه علوم کامپیوتر، دانشگاه فردوسی مشهد
مطالب کوواریانس از فصل 2 کتاب Pattern Classification نوشتهٔ دودا، هارت و استورک (Duda et al. (2000)) پیروی میکند و از نشانهگذاری همان کتاب استفاده میکنیم؛ توضیحهای هندسی از Vision Dummy و از نوشتهٔ SAS دربارهٔ فاصلهٔ ماهالانوبیس برگرفته شدهاند.
هدفهای یادگیری. در پایان باید بتوانید
بگویید چرا فاصلهٔ اقلیدسی وقتی ویژگیها واحدهای مختلف دارند یا همبستهاند شکست میخورد؛
ماتریس کوواریانس و مقادیر و بردارهای ویژهٔ آن را بهعنوان شکل و جهتگیری بخوانید؛
اثبات کنید ؛
ماتریس سفیدسازی را بسازید و نشان دهید سفیدسازی فاصلهٔ ماهالانوبیس را به اقلیدسی تبدیل میکند؛
فاصلههای ماهالانوبیس و مختصات سفیدشده را با NumPy حساب کنید؛
استانداردسازی، PCA و سفیدسازی را از هم تشخیص دهید؛
فاصلهٔ ماهالانوبیس را در ممیز گاوسی نظریهٔ تصمیم بیزی جای دهید.
1. چرا به فاصلهٔ ماهالانوبیس نیاز داریم؟
در بیشتر کاربردها داده چندمتغیره است، ویژگیها همبستهاند و با مقیاسهای مختلف اندازهگیری شدهاند. فاصلهٔ اقلیدسی () خلاف این را فرض میکند: ویژگیهای ناهمبسته با واریانس یکسان. اگر یک ویژگی بر حسب متر و دیگری بر حسب کیلومتر باشد، دومی فقط بهخاطر اندازهٔ عددیاش بر جمع غلبه میکند. اگر ویژگیها همبسته باشند، ابر نقطهها بیضیگون است نه کرهگون، و فاصلهٔ اقلیدسی جهتگیری آن بیضی را نادیده میگیرد — و نتیجههای گمراهکننده در دستهبندی و خوشهبندی میآید.
فاصلهٔ ماهالانوبیس فاصلهٔ میان یک نقطه و یک توزیع را میسنجد، نرمالشده با واریانس هر ویژگی و با همبستگیهای میان آنها.
مثال توضیحی: اقلیدسی در برابر ماهالانوبیس
یک گاوسی دوبعدی با همبستگی بالا، و دو نقطه در فاصلهٔ اقلیدسی یکسان از مرکزش، یکی در جهت واریانس بزرگ و یکی عمود بر آن:
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy.spatial.distance import mahalanobis
from scipy.stats import multivariate_normal

# Set random seed for reproducibility
np.random.seed(42)

# Generate 2D Gaussian random points with high correlation
mean = [0, 0]
cov = [[1, 0.8], [0.8, 1]]  # Covariance matrix
points = np.random.multivariate_normal(mean, cov, 100)

# Select two points with the same Euclidean distance to the center but different locations
# Point 1 is along the direction of high variance
# Point 2 is along the direction of low variance
point1 = np.array([1.5, 1.5])
point2 = np.array([-1.5, 1.5])

# Compute Euclidean distances
center = np.array(mean)
euclidean_dist1 = np.linalg.norm(point1 - center)
euclidean_dist2 = np.linalg.norm(point2 - center)

# Compute Mahalanobis distances
inv_cov = np.linalg.inv(cov)
mahalanobis_dist1 = mahalanobis(point1, center, inv_cov)
mahalanobis_dist2 = mahalanobis(point2, center, inv_cov)

# Plot the data and points
plt.figure(figsize=(10, 8))
plt.scatter(points[:, 0], points[:, 1], alpha=0.5, label='Data Points')
plt.scatter(center[0], center[1], color='red', marker='x', s=100, label='Mean (0,0)')

# Highlight the two comparison points
plt.scatter(point1[0], point1[1], color='green', marker='*', s=150,
            label=f'Point 1\nEuclidean: {euclidean_dist1:.2f}, Mahal: {mahalanobis_dist1:.2f}')
plt.scatter(point2[0], point2[1], color='blue', marker='*', s=150,
            label=f'Point 2\nEuclidean: {euclidean_dist2:.2f}, Mahal: {mahalanobis_dist2:.2f}')

# Plot the probability contours
x, y = np.mgrid[-3:3:.01, -3:3:.01]
pos = np.dstack((x, y))
rv = multivariate_normal(mean, cov)
plt.contour(x, y, rv.pdf(pos), levels=3, colors='purple', linewidths=2)

plt.legend()
plt.title('Euclidean vs. Mahalanobis Distance')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.grid(True, linestyle='--', alpha=0.3)
plt.axis('equal')
plt.tight_layout()
plt.show()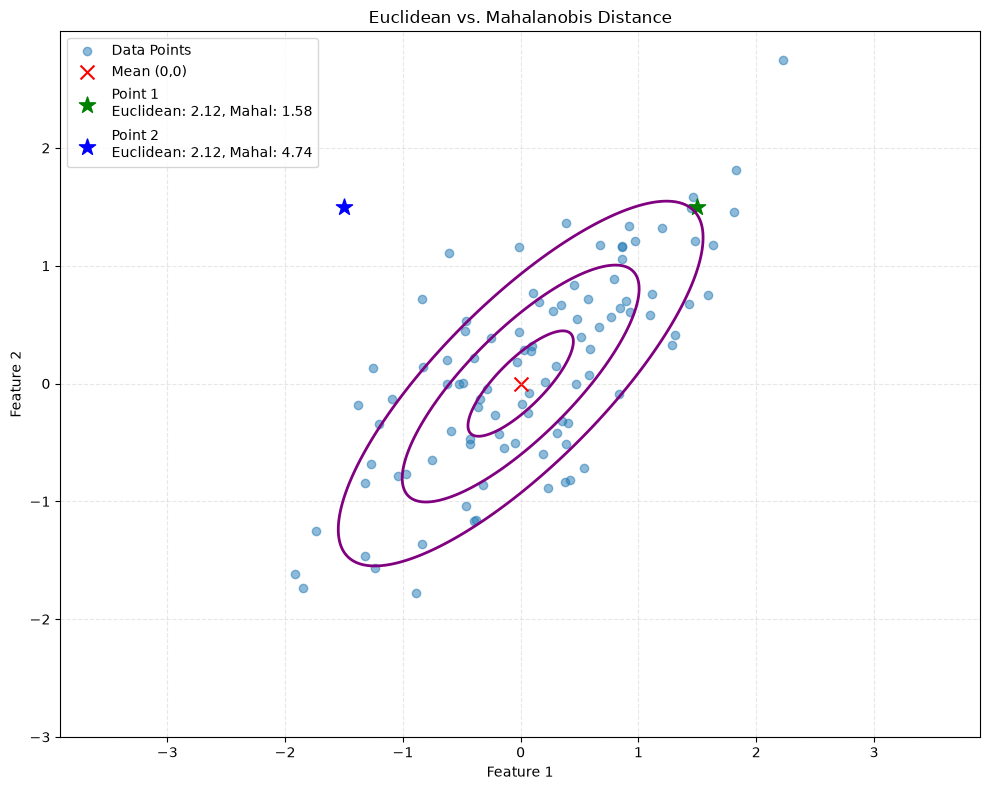
مشاهده: نقطهٔ 1 و نقطهٔ 2 فاصلهٔ اقلیدسی یکسانی از مرکز دارند، ولی در «ناحیههای احتمال» مختلفی قرار میگیرند. نقطهٔ 2 در جهتی با واریانس کمتر (عمود بر همبستگی اصلی) است و از نظر آماری کمتر محتمل (دورتر در فاصلهٔ ماهالانوبیس) از نقطهٔ 1 است.
2. مقیاس ویژگی: یک مطالعهٔ موردی
دادهها
سه موشک بالستیک که با دو ویژگی توصیف میشوند: برد و سرعت.
| موشک | برد (کیلومتر) | سرعت (ماخ) |
|---|---|---|
| A. خیبرشکن (هدف) | 1,450 | 5 |
| B. سجیل | 2,000 | 10 |
| C. فاتح | 1,400 | 14 |
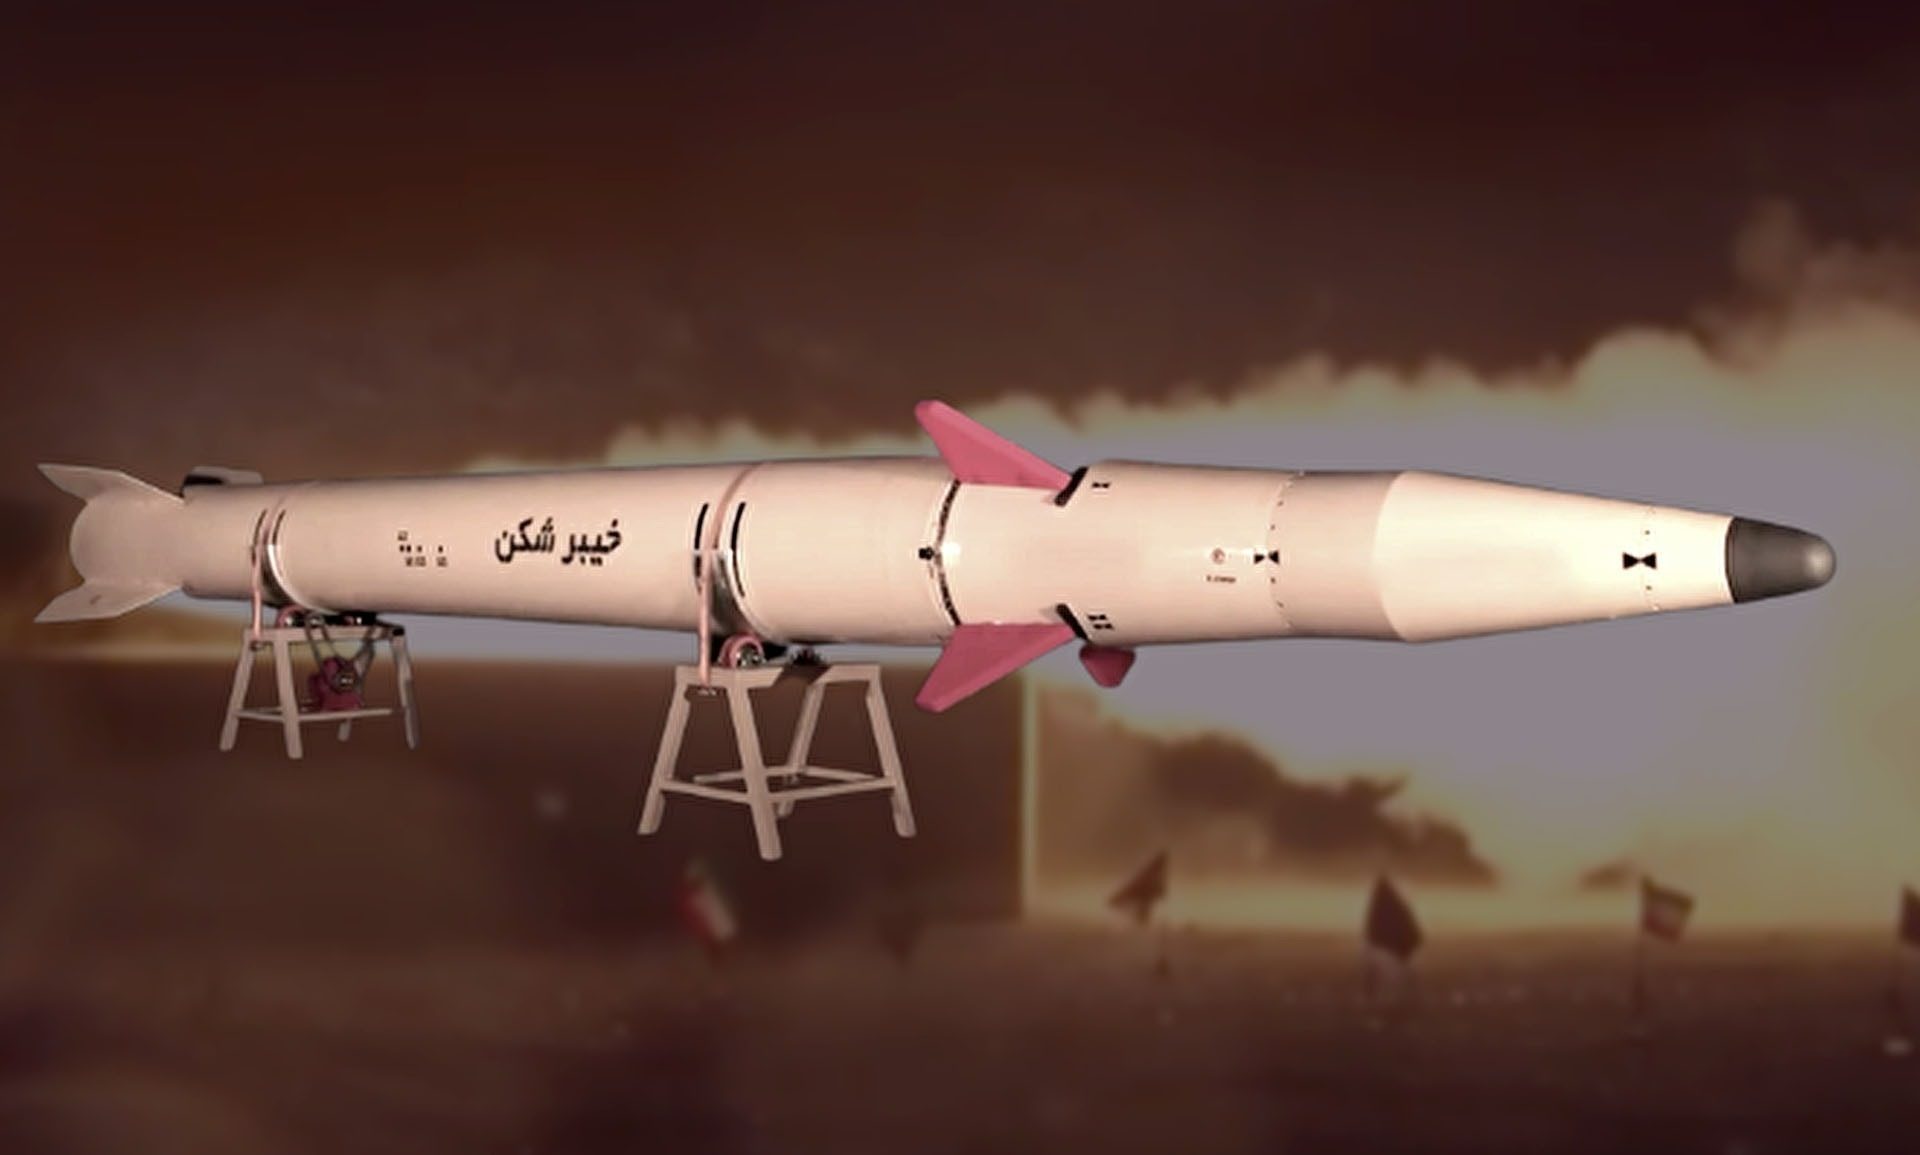
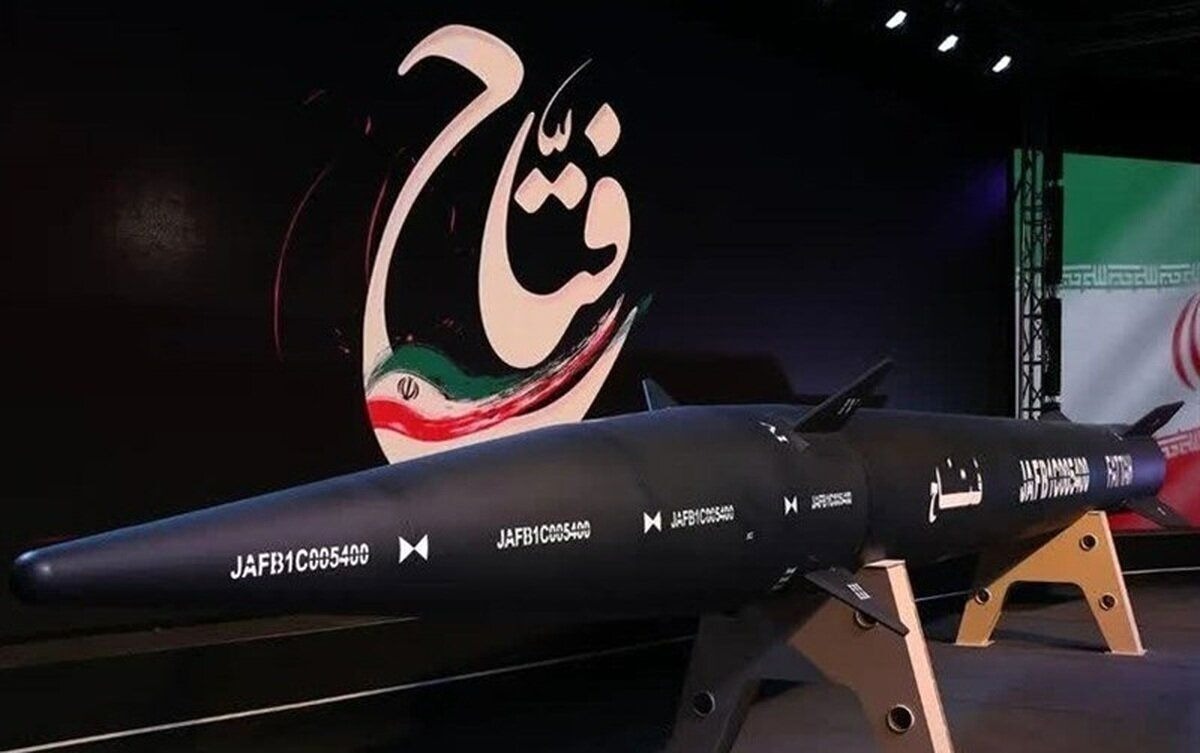
کدامیک از B و C به A شبیهتر است؟
فاصلهٔ اقلیدسی خام
خیبر در برابر سجیل (B): کیلومتر و ماخ، پس .
خیبر در برابر فاتح (C): کیلومتر و ماخ، پس .
فاتح ده برابر نزدیکتر به نظر میرسد. دلیلش حساب است نه شباهت: ستون برد مقدارهایی در هزاران دارد، پس 50 کیلومتر در برابر 5 یا 9 در ستون سرعت عدد کوچکی است. ویژگیای با گسترهٔ عددی بزرگتر جواب را تعیین میکند.
فاصلهٔ استانداردشده
هر ویژگی را بر انحراف معیارش تقسیم کنید، ، تا هر دو برحسب انحراف معیار سنجیده شوند. برای سه موشک
برد: کیلومتر، جامعه کیلومتر ( نمونه کیلومتر)؛
سرعت: ماخ، جامعه ماخ ( نمونه ماخ).
StandardScaler بر انحراف معیار جامعه تقسیم میکند، بر و نه ، و همین دلیل است که
فاصلههای زیر از 271.8 و 3.68 استفاده میکنند در حالی که pandas عددهای 332.9 و 4.51 را چاپ میکند. در
واحد z، نقطهٔ A برابر ، B برابر و C برابر است، پس
خیبر در برابر سجیل: ؛
خیبر در برابر فاتح: .
| مقایسه | فاصلهٔ خام | فاصلهٔ استانداردشده |
|---|---|---|
| خیبر در برابر سجیل | 550.02 | 2.44 |
| خیبر در برابر فاتح | 50.80 | 2.45 |
جواب برمیگردد، با اختلافی مویباریک: پس از استانداردسازی سجیل همسایهٔ نزدیکتر است.
کدام جواب درست است؟
هیچکدام. استانداردسازی میگوید دو ویژگی وزن یکسان میارزند؛ فاصلهٔ خام میگوید یک کیلومتر بهقدر یک ماخ میارزد. هر دو فرضهایی دربارهٔ مسئلهاند، نه واقعیتهایی دربارهٔ موشکها، و مثال چنان ساخته شده که با هم اختلاف داشته باشند. درسی که باید نگه داشت همین است: در هر روشی بر پایهٔ فاصلهٔ اقلیدسی — k-NN، k-means، لایهٔ ورودی شبکه — مقیاس بخشی از مدل است و باید انتخاب شود، نه از واحدهایی که داده اتفاقاً با آنها ذخیره شده به ارث برسد.
کد
سلول بعد حساب را انجام میدهد: فاصلههای خام، بعد StandardScaler، بعد همان فاصلهٔ اقلیدسی روی
ستونهای استانداردشده.
Source
import numpy as np
import pandas as pd
from sklearn.preprocessing import StandardScaler

# ============================================
# 1. REALISTIC IRANIAN MISSILE DATASET
# ============================================
data = {
    'Name': ['Khaybar Shikan', 'Sejjil', 'Fatāh'],
    'Range_km': [1450, 2000, 1400],
    'Speed_Mach': [5, 10, 14]
}

df = pd.DataFrame(data)
df.set_index('Name', inplace=True)

# Target: Compare Khaybar Shikan to Sejjil and Fatāh
target_name = 'Khaybar Shikan'
target = df.loc[target_name].values
other_names = ['Sejjil', 'Fatāh']
others = df.loc[other_names].values

# ============================================
# 2. RAW EUCLIDEAN DISTANCE (Unscaled)
# ============================================
raw_dist = np.linalg.norm(others - target, axis=1)

print("=== RAW EUCLIDEAN DISTANCE (Unscaled) ===")
for name, dist in zip(other_names, raw_dist):
    print(f"Distance to {name}: {dist:.2f}")

# ============================================
# 3. SCALED EUCLIDEAN DISTANCE (Standardized)
# ============================================
scaler = StandardScaler()
scaled_data = scaler.fit_transform(df[['Range_km', 'Speed_Mach']])
df_scaled = pd.DataFrame(scaled_data, index=df.index, columns=df.columns)

target_scaled = df_scaled.loc[target_name].values
others_scaled = df_scaled.loc[other_names].values

scaled_dist = np.linalg.norm(others_scaled - target_scaled, axis=1)

print("\n=== SCALED EUCLIDEAN DISTANCE (Normalized) ===")
for name, dist in zip(other_names, scaled_dist):
    print(f"Distance to {name}: {dist:.2f}")

# ============================================
# 4. SHOW THE FLIP
# ============================================
raw_winner = other_names[np.argmin(raw_dist)]
scaled_winner = other_names[np.argmin(scaled_dist)]

print("\n--- ANALYSIS ---")
print(f"Winner with raw distances: {raw_winner}")
print(f"Winner after standardization: {scaled_winner}")

# ============================================
# 5. SHOW STATISTICS
# ============================================
print("\n--- DATASET STATISTICS ---")
print(f"Range Std Dev: {df['Range_km'].std():.2f} km")
print(f"Speed Std Dev: {df['Speed_Mach'].std():.2f} Mach")
=== RAW EUCLIDEAN DISTANCE (Unscaled) ===
Distance to Sejjil: 550.02
Distance to Fatāh: 50.80

=== SCALED EUCLIDEAN DISTANCE (Normalized) ===
Distance to Sejjil: 2.44
Distance to Fatāh: 2.45

--- ANALYSIS ---
Winner with raw distances: Fatāh
Winner after standardization: Sejjil

--- DATASET STATISTICS ---
Range Std Dev: 332.92 km
Speed Std Dev: 4.51 Mach
دو آمارهٔ چاپشده مخرجهای مختلف دارند: df.std() انحراف معیار نمونه () است در حالی که
StandardScaler از نسخهٔ جامعه () استفاده میکند. هر دو معقولاند؛ فاصلههای بالا از نسخهٔ جامعه
میآیند.
3. ماتریس کوواریانس
ماتریس کوواریانس ماتریسی مربعی است که واریانسها و کوواریانسهای مجموعهای از متغیرهای تصادفی را خلاصه میکند. برای مجموعهدادهای با ویژگی، ماتریس کوواریانس ماتریسی است که چنین تعریف میشود:
که:
: واریانس ویژگی ام (درایههای قطری).
: کوواریانس میان ویژگیهای و (درایههای غیرقطری).
ویژگیها:
متقارن: ، پس .
مثبت نیمهمعین: همهٔ مقادیر ویژه نامنفیاند ().
4. تفسیر هندسی ماتریس کوواریانس
ماتریس کوواریانس شکل و جهتگیری توزیع داده در فضای ویژگی را تعریف میکند.
بردارهای ویژه (جهتها): بردارهای ویژهٔ محورهای اصلی توزیع داده را نشان میدهند. جهتهای بیشترین واریانس را مشخص میکنند.
مقادیر ویژه (اندازهها): مقادیر ویژهٔ متناظر اندازهٔ واریانس در این جهتهای بردار ویژه را نشان میدهند.
بیضیگون: در دو بُعد، ماتریس کوواریانس بیضی را تعریف میکند. در بُعد، ابربیضی را تعریف میکند. محورهای این بیضی با بردارهای ویژه همراستا هستند و طول محورها متناسب با جذر مقادیر ویژه است.
5. تبدیلهای خطی و کوواریانس
برای فهم کامل فاصلهٔ ماهالانوبیس و سفیدسازی، باید بفهمیم کوواریانس زیر تبدیلهای خطی چگونه تغییر میکند. قضیهٔ زیر بنیاد ریاضی تبدیل داده به فضای «سفیدشده» را میدهد.
قضیهٔ 1 (ویژگی تبدیل کوواریانس)
برداری تصادفی با میانگین و ماتریس کوواریانس باشد. ماتریس تبدیلی ثابت باشد. برای بردار تصادفی تبدیلشده ، ماتریس کوواریانس چنین است
اثبات: با اعمال تعریف کوواریانس و خطیبودن امید ریاضی پیش میرویم.
میانگین : نخست توجه کنید میانگین بردار مرکزشده صفر است:
کوواریانس :
چون ، تعریف کوواریانس به ساده میشود.
با خطیبودن عملگر امید ریاضی، ماتریسهای ثابت و را میتوان از امید ریاضی بیرون کشید:
با شناختن اینکه عبارت درون امید ریاضی دقیقاً تعریف است:
نکته (کاربرد سفیدسازی): این ویژگی بنیاد سفیدسازی است. با برگزیدن چنان که ، داده را به فضایی میبریم که ویژگیها ناهمبستهاند و واریانس واحد دارند. بخش 6 همین را از تجزیهٔ مقدار ویژهٔ میسازد.
6. تبدیل سفیدسازی
سفیدسازی گام پیشپردازشی است که ماتریس کوواریانس را به همانی تبدیل میکند. ویژگیهای تبدیلشده آنگاه ناهمبستهاند و واریانس واحد دارند.
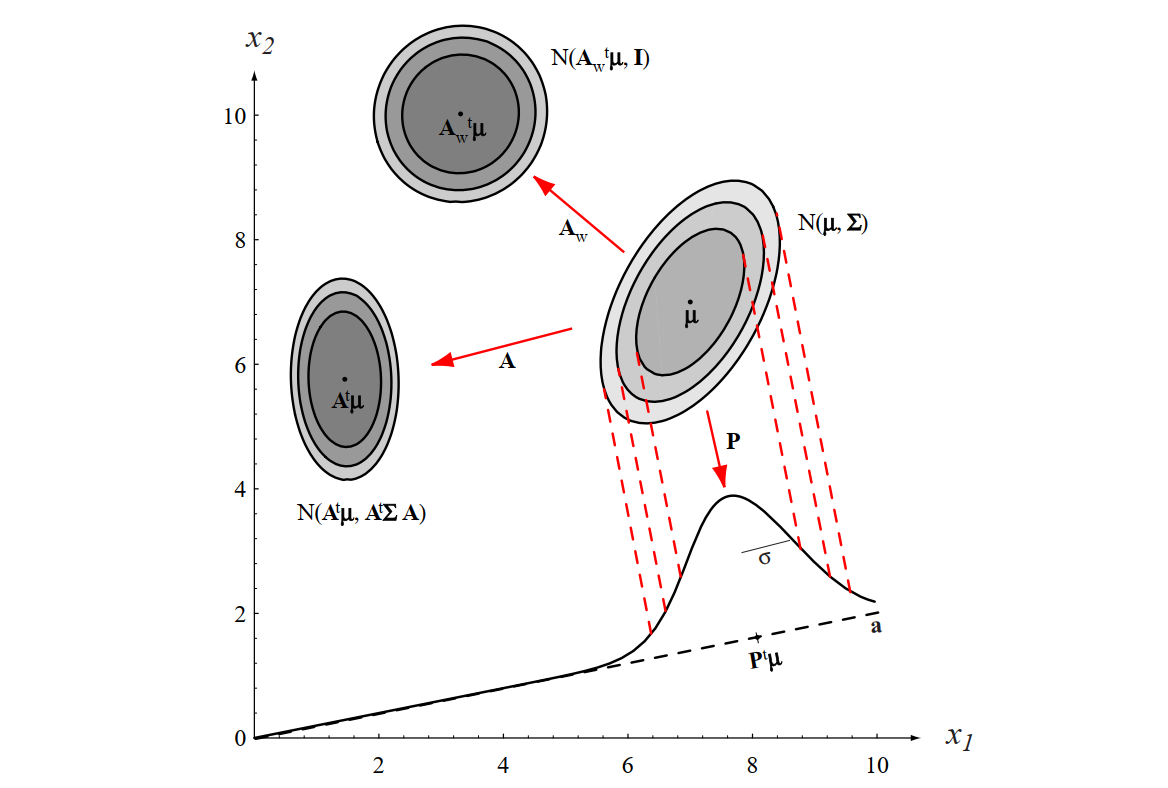
شکل 2.8 Duda et al. (2000): تبدیل خطی فضای ویژگی، یک توزیع نرمال دلخواه را به توزیع نرمال دیگری میبرد.
ماتریسی میخواهیم چنان که کوواریانس داشته باشد. بخش 5 میدهد ، و تجزیهٔ مقدار ویژهٔ بخش 4، ، مقدار را میدهد. بررسیاش:
تفسیر هندسی
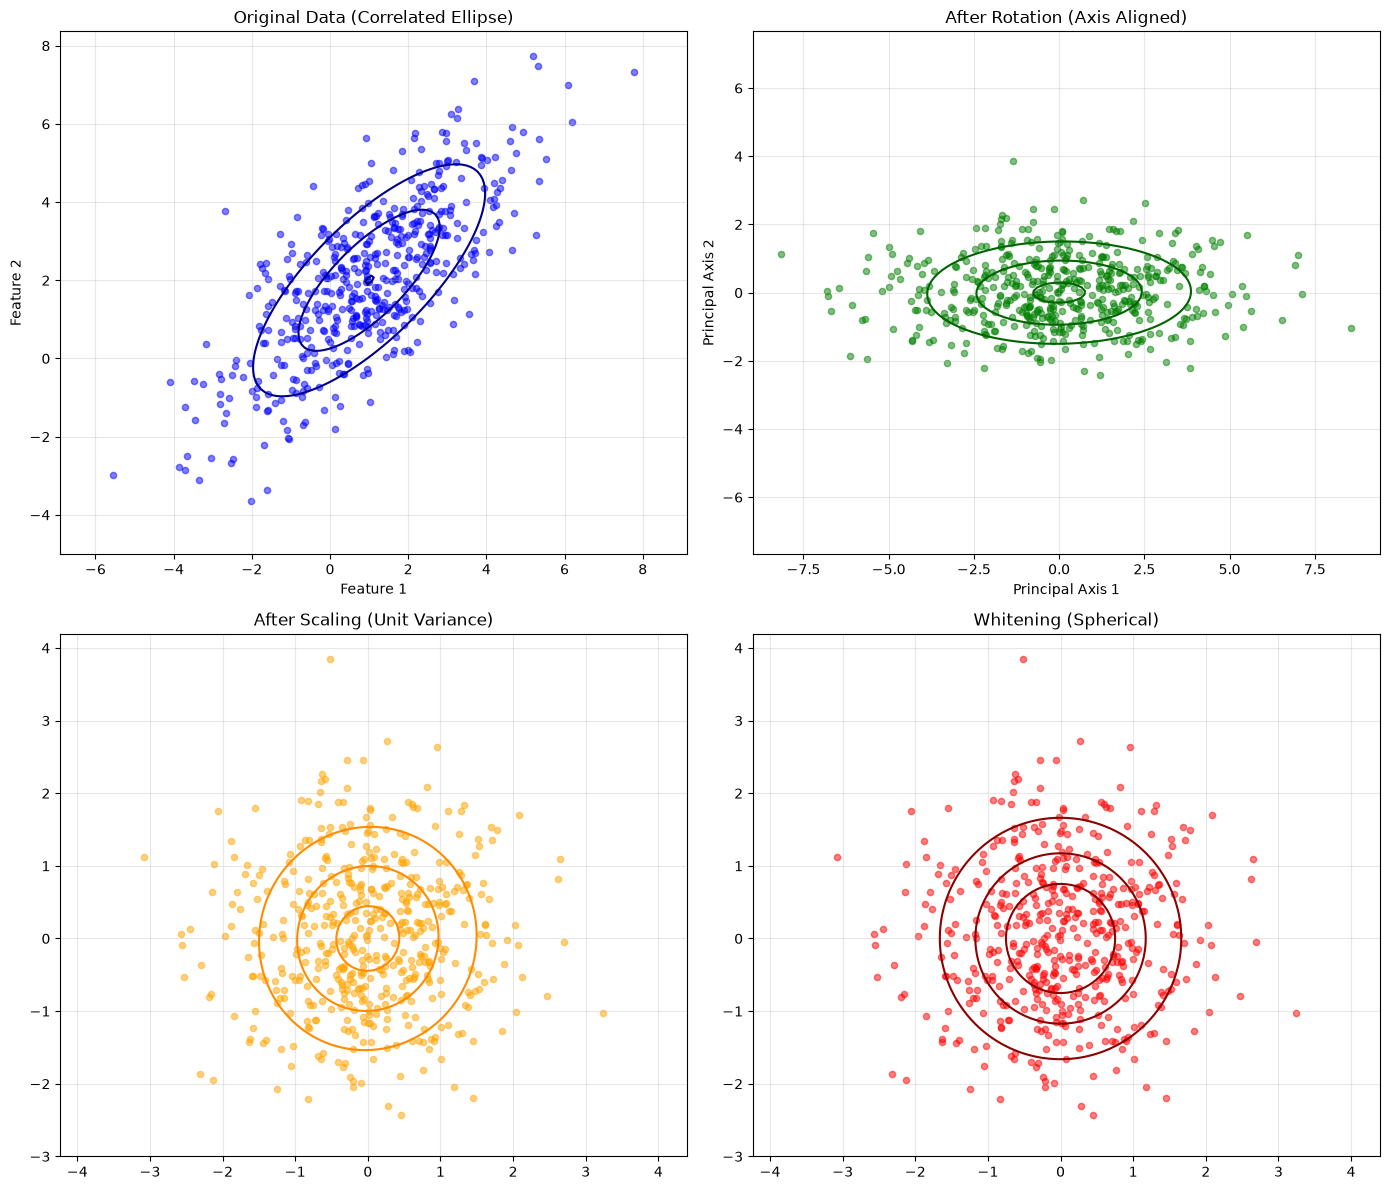
دوران () داده را با محورهای اصلی همراستا میکند و همبستگیها را برمیدارد.
مقیاسبندی () هر محور را کش میآورد یا فشرده میکند تا واریانسش 1 شود.
ابر نقطهها کره میشود. در این فضا فاصلهٔ اقلیدسی همان فاصلهٔ ماهالانوبیس فضای اصلی است — بخش 7 این اتحاد را اثبات میکند و کد زیر آن را عددی نشان میدهد.
همان دو نقطه، سفیدشده
کد ابر همبسته و دو نقطهٔ ستارهدار بخش 1 را میگیرد، را اعمال میکند و داده را قبل و بعد رسم میکند. در چپ دو نقطه در فاصلهٔ اقلیدسی یکسان از مرکزند؛ در راست فاصلههای اقلیدسیشان همان فاصلههای ماهالانوبیس در فضای اصلیاند.
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy.spatial.distance import mahalanobis
from scipy.stats import multivariate_normal

# Generate 2D Gaussian random points
np.random.seed(42)
mean = [0, 0]
cov = [[1, 0.8], [0.8, 1]]  # Covariance matrix
points = np.random.multivariate_normal(mean, cov, 100)

# The center
center = mean

# Select two points with equal Euclidean distance to the center
point1 = np.array([1.5, 1.5])
point2 = np.array([-1.5, 1.5])

# Compute Euclidean distances
euclidean_dist1 = np.linalg.norm(point1 - center)
euclidean_dist2 = np.linalg.norm(point2 - center)

# Compute Mahalanobis distances
inv_cov = np.linalg.inv(cov)
mahalanobis_dist1 = mahalanobis(point1, center, inv_cov)
mahalanobis_dist2 = mahalanobis(point2, center, inv_cov)

# Whitening the data based on Duda's book
# Step 1: Compute the eigenvalues and eigenvectors of the covariance matrix
eigenvals, eigenvecs = np.linalg.eigh(cov)
idx = np.argsort(eigenvals)[::-1]
eigenvals = eigenvals[idx]
eigenvecs = eigenvecs[:, idx]

# Step 2: Construct the whitening matrix
D = np.diag(1.0 / np.sqrt(eigenvals))  # Diagonal matrix of inverse square roots of eigenvalues
W = np.dot(eigenvecs, D)  # Whitening matrix

# Step 3: Whiten the data
whitened_points = np.dot(points - center, W)  # Subtract mean and apply whitening transformation
whitened_point1 = np.dot(point1 - center, W)
whitened_point2 = np.dot(point2 - center, W)

# Compute Euclidean distances in the whitened space
whitened_euclidean_dist1 = np.linalg.norm(whitened_point1)
whitened_euclidean_dist2 = np.linalg.norm(whitened_point2)

# Plot the original and whitened data
plt.figure(figsize=(12, 6))

# Plot original data
plt.subplot(1, 2, 1)
plt.scatter(points[:, 0], points[:, 1], alpha=0.5, label='Random Points')
plt.scatter(center[0], center[1], color='red', label='Center')
plt.scatter(point1[0], point1[1], color='green', marker='*', s=150, label=f'Point 1 (Euclidean: {euclidean_dist1:.2f}, Mahalanobis: {mahalanobis_dist1:.2f})')
plt.scatter(point2[0], point2[1], color='blue', marker='*', s=150, label=f'Point 2 (Euclidean: {euclidean_dist2:.2f}, Mahalanobis: {mahalanobis_dist2:.2f})')

# Create a grid of points for the original data
x, y = np.mgrid[-3:3:.01, -3:3:.01]
pos = np.dstack((x, y))

# Compute the Gaussian distribution on the grid
rv = multivariate_normal(mean, cov)
plt.contour(x, y, rv.pdf(pos), levels=3, cmap='viridis')

plt.legend()
plt.title('Original Data')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.axis('equal')

# Plot whitened data
plt.subplot(1, 2, 2)
plt.scatter(whitened_points[:, 0], whitened_points[:, 1], alpha=0.5, label='Whitened Points')
plt.scatter(0, 0, color='red', label='Center')
plt.scatter(whitened_point1[0], whitened_point1[1], color='green', marker='*', s=150, label=f'Point 1 (Euclidean: {whitened_euclidean_dist1:.2f})')
plt.scatter(whitened_point2[0], whitened_point2[1], color='blue', marker='*', s=150, label=f'Point 2 (Euclidean: {whitened_euclidean_dist2:.2f})')

# Create a grid of points for the whitened data
x_whitened, y_whitened = np.mgrid[-3:3:.01, -3:3:.01]
pos_whitened = np.dstack((x_whitened, y_whitened))

# Compute the Gaussian distribution on the grid for whitened data
rv_whitened = multivariate_normal([0, 0], np.eye(2))  # Covariance matrix is identity after whitening
plt.contour(x_whitened, y_whitened, rv_whitened.pdf(pos_whitened), levels=3, cmap='viridis')

plt.legend()
plt.title('Whitened Data')
plt.xlabel('Whitened Feature 1')
plt.ylabel('Whitened Feature 2')
plt.axis('equal')

plt.tight_layout()
plt.show()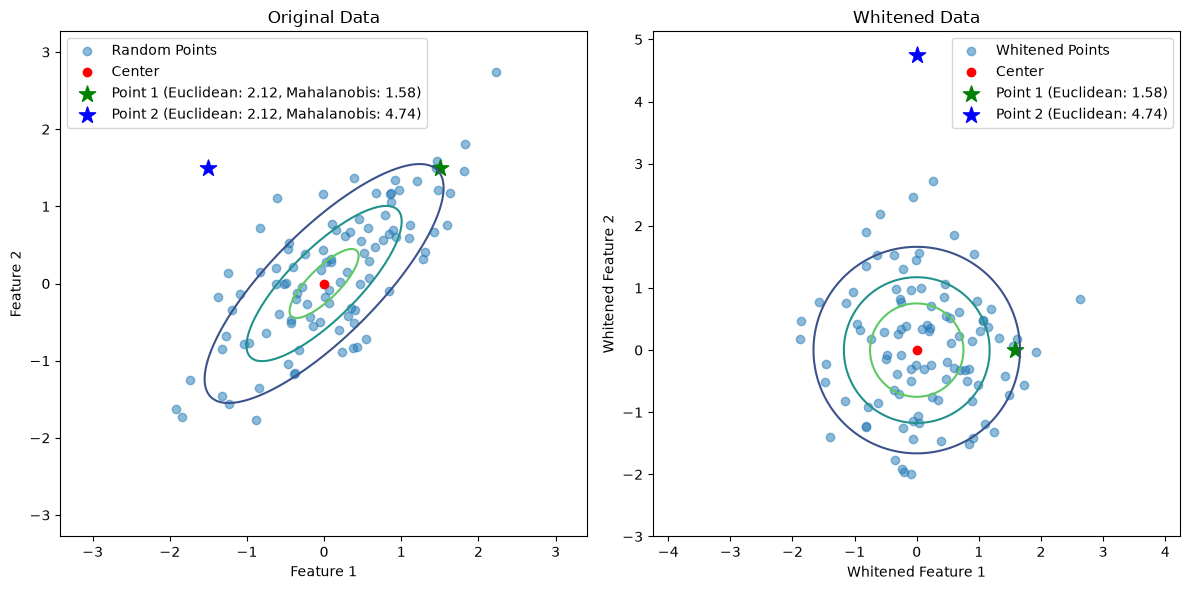
هر دو نقطه در معنای اقلیدسی اصلی 2.12 از مرکز دورند. فاصلههای ماهالانوبیسشان 1.58 برای نقطهٔ روی محور اصلی و 4.74 برای نقطهٔ عمود بر آن است؛ پس از سفیدسازی فاصلههای اقلیدسی دقیقاً همان دو عددند، با همان ترتیب. دایرهٔ شعاع ثابت در پنل راست، در پنل چپ بیضی فاصلهٔ ماهالانوبیس ثابت است.
7. فاصلهٔ ماهالانوبیس
در بخش 6 تبدیل را ثابت گرفتیم و پرسیدیم چه کوواریانسی تولید میکند. اینجا پرسش وارون را میپرسیم: کدام نُرم روی مختصات تبدیلشده فاصلهٔ ماهالانوبیس فضای اصلی را بازتولید میکند؟
فاصلهٔ ماهالانوبیس سنجهٔ فاصلهٔ میان نقطهٔ و توزیعی با میانگین و ماتریس کوواریانس است. چنین تعریف میشود:
این فاصله در بسیاری از روشهای آماری چندمتغیره، از جمله نظریهٔ تصمیم بیزی برای دستهبندی، مرکزی است، چون ساختار زیربنایی (واریانسها و همبستگیهای) داده را در نظر میگیرد.
نکتهٔ کلیدی
فرمول تبدیل کوواریانس از بخش 5 بنیاد ریاضی اصلی هم برای تبدیل سفیدسازی و هم برای فاصلهٔ ماهالانوبیس است.
فاصلهٔ ماهالانوبیس را یادآوری کنید:
حالا فضای سفیدشده را در نظر بگیرید: اگر تعریف کنیم که در آن باعث میشود، آنگاه:
برای اینکه این با فاصلهٔ ماهالانوبیس برابر شود باید نشان دهیم .
اثبات:
داده شده: و
هدف: نشان دادن
گام 1: حساب کردن
را جایگذاری کنید:
حالا عامل دوم را ترانهاده کنید:
چون ماتریسی قطری با مقادیر ویژهٔ مثبت است (یعنی وارونپذیر)، هم قطری و متقارن است، پس:
بنابراین،
گام 2: حساب کردن با وارون ماتریس قطریشده
داده شده:
چون ماتریسی متعامد است (یعنی )، میدانیم:
چون متعامد است:
پس
بنابراین،
نشان دادیم که:
نکتهٔ کلیدی: متعامد بودن به ما اجازه میدهد وارون را زیبا ساده کنیم، و همین برای برقراری نتیجه ضروری است.
رابطهٔ کلیدی
| مفهوم | بیان ریاضی | هدف |
|---|---|---|
| تبدیل کوواریانس | نشان میدهد کوواریانس زیر تبدیل خطی چگونه تغییر میکند | |
| ماتریس سفیدسازی | داده را به کوواریانس واحد میبرد | |
| فاصلهٔ ماهالانوبیس | فاصلهٔ در نظرگیرندهٔ ساختار کوواریانس | |
| فاصلهٔ اقلیدسی (سفیدشده) | فاصله پس از نرمالسازی کوواریانس | |
| همارزی کلیدی | ماهالانوبیس = اقلیدسی در فضای سفیدشده |
8. پیادهسازی پایتون، گامبهگام
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import multivariate_normal

np.random.seed(42)

# ============================================================================
# 1. GENERATE CORRELATED DATA
# ============================================================================
print("=" * 70)
print("STEP 1: Generate Correlated Data (Original Space)")
print("=" * 70)

mean = np.array([1, 2])
cov_original = np.array([[4, 3], [3, 4]])  # Correlated data
n_samples = 500
data_original = np.random.multivariate_normal(mean, cov_original, n_samples)

print(f"Original Covariance:\n{cov_original}")

# ============================================================================
# 2. EIGEN DECOMPOSITION
# ============================================================================
print("\n" + "=" * 70)
print("STEP 2: Eigen Decomposition (Rotation + Scaling Factors)")
print("=" * 70)

eigenvalues, eigenvectors = np.linalg.eigh(cov_original)
idx = np.argsort(eigenvalues)[::-1]
eigenvalues = eigenvalues[idx]
eigenvectors = eigenvectors[:, idx]
print(f"\nEigenvalues (λ): {eigenvalues}")
print(f"\nEigenvectors (Φ):")
print(eigenvectors)
======================================================================
STEP 1: Generate Correlated Data (Original Space)
======================================================================
Original Covariance:
[[4 3]
 [3 4]]

======================================================================
STEP 2: Eigen Decomposition (Rotation + Scaling Factors)
======================================================================

Eigenvalues (λ): [7. 1.]

Eigenvectors (Φ):
[[ 0.70710678 -0.70710678]
 [ 0.70710678  0.70710678]]
# ============================================================================
# 3. ROTATION ONLY (Phi^T: removes the correlation)
# ============================================================================
print("\n" + "=" * 70)
print("STEP 3: Rotation Only")
print("=" * 70)

data_rotated = (data_original - mean) @ eigenvectors
cov_rotated = np.cov(data_rotated.T)

print(f"\nCovariance after Rotation (diagonal, up to sampling error):")
print(cov_rotated)
print(f"Off-diagonal before rotation: {cov_original[0, 1]:.4f}")
print(f"Off-diagonal after rotation: {cov_rotated[0, 1]:.4f}")

# ============================================================================
# 4. SCALING AFTER ROTATION (divide each axis by sqrt(lambda))
# ============================================================================
print("\n" + "=" * 70)
print("STEP 4: Scaling Only (Λ^(-1/2) normalizes variance)")
print("=" * 70)

scale_factors = 1.0 / np.sqrt(eigenvalues)
data_scaled = data_rotated @ np.diag(scale_factors)
cov_scaled = np.cov(data_scaled.T)

print(f"\nCovariance after Scaling (identity, up to sampling error):")
print(cov_scaled)
======================================================================
STEP 3: Rotation Only
======================================================================

Covariance after Rotation (diagonal, up to sampling error):
[[6.54609064 0.06692453]
 [0.06692453 0.98399756]]
Off-diagonal before rotation: 3.0000
Off-diagonal after rotation: 0.0669

======================================================================
STEP 4: Scaling Only (Λ^(-1/2) normalizes variance)
======================================================================

Covariance after Scaling (identity, up to sampling error):
[[0.93515581 0.02529509]
 [0.02529509 0.98399756]]
# ============================================================================
# 5. WHITENING: the same two steps as one matrix, W = Phi Lambda^(-1/2)
# ============================================================================
print("\n" + "=" * 70)
print("STEP 5:  Whitening (W = ΦΛ^(-1/2))")
print("=" * 70)

W = eigenvectors @ np.diag(scale_factors)
data_whitened = W.T @ (data_original - mean).T
data_whitened = data_whitened.T

print(f"\nWhitening Matrix (W = ΦΛ^(-1/2)):")
print(W)
print(f"\nCovariance after Whitening (W^T Σ W):")
print(np.cov(data_whitened.T))
======================================================================
STEP 5:  Whitening (W = ΦΛ^(-1/2))
======================================================================

Whitening Matrix (W = ΦΛ^(-1/2)):
[[ 0.26726124 -0.70710678]
 [ 0.26726124  0.70710678]]

Covariance after Whitening (W^T Σ W):
[[0.93515581 0.02529509]
 [0.02529509 0.98399756]]
کوواریانسهای چاپشده متعلق به یک نمونه 500 نقطهایاند، نه به
واقعی، و np.cov بر تقسیم
میکند. همین دلیل است که قطر پس از دوران 6.55 و 0.98 میخواند و نه دقیقاً 7 و 1، و پس از سفیدسازی
0.94 و 0.98 میخواند و نه دقیقاً 1: تبدیل دقیق است، برآورد کوواریانس نه. n_samples را بالا ببرید و
درایهها به همانی همگرا میشوند.
# ============================================================================
# 6. VISUALIZATION
# ============================================================================
print("\n" + "=" * 70)
print("STEP 6: Visualization of Transformation")
print("=" * 70)

fig, axes = plt.subplots(2, 2, figsize=(14, 12))

# Original Data
axes[0, 0].scatter(data_original[:, 0], data_original[:, 1], alpha=0.5, s=20, color='blue', label='Original')
pos = np.dstack(np.mgrid[-5:5:100j, -5:5:100j])
axes[0, 0].contour(pos[:,:,0], pos[:,:,1], multivariate_normal(mean, cov_original).pdf(pos), levels=3, colors='darkblue')
axes[0, 0].set_title('Original Data (Correlated Ellipse)')
axes[0, 0].set_xlabel('Feature 1'); axes[0, 0].set_ylabel('Feature 2')
axes[0, 0].grid(True, alpha=0.3); axes[0, 0].axis('equal')

# After Rotation
axes[0, 1].scatter(data_rotated[:, 0], data_rotated[:, 1], alpha=0.5, s=20, color='green', label='Rotated')
pos = np.dstack(np.mgrid[-5:5:100j, -5:5:100j])
axes[0, 1].contour(pos[:,:,0], pos[:,:,1], multivariate_normal(np.zeros(2), cov_rotated).pdf(pos), levels=3, colors='darkgreen')
axes[0, 1].set_title('After Rotation (Axis Aligned)')
axes[0, 1].set_xlabel('Principal Axis 1'); axes[0, 1].set_ylabel('Principal Axis 2')
axes[0, 1].grid(True, alpha=0.3); axes[0, 1].axis('equal')

# After Scaling
axes[1, 0].scatter(data_scaled[:, 0], data_scaled[:, 1], alpha=0.5, s=20, color='orange', label='Scaled')
pos = np.dstack(np.mgrid[-3:3:100j, -3:3:100j])
axes[1, 0].contour(pos[:,:,0], pos[:,:,1], multivariate_normal(np.zeros(2), cov_scaled).pdf(pos), levels=3, colors='darkorange')
axes[1, 0].set_title('After Scaling (Unit Variance)')
axes[1, 0].grid(True, alpha=0.3); axes[1, 0].axis('equal')

# Combined Whitening
axes[1, 1].scatter(data_whitened[:, 0], data_whitened[:, 1], alpha=0.5, s=20, color='red', label='Whitened')
pos = np.dstack(np.mgrid[-3:3:100j, -3:3:100j])
axes[1, 1].contour(pos[:,:,0], pos[:,:,1], multivariate_normal(np.zeros(2), np.eye(2)).pdf(pos), levels=3, colors='darkred')
axes[1, 1].set_title('Whitening (Spherical)')
axes[1, 1].grid(True, alpha=0.3); axes[1, 1].axis('equal')

plt.tight_layout()
plt.show()
======================================================================
STEP 6: Visualization of Transformation
======================================================================
# ============================================================================
# 7. MAHALANOBIS DISTANCE VERIFICATION
# ============================================================================
print("\n" + "=" * 70)
print("STEP 7: Mahalanobis Distance = Euclidean in Whitened Space")
print("=" * 70)

test_point = np.array([4, 4])
inv_cov = np.linalg.inv(cov_original)
mahalanobis_dist = np.sqrt((test_point - mean) @ inv_cov @ (test_point - mean))
test_point_whitened = W.T @ (test_point - mean)
euclidean_dist_whitened = np.linalg.norm(test_point_whitened)

print(f"\nTest Point: {test_point}")
print(f"Mahalanobis Distance (Original Space): {mahalanobis_dist:.4f}")
print(f"Euclidean Distance (Whitened Space): {euclidean_dist_whitened:.4f}")
print("\nMahalanobis distance and whitened Euclidean distance agree.")
======================================================================
STEP 7: Mahalanobis Distance = Euclidean in Whitened Space
======================================================================

Test Point: [4 4]
Mahalanobis Distance (Original Space): 1.5119
Euclidean Distance (Whitened Space): 1.5119

Mahalanobis distance and whitened Euclidean distance agree.
9. ماتریس کوواریانس در نظریهٔ تصمیم بیزی
چگالی شرطی-دستهٔ گاوسی در صفحهٔ نظریهٔ تصمیم بیزی چنین است
که و برای هر دسته با بیشترین درستنمایی برآورد میشوند (صفحهٔ MLE).
توان دقیقاً نصف مربع فاصلهٔ ماهالانوبیس از تا است.
کوواریانس مشترک، برای همهٔ ، ممیز لگاریتمی را خطی میکند و مرزها ابرصفحه میشوند: همان LDA.
کوواریانس جداگانه برای هر دسته جملهٔ درجهدوم میگذارد و QDA میدهد.
اگر تکین باشد — نمونهٔ هر دسته در برابر کم — چگالی، و با آن فاصلهٔ ماهالانوبیس، تا تنظیمنشدن برآورد تعریفشده نیست.
پس فاصلهٔ ماهالانوبیس فرمولی جداگانه که به دستهبندی افزوده شده باشد نیست: همان هندسهٔ دستهبند گاوسی است.
10. فاصلهٔ ماهالانوبیس و نقشش
برای یک ویژگی، امتیاز z میسنجد یک مقدار چند انحراف معیار از میانگین دور است. فاصلهٔ ماهالانوبیس همان ایده برای ویژگی است:
نقش را ماتریس کوواریانس میگیرد، پس همزمان دو کار میکند: هر ویژگی را با واریانسش مقیاس میکند و فضا را میچرخاند تا همبستگیها برداشته شوند. هندسی، میشمارد نقطه چند «انحراف معیار» از مرکز ابر بیضیگون دور است و فاصله را در جهت محورهای کشیده و چرخیدهٔ آن بیضی میسنجد.
از فاصله به یک آزمون
برای دادهای که از آمده، مربع فاصلهٔ ماهالانوبیس متغیری با درجهٔ آزادی است، . پس فاصله به یک گزارهٔ احتمالاتی تبدیل میشود، که همان چیزی است که یک آشکارساز ناهنجاری میخواهد: چندکهای 95٪ و 99٪ برابر 5.99 و 9.21 هستند، پس نقطهای با بیش از آنها بیرون از کانتور احتمال متناظر بیضی است. این نسخهٔ چندمتغیرهٔ قاعدهٔ «بیش از دو انحراف معیار دور» است و رایجترین کاربرد عملی این فاصله است.
11. استانداردسازی، PCA و سفیدسازی
هر سه تبدیل از همان آمارهها شروع میکنند و بهراحتی با هم اشتباه میشوند. برحسب تجزیهٔ مقدار ویژه :
استانداردسازی هر ویژگی را بر انحراف معیار خودش تقسیم میکند. قطر کوواریانس را یک میکند ولی همبستگیهای غیرقطری سر جایشان میمانند.
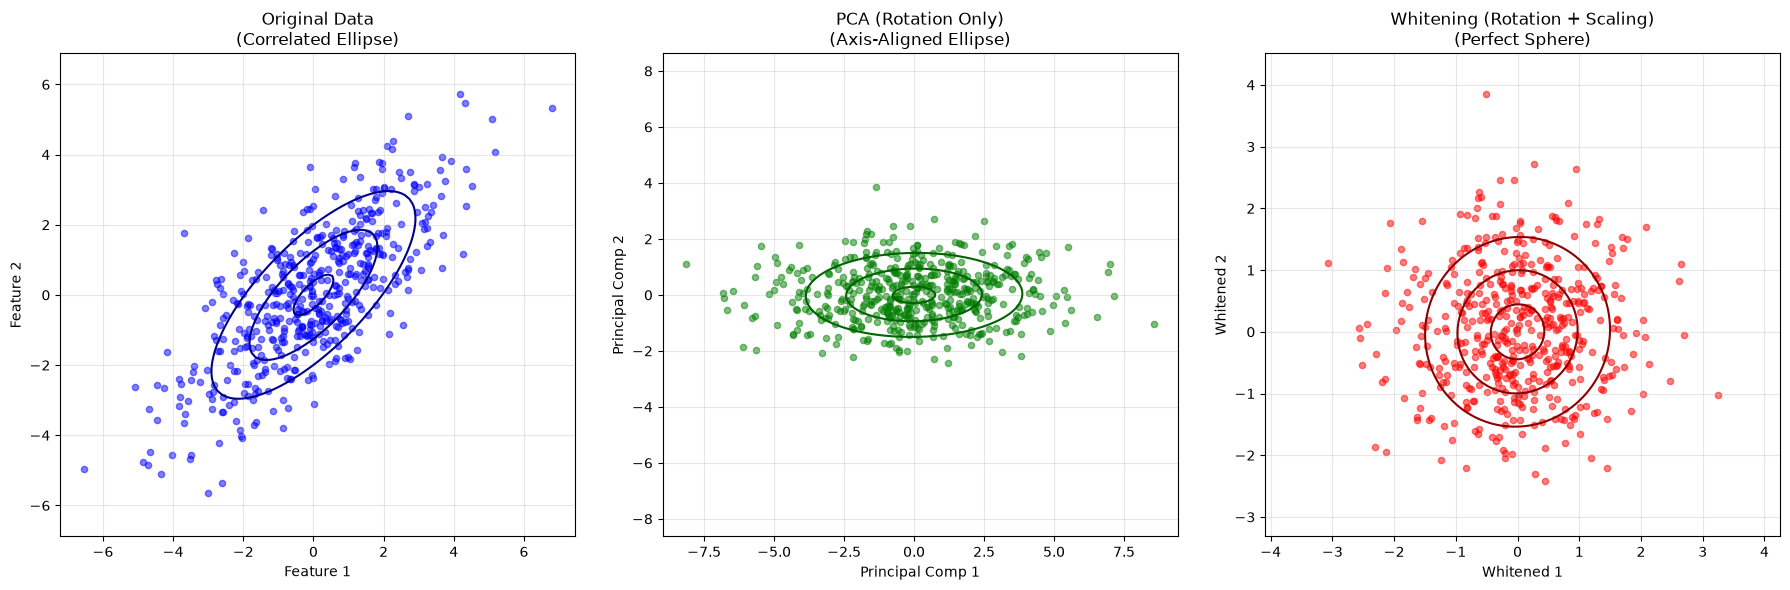
PCA به محورهای اصلی میچرخاند، ، و کوواریانس دارد: همبستگیها رفتهاند، واریانسهای ماندهاند.
سفیدسازی میچرخاند و بعد مقیاس میدهد، ، و کوواریانس دارد.
| ویژگی | استانداردسازی | PCA | سفیدسازی |
|---|---|---|---|
| هدف | واحدهای قابل مقایسه | کاهش بُعد، نگه داشتن واریانس | واریانس واحد و بیهمبستگی |
| تبدیل | |||
| کوواریانس بعد از آن | همبستگیها مانده | قطری، | همانی، |
| شکل ابر نقطهها | همان بیضی | بیضی همراستا با محورها | کره |
| اقلیدسی ماهالانوبیس؟ | نه | نه | بله |
| از دست رفتن اطلاعات | هیچ | اگر مؤلفه نگه داشته شود | در رتبهٔ کامل هیچ |
آنکه فاصلهٔ اقلیدسی را معنادار میکند سفیدسازی است: پس از استانداردسازی ویژگیها هنوز در جهتهای همبسته واریانسهای مختلف دارند و پس از PCA محورها هنوز واریانسهای را دارند. تنها وقتی هر جهت واریانس 1 دارد، کرهٔ اقلیدسی به کانتور چگالی احتمال ثابت تبدیل میشود.
نمایش: PCA در برابر سفیدسازی
سلول بعد هر دو تبدیل را روی همان ابر نقطهها اعمال میکند و سه فاصلهٔ یک نقطهٔ آزمون را چاپ میکند.
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import multivariate_normal

np.random.seed(42)

# ============================================================================
# 1. GENERATE CORRELATED DATA
# ============================================================================
mean = np.array([0, 0])
cov_original = np.array([[4, 3], [3, 4]])  # Correlated data
n_samples = 500
data_original = np.random.multivariate_normal(mean, cov_original, n_samples)
# print(f"Original data shape: {data_original.shape}")  # (500, 2)

# ============================================================================
# 2. PREPARE TRANSFORMATIONS
# ============================================================================
eigenvalues, eigenvectors = np.linalg.eigh(cov_original)
idx = np.argsort(eigenvalues)[::-1]
eigenvalues = eigenvalues[idx]
eigenvectors = eigenvectors[:, idx]

# PCA Transformation (Rotation Only)
# Correct: Keep shape (n_samples, n_features)
data_pca = (data_original - mean) @ eigenvectors

# Whitening Transformation (Rotation + Scaling)
scale_factors = 1.0 / np.sqrt(eigenvalues)
data_whitened = data_pca @ np.diag(scale_factors)

# print(f"PCA data shape: {data_pca.shape}")  # (500, 2)
# print(f"Whitened data shape: {data_whitened.shape}")  # (500, 2)

# ============================================================================
# 3. COMPUTE COVARIANCES
# ============================================================================
cov_original_computed = np.cov(data_original, rowvar=False)
cov_pca = np.cov(data_pca, rowvar=False)
cov_white = np.cov(data_whitened, rowvar=False)

# print(f"\nCovariance shapes:")
# print(f"Original: {cov_original_computed.shape}")  # (2, 2)
# print(f"PCA: {cov_pca.shape}")  # (2, 2)
# print(f"Whitened: {cov_white.shape}")  # (2, 2)

# ============================================================================
# 4. VISUALIZATION
# ============================================================================
print("\n" + "=" * 70)
print("COMPARISON: Original → PCA → Whitening")
print("=" * 70)

fig, axes = plt.subplots(1, 3, figsize=(18, 6))

# --- Plot 1: Original ---
axes[0].scatter(data_original[:, 0], data_original[:, 1], alpha=0.5, s=20, color='blue')
x, y = np.mgrid[-6:6:100j, -6:6:100j]
pos = np.dstack((x, y))
axes[0].contour(x, y, multivariate_normal(mean, cov_original_computed).pdf(pos), levels=3, colors='darkblue')
axes[0].set_title('Original Data\n(Correlated Ellipse)')
axes[0].set_xlabel('Feature 1'); axes[0].set_ylabel('Feature 2')
axes[0].grid(True, alpha=0.3); axes[0].axis('equal')

# --- Plot 2: PCA (Rotation Only) ---
axes[1].scatter(data_pca[:, 0], data_pca[:, 1], alpha=0.5, s=20, color='green')
x, y = np.mgrid[-5:5:100j, -5:5:100j]
pos = np.dstack((x, y))
axes[1].contour(x, y, multivariate_normal(np.zeros(2), cov_pca).pdf(pos), levels=3, colors='darkgreen')
axes[1].set_title('PCA (Rotation Only)\n(Axis-Aligned Ellipse)')
axes[1].set_xlabel('Principal Comp 1'); axes[1].set_ylabel('Principal Comp 2')
axes[1].grid(True, alpha=0.3); axes[1].axis('equal')

# --- Plot 3: Whitening (Rotation + Scaling) ---
axes[2].scatter(data_whitened[:, 0], data_whitened[:, 1], alpha=0.5, s=20, color='red')
x, y = np.mgrid[-3:3:100j, -3:3:100j]
pos = np.dstack((x, y))
axes[2].contour(x, y, multivariate_normal(np.zeros(2), cov_white).pdf(pos), levels=3, colors='darkred')
axes[2].set_title('Whitening (Rotation + Scaling)\n(Perfect Sphere)')
axes[2].set_xlabel('Whitened 1'); axes[2].set_ylabel('Whitened 2')
axes[2].grid(True, alpha=0.3); axes[2].axis('equal')

plt.tight_layout()
plt.show()

# ============================================================================
# 5. DISTANCE COMPARISON
# ============================================================================
print("\n" + "=" * 70)
print("Distance Metrics for a Test Point")
print("=" * 70)

test_point = np.array([2.0, 1.0])
inv_cov = np.linalg.inv(cov_original)
mahal_dist = np.sqrt((test_point - mean) @ inv_cov @ (test_point - mean))

# Euclidean in PCA space
test_pca = (test_point - mean) @ eigenvectors
euclid_pca = np.linalg.norm(test_pca)

# Euclidean in Whitened space
test_white = test_pca @ np.diag(scale_factors)
euclid_white = np.linalg.norm(test_white)

print(f"\nTest Point: {test_point}")
print(f"Mahalanobis Distance (Original): {mahal_dist:.4f}")
print(f"Euclidean Distance (PCA Space):  {euclid_pca:.4f}")
print(f"Euclidean Distance (White Space): {euclid_white:.4f}")

print("\nConclusion: only whitening keeps the Euclidean distance equal to the Mahalanobis one.")
======================================================================
COMPARISON: Original → PCA → Whitening
======================================================================
======================================================================
Distance Metrics for a Test Point
======================================================================

Test Point: [2. 1.]
Mahalanobis Distance (Original): 1.0690
Euclidean Distance (PCA Space):  2.2361
Euclidean Distance (White Space): 1.0690

Conclusion: only whitening keeps the Euclidean distance equal to the Mahalanobis one.
چرا این برای فاصلهٔ ماهالانوبیس مهم است
PCA داده را با محورهای اصلی همراستا میکند ولی واریانسهای مختلف در آن محورها را نگه میدارد. اگر در فضای PCA فاصلهٔ اقلیدسی بسنجید، نقطهای 2 واحد دور در محور پُرواریانس با نقطهای 2 واحد دور در محور کمواریانس یکسان گرفته میشود. این احتمال آماری را کج میکند.
سفیدسازی واریانسها را نرمال میکند. در این فضا 1 واحد در هر جهت برابر 1 انحراف معیار است. پس فاصلهٔ اقلیدسی در فضای سفیدشده بهدرستی «غافلگیری» آماری نقطه (فاصلهٔ ماهالانوبیس) را نشان میدهد.
نتیجه
فاصلهٔ ماهالانوبیس تعمیم طبیعی امتیاز z به چند بُعد است. از راه ماتریس کوواریانس، مقیاس هر ویژگی و همبستگی میان ویژگیها را در نظر میگیرد، کاری که فاصلهٔ اقلیدسی نمیتواند. به کار میرود در
آشکارسازی ناهنجاری: علامتگذاری نقطههایی که از نظر آماری نامحتملاند، در برابر یک چندک ؛
دستهبندی: توان ممیز گاوسی نظریهٔ تصمیم بیزی است که پارامترهایش از صفحهٔ MLE میآیند؛
پیشپردازش: سفیدسازی، که پس از آن ابزارهای اقلیدسی معتبر میشوند.
نکتههای کلیدی
فاصلهٔ اقلیدسی دادهٔ کرهگون را فرض میکند؛ فاصلهٔ ماهالانوبیس دادهٔ بیضیگون را.
ماتریس کوواریانس شکل، مقیاس و جهتگیری توزیع را حمل میکند.
سفیدسازی را به میبرد و ابر نقطهها را کره میکند.
اگر آنگاه ؛ برای این برابر است.
در فضای سفیدشده فاصلهٔ اقلیدسی برابر فاصلهٔ ماهالانوبیس است؛ استانداردسازی هرویژگی این را به دست نمیآورد، چون همبستگیها را نگه میدارد.
منابع
Duda et al. (2000)
Duda, R. O., Hart, P. E., & Stork, D. G. (2000). Pattern Classification (2nd ed.). Wiley-Interscience, chapter 2.
- Duda, R. O., Hart, P. E., & Stork, D. G. (2000). Pattern Classification (2nd ed.). Wiley-Interscience.