رگرسیون کرنلی: از مدلسازی خطی به ناخطی
1. بنیاد رگرسیون خطی
هدف رگرسیون پیشبینی یک خروجی پیوسته از ویژگیهای ورودی با تابعی آموختهشده است:
که نوفهٔ تصادفی را نشان میدهد.
در رگرسیون خطی فرض میکنیم خطی است:
(جملهٔ بایاس را میتوان با افزودن یک ثابت 1 به در گنجاند.)
پارامترهای مجموع مربع خطا را کمینه میکنند:
2. رگرسیون کرنلی: ایدهٔ اصلی
2.1 چرا کرنل؟
دادهٔ دنیای واقعی اغلب الگوهای ناخطی دارد که مدلهای خطی نمیتوانند بگیرند. راهحل: نگاشت هر ورودی به فضای ویژگی پرابعاد که در آن رابطه خطی میشود:
چالش: حساب کردن صریح میتواند از نظر محاسباتی ناممکن یا حتی بینهایتبعد باشد.
ترفند کرنل: از تابع کرنل استفاده کنید که ضرب داخلی در فضای ویژگی را حساب میکند بدون آنکه هرگز صریحاً ساخته شود:
2.2 صورت دوگان
با ترفند کرنل، تابع رگرسیون مجموع وزنی شباهتهای کرنلی به هر نقطهٔ آموزش میشود:
که:
وزنهای آموختهشده از دادهاند
شباهت میان نقطهٔ آزمون و نقطهٔ آموزش را میسنجد
تفسیر: پیشبینی میانگینی وزنی از خروجیهای آموزش است که وزنهایش بهجای میانگین ساده، آموخته میشوند.
3. آموزش: حل برای 
3.1 مسئلهٔ بهینهسازی
را با برازش دادهٔ آموزش یاد میگیریم:
3.2 صورت ماتریسی
تعریف کنید:
ماتریس کرنل (اندازهٔ ):
بردار وزن
بردار خروجی
برای همهٔ نقطههای آموزش، پیشبینیها چنیناند:
مجموع مربع خطا چنین میشود:
3.3 جواب
مشتق را میگیریم و صفر میگذاریم:
چون متقارن است ():
اگر وارونپذیر باشد (کرنل مثبت معین با نقطههای متمایز)، در ضرب کنید:
پس:
نکتهٔ کلیدی: وزنهای چنان برگزیده میشوند که پیشبینیهای آموزش دقیقاً با خروجیهای آموزش بخوانند (). این درونیابی دقیق است.
4. پیشبینی روی دادهٔ تازه
4.1 یک نقطهٔ آزمون
برای نقطهٔ آزمون تازه (که در مجموعهٔ آموزش نیست):
گام 1: شباهتهای کرنلی میان و همهٔ نقطههای آموزش را حساب کنید:
گام 2: با همان فرمول پیشبینی کنید:
4.2 چند نقطهٔ آزمون
برای نقطهٔ آزمون :
را ماتریسی تعریف کنید:
آنگاه پیشبینیها:
4.3 خلاصهٔ آموزش در برابر آزمون
| مرحله | ورودی | پیشبینی | برابر واقعی؟ |
|---|---|---|---|
| آموزش | () | بله (برازش دقیق) | |
| آزمون | () | نه (تعمیم) |
مهم: ویژگی درونیابی فقط برای دادهٔ آموزش برقرار است. برای نقطههای آزمون، پیشبینیها با شباهت به نقطههای آموزش تعیین میشوند، نه با تطبیق دقیق.
5. پیوند با شبهوارون
5.1 نگاه یکپارچه
از پیوست ماتریسها به یاد آورید شبهوارون معادلهٔ را بهینه حل میکند. برای رگرسیون کرنلی را حل میکنیم، پس:
وقتی وارونپذیر است، . وقتی تکین یا بدشرط باشد، از تنظیمکننده استفاده میکنیم.
5.2 تنظیمکننده (رگرسیون ریج کرنلی)
در عمل، با دادهٔ نوفهدار، درونیابی دقیق به بیشبرازش میانجامد. جملهٔ جریمهٔ ریج را بیفزایید:
جواب چنین میشود:
این برآوردگر ریج کرنلی است. جملهٔ تنظیمکننده:
پایداری عددی را بهتر میکند (وارونپذیری را تضمین میکند)
با کوچک کردن وزنها از بیشبرازش جلو میگیرد
همواری تابع پیشبینی را کنترل میکند
تمرین عملی
import numpy as np
from sklearn.metrics.pairwise import rbf_kernel
import matplotlib.pyplot as plt

# Generate synthetic data
X = np.linspace(-3, 3, 100)[:, None]
y = np.sin(X).ravel() + 0.05*np.random.randn(100)

# Compute RBF kernel (σ=1.0)
K = rbf_kernel(X, X, gamma=0.5)

# Solve for coefficients (with small regularization)
alpha = np.linalg.solve(K + 1e-6*np.eye(len(X)), y)

# Predict new points
X_test = np.linspace(-3.1, 3.1, 200)[:, None]
K_test = rbf_kernel(X_test, X, gamma=0.5)
y_pred = K_test @ alpha

# Plot results
plt.figure(figsize=(8, 4))
plt.scatter(X, y, color='blue', label='Training Data', alpha=0.5)
plt.plot(X_test, y_pred, color='red', label='Kernel Regression')
plt.title('Kernel Regression with RBF Kernel')
plt.legend()
plt.show()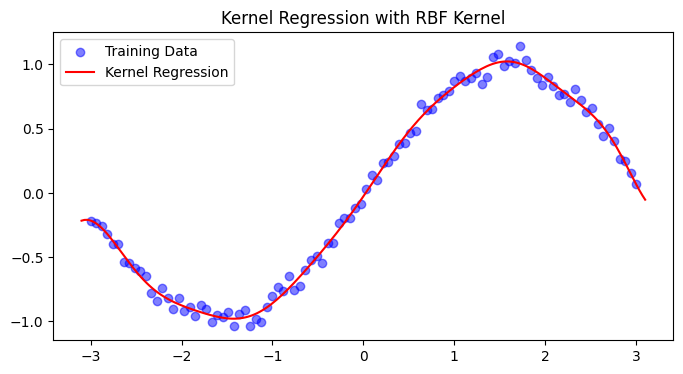
6. اثر تنظیمکننده و سطح نوفه بر رگرسیون کرنلی
Source
import numpy as np
from sklearn.metrics.pairwise import rbf_kernel
import matplotlib.pyplot as plt

# Set random seed for reproducibility
np.random.seed(42)

# --- Generate synthetic data ---
n_train = 50  # Number of training points
X = np.linspace(-3, 3, n_train)[:, None]
true_function = np.sin(X).ravel()  # Underlying smooth function

# --- Create figure with subplots ---
fig, axes = plt.subplots(2, 3, figsize=(15, 10))
fig.suptitle('Kernel Regression: Effects of Regularization and Noise', fontsize=16)

# Parameters to test
noise_levels = [0.0, 0.1]#, 1.0]  # Zero, low, high noise
lambda_regs = [0, 1e-6, 1e-1]    # No regularization, weak, strong

# Store results for comparison
results = {}

for i, noise in enumerate(noise_levels):
    for j, lambda_reg in enumerate(lambda_regs):
        # Generate noisy training data
        y = true_function + noise * np.random.randn(n_train)

        # --- Training ---
        # Compute RBF kernel matrix (gamma = 0.5)
        gamma = 0.5
        K = rbf_kernel(X, X, gamma=gamma)

        # Solve for alpha with or without regularization
        if lambda_reg == 0:
            # No regularization - direct inversion (may be unstable)
            try:
                alpha = np.linalg.solve(K, y)
                reg_status = "No regularization"
            except np.linalg.LinAlgError:
                alpha = np.linalg.pinv(K) @ y  # Use pseudoinverse if singular
                reg_status = "No regularization (pseudoinverse)"
        else:
            alpha = np.linalg.solve(K + lambda_reg * np.eye(n_train), y)
            reg_status = f"λ = {lambda_reg}"

        # --- Testing ---
        X_test = np.linspace(-3.5, 3.5, 300)[:, None]
        K_test = rbf_kernel(X_test, X, gamma=gamma)
        y_pred = K_test @ alpha

        # True function on test points
        y_true_test = np.sin(X_test).ravel()

        # Calculate test error
        test_mse = np.mean((y_pred - y_true_test)**2)

        # --- Plot ---
        ax = axes[i, j]
        ax.scatter(X, y, color='blue', alpha=0.6, s=30, label='Training data')
        ax.plot(X_test, y_true_test, 'k--', linewidth=2, label='True function', alpha=0.7)
        ax.plot(X_test, y_pred, 'r-', linewidth=2, label='Kernel regression')
        ax.set_xlabel('x')
        ax.set_ylabel('y')
        ax.grid(True, alpha=0.3)

        # Add title with parameters
        title = f"Noise σ = {noise}\n{reg_status}"
        ax.set_title(title)

        # Display MSE in the corner
        ax.text(0.05, 0.95, f'MSE = {test_mse:.4f}',
                transform=ax.transAxes, verticalalignment='top',
                bbox=dict(boxstyle='round', facecolor='wheat', alpha=0.5))

        # Add legend only for first plot
        if i == 0 and j == 0:
            ax.legend(loc='upper right')

        # Store results
        results[(noise, lambda_reg)] = {'mse': test_mse, 'alpha': alpha}

plt.tight_layout()
plt.show()


# --- Print summary table ---
print("\n" + "="*70)
print("SUMMARY: Test MSE for different noise levels and regularization")
print("="*70)
print(f"{'Noise σ':<10} {'λ = 0':<20} {'λ = 1e-6':<20} {'λ = 0.1':<20}")
print("-"*70)

for noise in noise_levels:
    row = f"{noise:<10}"
    for lambda_reg in lambda_regs:
        mse = results[(noise, lambda_reg)]['mse']
        row += f"{mse:<20.6f}"
    print(row)
print("="*70)

# --- Interpretation guide ---
print("\n" + "📊 INTERPRETATION GUIDE 📊".center(70))
print("="*70)
print("1. NOISE σ = 0 (No noise):")
print("   - λ = 0: Perfect fit (MSE ≈ 0) - model interpolates exactly")
print("   - λ > 0: Slight bias introduced, but still good fit")
print("\n2. NOISE σ = 0.1 (Low noise):")
print("   - λ = 0: May overfit slightly, capturing noise patterns")
print("   - λ = 1e-6: Balances fit and smoothness")
print("   - λ = 0.1: May underfit (too smooth)")
print("\n💡 KEY INSIGHT:")
print("   - More noise → need stronger regularization (larger λ)")
print("   - No noise → λ = 0 gives perfect interpolation")
print("   - Too much regularization → underfitting (bias)")
print("   - Too little regularization → overfitting (variance)")
print("="*70)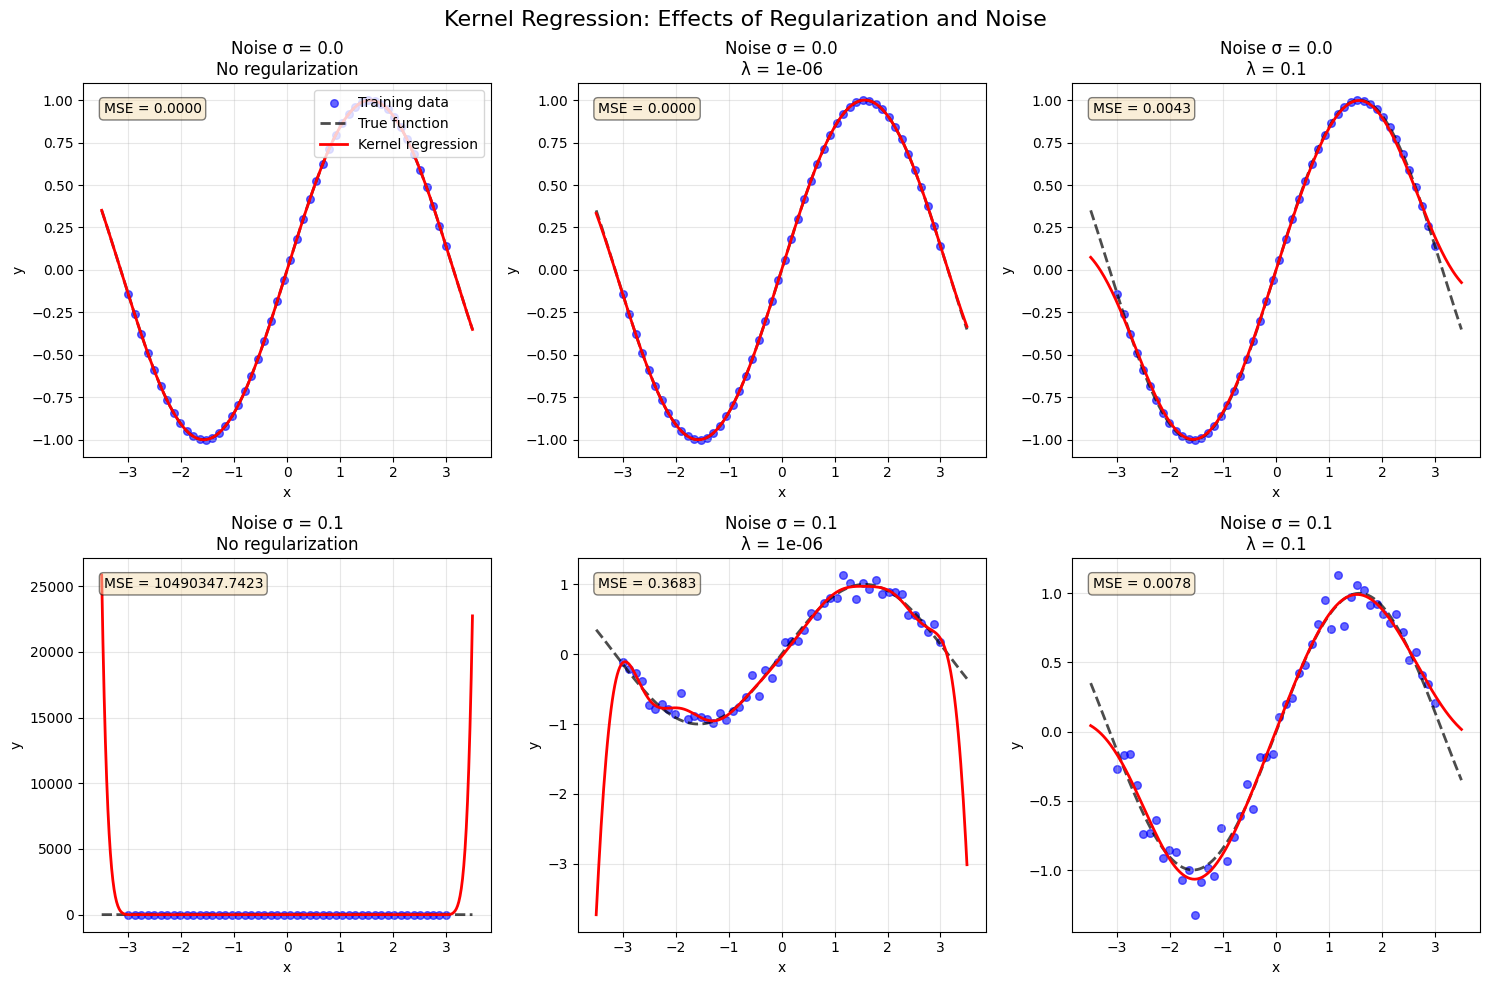
======================================================================
SUMMARY: Test MSE for different noise levels and regularization
======================================================================
Noise σ    λ = 0                λ = 1e-6             λ = 0.1
----------------------------------------------------------------------
0.0       0.000000            0.000008            0.004277
0.1       10490347.742265     0.368313            0.007773
======================================================================

                       📊 INTERPRETATION GUIDE 📊
======================================================================
1. NOISE σ = 0 (No noise):
   - λ = 0: Perfect fit (MSE ≈ 0) - model interpolates exactly
   - λ > 0: Slight bias introduced, but still good fit

2. NOISE σ = 0.1 (Low noise):
   - λ = 0: May overfit slightly, capturing noise patterns
   - λ = 1e-6: Balances fit and smoothness
   - λ = 0.1: May underfit (too smooth)

💡 KEY INSIGHT:
   - More noise → need stronger regularization (larger λ)
   - No noise → λ = 0 gives perfect interpolation
   - Too much regularization → underfitting (bias)
   - Too little regularization → overfitting (variance)
======================================================================
7. نگاه اولیه در برابر نگاه دوگان
7.1 دو شکل جواب
در رگرسیون خطی استاندارد با ویژگیهای ، بردار وزن را میتوان به دو شکل همارز نوشت:
صورت اولیه (فضای ویژگی):
صورت دوگان (فضای نمونه):
هر دو وقتی رتبهٔ ستونی کامل دارد همان پیشبینیها را میدهند.
7.2 چرا صورت دوگان برای کرنل مهم است
صورت دوگان نشان میدهد ترکیبی خطی از نمونههای آموزش است:
وقتی به فضای ویژگی نگاشت میکنیم، این چنین میشود:
که .
نکتهٔ کلیدی: پیشبینی برای نقطهٔ تازه چنین میشود:
هرگز به صریح نیاز نداریم — فقط به مقدارهای کرنل !
7.3 مبادلههای محاسباتی
| سناریو | صورت اولیه | صورت دوگان |
|---|---|---|
| (نمونهٔ کم، ویژگی زیاد) | کند (وارون ) | سریع (وارون ) |
| (نمونهٔ زیاد، ویژگی کم) | سریع (وارون ) | کند (وارون ) |
| کرنلهای ناخطی (RBF، چندجملهای) | کاربرد ندارد | لازم است (ترفند کرنل) |
مثال: کرنل RBF با نمونه عملاً ویژگیهای بینهایتبعد () به کار میبرد:
صورت اولیه ناممکن است (نمیتوان را صریح حساب کرد)
صورت دوگان با ماتریس کرنل کار میکند
8. نکتههای کلیدی
رگرسیون کرنلی برازش ناخطی را ممکن میکند، با نگاشت ضمنی داده به فضاهای پرابعاد
صورتبندی دوگان پیشبینیها را بهصورت مجموع وزنی شباهتهای کرنلی مینویسد:
آموزش (بدون تنظیم) یا (با تنظیم) را حل میکند
آزمون از استفاده میکند، که شباهتهای میان نقطههای آزمون و آموزش را دارد
تنظیمکننده () برای اینها ضروری است:
پایداری عددی (تضمین وارونپذیری )
جلوگیری از بیشبرازش به نوفه
انتخاب کرنل انعطاف مدل را کنترل میکند:
کرنل خطی رگرسیون خطی استاندارد
کرنل RBF تقریب هموار و محلی
کرنل چندجملهای جملههای تعاملی تا درجهٔ