نقشههای ویژگی: پلی به روشهای هسته
1. مقدمهای بر نقشههای ویژگی
یک نقشهٔ ویژگی دادهٔ ورودی را به فضایی با ابعاد بالاتر میبرد:
انگیزهٔ اصلی: توانمند کردن مدلهای خطی برای حل مسئلههای ناخطی، از راه:
نگاشت صریح برای دستهبندی/خوشهبندی
بسط پایه برای رگرسیون
برای روشهای پیشرفتهٔ ساختن ویژگی، MathFeatures در Feature-Engine را ببینید.
Source
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_circles
from sklearn.linear_model import Perceptron
from sklearn.cluster import KMeans
from mpl_toolkits.mplot3d import Axes3D

# 1. Generate Two-Ring Dataset
X, y = make_circles(n_samples=800, noise=0.07, factor=0.4, random_state=42)

# Create a figure with two subplots side-by-side
fig, axes = plt.subplots(1, 2, figsize=(15, 6)) # Adjusted figsize for better side-by-side view
# 2. Visualize Original 2D Data (on the first subplot)
axes[0].scatter(X[y == 0, 0], X[y == 0, 1], color='red', alpha=0.6, label='Class 0')
axes[0].scatter(X[y == 1, 0], X[y == 1, 1], color='blue', alpha=0.6, label='Class 1')
axes[0].set_title("Two-Ring Dataset in 2D Space")
axes[0].set_xlabel("Feature 1")
axes[0].set_ylabel("Feature 2")
axes[0].legend()
axes[0].grid(True)
# 3. Apply Perceptron (Linear Classifier)
perceptron = Perceptron(max_iter=1000, random_state=42)
perceptron.fit(X, y)

# Create decision boundary grid
xx, yy = np.meshgrid(np.linspace(-1.5, 1.5, 200), np.linspace(-1.5, 1.5, 200))
Z = perceptron.decision_function(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

# Plot Perceptron Classification (on the second subplot)
axes[1].contourf(xx, yy, Z, levels=[-1, 0, 1], alpha=0.4, cmap='RdBu')
axes[1].scatter(X[y == 0, 0], X[y == 0, 1], color='red', alpha=0.6, label='Class 0')
axes[1].scatter(X[y == 1, 0], X[y == 1, 1], color='blue', alpha=0.6, label='Class 1')
axes[1].set_title("Perceptron Classification in 2D (Fails to Separate)")
axes[1].set_xlabel("Feature 1")
axes[1].set_ylabel("Feature 2")
axes[1].legend()

# Adjust layout and display the combined plot
plt.tight_layout()
plt.show()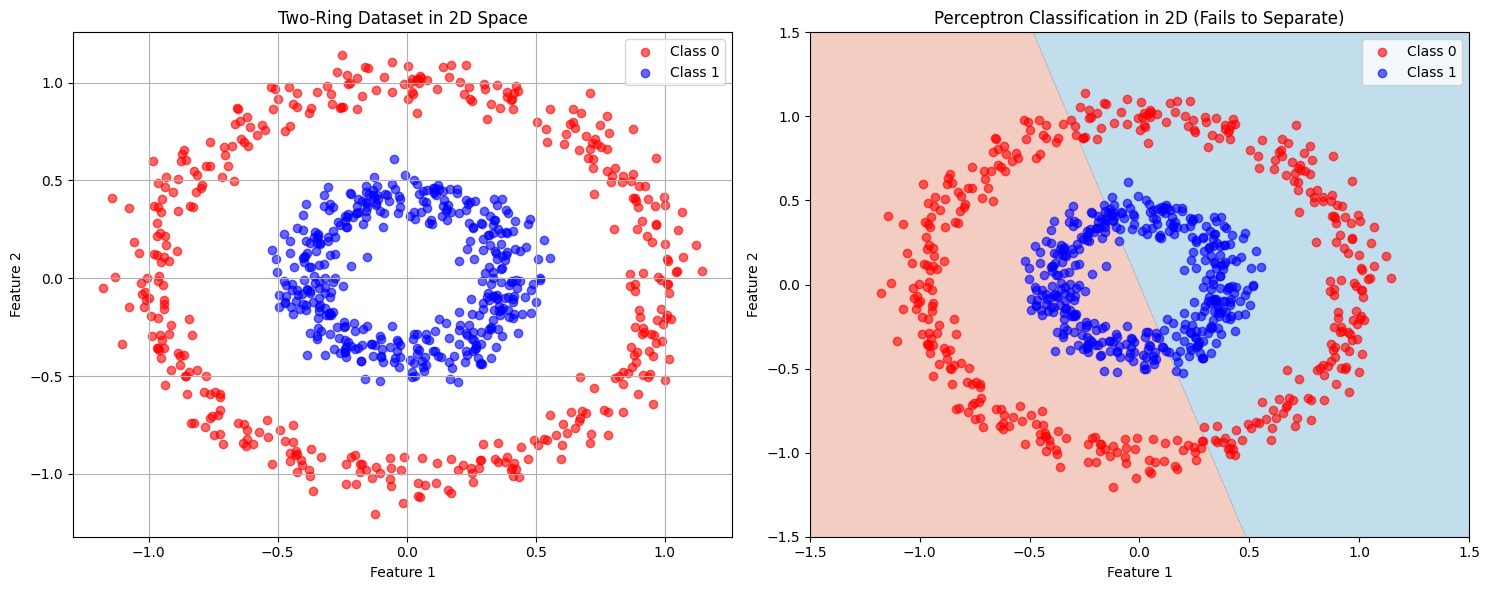
نگاشت با تبدیل فاصلهٔ شعاعی به یک ویژگی خطی، دستهها را خطیجداپذیر میکند.
# Transform to 3D (z = x² + y²)
X_3d = np.column_stack((X[:, 0], X[:, 1], X[:, 0]**2 + X[:, 1]**2))

# Perceptron in 3D
perceptron.fit(X_3d, y)
Output
Source
import matplotlib.pyplot as plt
# %matplotlib notebook
# Plot in 3D
fig = plt.figure(figsize=(10, 7))
ax = fig.add_subplot(111, projection='3d')
ax.scatter(X_3d[y==0, 0], X_3d[y==0, 1], X_3d[y==0, 2],
           color='red', label='Class 0', alpha=0.6, s=20)
ax.scatter(X_3d[y==1, 0], X_3d[y==1, 1], X_3d[y==1, 2],
           color='blue', label='Class 1', alpha=0.6, s=20)

# Add optimal separating plane
xx, yy = np.meshgrid(np.linspace(-1.5, 1.5, 20), np.linspace(-1.5, 1.5, 20))
zz = np.full(xx.shape, 0.5)  # Plane at z=0.5 (optimal boundary)
ax.plot_surface(xx, yy, zz, alpha=0.3, color='green')

ax.set_title("Linearly Separable in 3D Space")
ax.set_xlabel("Feature 1 (x)")
ax.set_ylabel("Feature 2 (y)")
ax.set_zlabel("Feature 3 (x² + y²)")
ax.legend()
plt.show()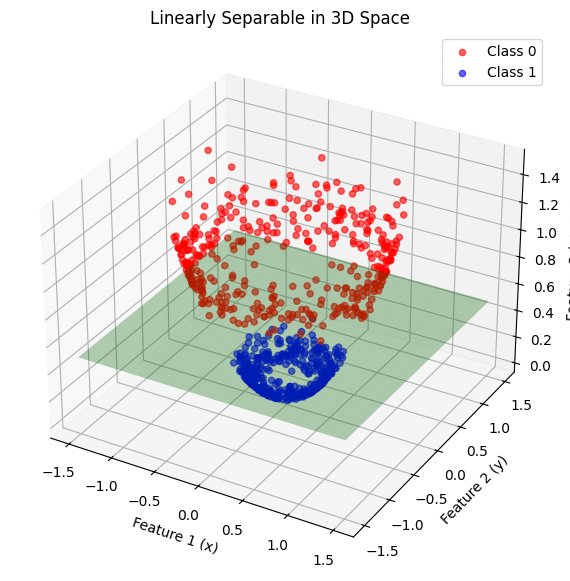
Source
import plotly.graph_objects as go

fig = go.Figure(data=[
    go.Scatter3d(
        x=X_3d[y==0, 0], y=X_3d[y==0, 1], z=X_3d[y==0, 2],
        mode='markers', marker=dict(size=3, color='red'), name='Class 0'
    ),
    go.Scatter3d(
        x=X_3d[y==1, 0], y=X_3d[y==1, 1], z=X_3d[y==1, 2],
        mode='markers', marker=dict(size=3, color='blue'), name='Class 1'
    ),
    go.Surface(
        x=xx, y=yy, z=zz, opacity=0.3, colorscale='Greens', showscale=False
    )
])

fig.update_layout(
    title="Linearly Separable in 3D Space (Interactive)",
    scene=dict(
        xaxis_title='Feature 1 (x)',
        yaxis_title='Feature 2 (y)',
        zaxis_title='Feature 3 (x² + y²)'
    )
)
fig.show()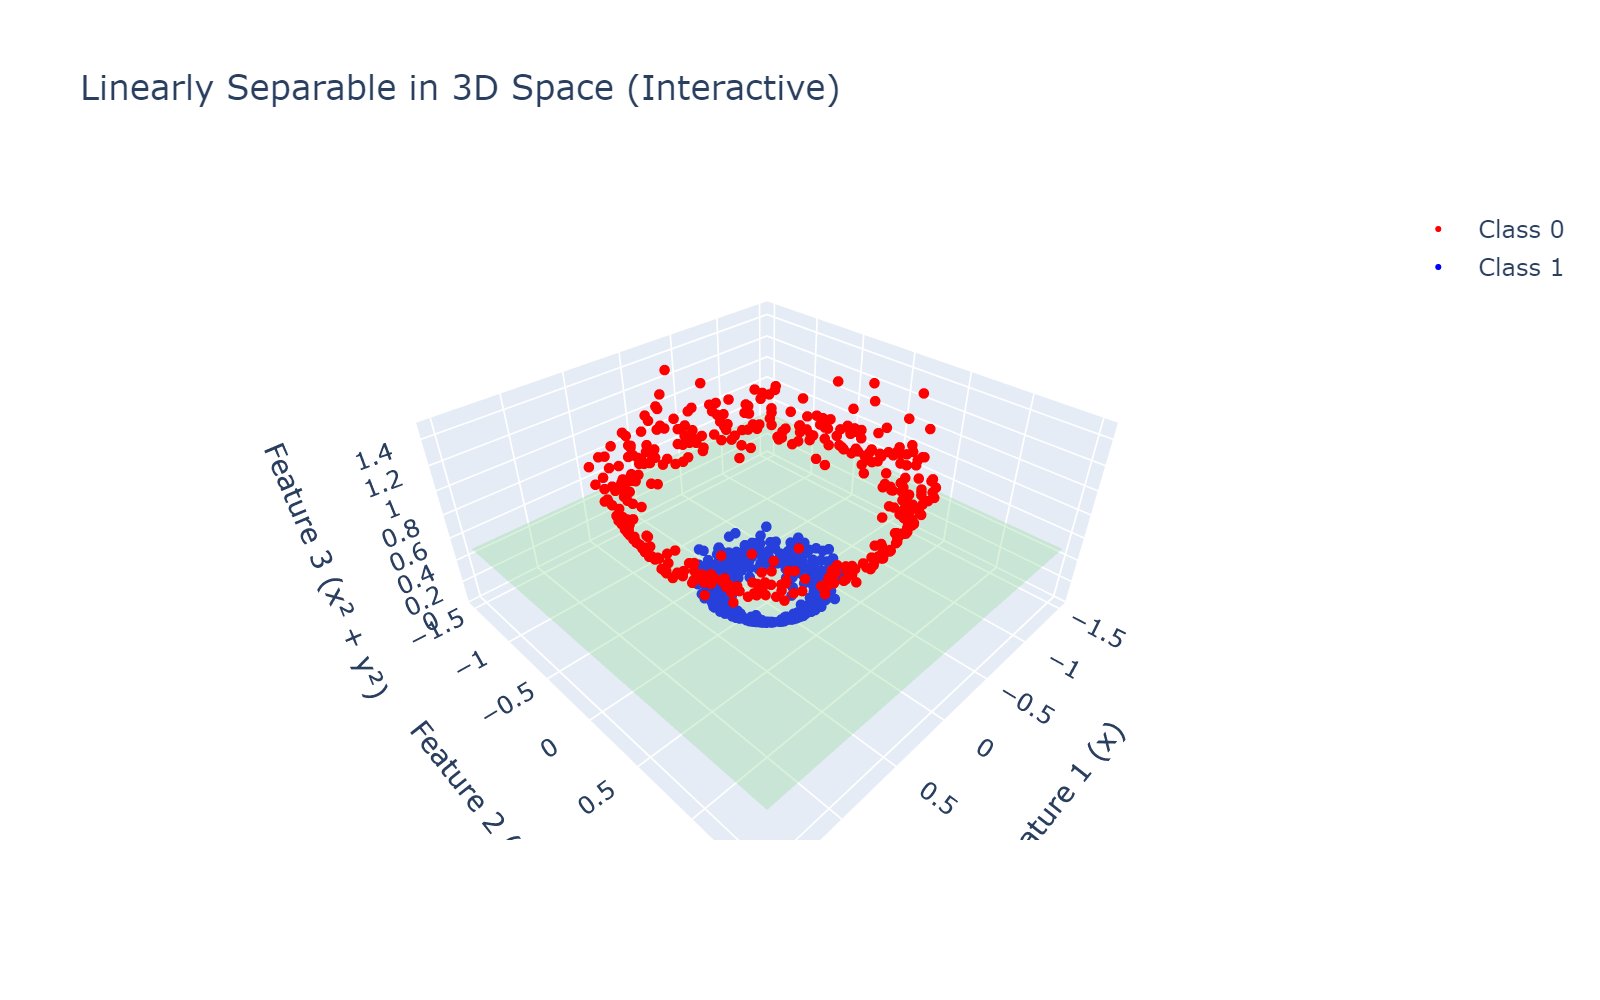
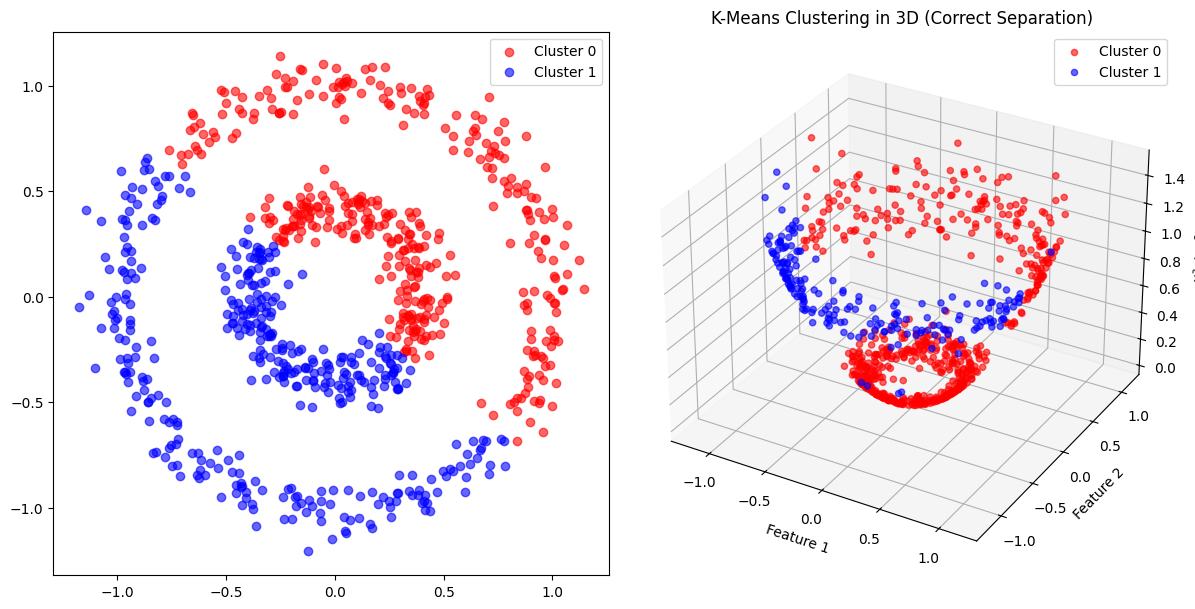
3. خوشهبندی: مسئلهٔ دو حلقه
Source
# Apply K-Means Clustering in 2D
kmeans = KMeans(n_clusters=2, random_state=42)
kmeans.fit(X)
cluster_labels = kmeans.labels_

fig = plt.figure(figsize=(12, 6))
ax1 = fig.add_subplot(121)
# plt.figure(figsize=(10, 5))
ax1.scatter(X[cluster_labels == 0, 0], X[cluster_labels == 0, 1], color='red', alpha=0.6, label='Cluster 0')
ax1.scatter(X[cluster_labels == 1, 0], X[cluster_labels == 1, 1], color='blue', alpha=0.6, label='Cluster 1')
ax1.legend()

# Transform to 3D (z = x² + y²)
X_3d = np.column_stack((X[:, 0], X[:, 1], X[:, 0]**2 + X[:, 1]**2))
# 7. K-Means in 3D
# kmeans_3d = KMeans(n_clusters=2, random_state=42)
kmeans.fit(X_3d)
cluster_labels_3d = kmeans.labels_

# K-Means results in 3D
ax2 = fig.add_subplot(122, projection='3d')
ax2.scatter(X_3d[cluster_labels_3d == 0, 0],
            X_3d[cluster_labels_3d == 0, 1],
            X_3d[cluster_labels_3d == 0, 2], color='red', alpha=0.6, label='Cluster 0')
ax2.scatter(X_3d[cluster_labels_3d == 1, 0],
            X_3d[cluster_labels_3d == 1, 1],
            X_3d[cluster_labels_3d == 1, 2], color='blue', alpha=0.6, label='Cluster 1')
ax2.set_title("K-Means Clustering in 3D (Correct Separation)")
ax2.set_xlabel("Feature 1")
ax2.set_ylabel("Feature 2")
ax2.set_zlabel("x² + y²")
ax2.legend()

plt.tight_layout()
plt.show()
4. مثال رگرسیون: استفاده از نقشهٔ ویژگی برای دادهٔ ناخطی
هدف: نشان دادن اینکه نگاشت ویژگیها به فضایی با ابعاد بالاتر چگونه به یک مدل خطی اجازه میدهد دادهٔ ناخطی را برازش کند.
انگیزه: مدلهای رگرسیون خطی استاندارد رابطهٔ خطی میان ویژگیها (متغیرهای مستقل) و هدف (متغیر وابسته) را فرض میکنند. وقتی رابطهٔ زیربنایی ناخطی باشد چه میشود؟ یک مدل خطی ساده ضعیف عمل میکند.
سناریویی را در نظر بگیرید که داده از یک منحنی پیروی میکند، مثلاً رابطهای درجهدوم. یک خط راست (از رگرسیون خطی) این منحنی را خوب نمیگیرد.
ایدهٔ حل: میتوانیم ویژگیهای اصلی را به فضایی با ابعاد بالاتر ببریم که در آن رابطه خطی میشود. این تبدیل نقشهٔ ویژگی نام دارد و با Φ نشان داده میشود.
بیایید با یک مثال نشان دهیم.
4.1 تولید دادهٔ ناخطی
دادهٔ مصنوعی میسازیم که در آن y بهصورت درجهدوم به x وابسته است، بهعلاوهٔ کمی نوفهٔ تصادفی تا
واقعیتر شود.
Source
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures

np.random.seed(42)

# Generate data points
m = 100 # number of samples
X = 6 * np.random.rand(m, 1) - 3 # Feature values between -3 and 3
y = 0.5 * X**2 + X + 2 + np.random.randn(m, 1) # Quadratic relationship + noise

# Visualize the generated data
plt.figure(figsize=(8, 6))
plt.scatter(X, y, alpha=0.7)
plt.title("Generated Non-Linear Data (Quadratic Relationship)")
plt.xlabel("Feature (x)")
plt.ylabel("Target (y)")
plt.grid(True)
plt.show()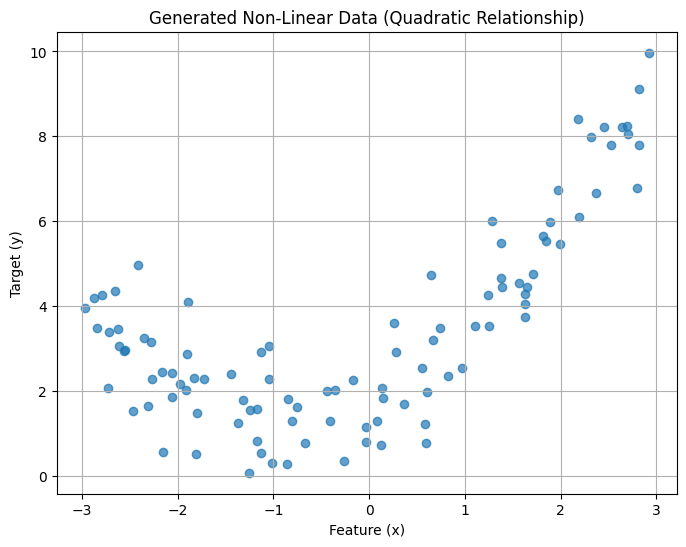
همانطور که میبینید، داده آشکارا از یک منحنی پیروی میکند، نه از یک خط راست.
4.2 تلاش برای رگرسیون خطی ساده (فضای اصلی)
ببینیم یک مدل رگرسیون خطی استاندارد بدون هیچ تبدیل ویژگی روی این داده چگونه عمل میکند.
Source
# Train a simple linear regression model
lin_reg = LinearRegression()
lin_reg.fit(X, y)

# Make predictions
X_new = np.linspace(-3, 3, 100).reshape(100, 1) # Points for plotting the line
y_pred_linear = lin_reg.predict(X_new)

# Visualize the fit
plt.figure(figsize=(8, 6))
plt.scatter(X, y, alpha=0.7, label="Data Points")
plt.plot(X_new, y_pred_linear, "r-", linewidth=2, label="Linear Regression Fit")
plt.title("Simple Linear Regression on Non-Linear Data")
plt.xlabel("Feature (x)")
plt.ylabel("Target (y)")
plt.legend()
plt.grid(True)
plt.show()

print(f"Linear Regression Score (R^2): {lin_reg.score(X, y):.4f}")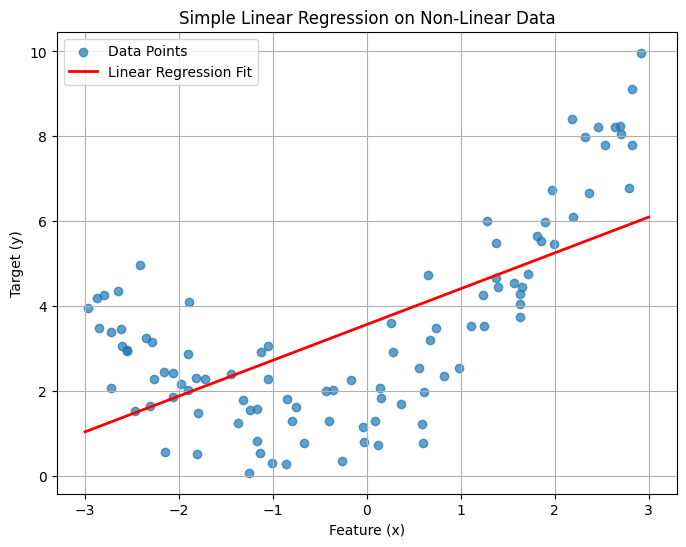
Linear Regression Score (R^2): 0.4260
مدل خطی نهایت تلاشش را میکند تا خطی راست را از دادهٔ منحنی بگذراند، ولی آشکارا برازش ضعیفی است. امتیاز R² احتمالاً پایین است، که نشان میدهد مدل واریانس داده را زیاد توضیح نمیدهد.
4.3 اعمال یک نقشهٔ ویژگی (ویژگیهای چندجملهای)
حالا یک نقشهٔ ویژگی اعمال میکنیم. چون میدانیم رابطهٔ زیربنایی درجهدوم است (y ≈ ax² + bx + c)،
نقشهٔ ویژگی مناسبی مثل Φ ویژگی تکتای x ما را به دو ویژگی تبدیل میکند: x و x².
پس Φ(x) = [x, x²].
این کار را با PolynomialFeatures در Scikit-Learn انجام میدهیم.
# Create polynomial features (degree=2 includes x and x^2)
# include_bias=False because LinearRegression handles the intercept (bias) term
poly_features = PolynomialFeatures(degree=2, include_bias=False)
X_poly = poly_features.fit_transform(X)

# Display the original feature and the transformed features for the first few samples
print("Original X (first 5 samples):\n", X[:5])
print("\nTransformed X_poly (first 5 samples) [x, x^2]:\n", X_poly[:5])
Original X (first 5 samples):
[[-0.75275929]
[ 2.70428584]
[ 1.39196365]
[ 0.59195091]
[-2.06388816]]
Transformed X_poly (first 5 samples) [x, x^2]:
[[-0.75275929 0.56664654]
[ 2.70428584 7.3131619 ]
[ 1.39196365 1.93756281]
[ 0.59195091 0.35040587]
[-2.06388816 4.25963433]]
توجه کنید دادهٔ ما اکنون در فضای ویژگی دوبعدی [x, x²] نمایش داده میشود.
4.4 رگرسیون خطی در فضای ویژگی با ابعاد بالاتر
اکنون یک مدل رگرسیون خطی آموزش میدهیم، ولی با ویژگیهای تبدیلشده (X_poly). مدل برای x و
x² وزن یاد میگیرد و عملاً مدلی به شکل
y = w₁*x + w₂*x² + b
برازش میکند، که w₁ و w₂ وزنها (ضریبها) و b عرض از مبدأ (بایاس) است. این مدلی خطی نسبت به
ویژگیهای تازه x و x² است.
مدل خطی اصلی:
تبدیلی که ویژگیها را به ابعاد بالاتر میبرد:
مدل تازه چنین میشود:
برای p=1 و درجه=2:
Source
# Train a linear regression model on the polynomial features
poly_lin_reg = LinearRegression()
poly_lin_reg.fit(X_poly, y)

# Make predictions using the polynomial model
X_new_poly = poly_features.transform(X_new) # Transform the plotting points
y_pred_poly = poly_lin_reg.predict(X_new_poly)

# Visualize the fit
plt.figure(figsize=(8, 6))
plt.scatter(X, y, alpha=0.7, label="Data Points")
plt.plot(X_new, y_pred_poly, "r-", linewidth=2, label="Polynomial Regression Fit (Linear in Feature Space)")
plt.title("Linear Regression on Transformed (Polynomial) Features")
plt.xlabel("Feature (x)")
plt.ylabel("Target (y)")
plt.legend()
plt.grid(True)
plt.show()

print(f"Polynomial Regression Score (R^2): {poly_lin_reg.score(X_poly, y):.4f}")
# Display the learned coefficients (w1 for x, w2 for x^2) and intercept (b)
print(f"Coefficients (w1, w2): {poly_lin_reg.coef_}")
print(f"Intercept (b): {poly_lin_reg.intercept_}")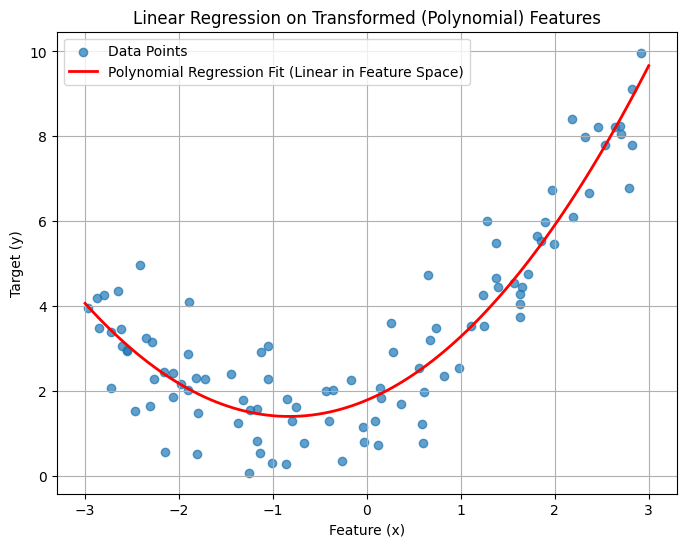
Polynomial Regression Score (R^2): 0.8525
Coefficients (w1, w2): [[0.93366893 0.56456263]]
Intercept (b): [1.78134581]
4.5 نتیجه
با نگاشت ویژگی تکتای اصلی x به فضایی با ابعاد بالاتر [x, x²]، به یک مدل رگرسیون خطی استاندارد
امکان دادیم رابطهٔ ناخطی (درجهدوم) موجود در داده را کامل بگیرد. برازش حاصل بسیار بهتر است، همانطور که
از نظر دیداری و با امتیاز R² بهمراتب بالاتر پیداست.
این مثال قدرت نقشههای ویژگی را نشان میدهد: تبدیل داده به فضایی که مدلهای خطی در آن کارآمد میشوند، حتی وقتی رابطهٔ اصلی ناخطی بوده است.
گذار به ترفند کرنل: هرچند این نگاشت صریح ویژگی برای دادهٔ کمبعد و تبدیلهای ساده خوب کار میکند، حساب کردن و نگه داشتن این ویژگیهای پرابعاد میتواند پرهزینه یا حتی ناممکن شود اگر دادهٔ اصلی یا فضای ویژگی هدف ابعاد بسیار بالایی داشته باشد (مثلاً ویژگیهای چندجملهای با درجهٔ بسیار بالا یا نگاشتهای پیچیدهٔ دیگر). ترفند کرنل میانبُری ریاضی میدهد تا همان نتیجهٔ کار در فضای ویژگی پرابعاد به دست آید بدون آنکه مختصات داده در آن فضا صریحاً حساب شود. این اجازه میدهد الگوریتمهایی که فقط به ضرب داخلی میان نقطههای داده وابستهاند (مثل ماشین بردار پشتیبان) بهصورت ضمنی در فضای ویژگی پرابعاد کار کنند و نگاشتهای پیچیده از نظر محاسباتی شدنی شوند. این مثال رگرسیون به ساختن شهود دربارهٔ اینکه چرا چنین نگاشتهای ضمنی مطلوباند کمک میکند.
Notebook Cell
برای رویکردهای نوین، Dynamic and Adaptive Feature Generation with LLM را ببینید.