روش کرنل (ترفند کرنل)
1. مقدمه¶
بسیاری از الگوریتمهای یادگیری ماشین، از جمله رگرسیون خطی، رگرسیون لجستیک، تحلیل مؤلفههای اصلی (PCA) و دستهبندهای خطی (مثل پرسپترون یا ماشینهای بردار پشتیبان خطی)، بر رابطههای خطی میان نقطههای داده تکیه دارند. این الگوریتمها وقتی خوب کار میکنند که داده خطیجداپذیر باشد یا با تابعهای خطی بهقدر کافی مدل شود. ولی بسیاری از مسئلههای دنیای واقعی ساختارهای ناخطی پیچیدهای دارند که مدلهای خطی نمیتوانند بهدرستی بگیرند.
روش کرنل (که اغلب ترفند کرنل نامیده میشود) راهی توانمند برای بهکارگیری الگوریتمهای خطی روی دادهٔ ناخطی میدهد. ایدهٔ اصلی نگاشت داده به فضای ویژگی () با ابعاد بالاتر است که در آن داده خطیجداپذیر میشود یا مدلسازی خطیاش آسانتر است. «ترفند» این است که این نگاشت را میتوان بهصورت ضمنی با یک تابع کرنل انجام داد، بدون آنکه هرگز نیاز باشد مختصات نقطههای داده در فضای ویژگی پرابعاد (و شاید بینهایتبعد) صریحاً حساب شود. این کار بار محاسباتی نگاشت صریح را دور میزند.
توجه: ترفند کرنل، که با نامهای روش کرنل یا ماشینهای کرنلی هم شناخته میشود، دستهای از الگوریتمها برای تحلیل الگو است که در آنها از دستهبندهای خطی برای حل مسئلههای ناخطی استفاده میشود. این روشها با کرنلسازی فرق دارند؛ آن یکی تکنیکی برای طراحی الگوریتمهای کارآمد است که کارآمدیاش را از یک مرحلهٔ پیشپردازش میگیرد که در آن ورودی الگوریتم با ورودی کوچکتری به نام «کرنل» جایگزین میشود.
2. محدودیتهای مدلهای خطی¶
یک مسئلهٔ دستهبندی دودویی را در نظر بگیرید. مدل خطی میکوشد ابرصفحهای بیابد که نقطههای دادهٔ دستههای مختلف را جدا کند.
در فضای دوبعدی، ابرصفحه یک خط است ().
در فضای سهبعدی، ابرصفحه یک صفحه است ().
در فضای -بعدی، ابرصفحه زیرفضایی -بعدی است.
اگر چنین ابرصفحهٔ جداکنندهای وجود داشته باشد، داده خطیجداپذیر نامیده میشود. ولی اگر داده ساختار ناخطی داشته باشد، مثل مسئلهٔ کلاسیک XOR یا دایرههای هممرکز، هیچ ابرصفحهٔ واحدی نمیتواند دستهها را در فضای ورودی اصلی درست جدا کند.
3. نگاشت ویژگی¶
برای سر و کار داشتن با دادهٔ ناخطی، میتوانیم داده را به فضای ویژگی تازه و پرابعادتری ببریم که در آن شاید خطیجداپذیر شود. این کار با یک تابع نگاشت انجام میشود که با نشان میدهیم:
: فضای ورودی اصلی (مثلاً ).
: فضای ویژگی، معمولاً با ابعادی بسیار بیشتر از (مثلاً که ، یا حتی بینهایتبعد).
4. ترفند کرنل¶
توان روش کرنل در این مشاهده نهفته است که بسیاری از الگوریتمهای خطی را میتوان چنان صورتبندی کرد که فقط به ضرب داخلی میان نقطههای داده () نیاز داشته باشند. نمونهها: پرسپترون (در صورت دوگان)، رگرسیون لجستیک (صورت دوگان)، PCA و ماشینهای بردار پشتیبان.
اگر از نگاشت ویژگی استفاده کنیم، این الگوریتمها باید ضرب داخلی را در فضای ویژگی پرابعاد حساب کنند: . حساب کردن صریح میتواند از نظر محاسباتی بسیار پرهزینه باشد، بهویژه اگر ابعاد بسیار بالا یا بینهایت داشته باشد.
ترفند کرنل این محاسبهٔ صریح را دور میزند. یک تابع کرنل تعریف میکنیم که ضرب داخلی را در فضای ویژگی مستقیماً از بردارهای ورودی اصلی حساب میکند:
اگر تابعی بیابیم که این ضرب داخلی را کارآمد حساب کند بدون آنکه نخست و را حساب کنیم، میتوانیم از آن در الگوریتم خطیمان استفاده کنیم. کافی است هر ضرب داخلی را با مقدار کرنل جایگزین کنیم.
این به ما اجازه میدهد عملاً در فضای ویژگی پرابعاد کار کنیم و در همان حال محاسبات را فقط در فضای ورودی اصلی انجام دهیم.
ضرب داخلی شباهت میان نقطههای و را در فضای ویژگی میسنجد.
بنابراین تابع کرنل را میتوان سنجهٔ شباهت تعمیمیافته میان نقطهها در فضای اصلی دانست که بهصورت ضمنی متناظر با ضرب داخلی در فضایی (احتمالاً پرابعاد یا حتی بینهایتبعد) است.
فضای ویژگی رسماً فضای هیلبرت با کرنل بازتولیدکننده (RKHS) نامیده میشود.
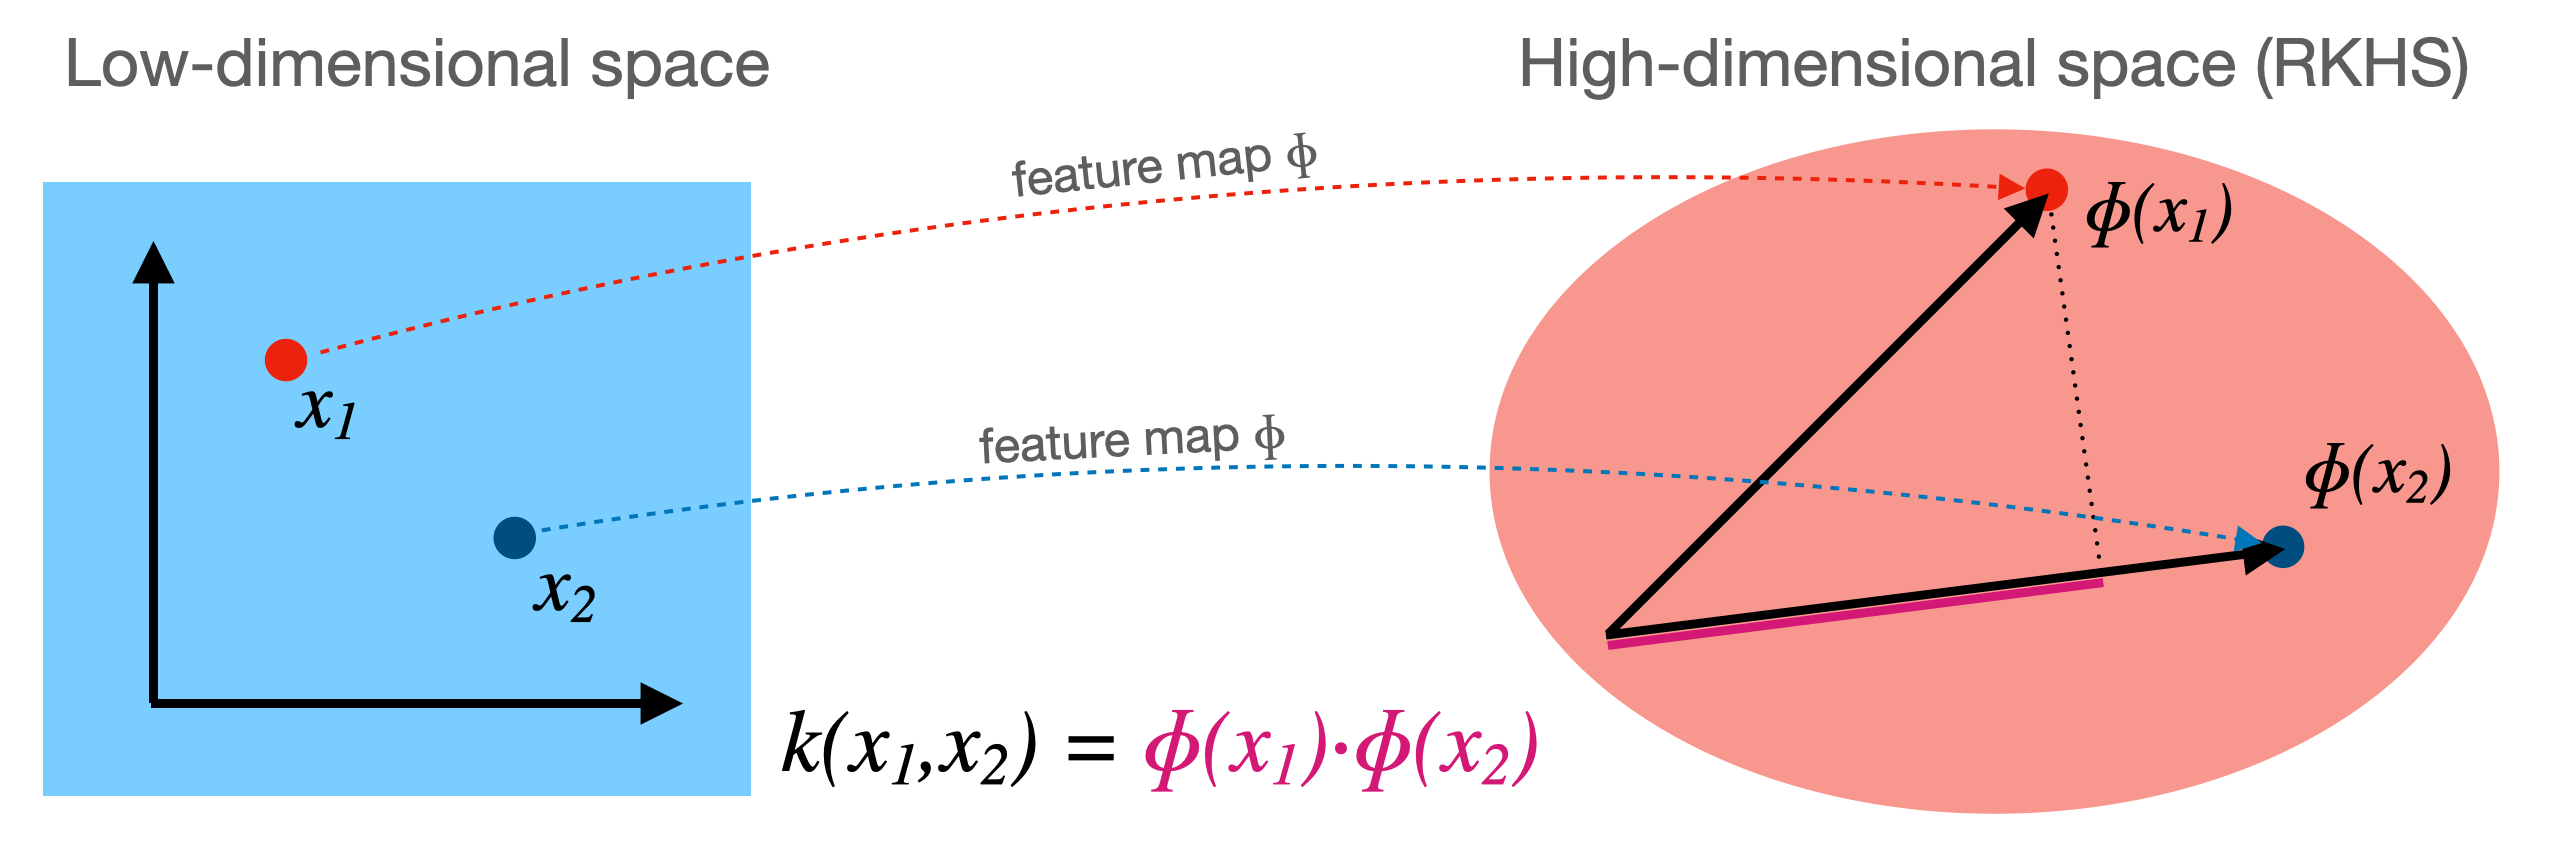
تصویری از نگاشت و تابع کرنل .
5. الگوریتمهایی که از کرنل استفاده میکنند¶
هر الگوریتمی که تنها برحسب ضرب داخلی میان نمونههای ورودی بیان شود، بهطور بالقوه «کرنلیشدنی» است.
دستهبندهای خطی: الگوریتمهایی مثل پرسپترون یا رگرسیون لجستیک (وقتی در صورت دوگان بیان شوند) به ضرب داخلی تکیه دارند. با جایگزینی ضرب داخلی استاندارد با ، این الگوریتمها بهصورت ضمنی در فضای ویژگی کار میکنند. هرچند جداکنندهٔ خطی (ابرصفحه) در مییابند، این جداکننده در فضای ورودی اصلی متناظر با مرز تصمیم ناخطی است.
PCA کرنلی: تحلیل مؤلفههای اصلی (PCA) مؤلفههای اصلی را با تحلیل بردارهای ویژهٔ ماتریس کوواریانس مییابد که از ضرب داخلیها حسابشدنی است. PCA کرنلی این تحلیل را در فضای ویژگی تعریفشده با کرنل انجام میدهد و میتواند ساختارهای ناخطی داده را بیابد.
ماشینهای بردار پشتیبان (SVM): SVMها شاید نامدارترین نمونهٔ الگوریتمهای کرنلی باشند. آنها ابرصفحهٔ جداکنندهٔ بهینه را مییابند و ترفند کرنل به آنها اجازه میدهد مرزهای تصمیم پیچیده و ناخطی را کارآمد بیابند.
نمونههای دیگر: فرایندهای گاوسی، رگرسیون ریج (ریج کرنلی) و الگوریتمهای خوشهبندی (مثل خوشهبندی طیفی) هم میتوانند از کرنل بهره ببرند.
6. تابعهای کرنل رایج¶
چند تابع کرنل استاندارد وجود دارد که هر کدام متناظر با نگاشت ویژگی متفاوتی است.
کرنل خطی:
این همان ضرب داخلی استاندارد است. نگاشت ویژگی بهسادگی همانی است: . استفاده از این کرنل الگوریتم خطی اصلی را بازمیگرداند.
کرنل چندجملهای:
اینجا ، و (درجه) ابرپارامترند. این کرنل متناظر با فضای ویژگیای است که ترکیبهای چندجملهای ویژگیهای اصلی تا درجهٔ را دارد. مثلاً اگر ، ، آنگاه
این متناظر با نگاشت ویژگی است، چون .
کرنل گاوسی (تابع پایهٔ شعاعی — RBF):
که یک ابرپارامتر است. این یکی از محبوبترین کرنلهاست. متناظر با فضای ویژگی بینهایتبعد است. شباهت را بر پایهٔ فاصله میسنجد؛ نقطههایی که در فضای ورودی نزدیک هماند مقدار کرنل نزدیک به 1 دارند و نقطههای دور مقدار نزدیک به 0.
7. قضیهٔ مرسر: چه زمانی K کرنل معتبر است؟¶
هر تابع را نمیتوان بهعنوان ضرب داخلی در فضایی ویژگی (بهویژه فضای هیلبرت) تفسیر کرد. قضیهٔ مرسر شرط معتبر بودن یک تابع بهعنوان کرنل را میدهد.
تعریف: ماتریس گرام
با مجموعهدادهٔ و نگاشت ویژگی که هر نقطهٔ داده را به فضایی با ضرب داخلی (احتمالاً بینهایتبعد) میبرد، ماتریس گرام ماتریسی است که درایهٔ آن ضرب داخلی نمایشهای ویژگی است:
رابطه با تابع کرنل¶
تابع کرنل دقیقاً همین ضرب داخلی تعریف میشود:
بنابراین درایههای ماتریس گرام را میتوان بهطور همارز چنین نوشت:
تعریف: ماتریس مثبت نیمهمعین (PSD) ماتریس متقارن مثبت نیمهمعین است اگر برای هر بردار ناصفر :
قضیهٔ مرسر (سادهشده): را زیرمجموعهای فشرده از بگیرید. تابع پیوسته و متقارن کرنل معتبر است (یعنی نگاشتی به فضای هیلبرت وجود دارد چنان که ) اگر و تنها اگر ماتریس گرام برای هر مجموعهٔ متناهی از نقطههای برگرفته از مثبت نیمهمعین باشد.
اثبات: اگر کرنل باشد ماتریس گرام PSD است فرض کنید برای نگاشتی . هر مجموعهای از نقطهها و ماتریس گرام متناظر () باشد. برای هر بردار ، صورت درجهدوم را در نظر بگیرید:
را جایگذاری کنید:
جملهها را بازآرایی کنید:
بگذارید . این برداری در فضای ویژگی است. عبارت چنین میشود:
چون مربع نُرم اقلیدسی (یا مربع نُرم در فضای هیلبرت) هر بردار همیشه نامنفی است، داریم:
پس ماتریس گرام مثبت نیمهمعین است.
جهت دیگر قضیهٔ مرسر (اینکه هر تابع که ماتریسهای گرام PSD تولید کند متناظر با یک نگاشت ویژگی است) اثبات پیچیدهتری دارد ولی تضمین میکند که تابعهایی مثل کرنل گاوسی یا چندجملهای معتبرند.
پیامدها: قضیهٔ مرسر بنیادی است چون میگوید کدام تابعهای را میتوانیم بهطور قانونی بهعنوان کرنل در الگوریتمهایمان به کار ببریم. لازم نیست را صریحاً بیابیم؛ فقط باید شرط مثبت نیمهمعین بودن را بررسی کنیم. در عمل اغلب از کرنلهای شناختهشده (خطی، چندجملهای، RBF) استفاده میکنیم که میدانیم شرط مرسر را برآورده میکنند. همچنین میتوان از کرنلهای معتبر موجود کرنلهای معتبر تازه ساخت (مثلاً جمع یا ضرب کرنلهای معتبر هم کرنل معتبر است).
8. تفسیرها و عملیات دیگر در فضای ویژگی (با کرنل)¶
ترفند کرنل نهتنها به ما اجازه میدهد الگوریتمها را بهصورت ضمنی در فضای ویژگی اجرا کنیم، بلکه امکان میدهد برخی ویژگیهای مربوط به داده را در آن فضا بفهمیم و حساب کنیم، همه بدون نیاز به مختصات صریح .
مقدار کرنل بهعنوان شباهت:
همانطور که پیشتر گفتیم، تابع کرنل ضرب داخلی میان بردارهای ویژگی و را نشان میدهد. در فضای اقلیدسی (و فضاهای هیلبرت)، ضرب داخلی با زاویهٔ میان بردارها نسبت نزدیک دارد. ضرب داخلی بزرگتر و مثبت یعنی بردارها در جهتهای مشابهاند، که شباهت بیشتر را نشان میدهد. بنابراین مقدار کرنل را میتوان سنجهٔ شباهت میان نقطههای اصلی و پس از نگاشت به فضای ویژگی دانست. همین تفسیر بنیاد خوب کار کردن کرنلها در الگوریتمهایی مثل SVM (یافتن نقطههای شبیه بردارهای پشتیبان) یا خوشهبندی (گروه کردن نقطههای شبیه) است. کرنلهای مختلف تلقیهای مختلفی از شباهت را میگیرند.
نُرم یک نقطه در فضای ویژگی:
مربع نُرم اقلیدسی (یا مربع طول) نقطهٔ نگاشتشدهٔ در فضای ویژگی را میتوان با تابع کرنل حساب کرد. یادآوری میکنیم مربع نُرم یک بردار ضرب داخلی آن با خودش است:
با تعریف کرنل، این بهسادگی چنین است:
پس درایههای قطری ماتریس گرام مربع نُرم نقطههای داده در فضای ویژگی را میدهند. این مثلاً وقتی لازم است نقطهها را در نرمال کنیم سودمند است.
میانگین در فضای ویژگی:
با مجموعهدادهٔ ، میانگین نمایشهایشان در فضای ویژگی چنین است:
هرچند معمولاً نمیتوانیم را مستقیماً حساب یا نگه داریم (چون در زندگی میکند)، میتوانیم ضرب داخلیاش با هر نقطهٔ نگاشتشدهٔ را با کرنل حساب کنیم:
بههمینترتیب مربع نُرم بردار میانگین را هم میتوان حساب کرد:
این توانایی کار کردن با میانگین بهصورت ضمنی برای الگوریتمهایی مثل PCA کرنلی که به مرکز کردن داده در فضای ویژگی نیاز دارند حیاتی است.
فاصلهٔ میان نقطهها:
فاصلهٔ و چنین است
که یعنی
واریانس کل در فضای ویژگی:
واریانس کل داده در فضای ویژگی پخششدگی نقطههای حول میانگینشان را میسنجد. معمولاً بهصورت میانگین مربع فاصله از میانگین تعریف میشود:
میتوانیم این را با کرنل حساب کنیم. با بسط نُرم:
حالا بیانهای کرنلی را که بالا یافتیم جایگذاری کنید:
جمع روی و تقسیم بر واریانس کل را میدهد که کاملاً از مقدارهای کرنل حسابشدنی است. این محاسبه در PCA کرنلی مرکزی است.
نرمالسازی داده در فضای ویژگی:
بعضی وقتها نرمال کردن نقطههای داده در فضای ویژگی مطلوب است. دو نوع رایج نرمالسازی:
مرکز کردن: یعنی کم کردن میانگین از هر نقطه:
.
هرچند را صریح حساب نمیکنیم، میتوانیم ماتریس کرنل متناظر با این نقطههای مرکزشده را از ماتریس کرنل اصلی حساب کنیم. این عملیات عملاً داده را در مرکز میکند. فرمول ماتریس کرنل مرکزشدهٔ که در آن چنین است: ، که ماتریسی است با همهٔ درایههای برابر . این دقیقاً همان گام مرکز کردن است که در PCA کرنلی استفاده میشود.
مقیاسبندی به نُرم واحد: میتوانیم هر نقطهٔ را چنان مقیاس کنیم که در فضای ویژگی نُرمی برابر 1 داشته باشد:
بهشرط . با ، داریم . تابع کرنل متناظر با این نقطههای نرمالشده چنین است:
این را گاهی «کرنل کسینوسی» یا «کرنل نرمالشده» مینامند. تضمین میکند همهٔ نقطهها روی کرهٔ واحد فضای ویژگی باشند، .
9. مزایا و معایب ترفند کرنل¶
مزایا:
توان مدلسازی ناخطی: کرنلها به الگوریتمهای خطی اجازه میدهند رابطهها و مرزهای تصمیم پیچیدهٔ ناخطی را بدون تغییر خود الگوریتم اصلی مدل کنند.
کارایی محاسباتی: حساب کردن صریح بردارهای ویژگی که ممکن است ابعاد بسیار بالا یا بینهایت داشته باشند دور زده میشود. محاسبات در بُعد فضای ورودی اصلی میمانند و هنگام حساب کردن ماتریس گرام فقط به تعداد نقطههای داده بستگی دارند.
پیمانهای بودن: با تغییر تابع کرنل (مثلاً از چندجملهای به RBF) میتوان بهسادگی میان نوعهای مختلف ناخطیبودن جابهجا شد.
کار با دادهٔ غیربرداری: کرنلها را میتوان برای نوعهای دادهای تعریف کرد که طبیعتاً بهصورت بردار با اندازهٔ ثابت نمایش داده نمیشوند، مثل رشتهها، گرافها یا تصویرها، تا زمانی که تابع شباهت معناداری (که شرط مرسر را برآورده کند) تعریفشدنی باشد.
معایب:
هزینهٔ محاسباتی با مجموعهدادهٔ بزرگ: حساب کردن و نگه داشتن ماتریس گرام زمان یا (بسته به پیچیدگی کرنل) و حافظهٔ میگیرد، که تعداد نمونهها و بُعد اصلی است. این برای بسیار بزرگ ناممکن میشود. الگوریتمهایی که از کرنل استفاده میکنند معمولاً پیچیدگیای در حدود یا دارند.
انتخاب کرنل و ابرپارامترها: کارایی بهشدت به انتخاب تابع کرنل (مثلاً خطی، RBF، چندجملهای) و ابرپارامترهایش (مثلاً برای RBF و و برای چندجملهای) حساس است. این اغلب تنظیم دقیق با روشهایی مثل اعتبارسنجی متقاطع میخواهد.
تفسیرپذیری: هرچند مرز تصمیم در فضای ویژگی خطی است، مرز متناظر در فضای ورودی اصلی میتواند بسیار پیچیده و بهسختی تفسیرپذیر باشد. از تفسیر ضریبهای یک مدل خطی ساده روراستتر نیست.
جمعبندی¶
ترفند کرنل تکنیکی ریاضی و توانمند است که به الگوریتمهای خطی (بهویژه آنهایی که فقط به ضرب داخلی تکیه دارند) اجازه میدهد بهصورت ضمنی در فضای ویژگی پرابعاد کار کنند. با تعریف تابع کرنل ، ضربهای داخلی در الگوریتم اصلی را با مقدارهای کرنل جایگزین میکنیم. این کار محاسبهٔ بالقوه پرهزینهٔ نگاشت ویژگی را دور میزند و در همان حال اثر نگاشت داده به فضایی را میدهد که در آن شاید خطیجداپذیر باشد یا الگوهای خطی پدید آیند. جنبههای کلیدی:
نگاشت ویژگی: تبدیل دادهٔ به .
تابع کرنل: ضرب داخلی را مستقیماً در حساب میکند.
کرنلهای رایج: خطی، چندجملهای، RBF (گاوسی).
قضیهٔ مرسر: شرط (مثبت نیمهمعین بودن ماتریس گرام) معتبر بودن یک تابع بهعنوان کرنل را تعریف میکند.
کاربردها: k-means کرنلی، PCA کرنلی، ریج کرنلی و غیره.
مبادلهها: ناخطیبودن را ممکن میکند ولی میتواند برای مجموعهدادهٔ بزرگ پرهزینه باشد و به انتخاب و تنظیم دقیق کرنل نیاز دارد.
10. خوشهبندی k-means کرنلی¶
مرور: الگوریتم استاندارد k-means¶
k-means الگوریتم خوشهبندی پرکاربردی است که مجموعهداده را با کمینه کردن مجموع مربع فاصلههای هر نقطه از مرکز خوشهٔ تخصیصیافتهاش به خوشه افراز میکند.
گامهای الگوریتم:
مقداردهی اولیه: تصادفی مرکز اولیه برگزینید.
گام تخصیص: هر نقطهٔ دادهٔ را به نزدیکترین مرکز تخصیص دهید:
گام بهروزرسانی: هر مرکز را بهعنوان میانگین نقطههای تخصیصیافته به آن دوباره حساب کنید:
تکرار گامهای 2 و 3 تا همگرایی (یعنی وقتی تخصیصها دیگر عوض نشوند یا مرکزها پایدار شوند).
تابع هدف:
محدودیت: k-means فقط میتواند خوشههای جداشده با مرزهای خطی را بیابد. وقتی خوشهها ساختار ناخطی دارند شکست میخورد.
k-means کرنلی: انگیزه¶
برای غلبه بر محدودیت خطیبودن، k-means کرنلی از ترفند کرنل استفاده میکند تا داده را بهصورت ضمنی به فضای ویژگی پرابعادتری ببرد که در آن خوشهها شاید خطیجداپذیر شوند.
نگاشتی از فضای ورودی به فضای ویژگی (احتمالاً بینهایتبعد) باشد.
بهجای حساب کردن صریح ، از تابع کرنل استفاده میکنیم.
الگوریتم k-means کرنلی¶
تعریفها:
ماتریس کرنل با باشد.
مرکز خوشهٔ در فضای ویژگی چنین است:
فاصله در فضای ویژگی: مربع فاصلهٔ یک نقطه تا مرکز یک خوشه در فضای ویژگی را میتوان فقط با مقدارهای کرنل حساب کرد:
گامهای الگوریتم:
مقداردهی اولیه: تصادفی نقطهها را به خوشه تخصیص دهید.
برای هر خوشهٔ و هر نقطهٔ :
حساب کنید:
فاصله را حساب کنید:
گام تخصیص: هر نقطه را به خوشهای با کمترین تخصیص دهید.
تکرار گامهای 2 و 3 تا همگرایی.
تابع هدف در فضای کرنل:
نکتهها¶
اگر کرنل خطی باشد ()، k-means کرنلی به k-means استاندارد تبدیل میشود.
با کرنلهای ناخطی (مثل گاوسی/RBF)، k-means کرنلی میتواند خوشههایی با مرزهای ناخطی بیابد.
همهٔ محاسبات با مقدارهای کرنل انجام میشوند؛ نگاشت صریح هرگز لازم نمیشود.
مثال: کرنل گاوسی¶
با کرنل گاوسی (RBF):
k-means کرنلی میتواند خوشههای هممرکز یا خوشههایی را که بهصورت ناخطی جداپذیرند از هم جدا کند.
تمرینها¶
و را بگیرید. نگاشت ویژگی صریح را بیابید که را برآورده کند و بُعد فضای ویژگی را بشمارید.
نشان دهید کرنل گاوسی متناظر با فضای ویژگی بینهایتبعد است، با بسط دادنش با سری تیلور و شناسایی ضریبها.
با قضیهٔ مرسر تعیین کنید کدامیک از ، و کرنل معتبرند. برای نامعتبرها مجموعهٔ متناهی از نقطهها را نشان دهید که ماتریس گرامشان مقدار ویژهٔ منفی دارد.
ریج کرنلی معادلهٔ را حل میکند. نشان دهید وقتی و وارونپذیر است این کار داده را درونیابی میکند، و توضیح دهید چرا بزرگ در کرنل RBF جواب را هموارتر میکند (راهنما: به ماتریس گرام نگاه کنید).
k-means کرنلی را از اتحاد SSE الگوریتم استاندارد استنتاج کنید و بررسی کنید که با کرنل خطی هر فرمول به بهروزرسانی معمول k-means فرو میکاهد.
هزینهٔ ترفند کرنل همان ماتریس گرام است. حافظهٔ لازم برای با ذخیره در float64 را برآورد کنید و توضیح دهید ترفند کرنل واقعاً کدام بخش الگوریتم (محاسبه، ذخیره یا هر دو) را صرفهجویی میکند.
منابع¶
Schölkopf, B. and Smola, A., Learning with Kernels, MIT Press, 2002 (Ch. 1–2).
Hofmann, T., Schölkopf, B. and Smola, A., “Kernel Methods in Machine Learning”, Annals of Statistics 36(3), 2008.
Hastie, Tibshirani and Friedman, The Elements of Statistical Learning, 2nd ed., §12.3.
Burges, C., “A Tutorial on Support Vector Machines for Pattern Recognition”, Data Mining and Knowledge Discovery 2, 1998 (فقط بخش کرنل؛ بخش SVM موضوع درس دیگری است).