رگرسیون خطی، بخش 2
گروه علوم کامپیوتر، دانشگاه فردوسی مشهد
همانطور که naive Bayes (که در صفحهٔ دستهبندی Naive Bayes بحث شد) نقطهٔ شروع خوبی برای وظیفههای دستهبندی است، مدلهای رگرسیون خطی هم نقطهٔ شروع خوبی برای وظیفههای رگرسیون هستند. چنین مدلهایی محبوباند چون سریع برازش میشوند و تفسیرشان روراست است. با سادهترین شکل مدل رگرسیون خطی (یعنی برازش یک خط راست به دادهٔ دوبعدی) آشنا هستید، ولی این مدلها را میتوان برای مدلسازی رفتارهای پیچیدهتر داده بسط داد.
Notebook Cell
# Auto-setup when running on Google Colab
import os
if 'google.colab' in str(get_ipython()) and not os.path.exists('/content/data-mining'):
    !git clone -q https://github.com/fum-cs/data-mining.git /content/data-mining
    # !pip --quiet install -r /content/data-mining/requirements_colab.txt
    %cd data-mining/notebooks
Notebook Cell
import warnings

warnings.filterwarnings("ignore")
import numpy as np
from sklearn.model_selection import train_test_split

# This is needed to render the plots
from utils.utils import *
مدل خطی
فرض کنید مدل واقعی و مدل برآوردشده باشد (معادلهٔ 23.2 کتاب زکی Zaki & Meira (2020)):
اگر داشته باشیم:
آنگاه را میتوان ضرب داخلی دو بردار دانست:
اگر نمونهٔ ام با نشان داده شود
آنگاه:
مجموع مربع خطا (SSE):
که در آن:
تولید داده
تولید دادهٔ مصنوعی
true_w0 = 1  # b in mx+b
true_w1 = 2  # m in mx+b
N = 100

# Data Generation
np.random.seed(42)
x = np.random.rand(N, 1)

epsilon = 0.1 * np.random.randn(N, 1)
y = true_w0 + true_w1 * x + epsilon

# Add a column of 1s to x

# ones = np.ones((N, 1))
# X = np.concatenate([ones, x],axis=1)
X = np.insert(x, 0, 1, axis=1)
print(x.shape, X.shape)
print(x[:3])
print(y[:3])
(100, 1) (100, 2)
[[0.37454012]
[0.95071431]
[0.73199394]]
[[1.75778494]
[2.87152788]
[2.47316396]]
figure0(x, y)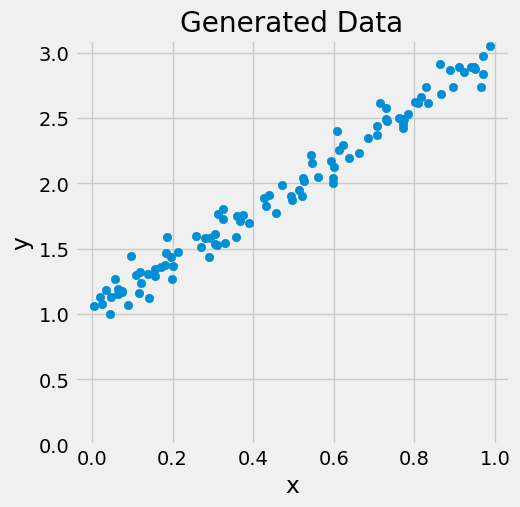
معادلههای نرمال
معادلههای نرمال جواب بستهای برای یافتن پارامترهای بهینه (ضریبها) میدهند که تابع هزینه (معمولاً میانگین مربع خطا) را در رگرسیون خطی کمینه میکنند.
معادلههای نرمال از صفر گذاشتن مشتقهای جزئی تابع هزینه نسبت به هر ضریب به دست میآیند.
جواب بسته یعنی یافتن پارامترهای بهینه مستقیماً با یک فرمول ریاضی، بهجای یک فرایند بهینهسازی تکراری.
باید را نسبت به کمینه کنیم که برابر با شکل مشهور است. موقتاً بهجای از استفاده میکنیم و ضخیمبودن حروف را نادیده میگیریم؛ پس باید را کمینه کنیم
میدانیم که (حساب ماتریسی را در ویکیپدیا ببینید):
و اگر ماتریسی متقارن باشد:
پس:
مشتق را صفر بگذارید:
و با نشانهگذاری پیشین ما:
w = np.linalg.inv(X.T @ X) @ X.T @ y
w
array([[1.02150962],
[1.95402268]])استفاده از Scikit-learn
from sklearn.linear_model import LinearRegression

linreg = LinearRegression()
linreg.fit(x, y)
print(linreg.intercept_, linreg.coef_)
[1.02150962] [[1.95402268]]
اگر ماتریس دادهٔ افزوده داشته باشیم، باید
fit_intercept=False بگذاریم. در معادلهٔ (23.20) کتاب زکی این ماتریس با نشان داده
میشود.
linreg = LinearRegression(fit_intercept=False)
linreg.fit(X, y)
print(linreg.coef_)
[[1.02150962 1.95402268]]
رگرسیون دوجملهای
در رگرسیون دوجملهای دو متغیر داریم: یکی متغیر پیشبین (که ویژگی هم نامیده میشود) و دیگری متغیر پاسخ (که هدف هم نامیده میشود).
متغیر پیشبین (ویژگی):
متغیر پیشبین (که اغلب با x نشان داده میشود) متغیر ورودی است که با آن تغییرات متغیر پاسخ را پیشبینی یا توضیح میدهیم.
در یادگیری ماشین این معادل یک ویژگی است. ویژگیها مشخصهها یا صفات نقطههای داده را نشان میدهند.
مثلاً در مدل پیشبینی قیمت مسکن، ویژگیها میتوانند متراژ، تعداد اتاق خواب، موقعیت و … باشند.
متغیر پاسخ (هدف):
متغیر پاسخ (که اغلب با y نشان داده میشود) متغیر خروجی است که میکوشیم بر پایهٔ متغیر پیشبین پیشبینی یا بفهمیم.
در یادگیری ماشین این معادل هدف است. هدف مقداری را نشان میدهد که میخواهیم پیشبینی کنیم.
برای مدل پیشبینی قیمت مسکن، هدف قیمت واقعی فروش خانه خواهد بود.
پس به کوتاهی، رگرسیون دوجملهای تحلیل رابطهٔ دو متغیر است: یکی (ویژگی) برای پیشبینی یا توضیح رفتار دیگری (هدف) به کار میرود. این اصطلاحها هم در آمار و هم در یادگیری ماشین رایجاند.
برای اطلاعات بیشتر دربارهٔ رگرسیون چندمتغیرهٔ چندگانه، این نوشتهٔ فرادرس را ببینید.
گرادیان کاهشی
در این بخش مفاهیم پایهای زیربنای گرادیان کاهشی را معرفی میکنیم. بخشی از مطالب از D2L گرفته شده است.
گرادیان کاهشی یکبعدی
گرادیان کاهشی در یک بعد مثال خوبی است برای توضیح اینکه چرا الگوریتم گرادیان کاهشی میتواند مقدار تابع هدف را کم کند. تابعی حقیقی و پیوستهمشتق مانند را در نظر بگیرید. با بسط تیلور به دست میآوریم
یعنی در تقریب مرتبهٔ اول، از مقدار تابع و مشتق اول در به دست میآید. بیمنطق نیست اگر فرض کنیم برای کوچک، حرکت در جهت گرادیان منفی را کم میکند. برای سادگی اندازهٔ گام ثابت برمیگزینیم و میگذاریم. با جایگذاری در بسط تیلور بالا میرسیم به
اگر مشتق صفر نباشد پیشرفت میکنیم، چون . در کنار این، همیشه میتوان را چنان کوچک گرفت که جملههای مرتبهٔ بالاتر بیاهمیت شوند. پس به این میرسیم
یعنی اگر از
برای تکرار استفاده کنیم، مقدار تابع ممکن است کم شود. بنابراین در گرادیان کاهشی نخست یک مقدار اولیهٔ و یک ثابت برمیگزینیم و بعد با آنها را پیوسته تکرار میکنیم تا شرط توقف برقرار شود، مثلاً وقتی اندازهٔ گرادیان بهقدر کافی کوچک شود یا تعداد تکرارها به مقدار مشخصی برسد.
گرادیان کاهشی روی 
برای سادگی تابع هدف را برمیگزینیم تا نشان دهیم گرادیان کاهشی چگونه پیاده میشود. هرچند میدانیم جواب کمینهسازی است، هنوز از این تابع ساده استفاده میکنیم تا ببینیم چگونه تغییر میکند.
# Defining a simple quadratic function and its derivative
f = lambda x: x**2
f_prime = lambda x: 2 * x

# Generating values
x = np.linspace(-10, 10, 400)
y = f(x)

# Gradient descent settings
learning_rate = 0.1
x_start = 9.0  # Starting point
steps = [x_start]
n_iterations = 15

# Gradient Descent Iteration
for _ in range(n_iterations):
    print(
        "x = {:4.2f}, f'(x) = {:5.2f}, -lr*f'(x)={:5.2f}".format(
            x_start, f_prime(x_start), -learning_rate * f_prime(x_start)
        )
    )
    x_start = x_start - learning_rate * f_prime(x_start)
    steps.append(x_start)

# Plotting the function
plt.figure(figsize=(8, 5))
plt.plot(x, y, lw=2, color="blue", label="f(x) = x²")

# Plotting the steps
plt.scatter(steps, f(np.array(steps)), color="red", s=100, label="Steps")
plt.plot(steps, f(np.array(steps)), color="red", linestyle="--", lw=1.5)

# Annotations and labels
plt.title("Gradient Descent on f(x) = x²")
plt.xlabel("x")
plt.ylabel("f(x)")
plt.legend()
plt.grid(True)
plt.show()
x = 9.00, f'(x) = 18.00, -lr*f'(x)=-1.80
x = 7.20, f'(x) = 14.40, -lr*f'(x)=-1.44
x = 5.76, f'(x) = 11.52, -lr*f'(x)=-1.15
x = 4.61, f'(x) = 9.22, -lr*f'(x)=-0.92
x = 3.69, f'(x) = 7.37, -lr*f'(x)=-0.74
x = 2.95, f'(x) = 5.90, -lr*f'(x)=-0.59
x = 2.36, f'(x) = 4.72, -lr*f'(x)=-0.47
x = 1.89, f'(x) = 3.77, -lr*f'(x)=-0.38
x = 1.51, f'(x) = 3.02, -lr*f'(x)=-0.30
x = 1.21, f'(x) = 2.42, -lr*f'(x)=-0.24
x = 0.97, f'(x) = 1.93, -lr*f'(x)=-0.19
x = 0.77, f'(x) = 1.55, -lr*f'(x)=-0.15
x = 0.62, f'(x) = 1.24, -lr*f'(x)=-0.12
x = 0.49, f'(x) = 0.99, -lr*f'(x)=-0.10
x = 0.40, f'(x) = 0.79, -lr*f'(x)=-0.08
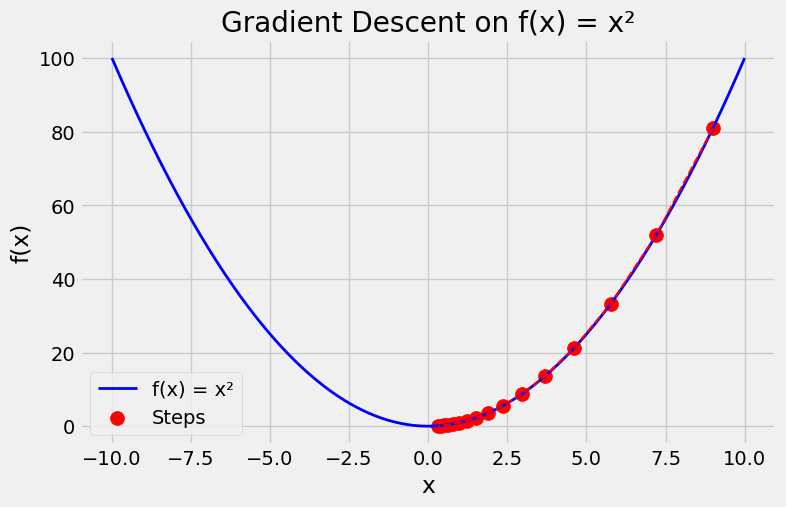
و تابع دیگری را ببینید که در درس ADS با PSO حل شده است.
# Defining a simple quadratic function and its derivative
f = lambda x: 3 * np.sin(x) + (0.1 * x - 3) ** 2
f_prime = lambda x: 3 * np.cos(x) + 0.2 * (0.1 * x - 3)

# Generating values
x = np.linspace(0, 60, 400)
y = f(x)

# Gradient descent settings
learning_rate = 0.1
x_start = 20  # Starting point
steps = [x_start]
n_iterations = 15

# Gradient Descent Iteration
for _ in range(n_iterations):
    x_start = x_start - learning_rate * f_prime(x_start)
    steps.append(x_start)

# Plotting the function
plt.figure(figsize=(8, 6))
plt.plot(x, y, lw=2, color="blue", label="f(x) = 3sin(x)+(0.1x-3)²")

# Plotting the steps
plt.scatter(steps, f(np.array(steps)), color="red", s=100, label="Steps")
plt.plot(steps, f(np.array(steps)), color="red", linestyle="--", lw=1.5)

# Annotations and labels
plt.title("Gradient Descent on f(x) = 3sin(x)+(0.1x-3)²")
plt.xlabel("x")
plt.ylabel("f(x)")
plt.legend()
plt.grid(True)
plt.show()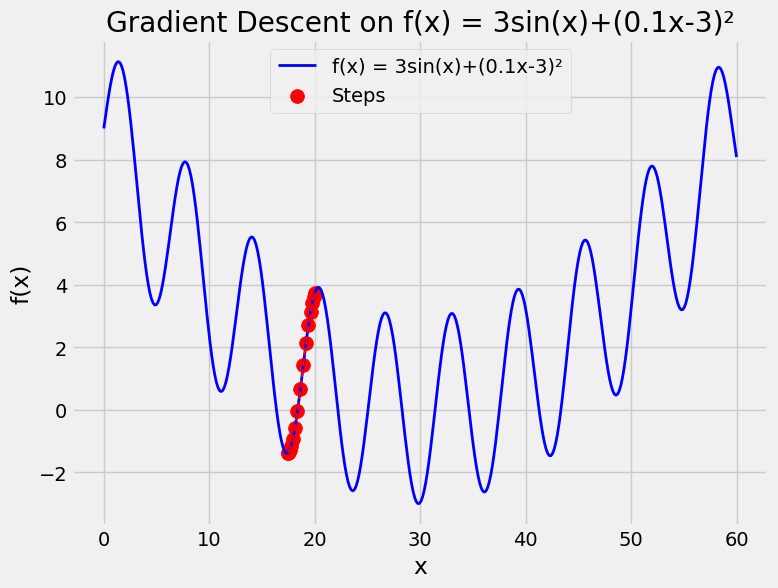
استفاده از گرادیان کاهشی برای رگرسیون در یادگیری ماشین
اینجا از دادهٔ آموزش برای برآورد پارامترهای مدل استفاده میکنیم و خطا را روی دادهٔ آزمون گزارش میدهیم
# Reproduce our data
true_w0 = 1  # b in mx+b
true_w1 = 2  # m in mx+b
N = 100

# Data Generation
np.random.seed(42)
x = np.random.rand(N, 1)

epsilon = 0.1 * np.random.randn(N, 1)
y = true_w0 + true_w1 * x + epsilon
X = np.insert(x, 0, 1, axis=1)
تقسیم آموزش–آزمون
x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.2)x_train.shape, y_train.shape((80, 2), (80, 1))figure1(x_train, y_train, x_test, y_test)(<Figure size 1200x600 with 2 Axes>,
array([<Axes: title={'center': 'Generated Data - Train'}, xlabel='x', ylabel='y'>,
<Axes: title={'center': 'Generated Data - Test'}, xlabel='x', ylabel='y'>],
dtype=object))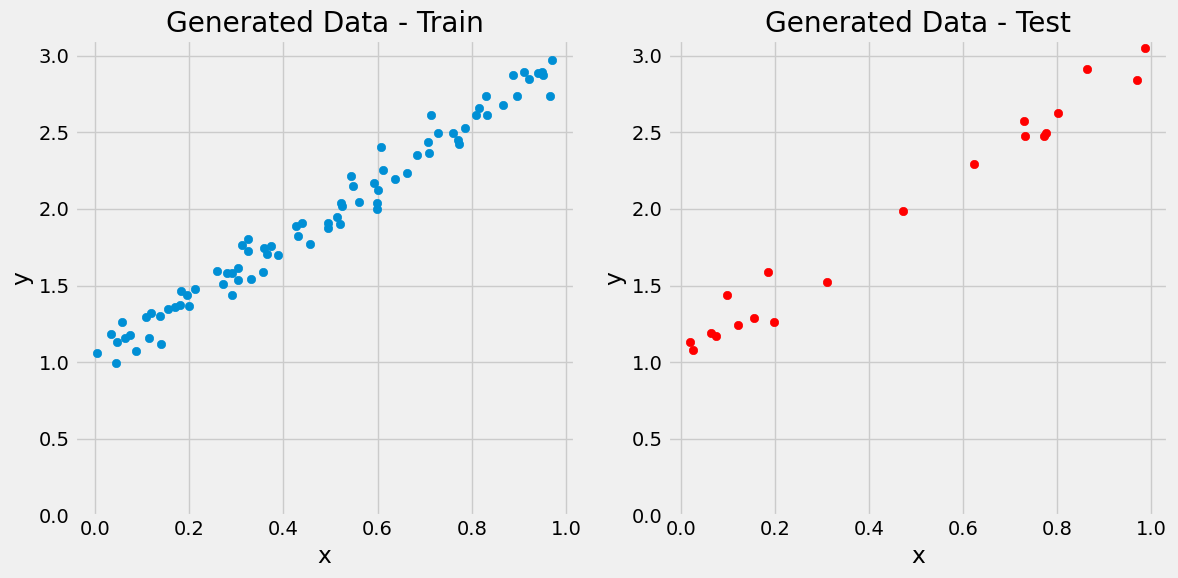
گام 0: مقدار اولیهٔ تصادفی
# Step 0 - Initializes parameters "b" and "w" randomly
np.random.seed(42)
w = np.random.randn(2, 1)
print(w)
[[ 0.49671415]
[-0.1382643 ]]
گام 1: محاسبهٔ پیشبینیهای مدل
# Step 1 - Computes our model's predicted output - forward pass
# y_hat = b + m * x_train
y_hat = w[0] + w[1] * x_train[:, 1]
y_hat[:3]
array([0.39881299, 0.41404593, 0.36925186])y_hat = x_train @ w
y_hat[:3]array([[0.39881299],
[0.41404593],
[0.36925186]])figure2(x_train, y_train, w[0], w[1])(<Figure size 600x600 with 1 Axes>, <Axes: xlabel='x', ylabel='y'>)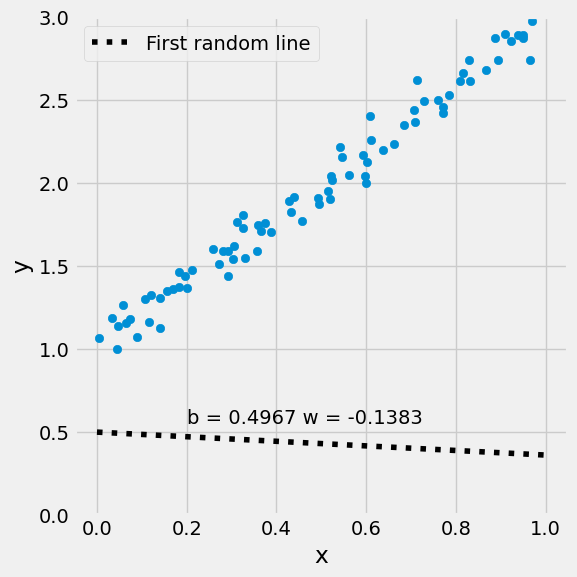
گام 2: محاسبهٔ هزینه
$$
\begin{aligned} error_i &= \hat{y_i} - y_i\ where:\ y &= true_w_0 + true_w_1 x_1 + \epsilon\ &\hat{y}= w_0 x_0+ w_1 x_1 \end{aligned} $$
print(y_train[0], y_hat[0])
figure3(x_train, y_train, w[0], w[1])
[2.36596945] [0.39881299]
(<Figure size 600x600 with 1 Axes>, <Axes: xlabel='x', ylabel='y'>)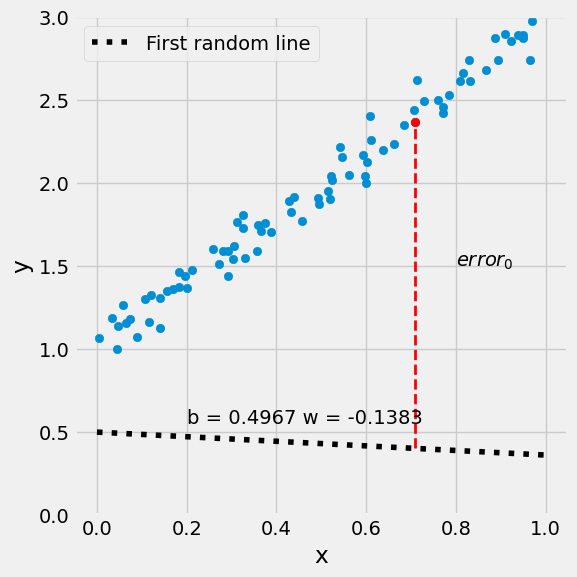
$$
\begin{aligned} MSE &= \frac{1}{n} \sum_{i=1}^n{error_i}^2 \ &= \frac{1}{n} \sum_{i=1}^n{(\hat{y_i} - y_i)}^2 \ &= \frac{1}{n} \sum_{i=1}^n{(w_0 x_{i,0} + w_1 x_{i,1} - y_i)}^2 \end{aligned} $$
# Step 2 - Computing the loss
# We are using ALL data points, so this is BATCH gradient
# descent. How wrong is our model? That's the error!
error = y_hat - y_train
print(error.shape)
# It is a regression, so it computes mean squared error (MSE)
loss = (error**2).mean()
print(loss)
(80, 1)
2.6401126993616817
سطح هزینه
w0s, w1s, all_losses = mesh_losses(true_w0, true_w1, x_train, y_train)figure4(x_train, y_train, w[0], w[1], w0s, w1s, all_losses)(<Figure size 1200x600 with 2 Axes>,
(<Axes3D: title={'center': 'Loss Surface'}, xlabel='b', ylabel='w'>,
<Axes: title={'center': 'Loss Surface'}, xlabel='b', ylabel='w'>))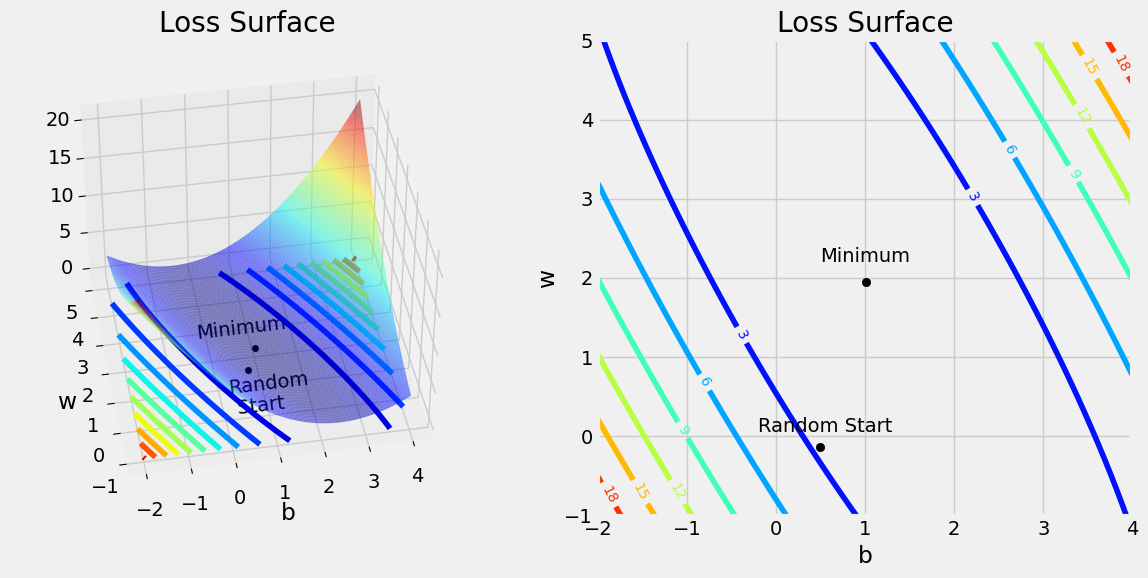
گام 3: محاسبهٔ گرادیانها
# Step 3 - Computes gradients for both "b" and "w" parameters
w0_grad = 2 * error.mean()
# w1_grad = 2 * (x_train[:,1] * error).mean() # Wrong!
w1_grad = 2 * (np.delete(x_train, 0, axis=1) * error).mean()
print(w0_grad, w1_grad)
-3.0224384959608583 -1.7706733515907813
(x_train * error).shape(80, 2)شکل برداری
# w_grad = 2 * (x_train * error).mean() # Wrong
w_grad = 2 * (x_train * error).mean(axis=0)
print(w_grad.shape, w_grad)
w_grad = np.reshape(w_grad, (2, 1))
print(w_grad.shape, w_grad)
(2,) [-3.0224385 -1.77067335]
(2, 1) [[-3.0224385 ]
[-1.77067335]]
پسانتشار
گام 4: بهروزرسانی پارامترها
$$
\begin{aligned} & b = b - \eta \frac{\partial{MSE}}{\partial{b}} \ & w = w - \eta \frac{\partial{MSE}}{\partial{w}} \end{aligned} $$
print(w.shape, w_grad.shape)(2, 1) (2, 1)
# Sets learning rate - this is "eta" ~ the "n" like Greek letter
lr = 0.1
print(w[0], w[1])

# Step 4 - Updates parameters using gradients and the
# learning rate
# w[0] = w[0] - lr * w0_grad
# w[1] = w[1] - lr * w1_grad
w = w - lr * w_grad

print(w)
print(w[0])
[0.49671415] [-0.1382643]
[[0.798958 ]
[0.03880303]]
[0.798958]
figure9(x_train, y_train, w[0], w[1])(<Figure size 600x600 with 1 Axes>, <Axes: xlabel='x', ylabel='y'>)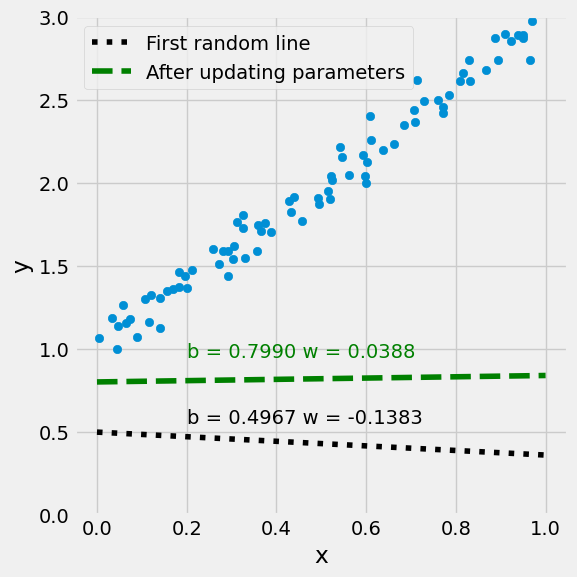
گام 5: تکرار همین بهروزرسانی!
# Initializes parameters "b" and "w" randomly
np.random.seed(42)
w = np.random.randn(2, 1)
lr = 0.3
num_epochs = 50
Losses = np.empty(num_epochs)
for epoch in range(num_epochs):
    y_hat = x_train @ w
    error = y_hat - y_train
    loss = (error**2).mean()
    Losses[epoch] = loss
    w_grad = 2 * (x_train * error).mean(axis=0)
    w_grad = np.reshape(w_grad, (2, 1))
    w = w - lr * w_grad

w
array([[1.11648206],
[1.75056848]])figure9(x_train, y_train, w[0], w[1])(<Figure size 600x600 with 1 Axes>, <Axes: xlabel='x', ylabel='y'>)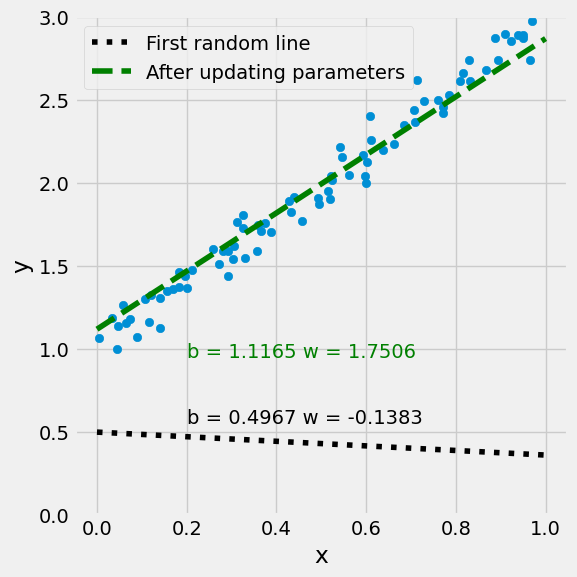
plt.plot(Losses)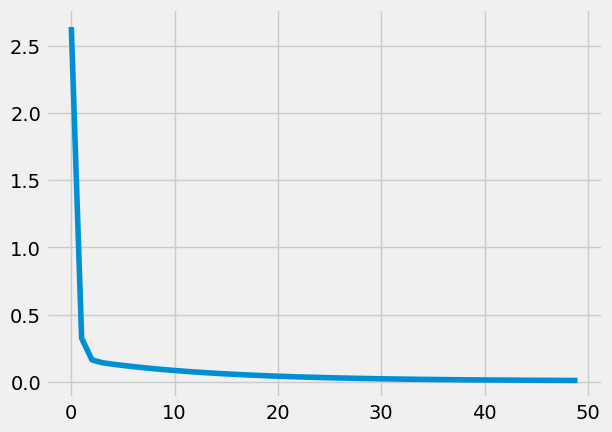
استفاده از خودمشتقگیری PyTorch
PyTorch ابزاری پایتونی برای محاسبات علمی است که چند ویژگی اصلی دارد:
torch.Tensor، آرایهای n-بعدی شبیهnumpyکه میتواند روی GPU اجرا شودگرافهای محاسباتی برای ساختن شبکههای عصبی
مشتقگیری خودکار برای آموزش شبکههای عصبی (در درس بعد بیشتر)
PyTorch را میتوانید از https://
pytorch .org/ نصب کنید
import torch
from torch import autograd

# Initializes parameters "b" and "w" randomly
np.random.seed(42)
b = np.random.randn(1)
w = np.random.randn(1)

b = torch.tensor(b, requires_grad=True)
w = torch.tensor(w, requires_grad=True)
xTrain = torch.tensor(x_train)  # xTrain is a pyTorch Tensor
yTrain = torch.tensor(y_train) # yTrain is a pyTorch Tensornp.random.seed(42)
w = np.random.randn(2, 1)
w = torch.tensor(w, requires_grad=True)
xTrain = torch.tensor(x_train) # xTrain is a pyTorch Tensor
yTrain = torch.tensor(y_train) # yTrain is a pyTorch Tensor
lr = 0.3
num_epochs = 50
for epoch in range(num_epochs):
y_hat = xTrain @ w
error = y_hat - yTrain
loss = (error**2).mean(axis=0)
# removed the manual derivative computation and use autograd instead
loss.backward()
with torch.no_grad():
w -= lr * w.grad
# Manually zero the gradients after updating weights
w.grad = None
wtensor([[1.1165],
[1.7506]], dtype=torch.float64, requires_grad=True)https://
PyTorch: تعریف توابع autograd تازه
PyTorch: ماژول nn
PyTorch: optim
PyTorch: ماژولهای nn سفارشی
استفاده از کتابخانهٔ PyTorch
import torch
import torch.nn as nn

# x_train.dtype is float64, so cast both inputs to float32
xTrain = torch.tensor(x_train, dtype=torch.float32)
yTrain = torch.tensor(y_train, dtype=torch.float32)

# the same simple model as before: one input, one output, with bias
# now that the data has two columns we either use the second column only
# or define the model without a bias
model = nn.Linear(2, 1, bias=False)

learning_rate = 0.3
f = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)

num_epochs = 50
for epoch in range(num_epochs):
    y_hat = model(xTrain)
    loss = f(y_hat, yTrain)
    loss.backward()  # backward propagation: calculate gradients
    optimizer.step()  # update the weights
    optimizer.zero_grad()  # clear out the gradients from the last step loss.backward()
print(model)
print(model.bias)
print(model.weight)
print(model.weight[0])
print(model.weight[0][0])
print(model.weight[0][0].item())
print(model.weight[0].detach().numpy()[0])Linear(in_features=2, out_features=1, bias=False)
None
Parameter containing:
tensor([[1.0971, 1.7887]], requires_grad=True)
tensor([1.0971, 1.7887], grad_fn=<SelectBackward0>)
tensor(1.0971, grad_fn=<SelectBackward0>)
1.0971075296401978
1.0971075
w = model.weight[0].detach().numpy()
w = np.reshape(w, (2, 1))
figure9(x_train, y_train, w[0], w[1])
(<Figure size 600x600 with 1 Axes>, <Axes: xlabel='x', ylabel='y'>)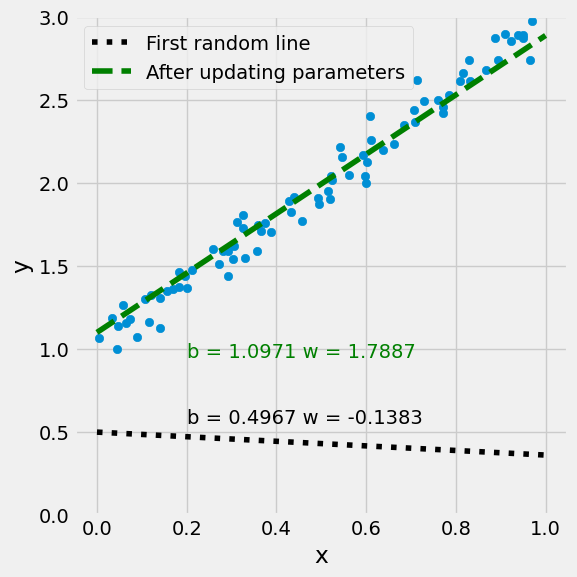
مطالعهٔ بیشتر:
Why use gradient descent for linear regression, when a closed-form math solution is available?
بخشی از پایاننامههای کارشناسی ارشد پیشین مرتبط با رگرسیون (به فارسی):
- Zaki, M. J., & Meira, W. (2020). Data Mining and Machine Learning: Fundamental Concepts and Algorithms (2nd ed.). Cambridge University Press. https://www.cambridge.org/9781108497367