شبکههای عصبی و پسانتشار
محمود امینطوسی، پاییز ۱۴۰۵
گروه علوم کامپیوتر، دانشگاه فردوسی مشهد
باید بگویم مطالب اصلی از درس تاماس بیوزن گرفته شده است.
هدفهای یادگیری درس
تفاوت آرایههای
numpyوtorch(np.arrayدر برابرtorch.Tensor) را توضیح دهیدمفاهیم بنیادی شبکههای عصبی مانند لایهها، گرهها، توابع فعالسازی و … را توضیح دهید
یک شبکهٔ عصبی ساده در PyTorch برای رگرسیون یا دستهبندی بسازید
گرادیانهای یک شبکهٔ کوچک را دستی استنتاج کنید و با
backward()بسنجید
واردکردنها
Notebook Cell
# Auto-setup when running on Google Colab
import os
if 'google.colab' in str(get_ipython()) and not os.path.exists('/content/neural-networks'):
    !git clone -q https://github.com/fum-cs/neural-networks.git /content/neural-networks
    !pip --quiet install -r /content/neural-networks/requirements_colab.txt
    %cd neural-networks/notebooks
Notebook Cell
import warnings
warnings.filterwarnings('ignore')
import sys
import numpy as np
import pandas as pd
import torch
from torchsummary import summary
from torch import nn, optim
from torch.utils.data import DataLoader, TensorDataset
from sklearn.datasets import make_regression, make_circles, make_blobs
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
from utils.plotting import *
import plotly.io as pio
pio.renderers.default = 'notebook'
1. مقدمه
PyTorch ابزاری پایتونی برای محاسبات علمی است که چند ویژگی اصلی دارد:
torch.Tensor، آرایهای n-بعدی شبیهnumpyکه میتواند روی GPU اجرا شودگرافهای محاسباتی برای ساختن شبکههای عصبی
مشتقگیری خودکار برای آموزش شبکههای عصبی (در درس بعد بیشتر)
PyTorch را میتوانید از https://
pytorch .org/ نصب کنید
2. تنسور در PyTorch
در PyTorch تنسور دقیقاً مانند
ndarrayدر NumPy است که با آن چنان آشنا شدهایم.تفاوت کلیدی
torch.Tensorباnp.arrayاین است کهtorch.Tensorبرای یکپارچگی با GPU و گرافهای محاسباتی PyTorch ساخته شده (هرچند در درس بعد بیشتر دربارهاش میگوییم)
2.1. ndarray در برابر tensor
ساختن و کار با تنسورها تقریباً همانند
ndarrayهای numpy استمیتوانید تنسور را با
torch.tensor()بسازید:
tensor_1 = torch.tensor([1, 2, 3])
tensor_2 = torch.tensor([1, 2, 3], dtype=torch.float32)
tensor_3 = torch.tensor(np.array([1, 2, 3]))

for t in [tensor_1, tensor_2, tensor_3]:
    print(f"{t}, dtype: {t.dtype}")
tensor([1, 2, 3]), dtype: torch.int64
tensor([1., 2., 3.]), dtype: torch.float32
tensor([1, 2, 3], dtype=torch.int32), dtype: torch.int32
PyTorch بیشتر تابعهای
numpyرا که میشناسیم هم دارد:
torch.zeros(2, 2) # zeroestensor([[0., 0.],
[0., 0.]])torch.ones(2, 2) # onestensor([[1., 1.],
[1., 1.]])torch.randn(3, 2) # random normaltensor([[ 0.3388, 0.0180],
[-0.1241, 0.9065],
[-1.6244, 0.1037]])torch.rand(2, 3, 2) # rand uniformtensor([[[0.8185, 0.1055],
[0.7195, 0.2424],
[0.8114, 0.7107]],
[[0.8324, 0.9311],
[0.1115, 0.8091],
[0.0066, 0.2076]]])همانند NumPy میتوانیم شکل تنسور را با صفت
.shapeببینیم:
x = torch.rand(2, 3, 2, 2)
x.shape
torch.Size([2, 3, 2, 2])x.ndim42.2. تنسورها و نوع داده
نوعهای دادهٔ مختلف پیامدهای حافظهای و محاسباتی مختلفی دارند (مستندات نوعهای دادهٔ NumPy را برای بیشتر ببینید)
در PyTorch شبکههایی میسازیم که هزاران یا حتی میلیونها محاسبهٔ اعشاری دارند!
در چنین حالتهایی استفاده از نوع کوچکتری مثل
float32میتواند محاسبات را بهشکل چشمگیری سریع تر کند و نیاز حافظه را کم کندنوع اعشاری پیشفرض در PyTorch
float32است، برخلافfloat64در numpyدر واقع برخی عملیات در PyTorch حتی اگر
dtypeپرمصرفی بدهید خطا میدهند!
print(np.array([3.14159]).dtype)
print(torch.tensor([3.14159]).dtype)
float64
torch.float32
ولی همانند numpy همیشه میتوانید نوع دادهٔ دلخواه را با آرگومان
dtypeتعیین کنید:
print(torch.tensor([3.14159], dtype=torch.float64).dtype)torch.float64
2.3. عملیات روی تنسورها
تنسورها دقیقاً مانند
ndarrayها کار میکنند و متدهای آشنای زیادی دارند که میتوان رویشان صدا زد:
a = torch.rand(1, 3)
b = torch.rand(3, 1)

a + b  # broadcasting betweean a 1 x 3 and 3 x 1 tensor
tensor([[0.6376, 0.8497, 0.5364],
[0.1417, 0.3538, 0.0404],
[0.8795, 1.0915, 0.7782]])a * btensor([[5.5718e-02, 1.6878e-01, 1.7360e-03],
[3.8856e-03, 1.1771e-02, 1.2106e-04],
[8.0994e-02, 2.4535e-01, 2.5235e-03]])a.mean()tensor(0.1415)a.sum()tensor(0.4244)2.4. اندیسگذاری
باز هم همانند NumPy!
X = torch.rand(5, 2)
print(X)
tensor([[0.5512, 0.5119],
[0.8011, 0.4224],
[0.1395, 0.0438],
[0.5987, 0.7250],
[0.2124, 0.4778]])
print(X[0, :])
print(X[0])
print(X[:, 0])
tensor([0.5512, 0.5119])
tensor([0.5512, 0.5119])
tensor([0.5512, 0.8011, 0.1395, 0.5987, 0.2124])
2.5. پل با Numpy
بعضی وقتها میخواهیم تنسور را به آرایهٔ NumPy برگردانیم
این کار را با متد
.numpy()میکنیم
X = torch.rand(3,3)
print(type(X))
X_numpy = X.numpy()
print(type(X_numpy))
<class 'torch.Tensor'>
<class 'numpy.ndarray'>
2.6. GPU و تنسورهای CUDA
GPU واحد پردازش گرافیکی است (در برابر CPU: واحد پردازش مرکزی)
GPUها در آغاز برای بازی ساخته شدند و با انجام موازی عملیات روی حجم زیادی داده بسیار سریعاند (به بهروزرسانی سریع مقدار همهٔ پیکسلهای صفحه هنگام جابهجایی بازیکن در بازی فکر کنید)
اخیراً GPUها برای برنامهنویسی با کاربرد عمومیتر سازگار شدهاند
شبکههای عصبی را معمولاً میتوان به محاسبات کوچکتری شکست که روی GPU موازی انجام شوند
PyTorch بهطور تنگ با CUDA یکپارچه است — لایهای نرمافزاری که تعامل با GPU را (اگر داشته باشید) آسان میکند
میتوانید با این کار توان GPU را بررسی کنید:
torch.cuda.is_available() # my MacBook Pro does not have a GPUFalseهنگام آموزش روی ماشینی با GPU، باید به PyTorch بگویید که میخواهید از آن استفاده کنید
در بالای بیشتر کدهای PyTorch چنین چیزی میبینید:
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(device)
cpu
بعد میتوانید هنگام ساختن تنسورها آرگومان
deviceرا به کار ببرید و بگویید CPU یا GPU را میخواهیدیا اگر میخواهید تنسوری را میان CPU و GPU جابهجا کنید، از متد
.to()استفاده کنید:
X = torch.rand(2, 2, 2, device=device)
print(X.device)
cpu
# X.to('cuda') # this would give an error for me so I'm commenting outبعداً در درس، وقتی با مجموعهدادههای بزرگتر و شبکههای پیچیدهتر کار میکنیم، به GPU برمیگردیم
فعلاً روی CPU هم خوب کار میکنیم
3. مبانی شبکهٔ عصبی
پیشتر چند الگوریتم یادگیری ماشین را یاد گرفتهاید (kNN، جنگل تصادفی، SVM و …)
شبکههای عصبی هم فقط الگوریتم دیگری هستند و به نظر من یکی از سادهترینها!
همانطور که میبینیم، شبکهٔ عصبی فقط دنبالهای از تبدیلهای خطی و ناخطی است
اغلب هنگام یادگیری یا استفاده از شبکههای عصبی چنین چیزی میبینید:
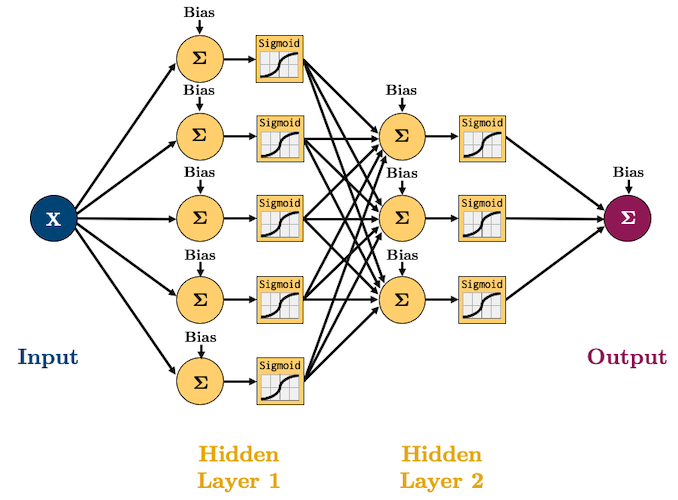
خب، اینها به چه معناست؟ گامبهگام شهودی میسازیم
3.1. رگرسیون خطی ساده با یک شبکهٔ عصبی
بیایید مجموعهدادهٔ رگرسیون سادهای با 500 مشاهده بسازیم:
X, y = make_regression(n_samples=500, n_features=1, random_state=0, noise=10.0)
plot_regression(X, y)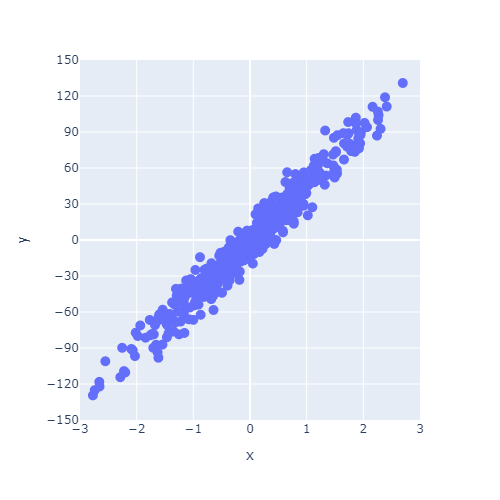
میدانیم چگونه با sklearn یک رگرسیون خطی ساده را به این داده برازش دهیم:
sk_model = LinearRegression().fit(X, y)
plot_regression(X, y, sk_model.predict(X))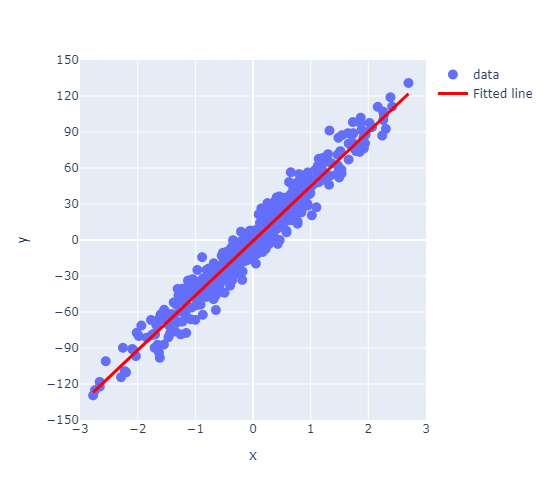
این پارامترهای خط برازششدهاند:
print(f"w_0: {sk_model.intercept_:.2f} (bias/intercept)")
print(f"w_1: {sk_model.coef_[0]:.2f}")
w_0: -0.77 (bias/intercept)
w_1: 45.50
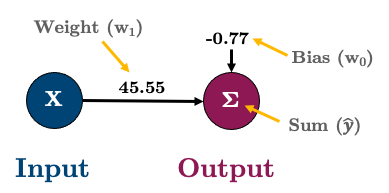
3.2. رگرسیون خطی با یک شبکهٔ عصبی در PyTorch
پس بیایید موارد بالا را در PyTorch پیاده کنیم و شهودی دربارهٔ شبکههای عصبی بسازیم!
هر مدل شبکهٔ عصبی که در PyTorch بسازید از
torch.nn.Moduleارث میبردوراثت به ما اجازه میدهد کارکردهای رایج لازم را بدون نوشتن کد خودمان به ارث ببریم! W3 Schools درسنامهٔ کوچک خوبی برای وراثت کلاس در پایتون دارد.
در آزمایشگاه
torch.nn.Moduleرا بیشتر بررسی میکنیم، ولی اگر کمک کند به مدلهای sklearn فکر کنید: همهشان متدهای رایجی مثل.fit()،.predict()،.score()و … را به ارث میبرند. هنگام ساختن شبکهٔ عصبی معماری خودمان را تعریف میکنیم ولی هنوز کارکردهای رایج را میخواهیم که ازtorch.nn.Moduleبه ارث میبریم.
بیایید مدلی به نام
linearRegressionبسازیم و بعد نحو آن را برایتان توضیح میدهم:
class linearRegression(nn.Module):  # our class inherits from nn.Module and we can call it anything we like
    def __init__(self, input_size, output_size):
        super().__init__()                                # super().__init__() makes our class inherit everything from torch.nn.Module
        self.linear = nn.Linear(input_size, output_size)  # this is a simple linear layer: wX + b

    def forward(self, x):
        out = self.linear(x)
        return out
بیایید موارد بالا را گامبهگام ببینیم:
class linearRegression(nn.Module):
    def __init__(self, input_size, output_size):
        super().__init__()
اینجا کلاسی به نام linearRegression میسازیم و متدها و صفتهای nn.Module را به ارث میبریم
(راهنما: help(linearRegression) را بزنید تا ببینید چه چیزهایی از nn.Module به ارث بردهایم).
self.linear = nn.Linear(input_size, output_size)اینجا لایهای «خطی» تعریف میکنیم که فقط یعنی wX + b، یعنی وزنهای شبکه ضرب در ویژگیهای ورودی
بهعلاوهٔ بایاس.
    def forward(self, x):
        out = self.linear(x)
return outشبکههای PyTorch که با nn.Module ساخته میشوند باید متد forward() داشته باشند. دادهٔ ورودی x را
میگیرد و از عملیات تعریفشده میگذراند. اینجا x را به لایهٔ خطی میدهیم و خروجی out را میگیریم.
پس از تعریف کلاس مدل، میتوانیم نمونهای از آن بسازیم:
model = linearRegression(input_size=1, output_size=1)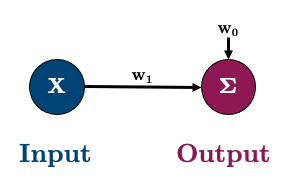
میتوانیم مدل را با
print()ببینیم:
print(model)linearRegression(
(linear): Linear(in_features=1, out_features=1, bias=True)
)
یا با
summary()مفیدتر (که در بالای این نوتبوک باfrom torchsummary import summaryوارد کردیم):
summary(model, (1,));----------------------------------------------------------------
Layer (type) Output Shape Param #
================================================================
Linear-1 [-1, 1] 2
================================================================
Total params: 2
Trainable params: 2
Non-trainable params: 0
----------------------------------------------------------------
Input size (MB): 0.00
Forward/backward pass size (MB): 0.00
Params size (MB): 0.00
Estimated Total Size (MB): 0.00
----------------------------------------------------------------
توجه کنید دو پارامتر داریم؟ یکی برای وزن (
w1) و یکی برای بایاس (w0)PyTorch هنگام ساختن مدل اینها را تصادفی مقداردهی کرد. با
model.state_dict()به آنها دسترسی دارید:
model.state_dict()OrderedDict([('linear.weight', tensor([[0.3072]])),
('linear.bias', tensor([-0.9891]))])خب، پیش از ادامه، دادههای
xوyما فعلاً آرایههای numpy هستند ولی باید تنسور PyTorch باشندبیایید تبدیلشان کنیم:
X_t = torch.tensor(X, dtype=torch.float32)
y_t = torch.tensor(y, dtype=torch.float32)
اکنون مدلی داریم که کار میکند و میتوانیم با این نحو از آن خروجی بگیریم:
y_p = model(X_t[0]).item()
print(f"Predicted: {y_p:.2f}")
print(f"   Actual: {y[0]:.2f}")
Predicted: -0.80
Actual: 31.08
پیشبینی ما بد است چون مدل هنوز آموزش ندیده/برازش نشده!
همانطور که در چند درس گذشته یاد گرفتیم، برای برازش مدل به اینها نیاز داریم:
یک تابع هزینه (که در PyTorch «criterion» نامیده میشود) تا بگوید پیشبینیهای ما چقدر خوب/بد هستند — از میانگین مربع خطا،
torch.nn.MSELoss()، استفاده میکنیمیک الگوریتم بهینهسازی برای کمک به بهینه کردن پارامترهای مدل — از GD،
torch.optim.SGD()استفاده میکنیم
LEARNING_RATE = 0.1
criterion = nn.MSELoss()  # loss function
optimizer = torch.optim.SGD(model.parameters(), lr=LEARNING_RATE)  # optimization algorithm is SGD
پیش از آموزش یک «بارگذار داده» میسازم تا به دستهبندی داده کمک کند
بارگذارهای داده فقط مولدهایی هستند که داده را بهدرخواست yield میکنند.
از
BATCH_SIZE = 50استفاده میکنیم (که با 500 نقطهٔ داده 10 دسته میدهد)
BATCH_SIZE = 50
dataset = TensorDataset(X_t, y_t)
dataloader = DataLoader(dataset, batch_size=BATCH_SIZE, shuffle=True)
باید 10 دسته داشته باشیم:
print(f"Total number of batches: {len(dataloader)}")Total number of batches: 10
میتوانیم با این نحو یک دسته را ببینیم:
XX, yy = next(iter(dataloader))
print(f" Shape of feature data (X) in batch: {XX.shape}")
print(f"Shape of response data (y) in batch: {yy.shape}")
Shape of feature data (X) in batch: torch.Size([50, 1])
Shape of response data (y) in batch: torch.Size([50])
با اینها، شبکهٔ سادهمان را ۵ دوره با SGD آموزش دهیم!
این بلوک را در بخش 5 خطبهخط باز میکنیم؛ فعلاً فقط توجه کنید که هزینه را حساب میکند، گرادیان میخواهد و یک گام برمیدارد.
def trainer(model, criterion, optimizer, dataloader, epochs=5, verbose=True):
    """Simple training wrapper for PyTorch network."""

    for epoch in range(epochs):
        losses = 0
        for X, y in dataloader:
            optimizer.zero_grad()       # Clear gradients w.r.t. parameters
            y_hat = model(X).flatten()  # Forward pass to get output
            loss = criterion(y_hat, y)  # Calculate loss
            loss.backward()             # Getting gradients w.r.t. parameters
            optimizer.step()            # Update parameters
            losses += loss.item()       # Add loss for this batch to running total
        if verbose: print(f"epoch: {epoch + 1}, loss: {losses / len(dataloader):.4f}")

trainer(model, criterion, optimizer, dataloader, epochs=5, verbose=True)
epoch: 1, loss: 648.7896
epoch: 2, loss: 99.0878
epoch: 3, loss: 94.1367
epoch: 4, loss: 93.6165
epoch: 5, loss: 93.4385
اکنون مدل آموزش دیده و پارامترهایمان باید با پیش از این فرق داشته باشند:
model.state_dict()OrderedDict([('linear.weight', tensor([[45.7395]])),
('linear.bias', tensor([-0.7178]))])در مقایسه با مدل sklearn همان جواب را میگیریم:
pd.DataFrame({"w0": [sk_model.intercept_, model.state_dict()['linear.bias'].item()],
              "w1": [sk_model.coef_[0], model.state_dict()['linear.weight'].item()]},
index=['sklearn', 'pytorch']).round(2)خیلی نزدیک شدیم! میتوانستیم با تغییر تعداد دورهها یا نرخ یادگیری بهتر شویم
پس شبکهٔ سادهمان باز هم این است:
راستی، ببینید اگر
trainer()را دوباره اجرا کنیم چه میشود:
trainer(model, criterion, optimizer, dataloader, epochs=5, verbose=True)epoch: 1, loss: 93.5241
epoch: 2, loss: 94.1431
epoch: 3, loss: 93.9253
epoch: 4, loss: 93.4623
epoch: 5, loss: 93.8662
مدل از جایی که رها کردیم ادامه میدهد!
این شاید آنچه میخواستید باشد یا نباشد. با ساختن دوبارهٔ
modelوoptimizerاز صفر شروع میکنیم.
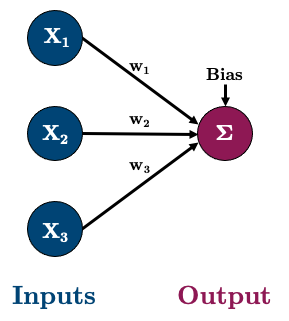
3.3. رگرسیون خطی چندگانه با یک شبکهٔ عصبی
خب، حالا یک رگرسیون خطی چندگانه با 3 ویژگی انجام دهیم
پس شبکهمان چنین میشود:
بیایید داده بسازیم:
# Create dataset
X, y = make_regression(n_samples=500, n_features=3, random_state=0, noise=10.0)
X_t = torch.tensor(X, dtype=torch.float32)
y_t = torch.tensor(y, dtype=torch.float32)
# Create dataloader
dataset = TensorDataset(X_t, y_t)
dataloader = DataLoader(dataset, batch_size=BATCH_SIZE, shuffle=True)
و مدل بالا را بسازیم:
model = linearRegression(input_size=3, output_size=1)اکنون باید 4 پارامتر داشته باشیم (3 وزن و 1 بایاس)
summary(model, (3,));----------------------------------------------------------------
Layer (type) Output Shape Param #
================================================================
Linear-1 [-1, 1] 4
================================================================
Total params: 4
Trainable params: 4
Non-trainable params: 0
----------------------------------------------------------------
Input size (MB): 0.00
Forward/backward pass size (MB): 0.00
Params size (MB): 0.00
Estimated Total Size (MB): 0.00
----------------------------------------------------------------
به نظر خوب است! مدل را آموزش دهیم و بعد با
LinearRegression()در sklearn مقایسه کنیم:
criterion = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=LEARNING_RATE)
trainer(model, criterion, optimizer, dataloader, epochs=5, verbose=True)
epoch: 1, loss: 1007.8107
epoch: 2, loss: 110.3681
epoch: 3, loss: 102.1059
epoch: 4, loss: 101.9216
epoch: 5, loss: 102.1261
sk_model = LinearRegression().fit(X, y)
pd.DataFrame({"w0": [sk_model.intercept_, model.state_dict()['linear.bias'].item()],
              "w1": [sk_model.coef_[0], model.state_dict()['linear.weight'][0, 0].item()],
              "w2": [sk_model.coef_[1], model.state_dict()['linear.weight'][0, 1].item()],
              "w3": [sk_model.coef_[2], model.state_dict()['linear.weight'][0, 2].item()]},
index=['sklearn', 'pytorch']).round(2)3.4. رگرسیون ناخطی با یک شبکهٔ عصبی
خب، میتوانیم شبکهٔ سادهای بسازیم که رگرسیون خطی ساده و چندگانه را تقلید کند
احتمالاً فکر میکنید که خب، که چه؟ ولی قول میدهم به بخش خوبش میرسیم!
مثلاً وقتی مجموعهدادهٔ پیچیدهتری مثل این داریم چه میشود؟
# Create dataset
np.random.seed(2020)
X = np.sort(np.random.randn(500))
y = X ** 2 + 15 * np.sin(X) **3
X_t = torch.tensor(X[:, None], dtype=torch.float32)
y_t = torch.tensor(y, dtype=torch.float32)
# Create dataloader
dataset = TensorDataset(X_t, y_t)
dataloader = DataLoader(dataset, batch_size=BATCH_SIZE, shuffle=True)
plot_regression(X, y, y_range=[-25, 25], dy=5)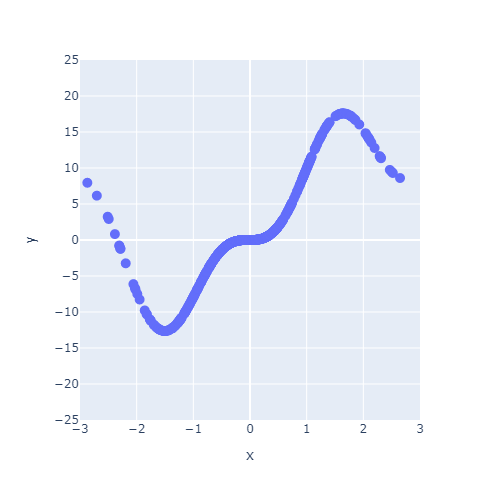
این آشکارا ناخطی است و باید ناخطیبودنهایی به شبکه وارد کنیم
همین ناخطیبودنها هستند که شبکههای عصبی را چنان توانمند میکنند و «توابع فعالسازی» نام دارند
کلاس مدل تازهای میسازیم که ناخطیبودنی — تابع سیگموید — دارد:
def sigmoid(x):
    return 1 / (1 + np.exp(-x))

xs = np.linspace(-15, 15, 100)
plot_regression(xs, [0], sigmoid(xs), x_range=[-5, 5], y_range=[0, 1], dy=0.2)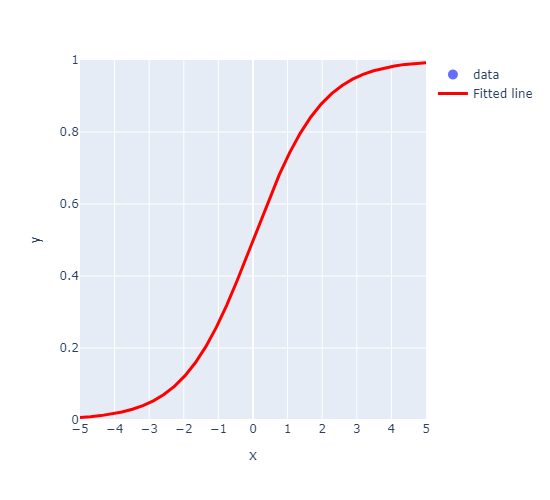
بعداً دربارهٔ توابع فعالسازی بیشتر میگوییم، ولی توجه کنید تابع سیگموید
xرا بهصورت ناخطی به مقداری بین 0 و 1 مینگاردخب، شبکهٔ زیر را بسازیم:
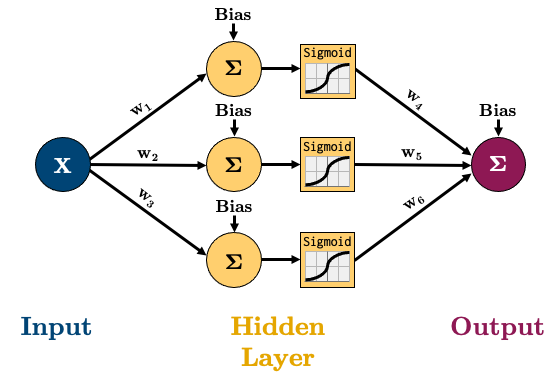
تمام معنایش این است که مقدار هر گره در لایهٔ پنهان با «تابع فعالسازی» دگرگون میشود و عنصرهای ناخطی به مدل وارد میکند!
دو راه اصلی برای ساختن مدل بالا در PyTorch هست، هر دو را نشان میدهم:
class nonlinRegression(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.hidden = nn.Linear(input_size, hidden_size)
        self.output = nn.Linear(hidden_size, output_size)
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        x = self.hidden(x)       # input -> hidden layer
        x = self.sigmoid(x)      # sigmoid activation function in hidden layer
        x = self.output(x)       # hidden -> output layer
        return x
توجه کنید متد
forward()ما اکنونxرا پس از لایهٔ پنهان از تابعnn.Sigmoid()میگذراندروش بالا بسیار روشن و انعطافپذیر است، ولی من استفاده از
nn.Sequential()برای ترکیب لایهها در سازنده را ترجیح میدهم:
class nonlinRegression(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.main = torch.nn.Sequential(
            nn.Linear(input_size, hidden_size),  # input -> hidden layer
            nn.Sigmoid(),                        # sigmoid activation function in hidden layer
            nn.Linear(hidden_size, output_size)  # hidden -> output layer
        )

    def forward(self, x):
        x = self.main(x)
        return x
بیایید نمونهای از کلاس تازه بسازیم و تأیید کنیم 10 پارامتر دارد (6 وزن و 4 بایاس):
model = nonlinRegression(1, 3, 1)
summary(model, (1,))
----------------------------------------------------------------
Layer (type) Output Shape Param #
================================================================
Linear-1 [-1, 3] 6
Sigmoid-2 [-1, 3] 0
Linear-3 [-1, 1] 4
================================================================
Total params: 10
Trainable params: 10
Non-trainable params: 0
----------------------------------------------------------------
Input size (MB): 0.00
Forward/backward pass size (MB): 0.00
Params size (MB): 0.00
Estimated Total Size (MB): 0.00
----------------------------------------------------------------
خب، آموزش دهیم:
criterion = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.3)
trainer(model, criterion, optimizer, dataloader, epochs=10, verbose=True)
epoch: 1, loss: 32.5818
epoch: 2, loss: 14.8140
epoch: 3, loss: 7.6448
epoch: 4, loss: 5.2685
epoch: 5, loss: 4.8211
epoch: 6, loss: 4.7319
epoch: 7, loss: 4.4413
epoch: 8, loss: 4.2567
epoch: 9, loss: 4.3213
epoch: 10, loss: 4.2639
y_p = model(X_t).detach().numpy().squeeze()
plot_regression(X, y, y_p, y_range=[-25, 25], dy=5)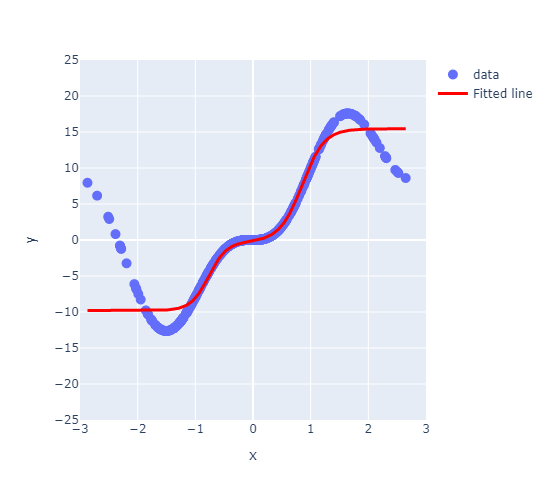
به آن پیشبینیهای ناخطی نگاه کنید! جالب است!
مدل ما عالی نیست و میتوانیم با تنظیم نرخ یادگیری، تعداد گرهها و تعداد دورهها بهترش کنیم
ولی واقعاً میخواهم ببینید هر یک از گرههای پنهانمان یک «ویژگی ناخطی مهندسی میکند» تا در پیشبینی به کار رود، ببینید:
plot_nodes(X, y_p, model)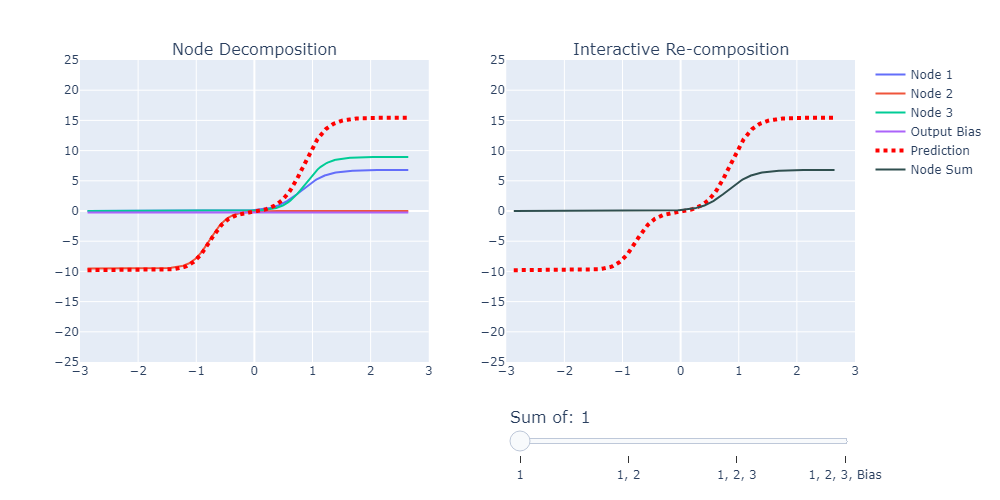
3.5. پرسپترون چندلایه
احتمالاً اصطلاح جادویی «MLP» را شنیدهاید و الان میفهمید یعنی چه!
واقعاً فقط یک شبکهٔ عصبی با بیش از 1 لایهٔ پنهان است! ساده است!
بیایید شبکهٔ «MLP» دو لایه بسازیم:
class multiLayerRegression(nn.Module):
    def __init__(self, input_size, hidden_size_1, hidden_size_2, output_size):
        super().__init__()
        self.main = nn.Sequential(
            nn.Linear(input_size, hidden_size_1),
            nn.Sigmoid(),
            nn.Linear(hidden_size_1, hidden_size_2),
            nn.Sigmoid(),
            nn.Linear(hidden_size_2, output_size)
        )

    def forward(self, x):
        out = self.main(x)
        return out
model = multiLayerRegression(1, 5, 3, 1)
optimizer = torch.optim.SGD(model.parameters(), lr=0.3)
trainer(model, criterion, optimizer, dataloader, epochs=20, verbose=False)
plot_regression(X, y, model(X_t).detach(), y_range=[-25, 25], dy=5)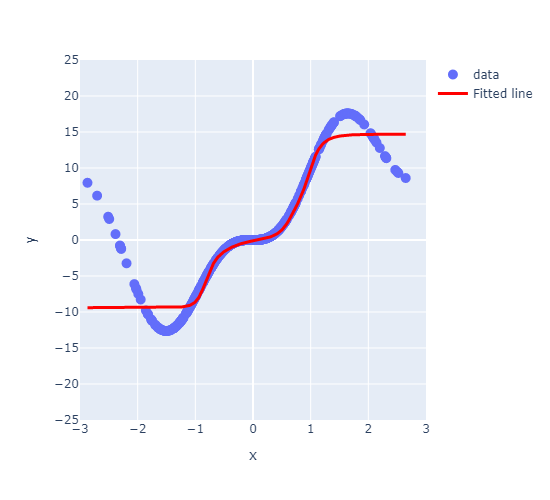
ولی فقط چون شبکه لایههای بیشتری دارد لزوماً بهتر نیست!
4. توابع فعالسازی
همانطور که بالا یاد گرفتیم، توابع فعالسازی همان چیزی هستند که به ما اجازه میدهند توابع پیچیدهٔ ناخطی را مدل کنیم
توابع فعالسازی بسیار متنوعاند:
functions = [torch.nn.Sigmoid, torch.nn.Tanh, torch.nn.Softplus, torch.nn.ReLU, torch.nn.LeakyReLU, torch.nn.SELU]
plot_activations(torch.linspace(-6, 6, 100), functions)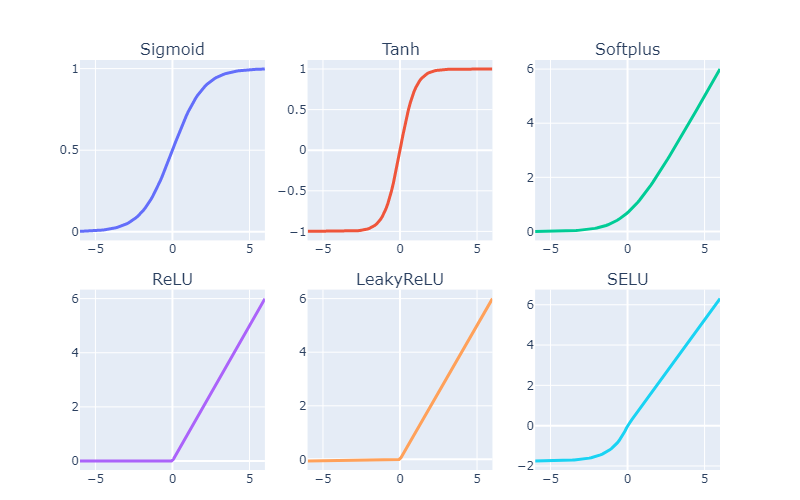
توابع فعالسازی باید ناخطی باشند و معمولاً یکنوا و پیوستهمشتق (هموار) هستند
ولی همانطور که با تابع ReLU بالا میبینید، همیشه اینطور نیست!
میخواستم این را بگویم چون نشان میدهد یادگیری عمیق واقعاً چقدر هنر است.
این نقلقول خوبی از یوشوا بنجیو (نامدار در کار روی هوش مصنوعی و یادگیری عمیق) دربارهٔ آزمایش گروهش با ReLU است:
«... یکی از بزرگترین اشتباههایم این بود که مثل همه در دههٔ ۹۰ فکر میکردم برای کار کردن پسانتشار به ناخطیبودنهای هموار نیاز دارید، چون فکر میکردم اگر چیزی مثل ناخطیبودنهای یکسوساز داشته باشیم که بخش تخت دارد، آموزشش واقعاً سخت میشود، چون مشتق در جاهای بسیاری صفر میشود. و وقتی حدود ۲۰۱۰ با شبکههای عمیق آزمایش ReLU را شروع کردیم، وسواس این ایده را داشتم که باید مراقب باشیم نورونها روی بخش صفر زیادی اشباع نشوند. ولی در پایان معلوم شد که ReLU واقعاً بسیار بهتر از سیگموید و tanh کار میکرد، و این غافلگیری بزرگی بود... معلوم شد بهتر کار میکند، در حالی که فکر میکردم آموزشش سختتر است!»
بههرحال، به کوتاهی ReLU احتمالاً امروز محبوبترین است، ولی میتوانید توابع فعالسازی را ابرپارامتر (برای بهینهسازی) بگیرید
5. پسانتشار
هر شبکهای که تا اینجا برازش کردیم با همان بلوک کوتاه کد آموزش دید، پنهان درون
trainer():
optimizer.zero_grad()        # 1. forget the gradients left by the previous batch
y_hat = model(X).flatten()   # 2. forward pass: compute the prediction
loss  = criterion(y_hat, y)  # 3. how wrong are we?
loss.backward()              # 4. backward pass: compute the gradients
optimizer.step()             # 5. move the parameters against the gradient
خط
loss.backward()همان است که جعبهٔ سیاه گرفتهایم. این پسانتشار است: قاعدهٔ زنجیره، اعمالشده به عقب در شبکه، لایه به لایه.ترفند این است که مشتق هزینه نسبت به خروجی یک بار حساب میشود و بعد هر پارامتری که در آن خروجی سهم داشته از آن دوباره استفاده میکند. همین دلیل است که یک گذر پسرو تقریباً بهقدر یک گذر پیشرو هزینه دارد، نه یک گذر پیشرو برای هر پارامتر.
برای دیدن این بهطور ملموس، کوچکترین شبکهای را بگیرید که هنوز ناخطی است: یک ورودی، دو واحد پنهان سیگمویدی و یک خروجی.
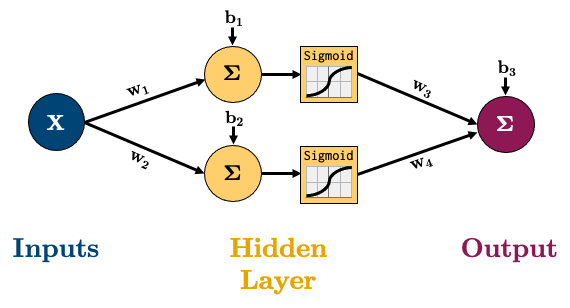
5.1. گذر پیشرو، دستی
وزنها و بایاسها را همانند شکل زیر ثابت کنید و یک مشاهدهٔ با هدف به شبکه بدهید.
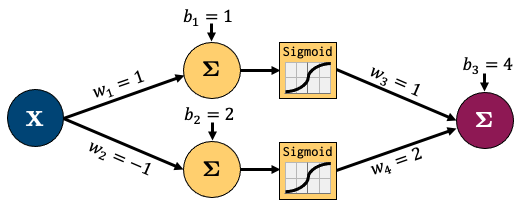
گذر پیشرو ضرب، جمع، فشردن است — دو بار:
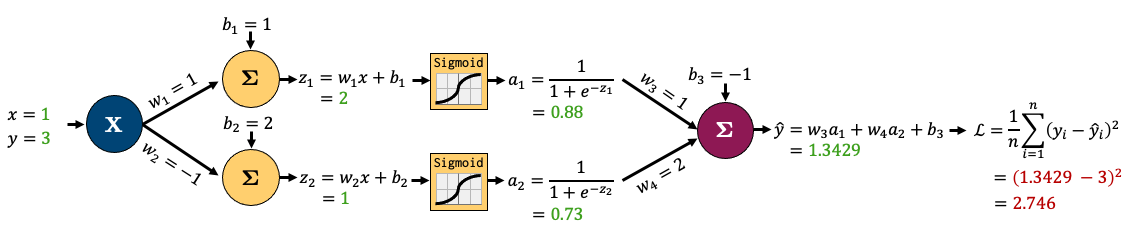
هیچ چیز اینجا تازه نیست: یک لایهٔ خطی، یک سیگموید، لایهٔ خطی دیگر و خطای مربعی، زنجیرهشده.
5.2. گذر پسرو، دستی
از هزینه شروع کنید و بپرسید وقتی تغییر کند چگونه تغییر میکند. برای خطای مربعی، .
همین یک عدد گرادیان بالادستی است. هر پارامتر پایینترش گرادیان خودش را با ضرب گرادیان بالادستی در مشتق محلی خودش میگیرد:
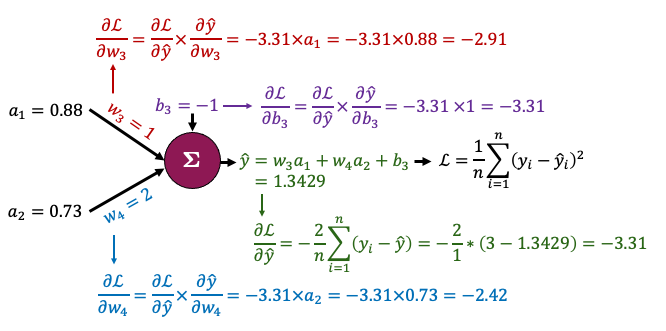
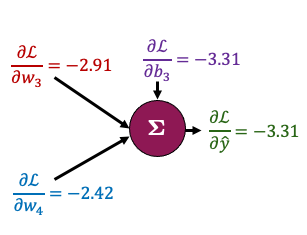
برای لایهٔ پنهان به عقب رفتن را ادامه میدهیم: لایهٔ خروجی گرادیان نسبت به هر فعالسازی را برمیگرداند و سیگموید مشتق خودش را میدهد. با و :
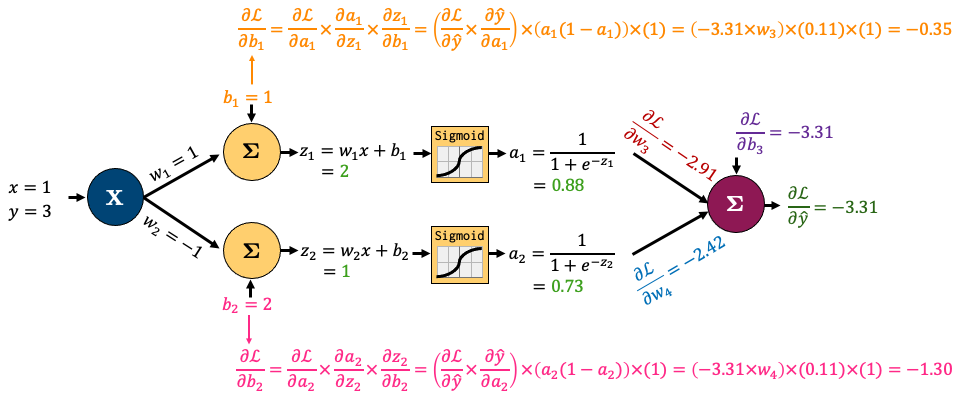
همین دستور روی واحد پنهان دوم و روی اولی میدهد.
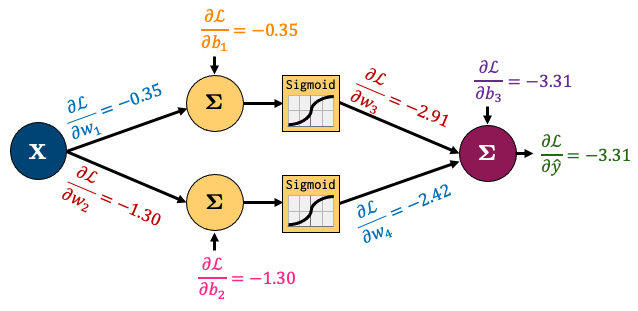
5.3. همان گرادیانها از PyTorch
میتوانیم شبکه را دقیقاً روی وزنهای شکل تنظیم کنیم و بگذاریم PyTorch حسابداری کند. عددهای زیر باید تا دو رقم اعشار با محاسبهٔ دستی بخوانند.
torch.manual_seed(0)

net = nn.Sequential(nn.Linear(1, 2), nn.Sigmoid(), nn.Linear(2, 1))
with torch.no_grad():  # the weights of the figure, not random ones
    net[0].weight.copy_(torch.tensor([[1.0], [-1.0]]))
    net[0].bias.copy_(torch.tensor([1.0, 2.0]))
    net[2].weight.copy_(torch.tensor([[1.0, 2.0]]))
    net[2].bias.copy_(torch.tensor([-1.0]))

x, y = torch.tensor([[1.0]]), torch.tensor([[3.0]])
y_hat = net(x)
loss = (y_hat - y) ** 2
loss.backward()

print(f"y_hat = {y_hat.item():.4f}, loss = {loss.item():.4f}")
for name, p in net.named_parameters():
    print(f"{name:10s}", [round(g, 2) for g in p.grad.flatten().tolist()])
5.4. معنای این برای trainer()
چرا گراف وجود دارد. پارامترهایی که
nn.Moduleمیسازد باrequires_grad=Trueمیآیند، پس PyTorch هر عملیاتی را که روی آنها اعمال شود ثبت میکند. چیز دیگری لازم نیست ردیابی شود: مشتق را نسبت به پارامترها میخواهیم، نه داده.backward()چه چیزی را پر میکند. پیش از فراخوانی،p.gradبرابرNoneاست؛ بعد از آن را برای دستهٔ جاری دارد. تمام خروجی پسانتشار همین است.چرا
zero_grad()هست. گرادیانها بهطور پیشفرض تجمع میکنند. اگر فراموشش کنید، دستهٔ بعدی گرادیانش را به قبلی میافزاید و نرخ یادگیری مؤثر میلغزد.step()چه میکند. برای SGD خالص، که دقیقاً گام 4 رویهٔ گرادیان کاهشی از درس رگرسیون است.پسانتشار بهینهساز نیست. فقط گرادیانها را حساب میکند؛ همان عددها را میتوان به SGD، Adam یا هر چیز دیگری داد.
6. دستهبندی با شبکههای عصبی
6.1. دستهبندی دودویی
این در واقع آسانترین بخش درس خواهد بود
تا اینجا شبکههایی برای وظیفههای رگرسیون میساختیم، ولی اگر بخواهیم دستهبندی دودویی کنیم؟
در رگرسیون لجستیک خروجی یک مدل خطی را از سیگموید میگذراندیم تا احتمال بین 0 و 1 بگیریم. شبکه هم همین کار را میکند، با یک لایهٔ پنهان پیش از سیگموید.
بیایید مجموعهدادهٔ اسباببازی بسازیم:
X, y = make_circles(n_samples=300, factor=0.5, noise=0.1, random_state=2020)
X_t = torch.tensor(X, dtype=torch.float32)
y_t = torch.tensor(y, dtype=torch.float32)
# Create dataloader
BATCH_SIZE = 50
dataset = TensorDataset(X_t, y_t)
dataloader = DataLoader(dataset, batch_size=BATCH_SIZE, shuffle=True)
plot_classification_2d(X, y)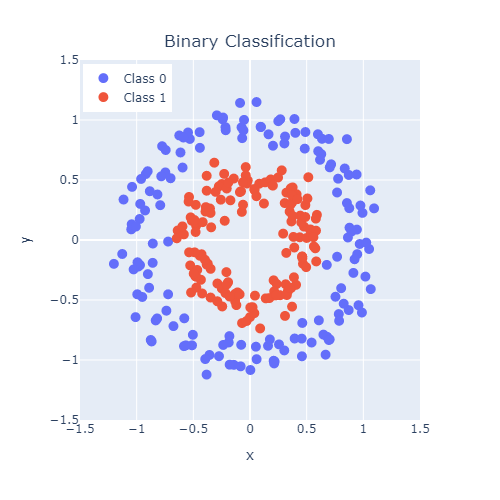
بیایید این شبکه را برای مدلسازی آن مجموعهداده بسازیم:
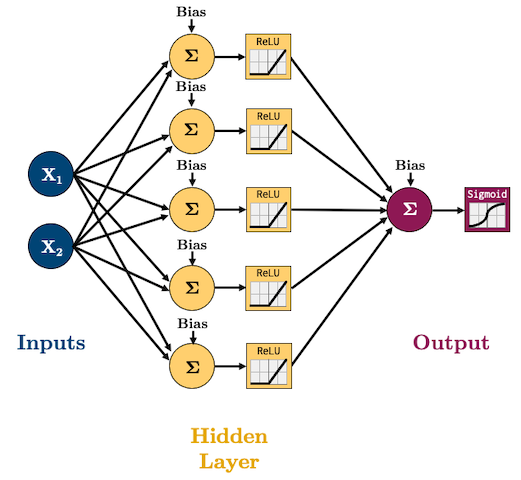
از
ReLUبهعنوان تابع(های) فعالسازی و ازAdamبهعنوان بهینهساز استفاده میکنم چون اینها امروز در عمل رایجاند.الان دستهبندی میکنیم، پس باید از هزینهٔ لگاریتمی (آنتروپی متقاطع دودویی) بهعنوان تابع هزینه استفاده کنیم:
در PyTorch معیار هزینهٔ آنتروپی متقاطع دودویی
torch.nn.BCELossاستفرمول «احتمال» میخواهد و همین دلیل افزودن تابع سیگموید به انتهای شبکه است.
class binaryClassifier(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.main = nn.Sequential(
            nn.Linear(input_size, hidden_size),
            nn.ReLU(),
            nn.Linear(hidden_size, output_size),
            nn.Sigmoid()  # <-- this will squash our output to a probability between 0 and 1
        )

    def forward(self, x):
        out = self.main(x)
        return out
ولی صبر کنید!
هرچند میتوانیم موارد بالا را انجام دهیم و بعد با تابع هزینهٔ
torch.nn.BCELossآموزش دهیم، راه بهتری هم هست!میتوانیم تابع سیگموید را حذف کنیم و فقط از
torch.nn.BCEWithLogitsLossاستفاده کنیم (که لایهٔ سیگموید و BCELoss را با هم ترکیب میکند)چرا این کار را کنیم؟ از نظر عددی پایدار است! (سؤال log-sum-exp در آزمایشگاه 1 را حل کردید؟ اینجا برای پایداری از آن استفاده میکنیم!)
از مستندات:
«این نسخه از نظر عددی پایدارتر از استفادهٔ سیگموید ساده و بعد BCELoss است، چون با ترکیب عملیات در یک لایه از ترفند log-sum-exp برای پایداری عددی بهره میبریم.»
پس در واقع مدل ما چنین است (بدون لایهٔ سیگموید در انتها، چون در تابع هزینهای که به کار میبریم گنجانده شده):
class binaryClassifier(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.main = nn.Sequential(
            nn.Linear(input_size, hidden_size),
            nn.ReLU(),
            nn.Linear(hidden_size, output_size)
        )

    def forward(self, x):
        out = self.main(x)
        return out
بیایید مدل را آموزش دهیم:
def trainer(model, criterion, optimizer, dataloader, epochs=5, verbose=True):
    """Simple training wrapper for PyTorch network."""

    for epoch in range(epochs):
        losses = 0
        for X, y in dataloader:
            optimizer.zero_grad()       # Clear gradients w.r.t. parameters
            y_hat = model(X).flatten()  # Forward pass to get output
            loss = criterion(y_hat, y)  # Calculate loss
            loss.backward()             # Getting gradients w.r.t. parameters
            optimizer.step()            # Update parameters
            losses += loss.item()       # Add loss for this batch to running total
        if verbose: print(f"epoch: {epoch + 1}, loss: {losses / len(dataloader):.4f}")
model = binaryClassifier(2, 5, 1)
LEARNING_RATE = 0.1
criterion = torch.nn.BCEWithLogitsLoss() # loss function
optimizer = torch.optim.Adam(model.parameters(), lr=LEARNING_RATE) # optimization algorithm
trainer(model, criterion, optimizer, dataloader, epochs=20, verbose=True)epoch: 1, loss: 0.6842
epoch: 2, loss: 0.6534
epoch: 3, loss: 0.6097
epoch: 4, loss: 0.5676
epoch: 5, loss: 0.5343
epoch: 6, loss: 0.4916
epoch: 7, loss: 0.4410
epoch: 8, loss: 0.3871
epoch: 9, loss: 0.3299
epoch: 10, loss: 0.2833
epoch: 11, loss: 0.2467
epoch: 12, loss: 0.2135
epoch: 13, loss: 0.1992
epoch: 14, loss: 0.1889
epoch: 15, loss: 0.1800
epoch: 16, loss: 0.1695
epoch: 17, loss: 0.1698
epoch: 18, loss: 0.1687
epoch: 19, loss: 0.1541
epoch: 20, loss: 0.1510
plot_classification_2d(X, y, model)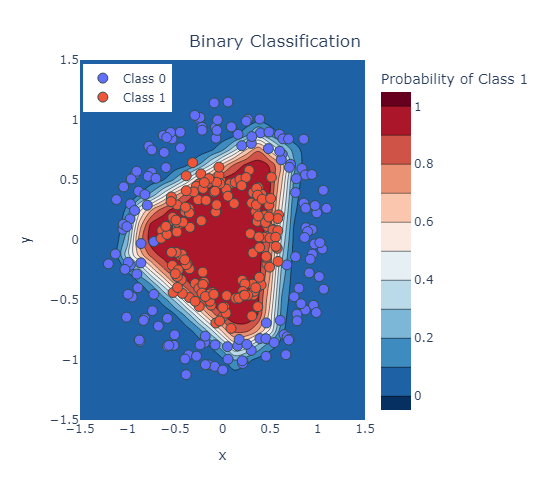
برای روشن بودن، مدل ما فقط عددی بین -∞ و +∞ خروجی میدهد (سیگموید اعمال نمیکنیم)، پس:
برای گرفتن احتمالها باید آنها را از سیگموید بگذرانیم؛
برای گرفتن دستهها میتوانیم آستانهای اعمال کنیم (معمولاً 0.5)
مثلاً انتظار داریم نقطهٔ (0,0) احتمال بالا و نقطهٔ (-1,-1) احتمال پایین داشته باشد:
prediction = model(torch.tensor([[0, 0], [-1, -1]], dtype=torch.float32)).detach()
print(prediction)
tensor([[ 4.9344],
[-11.3356]])
probability = nn.Sigmoid()(prediction)
print(probability)
tensor([[9.9286e-01],
[1.1939e-05]])
classes = np.where(probability > 0.5, 1, 0)
print(classes)
[[1]
[0]]
6.2. دستهبندی چنددستهای (اختیاری)
برای دستهبندی چنددستهای، softmax را یادتان هست؟
اساساً مطمئن میشود همهٔ خروجیها احتمالهای بین 0 و 1 باشند و جمعشان 1 شود.
torch.nn.CrossEntropyLossهزینهای است که softmax را با هزینهٔ آنتروپی متقاطع ترکیب میکند.بیایید با شبکهٔ زیر مسئلهٔ دستهبندی 4-دستهای را بیازماییم:
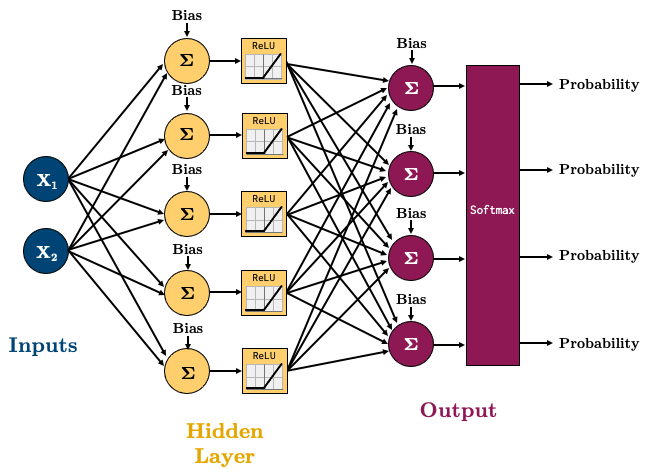
class multiClassifier(torch.nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.main = torch.nn.Sequential(
            torch.nn.Linear(input_size, hidden_size),
            torch.nn.ReLU(),
            torch.nn.Linear(hidden_size, output_size)
        )

    def forward(self, x):
        out = self.main(x)
        return out
X, y = make_blobs(n_samples=200, centers=4, center_box=(-1.2, 1.2), cluster_std=[0.15, 0.15, 0.15, 0.15], random_state=12345)
X_t = torch.tensor(X, dtype=torch.float32)
y_t = torch.tensor(y, dtype=torch.int64)
# Create dataloader
dataset = TensorDataset(X_t, y_t)
dataloader = DataLoader(dataset, batch_size=BATCH_SIZE, shuffle=True)
plot_classification_2d(X, y)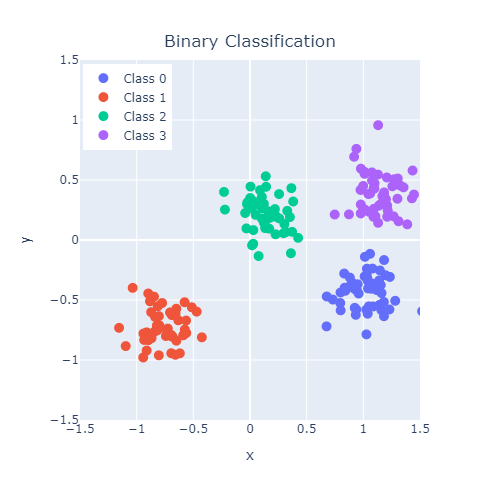
بیایید این مدل را آموزش دهیم:
model = multiClassifier(2, 5, 4)
criterion = torch.nn.CrossEntropyLoss() # loss function
optimizer = torch.optim.Adam(model.parameters(), lr=0.2)  # optimization algorithm

for epoch in range(10):
    losses = 0
    for X_batch, y_batch in dataloader:
        optimizer.zero_grad()       # Clear gradients w.r.t. parameters
        y_hat = model(X_batch)            # Forward pass to get output
        loss = criterion(y_hat, y_batch)  # Calculate loss
        loss.backward()             # Getting gradients w.r.t. parameters
        optimizer.step()            # Update parameters
        losses += loss.item()       # Add loss for this batch to running total
    print(f"epoch: {epoch + 1}, loss: {losses / len(dataloader):.4f}")
epoch: 1, loss: 1.1576
epoch: 2, loss: 0.7209
epoch: 3, loss: 0.4848
epoch: 4, loss: 0.3222
epoch: 5, loss: 0.1632
epoch: 6, loss: 0.0652
epoch: 7, loss: 0.0157
epoch: 8, loss: 0.0085
epoch: 9, loss: 0.0040
epoch: 10, loss: 0.0016
plot_classification_2d(X, y, model, transform="Softmax")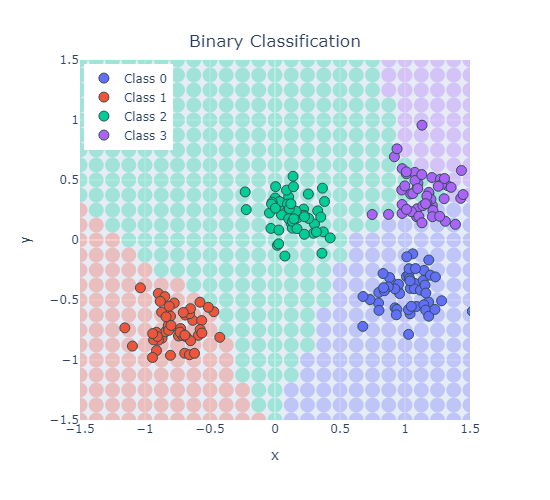
باز هم برای روشن بودن، مدل ما فقط عددی بین -∞ و +∞ خروجی میدهد، پس:
برای گرفتن احتمالها باید آنها را به Softmax بدهیم؛
برای گرفتن دستهها باید بزرگترین احتمال را برگزینیم.
مثلاً انتظار داریم نقطهٔ (-1,-1) احتمال بالایی برای تعلق به دستهٔ 1 و نقطهٔ (0,0) بالاترین احتمال برای تعلق به دستهٔ 2 داشته باشد.
prediction = model(torch.tensor([[-1, -1], [1,1]], dtype=torch.float32)).detach()
print(prediction)
tensor([[-27.5895, 19.3565, 1.1430, -33.1879],
[-12.4731, -22.3387, 2.0026, 20.8498]])
توجه کنید برای هر نقطهٔ داده 4 پیشبینی میگیریم (یک پیشبینی برای هر یک از 4 دسته)
probability = nn.Softmax(dim=1)(prediction)
print(probability)
tensor([[4.0889e-21, 1.0000e+00, 1.2302e-08, 1.5144e-23],
[3.3731e-15, 1.7517e-19, 6.5275e-09, 1.0000e+00]])
پیشبینیها اکنون باید جمعشان 1 شود:
probability.sum(dim=1)tensor([1., 1.])میتوانیم دسته با بیشترین احتمال را با
argmax()بگیریم:
classes = probability.argmax(dim=1)
print(classes)
tensor([1, 3])
7. تمرین درس: پرسشهای درست/غلط
برای موارد زیر درست/غلط بگویید:
شبکههای عصبی را میتوان هم برای رگرسیون و هم برای دستهبندی به کار برد. (درست)
در شبکههای عصبی کاملاً متصل، تعداد پارامترها تعداد ویژگیها است. (درست)
شبکههای عصبی مدلهای پارامتریاند. (درست)
هر شبکهٔ عصبی با 3 لایهٔ پنهان پارامتر بیشتری از هر شبکهٔ عصبی با 2 لایهٔ پنهان دارد. (غلط)
معماری یک شبکهٔ عصبی (تعداد لایههای پنهان و گرههای پنهان) یک ابرپارامتر است. (درست)
مانند رگرسیون خطی یا رگرسیون لجستیک، در شبکههای عصبی میتوان مقدار وزن هر ویژگی را سنجهٔ اهمیت آن ویژگی دانست. (غلط)
8. درس در سه گزاره
PyTorch نرمافزاری برای شبکههای عصبی بر پایهٔ «تنسورها» است (مثل آرایههای NumPy با قدرت بیشتر).
شبکههای عصبی بهسادگی:
از یک لایهٔ ورودی، 1 یا چند لایهٔ پنهان و یک لایهٔ خروجی ساخته میشوند که هر کدام 1 یا چند گره دارند.
تعداد گرههای لایههای ورودی/خروجی با مسئله/داده تعیین میشود. لایههای پنهان میتوانند هر تعداد گرهٔ دلخواهی داشته باشند.
توابع فعالسازی در لایههای پنهان به ما کمک میکنند دادهٔ ناخطی را مدل کنیم.
شبکههای عصبی پیشخور فقط ترکیبی از عملیات خطی و ناخطی سادهاند.
توابع فعالسازی به شبکه اجازه میدهند تابع ناخطی یاد بگیرد
تمرینها
گرادیانهای یک شبکهٔ تکلایهپنهان را نسبت به استنتاج کنید و بعد هر چهار مورد را روی یک ورودی ثابت با
autogradبسنجید.بررسی گرادیان: گرادیان تحلیلی یک وزن را با تفاضل متناهی مرکزی مقایسه کنید، خطای نسبی را برحسب از 10-12 تا 10-1 رسم کنید و شکل U منحنی را توضیح دهید.
تابع فعالسازی پنهان را با همانی جایگزین کنید، مثال رگرسیون ناخطی بخش ۳.۴ را دوباره آموزش دهید و خطای آموزش و آزمون را گزارش کنید. فروپاشی چه ویژگی شبکه را نشان میدهد؟
پشتهای از لایههای خطی یک ماتریس است: نشان دهید و تعداد پارامترهای عمیقترین و کمعمقترین نسخه را وقتی ورودی و خروجی هر دو بُعد 10 دارند بشمارید. کدام آزادی بیشتری دارد؟