دادههای با ابعاد بالا و نفرین ابعاد
محمود امینطوسی، پاییز ۱۴۰۵
گروه علوم کامپیوتر، دانشگاه فردوسی مشهد
واقعیتهای هندسی این صفحه از The Elements of Statistical Learning (Hastie et al. (2009))، بند 2.5، و فصل 6 کتاب Data Mining and Machine Learning زکی (Zaki & Meira (2020)) گرفته شدهاند.
اهداف یادگیری. در پایان باید بتوانید
حجم کره و مکعب در بعد را حساب کنید و توضیح دهید چرا نسبتشان به صفر میل میکند؛
توضیح دهید چرا همسایگیای که نسبتی ثابت از داده را در بر میگیرد در ابعاد بالا محلی نیست، و یال آن را حساب کنید؛
نشان دهید در ابعاد بالا نزدیکترین و دورترین همسایه تقریباً به یک اندازه دورند، و بگویید این برای k-NN چه معنایی دارد؛
توضیح دهید چرا بیشتر حجم کره در یک پوستهٔ نازک است، و چرا نمونههای گاوسی روی شعاع تمرکز میکنند؛
نقطهها را بهطور یکنواخت داخل کره و روی سطحش نمونهبرداری کنید (چرا شعاع سادهلوحانه غلط است)؛
اثر بُعد را روی یک دستهبند k-NN، با و بدون دادهٔ بیشتر، اندازه بگیرید.
مقدمه
در دادهکاوی و یادگیری ماشین امروزی اغلب با داده در فضاهای با ابعاد بسیار بالا سر و کار داریم (تصویر، نمایش برداری متن، دادهٔ ژنومی). یک مجموعهداده معمولاً بهصورت ماتریس یعنی نمایش داده میشود: نقطه و ویژگی.
فضای با ابعاد بالا، یا اَبَرفضا، مثل هندسهٔ دو یا سه بعد رفتار نمیکند. مجموعهٔ اثرهایی که از این واقعیت برمیآید نفرین ابعاد نامیده میشود. پنج پدیدهای که بررسی میکنیم:
تمرکز حجم: حجم ابرکره در برابر ابرمکعبی که آن را در بر دارد ناچیز میشود.
مسئلهٔ همسایگیهای محلی: همسایگی «محلی»ای که نسبتی ثابت از داده را در بر میگیرد دیگر محلی نیست، پس روشهایی مثل k-NN معنای خود را از دست میدهند (ESL بند 2.5).
تمرکز فاصله: نزدیکترین و دورترین همسایه تقریباً در یک فاصلهاند، پس رتبهبندی همسایهها بیمعنا میشود.
پوستهٔ نازک: تقریباً همهٔ حجم کره نزدیک سطح آن است.
تعامد و رفتار گاوسی: بردارهای تصادفی تقریباً متعامدند، و نمونههای گاوسی در یک پوستهٔ نازک روی شعاع متمرکز میشوند.
در سراسر این صفحه تعداد ابعاد است. شکلهایی که از ESL آمدهاند آن را مینامند؛ متن اینجا بهطور یکدست به کار میبرد.
import math

import matplotlib.pyplot as plt
import numpy as np

SEED = 42
rng = np.random.default_rng(SEED)


def ball_volume(d, r=1.0):
    """Volume of the d-dimensional ball of radius r: K_d * r^d."""
    return math.pi ** (d / 2) * r ** d / math.gamma(d / 2 + 1)


def shell_volume(d, r=1.0, thickness=0.2):
    """Volume of the shell of the given thickness just inside the surface."""
    return ball_volume(d, r) - ball_volume(d, max(r - thickness, 0.0))


dimensions = range(1, 30)
plt.figure(figsize=(9, 5))
plt.plot(list(dimensions), [ball_volume(d) for d in dimensions], marker="o", ms=4,
         label=r"volume of the unit ball, $K_d$")
plt.plot(list(dimensions), [2.0 ** d for d in dimensions], marker="s", ms=3,
         label=r"volume of the cube $[-1,1]^d$, $2^d$")
plt.yscale("log")
plt.xlabel("dimension $d$")
plt.ylabel("volume (log scale)")
plt.title("The ball grows, the cube explodes")
plt.legend(frameon=False)
plt.grid(alpha=0.3)
plt.show()

for d in [1, 2, 3, 10, 20]:
    print(f"d = {d:2d}:  ball volume = {ball_volume(d):.3e}   "
          f"ratio ball/cube = {ball_volume(d) / 2 ** d:.3e}")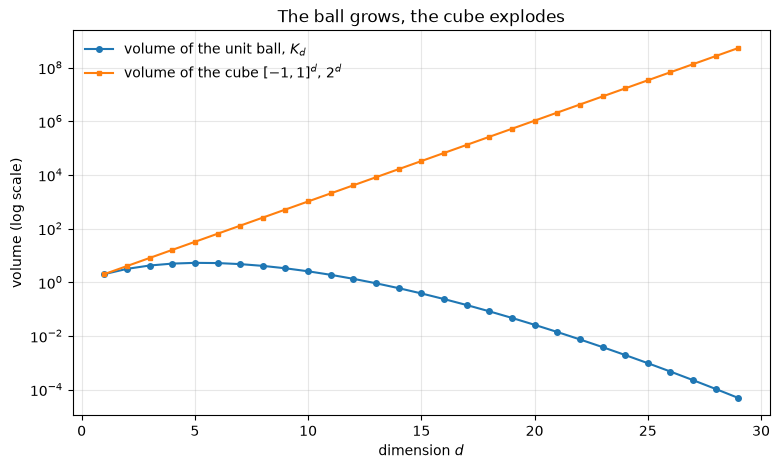
d =  1:  ball volume = 2.000e+00   ratio ball/cube = 1.000e+00
d =  2:  ball volume = 3.142e+00   ratio ball/cube = 7.854e-01
d =  3:  ball volume = 4.189e+00   ratio ball/cube = 5.236e-01
d = 10:  ball volume = 2.550e+00   ratio ball/cube = 2.490e-03
d = 20:  ball volume = 2.581e-02   ratio ball/cube = 2.461e-08
هندسهٔ اَبَرفضا: مکعبها و کرهها
ابرمکعب
فضای داده را اغلب یک ابرمکعب -بعدی میگیرند. برای ابرمکعب با یال حجم بهسادگی عبارت است از
کره و سطح کره
به دو شیء متفاوت نیاز داریم و اشتباه گرفتنشان منبع کلاسیک خطاست:
کرهٔ توپر جسم صلب است؛ حجمش
سطح کره فقط پوسته است — مجموعهای با اندازهٔ صفر — و با نوشته میشود چون شیئی -بعدی است که در زندگی میکند. مساحتش است، یعنی مشتق حجم نسبت به .
تابع گاما است؛ برای آرگومانهای صحیح .
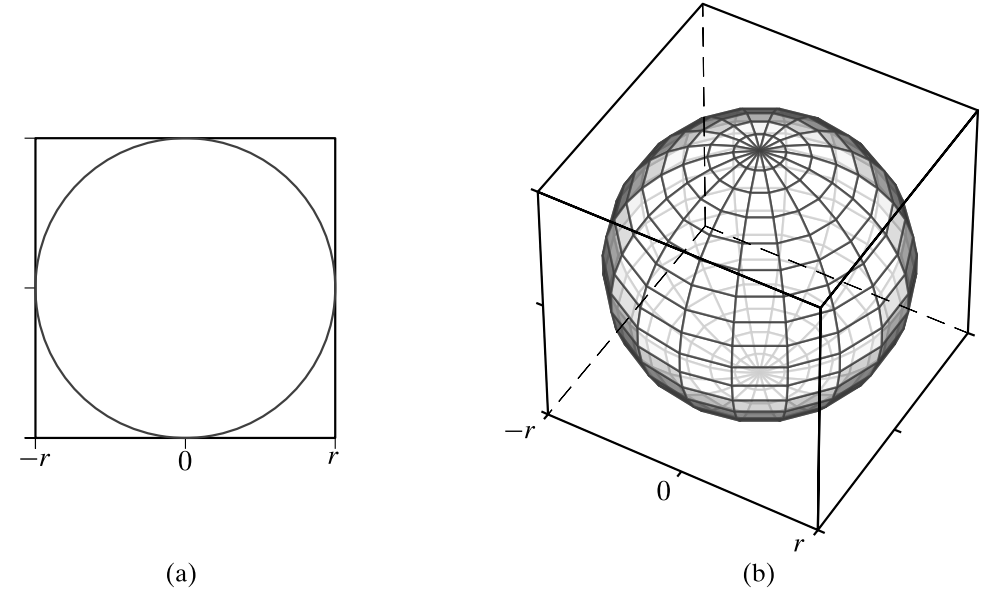
شکل 6.4. ابرکرهای محاط در ابرمکعب: (الف) دو و (ب) سه بعد (زکی، فصل 6).
مرکز تهی (اثر «خارپشت»)
بزرگترین کرهای را بگیرید که در مکعبی با یال جا میشود، یعنی . نسبت حجمشان
پیامد. با رشد بُعد، کره در برابر مکعب ناچیز میشود: تقریباً همهٔ حجم مکعب در گوشههای آن است و مرکز عملاً تهی است. در بعد گوشه داریم.
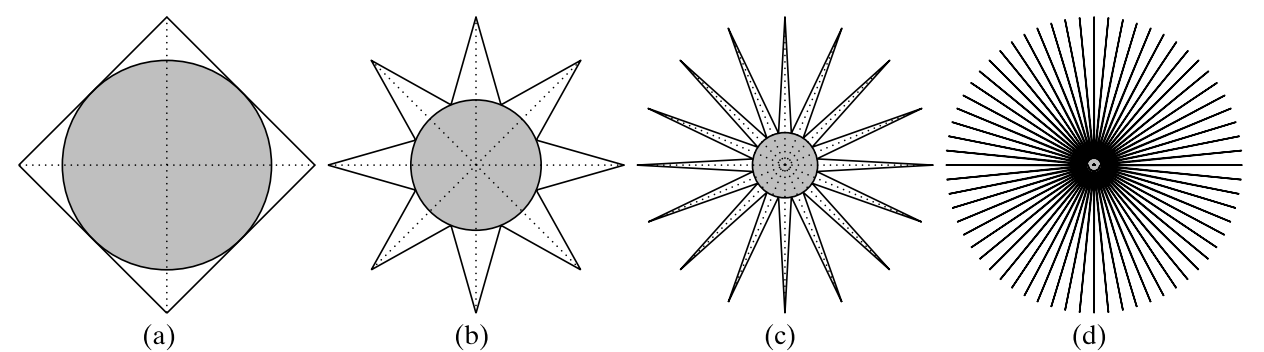
نمای مفهومی فضای با ابعاد بالا: (الف) دو، (ب) سه، (ج) چهار و (د) ابعاد بالاتر. در بعد گوشه وجود دارد؛ شعاع کرهٔ محاطی همان چیزی است که تفاوت حجم مکعب و کره را دیدنی میکند (زکی، فصل 6).
مسئلهٔ همسایگیهای محلی
یکی از پرپیامدترین جلوههای نفرین ابعاد این است که روشهای «محلی» مثل k نزدیکترین همسایه دیگر محلی نیستند.
یال یک همسایگی
فرض کنید ورودیها بهطور یکنواخت در ابرمکعب یکه پخش شدهاند و همسایگیای میخواهیم که نسبت از مشاهدات را در بر گیرد. آن همسایگی باید نسبت از حجم را بپوشاند و اگر زیرمکعبی با یال باشد،
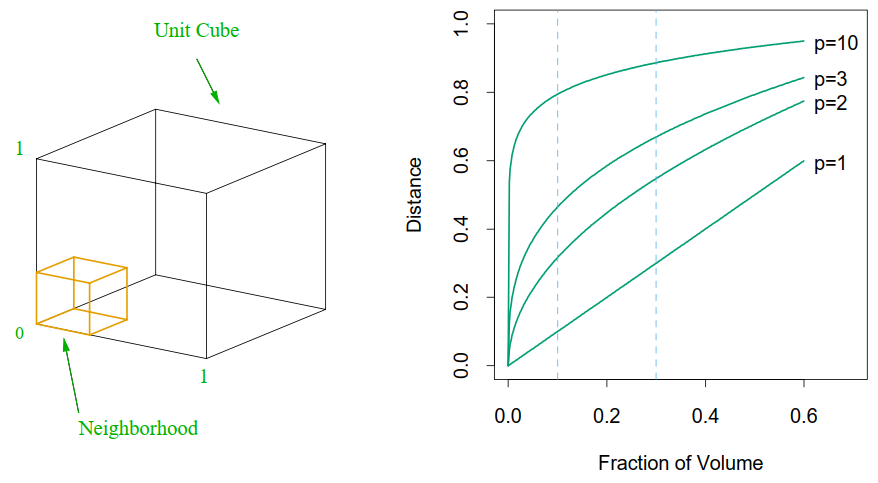
شکل 2.6 (ESL). یال زیرمکعبی که برای در برگرفتن نسبت از حجم داده لازم است، در ابعاد مختلف (شکل بُعد را مینامد؛ اینجا است). در ده بعد باید 80٪ دامنهٔ هر مؤلفه را بپوشانیم تا 10٪ داده را در بر بگیریم.
def edge_length(fraction, d):
    return fraction ** (1.0 / d)


fractions = np.linspace(0.001, 1.0, 200)
plt.figure(figsize=(7, 5))
for d in [1, 2, 3, 10]:
    plt.plot(fractions, edge_length(fractions, d), label=f"$d={d}$")

plt.plot(0.1, 0.1 ** (1 / 10), "ro")
plt.annotate(r"$d=10,\ r=0.1:\ e_d(r)\approx 0.80$", (0.1, 0.1 ** (1 / 10)),
             xytext=(0.25, 0.62), arrowprops=dict(arrowstyle="->", color="red"))
plt.xlabel(r"fraction of the data, $r$")
plt.ylabel(r"edge length of the subcube, $e_d(r)$")
plt.title("A neighborhood holding 10% of the data")
plt.legend(frameon=False)
plt.grid(alpha=0.3)
plt.show()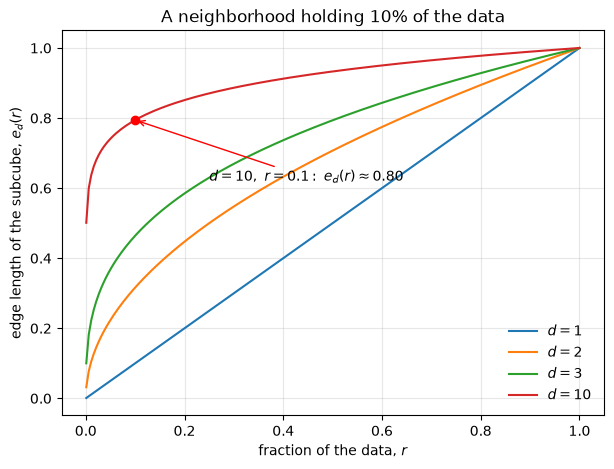
تحلیل. با و به نیاز داریم: برای گرفتن 10٪ داده باید 80٪ دامنهٔ هر مؤلفه را بپوشانیم. چنین همسایگیای به هیچ معنای سودمندی محلی نیست — تقریباً همهٔ فضا است.
فاصله تا مرز
چگالی نمونهبرداری به دلیل دومی هم کم است. برای نقطهٔ یکنواخت در کرهٔ یکه ، میانهٔ فاصلهٔ مبدأ تا نزدیکترین نقطهٔ داده
این فرمول از کجا میآید. احتمال اینکه یک نقطهٔ یکنواخت در کرهٔ شعاع بیفتد است، پس احتمال اینکه بیرون بیفتد است، و احتمال اینکه همهٔ نقطه بیرون بیفتند . میانهٔ فاصله تا نزدیکترین نقطه همان ی است که این احتمال را برابر میکند:
با و تقریباً 0.52 به دست میآید: بیش از نیمهٔ راه تا مرز. پس بیشتر نقطههای داده به مرز فضای نمونه نزدیکترند تا به هر نقطهٔ دادهٔ دیگر، و پیشبینی مسئلهٔ برونیابی است نه درونیابی.
تمرکز فاصله
پدیدهای که بیش از همه به k-NN آسیب میزند یال همسایگی نیست، خود فاصلههاست. برای یک نقطهٔ پرسوجو، را فاصله تا نزدیکترین همسایه و را فاصله تا دورترین نقطهٔ نمونه بگیرید. در یک بعد نسبت کوچک است: واقعاً نقطهٔ نزدیکی وجود دارد. در ابعاد بالا این نسبت به 1 میل میکند: نزدیکترین نقطه تقریباً به اندازهٔ دورترین است، پس «نزدیکترین» گزارهای دربارهٔ نوفه است نه دربارهٔ شباهت.
آزمایش زیر نقطه را بهطور یکنواخت در مکعب یکه برای میریزد، یک نقطهٔ پرسوجوی تصادفی برمیدارد و میانگین نسبت را روی پرسوجوهای زیاد گزارش میکند.
n_points, n_queries = 1000, 50
dims_dc = [2, 10, 100, 1000]
ratios = []

for d in dims_dc:
    data = rng.random((n_points, d))
    queries = rng.random((n_queries, d))
    dist = np.linalg.norm(queries[:, None, :] - data[None, :, :], axis=2)
    ratios.append(np.mean(dist.min(axis=1) / dist.max(axis=1)))

plt.figure(figsize=(7, 4))
plt.plot(dims_dc, ratios, marker="o")
for x, y in zip(dims_dc, ratios):
    plt.annotate(f"{y:.2f}", (x, y), textcoords="offset points", xytext=(0, 8), ha="center")
plt.xscale("log")
plt.xlabel("dimension $d$")
plt.ylabel(r"mean $d_{\min}/d_{\max}$")
plt.title(f"{n_points} uniform points, {n_queries} queries")
plt.ylim(0, 1.05)
plt.grid(alpha=0.3, which="both")
plt.show()

for d, ratio in zip(dims_dc, ratios):
    print(f"d = {d:4d}:  mean d_min/d_max = {ratio:.3f}")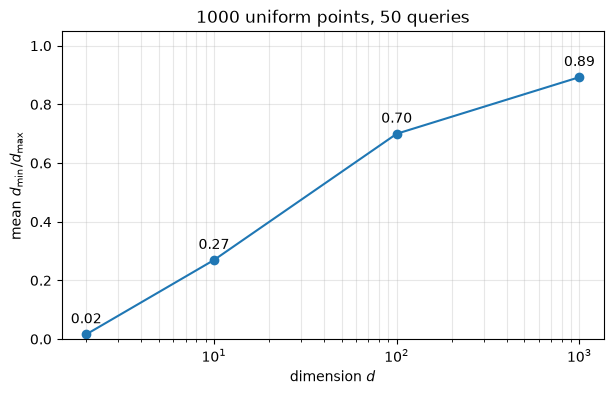
d =    2:  mean d_min/d_max = 0.016
d =   10:  mean d_min/d_max = 0.269
d =  100:  mean d_min/d_max = 0.700
d = 1000:  mean d_min/d_max = 0.893
عددها را بخوانید: در دو بعد نزدیکترین همسایه معمولاً کسر کوچکی از دورترین فاصله است، پس رتبهبندی همسایهها آگاهیبخش است. در هزار بعد نسبت نزدیک 1 است — هر نقطه تقریباً از هر نقطهٔ دیگر همفاصله است. دو پیامد:
رتبهبندی همسایهها زیر سلطهٔ نوفه است: اینکه کدام نقطه «نزدیکترین» است با اغتشاشهای کوچک داده عوض میشود، پس رأی k-NN ناپایدار است.
کرهای حول پرسوجو که همسایه را در بر میگیرد چنان بزرگ است که بخش خوبی از داده را شامل میشود، پس میانگین «محلی» محلی نیست.
این همان دلیل نظری پشت آزمایش پایان این صفحه است.
استدلال پوستهٔ نازک
حجم داخل کره کجاست؟ پوستهٔ نازکی با ضخامت درست زیر سطح کرهٔ شعاع را در نظر بگیرید. حجمش
پس نسبت حجمی که در پوسته است
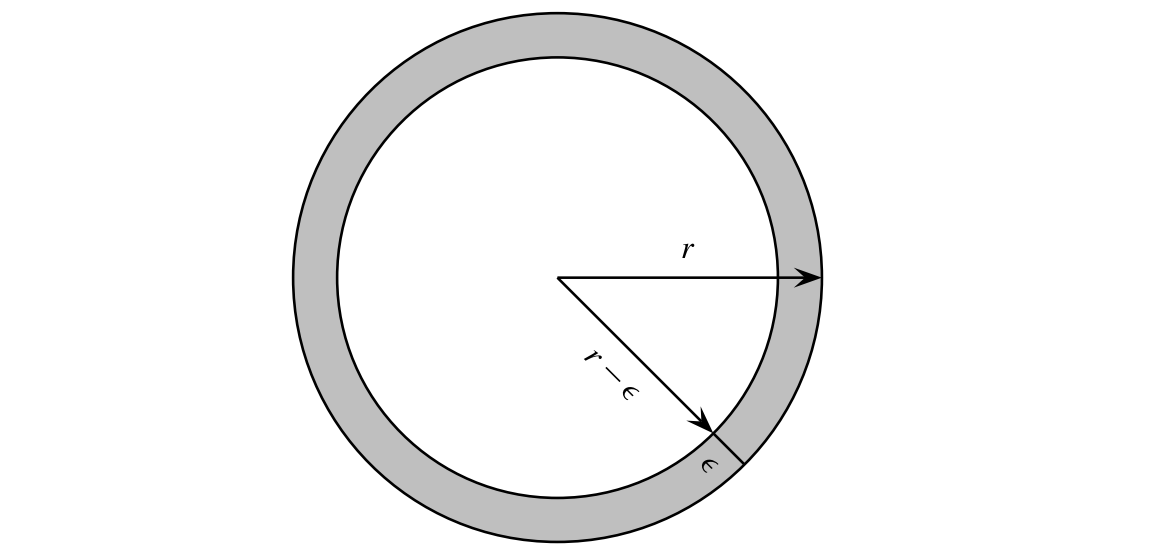
شکل 6.6 (زکی، فصل 6): پوستهٔ کره حجم را با رشد در خود جمع میکند.
برای قرصی () با و پوسته از مساحت را دارد. برای همان پوسته — نزدیک دو سوم.
نتیجه. در ابعاد بالا، برای پوستهای با ضخامت نسبی ثابت ، تقریباً 100٪ حجم — و جرم احتمال توزیع یکنواخت — نزدیک سطح متمرکز است. درون آن عملاً تهی است.
dims_shell = list(range(1, 30))
fraction = [shell_volume(d, 1.0, 0.2) / ball_volume(d, 1.0) for d in dims_shell]

plt.figure(figsize=(9, 5))
plt.plot(dims_shell, fraction, marker="o", ms=4)
plt.axhline(1.0, color="black", lw=1, ls="--")
plt.xlabel("dimension $d$")
plt.ylabel(r"volume of the shell / volume of the ball")
plt.title(r"Fraction of the volume in a shell of thickness $\epsilon = 0.2\,r$")
plt.grid(alpha=0.3)
plt.show()

for d in [2, 10, 30]:
    print(f"d = {d:2d}:  shell fraction = {shell_volume(d, 1.0, 0.2) / ball_volume(d, 1.0):.3f}")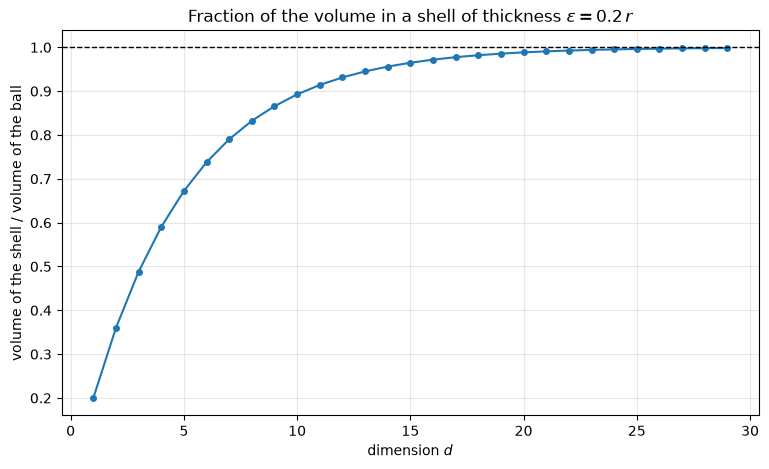
d =  2:  shell fraction = 0.360
d = 10:  shell fraction = 0.893
d = 30:  shell fraction = 0.999
گریز: نمونهبرداری یکنواخت در کره
تولید نقطهٔ یکنواخت داخل کره در ابعاد بالا تصویر خوبی از واقعیتهای حجمی بالا میدهد و در بسیاری از آزمایشهای شبیهسازی لازم است.
نمونهبرداری ردکردنی — تولید نقطهٔ یکنواخت در مکعب و نگه داشتن آنهایی که داخل کرهاند — نرخ پذیرش برابر نسبت دو حجم دارد که به صفر میرود (اثر خارپشت). از حدود ده بعد به بعد عملاً بیفایده است. جدول زیر نرخ پذیرش را برای با 2000 نقطهٔ پذیرفتهشده اندازه میگیرد و با مقدار نظری مقایسه میکند.
def rejection_rate(num_points, d, batch_size=1000, max_batches=20000):
    """Acceptance rate of rejection sampling: how much of the cube is in the ball?"""
    accepted, generated = 0, 0
    for _ in range(max_batches):
        batch = rng.uniform(-1, 1, (batch_size, d))
        accepted += int(np.sum(np.sum(batch ** 2, axis=1) <= 1.0))
        generated += batch_size
        if accepted >= num_points:
            break
    return accepted / generated


n_points = 2000
dims_rej = list(range(2, 11))
measured, theoretical = [], []

for d in dims_rej:
    measured.append(rejection_rate(n_points, d))
    theoretical.append(ball_volume(d) / 2 ** d)

plt.figure(figsize=(8, 5))
plt.plot(dims_rej, measured, marker="o", label="measured")
plt.plot(dims_rej, theoretical, marker="s", ls="--", label=r"theory: $K_d/2^d$")
plt.yscale("log")
plt.xlabel("dimension $d$")
plt.ylabel("acceptance rate (log scale)")
plt.title(f"rejection sampling from the cube, {n_points} accepted points")
plt.legend(frameon=False)
plt.grid(alpha=0.3, which="both")
plt.show()

for d, m, t in zip(dims_rej, measured, theoretical):
    print(f"d = {d:2d}:  measured = {m:.4f}   theory = {t:.4f}   "
          f"candidates per accepted point = {1 / m:8.1f}")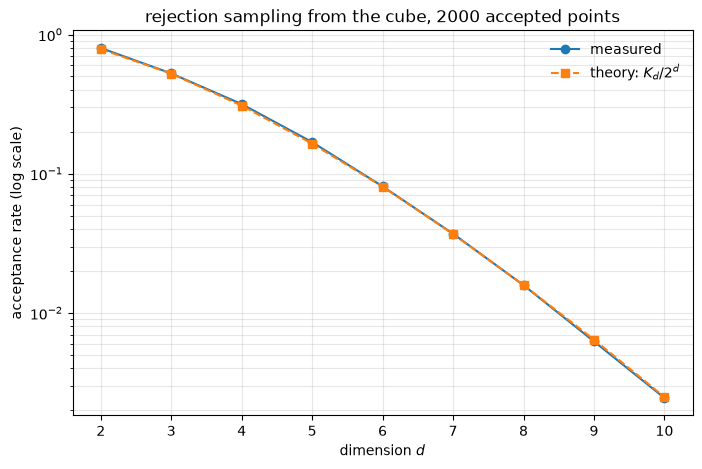
d =  2:  measured = 0.8003   theory = 0.7854   candidates per accepted point =      1.2
d =  3:  measured = 0.5255   theory = 0.5236   candidates per accepted point =      1.9
d =  4:  measured = 0.3163   theory = 0.3084   candidates per accepted point =      3.2
d =  5:  measured = 0.1687   theory = 0.1645   candidates per accepted point =      5.9
d =  6:  measured = 0.0811   theory = 0.0807   candidates per accepted point =     12.3
d =  7:  measured = 0.0371   theory = 0.0369   candidates per accepted point =     27.0
d =  8:  measured = 0.0158   theory = 0.0159   candidates per accepted point =     63.2
d =  9:  measured = 0.0062   theory = 0.0064   candidates per accepted point =    160.0
d = 10:  measured = 0.0025   theory = 0.0025   candidates per accepted point =    408.0
نرخ اندازهگیریشده بهطور هندسی افت میکند و را دنبال میکند: تا فقط حدود یک نقطهٔ نامزد از هر چهارصد نامزد داخل کره میافتد و هزینهٔ هر نقطهٔ پذیرفتهشده با هر بُعد اضافه دو برابر میشود.
نقطهها روی سطح: جهتهای گاوسی
شگردی که نمونهبرداری یکنواخت را ساده میکند استفاده از تقارن کروی توزیع گاوسی است. اگر مستقل باشند، چگالی مشترک
که فقط به طول بستگی دارد و هرگز به جهت. پس توزیع نسبت به دوران ناوردا است (همسانگرد)، همهٔ جهتها به یک اندازه محتملاند، و
بهطور یکنواخت روی سطح کرهٔ یکه پخش است.
n_dir = 500
d_vis = 2

x = rng.standard_normal((n_dir, d_vis))
y_surface = x / np.linalg.norm(x, axis=1, keepdims=True)

plt.figure(figsize=(5, 5))
plt.scatter(x[:, 0], x[:, 1], s=5, alpha=0.6, label="Gaussian sample")
plt.scatter(y_surface[:, 0], y_surface[:, 1], s=5, label="normalised")
plt.gca().set_aspect("equal")
plt.title("Normalising a Gaussian sample gives the circle")
plt.legend(frameon=False, loc="upper right")
plt.show()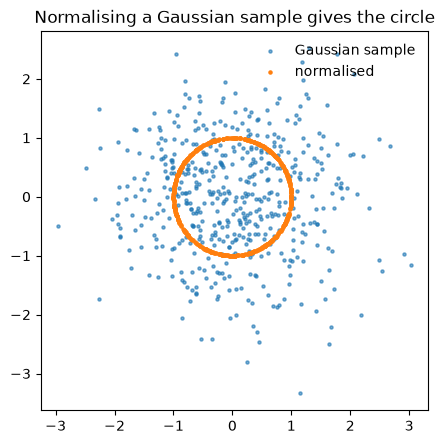
نقطهها داخل کره
مقیاس دادن یک جهت با یک عدد تصادفی یکنواخت غلط است: حجم پوستهٔ شعاع مثل رشد میکند، پس بیشتر حجم نزدیک سطح است و شعاع یکنواخت نقطهها را نزدیک مرکز جمع میکند.
شعاع درست. برای توزیع یکنواخت داخل کره، احتمال اینکه نقطه در شعاع باشد باید متناسب با حجمی باشد که در بر میگیرد:
نمونهبرداری وارون تبدیل با آنگاه میدهد. برای ، :
| 0.00 | 0.10 | 0.25 | 0.50 | 0.75 | 1.00 | |
|---|---|---|---|---|---|---|
| 0.000 | 0.316 | 0.500 | 0.707 | 0.866 | 1.000 |
الگوریتم نقطههای یکنواخت در کرهٔ :
بکش؛
نرمال کن، — یک جهت یکنواخت؛
بکش؛
را برگردان.
d_ball = 2
plt.figure(figsize=(11, 5))

for panel, exponent in enumerate([1.0, 1.0 / d_ball]):
    a = rng.random(n_dir)
    rho = a ** exponent
    points = rho[:, None] * y_surface

    plt.subplot(1, 2, panel + 1)
    theta = np.linspace(0, 2 * np.pi, 400)
    plt.plot(np.cos(theta), np.sin(theta), color="black", lw=1)
    plt.scatter(points[:, 0], points[:, 1], s=6)
    plt.gca().set_aspect("equal")
    plt.title(r"$\rho \sim U(0,1)$: bunched at the center" if panel == 0
              else r"$\rho = a^{1/d}$: uniform")
    plt.xlim(-1.1, 1.1)
    plt.ylim(-1.1, 1.1)

plt.tight_layout()
plt.show()

# a quantitative check: the fraction of points inside half the radius must be (1/2)^d
for d in [2, 3, 10]:
    a = rng.random(20000)
    for name, rho in [("naive", a), ("correct", a ** (1 / d))]:
        print(f"d = {d:2d}, {name:7s}: fraction with rho < 0.5 = "
              f"{np.mean(rho < 0.5):.4f}   (expected {(0.5) ** d:.4f})")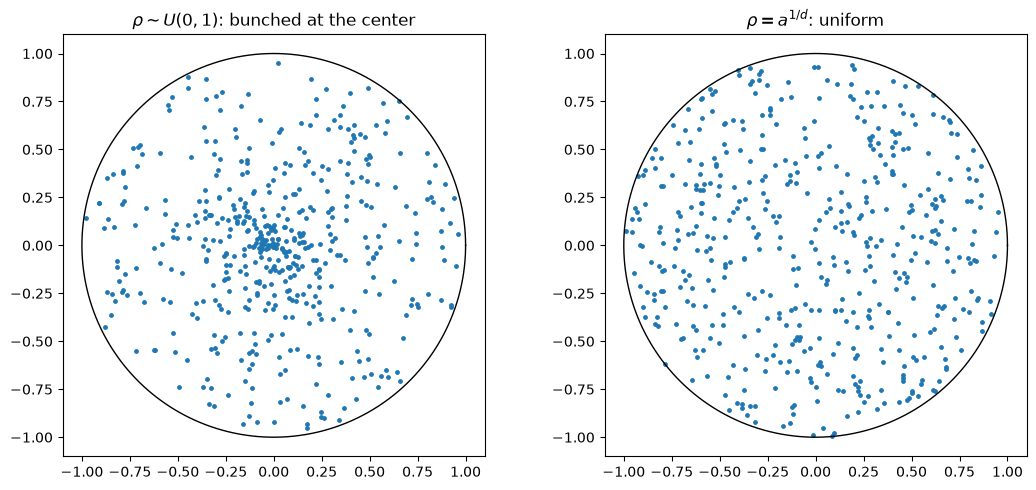
d =  2, naive  : fraction with rho < 0.5 = 0.4967   (expected 0.2500)
d =  2, correct: fraction with rho < 0.5 = 0.2479   (expected 0.2500)
d =  3, naive  : fraction with rho < 0.5 = 0.4966   (expected 0.1250)
d =  3, correct: fraction with rho < 0.5 = 0.1240   (expected 0.1250)
d = 10, naive  : fraction with rho < 0.5 = 0.5015   (expected 0.0010)
d = 10, correct: fraction with rho < 0.5 = 0.0009   (expected 0.0010)
جهتهای تقریباً متعامد
خاصیت ضدشهودی دیگری این است که در ابعاد بالا «هر جهت بر هر جهت دیگر عمود است»، یا دقیقتر: بردارهای تصادفی تقریباً متعامدند.
قطر ابرمکعب
قطر اصلی مکعب را در نظر بگیرید، . زاویهٔ میان آن و یک محور مختصات در رابطهٔ
است، پس : قطر تقریباً بر هر محور عمود است.
بردارهای تصادفی
همین برای دو بردار تصادفی مستقل هم برقرار است و دلیلش قانون اعداد بزرگ است: برای و با مؤلفههای مستقل، میانگین صفر و واریانس یک،
که صورتش مجموع جملهٔ مستقل با میانگین صفر و واریانس 1 و بنابراین به اندازهٔ است — نسبت میشود.
dim = 200
vectors = rng.standard_normal((5, dim))
vectors /= np.linalg.norm(vectors, axis=1, keepdims=True)

cosines = [vectors[i] @ vectors[j]
           for i in range(len(vectors)) for j in range(i + 1, len(vectors))]
print(f"cosine similarities of {len(cosines)} random pairs in {dim}-D:")
print(np.round(cosines, 4))
print(f"max |cosine| = {np.max(np.abs(cosines)):.4f}   (1/sqrt(d) = {1 / np.sqrt(dim):.4f})")
cosine similarities of 10 random pairs in 200-D:
[-0.0401 0.0349 -0.0056 -0.0042 -0.075 -0.0497 -0.0402 0.0836 0.0071
0.1518]
max |cosine| = 0.1518 (1/sqrt(d) = 0.0707)
توزیع گاوسی در ابعاد بالا
از پوستههای هندسی به پوستههای آماری
اثرهای هندسی بالا دربارهٔ حجم کره بودند. توزیع گاوسی همان پدیده را آماری نشان میدهد: با اینکه چگالیاش در مبدأ بیشینه است، تقریباً هیچ نمونهای نزدیک مبدأ نمیافتد.
چرا نقطههای گاوسی نزدیک میانگین جمع نمیشوند
بگذارید . در یک بعد بسیاری از نمونهها «نزدیک صفر»اند و معمولاً کوچک است. این شهود از دو بعد به بعد میشکند: چگالی در مبدأ بیشینه است، ولی حجم موجود نزدیک مبدأ ناچیز است.
در یک بعد «مرکز» یک نقطه است و رشد حجمی وجود ندارد.
در بعد حجم پوسته مثل رشد میکند، پس تعداد نقطههای روی شعاع چگالی × حجم است.
مرکز بیشترین چگالی را دارد ولی تقریباً هیچ حجمی، پس تقریباً هیچ نمونهای آنجا نمیافتد.
فاصلهٔ یک بردار گاوسی از مبدأ
یک اتحاد سراسر این رفتار را توضیح میدهد:
پس برای ، برای ، برای و برای (نگاه کنید به توزیع کایدو). افزودن بُعد همهٔ نمونهها را به بیرون میراند، نه فقط دادههای پرت را: کل توزیع در پوستهٔ نازکی حول شعاع مینشیند.
d_gauss = 200
n_gauss = 5000

x_1d = rng.standard_normal(n_gauss)
norms = np.linalg.norm(rng.standard_normal((n_gauss, d_gauss)), axis=1)

fig, ax = plt.subplots(1, 2, figsize=(11, 4))
ax[0].hist(x_1d, bins=60, color="tab:blue", alpha=0.8)
ax[0].axvline(0, color="red", ls="--", label="mean 0")
ax[0].set_title("1-D Gaussian: mass at the mean")
ax[0].set_xlabel("value")
ax[0].legend(frameon=False)

ax[1].hist(norms, bins=60, color="tab:green", alpha=0.8)
ax[1].axvline(np.sqrt(d_gauss), color="red", ls="--",
              label=rf"$\sqrt{{d}} = {np.sqrt(d_gauss):.1f}$")
ax[1].axvline(0, color="black", lw=1, label="mean 0")
ax[1].set_title(rf"{d_gauss}-D Gaussian: mass at $\sqrt{{d}}$")
ax[1].set_xlabel(r"distance from the origin, $\|\mathbf{x}\|$")
ax[1].legend(frameon=False)
plt.tight_layout()
plt.show()

print(f"mean norm = {norms.mean():.2f}   std = {norms.std():.2f}   sqrt(d) = {np.sqrt(d_gauss):.2f}")
print(f"fraction of samples with norm within 10% of sqrt(d): "
      f"{np.mean(np.abs(norms - np.sqrt(d_gauss)) < 0.1 * np.sqrt(d_gauss)):.2f}")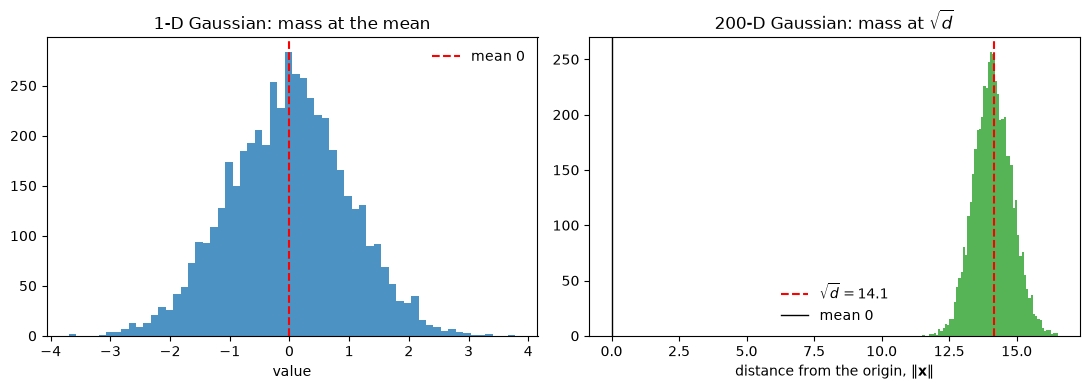
mean norm = 14.12   std = 0.70   sqrt(d) = 14.14
fraction of samples with norm within 10% of sqrt(d): 0.96
این دو بافتنگار نسخهٔ آماری اثر هندسی پوستهٔ نازکاند: دادهٔ گاوسی یکبعدی روی میانگین مینشیند، دادهٔ گاوسی دویستبعدی روی کرهای به شعاع 14.1 با پهنایی که با رشد نمیکند.
پدیدهٔ حلقهٔ گاوسی
گزارهٔ صوری چنین است:
با احتمال غالب یک نمونهٔ گاوسی در بازهٔ از مبدأ است — حلقهای نازک که ضخامتش با رشد نمیکند.
با افزایش شعاع مثل رشد میکند در حالی که ضخامت ثابت میماند، پس ضخامت نسبی به صفر میل میکند. همین دلیل استفادهٔ نظری از بردارهای گاوسی است: آنها همان هندسهٔ فضای با ابعاد بالا هستند، همانگونه که نقطههای یکنواخت در کره.
پیوند با بخشهای پیشین
| نتیجهٔ پیشین | نسخهٔ گاوسی |
|---|---|
| مرکز کره تهی است | جرم گاوسی از مبدأ میپرهیزد |
| حجم یکنواخت روی سطح متمرکز است | جرم گاوسی روی متمرکز است |
| نمونهبرداری یکنواخت به نیاز دارد | نمونهبرداری گاوسی این کار را خودکار میکند |
| بردارهای تصادفی تقریباً متعامدند | بردارهای گاوسی نرمالشده تقریباً متعامدند |
چرا مهم است
چون تقریباً همهٔ بردارهای گاوسی طول دارند، دو بردار گاوسی مستقل و در صدق میکنند، با پراکندگی نسبیای که با رشد کوچک میشود: فاصلههای دوبهدو پایدارند و ضرب داخلی بردارهای نرمالشده کوچک است. همین دو واقعیت تصویرهای تصادفی را کارا میکند و همان خواصی است که در بحث تصویرهای تصادفی و لم جانسون–لیندنشتراوس در ادامهٔ درس به آن برمیگردیم.
k-NN زیر نفرین ابعاد
استدلال تمرکز فاصله پیشبینی میکند که k-NN با رشد بُعد بدتر میشود — و اینکه این بدترشدن با
دادهٔ بیشتر جبرانشدنی است. آزمایش زیر هر دو پیشبینی را روی دادهٔ مصنوعی با make_classification
میآزماید:
سطر 1: ثابت () در حالی که از 2 به 200 رشد میکند. فقط دو ویژگی آگاهیبخشاند (
n_informative=2) و ویژگی بقیه نوفه است. با ثابت، بُعد بیشتر یعنی نوفهٔ بیشتر و نقطهٔ کمتر به ازای هر بُعد.سطر 2: با رشد میکند ()، پس تعداد نقطه به ازای هر بُعد ثابت میماند. اگر نفرین دربارهٔ چگالی باشد و نه خود بُعد، این باید دقت را برگرداند.
هر پیکربندی روی پنج بذر تکرار میشود و نمودارها میانگین دقت را با نواری از انحراف معیار نشان میدهند. دستهبند 5-NN روی ویژگیهای استانداردشده است.
from sklearn.datasets import make_classification
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

dims_knn = [2, 5, 10, 25, 50, 100, 200]
seeds = range(5)


def knn_accuracy(d, n_samples, seed):
    X_, y_ = make_classification(n_samples=n_samples, n_features=d, n_informative=2,
                                 n_redundant=0, n_classes=2, n_clusters_per_class=1,
                                 class_sep=1.0, flip_y=0.01, random_state=seed)
    X_tr, X_te, y_tr, y_te = train_test_split(X_, y_, test_size=0.3, random_state=seed,
                                              stratify=y_)
    model = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=5))
    return accuracy_score(y_te, model.fit(X_tr, y_tr).predict(X_te))


curves = {}
for label, size in [("fixed n = 600", lambda d: 600),
                    ("n = 100 d", lambda d: 100 * d)]:
    scores = np.array([[knn_accuracy(d, size(d), s) for d in dims_knn] for s in seeds])
    curves[label] = (scores.mean(axis=0), scores.std(axis=0))
    for d, mean, std in zip(dims_knn, *curves[label]):
        print(f"{label:13s} d = {d:3d}  n = {size(d):6d}   accuracy = {mean:.3f} +- {std:.3f}")

plt.figure(figsize=(8, 5))
for (label, (mean, std)), color in zip(curves.items(), ["tab:red", "tab:blue"]):
    plt.plot(dims_knn, mean, marker="o", color=color, label=label)
    plt.fill_between(dims_knn, mean - std, mean + std, color=color, alpha=0.2)
plt.xlabel("number of features $d$")
plt.ylabel("test accuracy of 5-NN")
plt.title("Two informative features, the rest noise")
plt.ylim(0.4, 1.0)
plt.legend(frameon=False)
plt.grid(alpha=0.3)
plt.show()
fixed n = 600 d = 2 n = 600 accuracy = 0.934 +- 0.039
fixed n = 600 d = 5 n = 600 accuracy = 0.903 +- 0.040
fixed n = 600 d = 10 n = 600 accuracy = 0.850 +- 0.039
fixed n = 600 d = 25 n = 600 accuracy = 0.773 +- 0.034
fixed n = 600 d = 50 n = 600 accuracy = 0.667 +- 0.052
fixed n = 600 d = 100 n = 600 accuracy = 0.608 +- 0.041
fixed n = 600 d = 200 n = 600 accuracy = 0.594 +- 0.022
n = 100 d     d =   2  n =    200   accuracy = 0.963 +- 0.036
n = 100 d     d =   5  n =    500   accuracy = 0.929 +- 0.057
n = 100 d     d =  10  n =   1000   accuracy = 0.878 +- 0.048
n = 100 d     d =  25  n =   2500   accuracy = 0.824 +- 0.075
n = 100 d     d =  50  n =   5000   accuracy = 0.737 +- 0.047
n = 100 d     d = 100  n =  10000   accuracy = 0.671 +- 0.016
n = 100 d     d = 200  n =  20000   accuracy = 0.627 +- 0.029
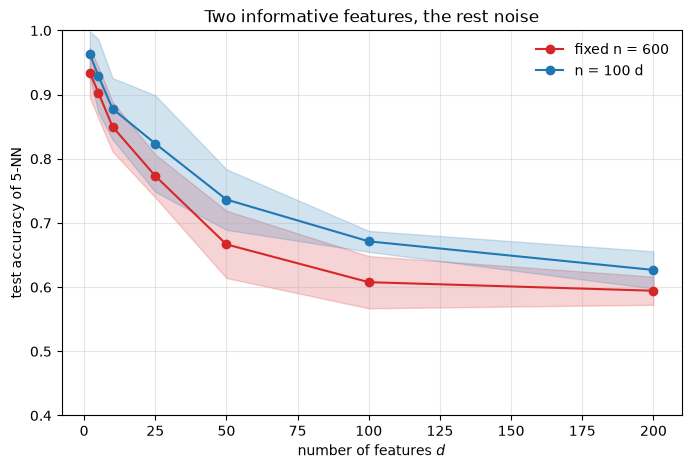
منحنی اول با رشد بُعد افت میکند هرچند ساختار آگاهیبخش هرگز عوض نمیشود: دو ویژگی سودمند هنوز هستند ولی زیر ویژگی نوفه دفن شدهاند، و فاصلههایی که k-NN به آنها اعتماد میکند زیر سلطهٔ نوفهاند.
منحنی دوم میآزماید که آیا دادهٔ بیشتر درمان است. کمک میکند — هر مقدار کمی بهتر از نقطهٔ متناظر منحنی اول است — ولی افت را متوقف نمیکند: دقت هنوز از حدود 0.96 در به حدود 0.63 در میافتد، با 33 برابر دادهٔ بیشتر. دادهٔ بیشتر چگالی میخرد و چگالی اینجا قید مقیدکننده نبود: قید مقیدکننده این است که تقریباً همهٔ مختصات نوفهاند، پس تمرکز فاصلهٔ بخشهای پیشین خاصیتی از توزیع است، نه فقط از اندازهٔ نمونه.
پیامد عملی همان است که ESL در بند 2.5 میگیرد: برای دادهٔ با ابعاد بالا، k-NN باید پس از چیزی بیاید که جهتهای بیاطلاع را حذف یا کموزن کند — انتخاب ویژگی، PCA، یا یک متریک یادگرفته. افزودن نقطه سودمند است ولی جانشین آن نیست.
جمعبندی
فضای با ابعاد بالا در مرکز تهی است: حجم کره در برابر مکعب ناچیز است و تقریباً همهٔ حجم مکعب در گوشهٔ آن است.
همسایگیای که نسبت ثابت از نقطهها را در بر میگیرد یال دارد: در ده بعد، 10٪ داده به 80٪ دامنهٔ هر مؤلفه نیاز دارد.
فاصلهها متمرکز میشوند: ، پس رتبهبندی همسایهها نوفه میشود و k-NN بدتر — مگر اینکه با رشد کند.
بیشتر حجم کره در پوستهٔ نازکی با ضخامت نسبی ثابت است، و نمونههای گاوسی روی شعاع با ضخامتی که با رشد نمیکند متمرکز میشوند.
نمونهبرداری یکنواخت در کره به شعاع نیاز دارد؛ راه ساده یک جهت گاوسی ضرب در آن شعاع است. نمونهبرداری ردکردنی بهطور نمایی میمیرد.
بردارهای تصادفی تقریباً متعامدند و فاصلههای دوبهدو پایدارند — همان خواصی که پشت تصویرهای تصادفی است.
منابع
Hastie et al. (2009)، بند 2.5 (روشهای محلی در ابعاد بالا، شکل 2.6) و بند 2.9 (برآورد مدل).
Zaki & Meira (2020)، فصل 6 (فضای با ابعاد بالا، شکلهای 6.4 تا 6.6).
Blum، Hopcroft و Kannan، Foundations of Data Science، فصل 2 (تمرکز اندازه، تصویرهای تصادفی).
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer.
- Zaki, M. J., & Meira, W. (2020). Data Mining and Machine Learning: Fundamental Concepts and Algorithms (2nd ed.). Cambridge University Press. https://www.cambridge.org/9781108497367