قطعهبندی تصویر با k-means
«قطعهبندی» یعنی چه
تصویر جدولی از اعداد است. تصویر خاکستری آرایهای H x W است با یک مقدار روشنایی برای هر پیکسل؛ تصویر رنگی سه عدد برای هر پیکسل دارد. قطعهبندی یک تصویر، دادن برچسب به هر پیکسل است که بگوید آن پیکسل به کدام ناحیه یا کدام شیء تعلق دارد. پس قطعهبندی خود تصویر را عوض نمیکند، بلکه نحوهٔ توصیف آن را عوض میکند: بهجای ۲۴۰٬۰۰۰ سطح خاکستری، به چند ناحیه میرسیم.
این صفحه دو راه یافتن این برچسبها را مقایسه میکند:
آستانهگذاری — یک مقدار برش که با دست انتخاب میشود: پیکسلهای بالاتر از آن یک ناحیهاند و بقیه ناحیهای دیگر.
خوشهبندی — برش از داده یاد گرفته میشود با k-means، و به بیش از دو ناحیه هم تعمیم مییابد بدون اینکه کسی آستانهای بنویسد.
گام سوم جزء گمشدهٔ دو راه اول را میافزاید: موقعیت پیکسل. روشی که فقط روشنایی را میبیند نمیتواند دو ناحیهٔ همروشنایی را از هم جدا کند، هرقدر هم در تصویر از هم دور باشند.
در پایان باید بتوانید
تصویر را به جدول
(n_pixels, n_features)تبدیل کنید که scikit-learn انتظار دارد، و توضیح دهید چرا دادن تصویر خام بهfitشکل نادرستی است؛labels_وcluster_centers_را بخوانید و بگویید کدامیک تصویر را میکشد و چرا؛مختصات را بهعنوان ویژگی اضافه کنید و پیشبینی کنید چه عوض میشود؛
توضیح دهید چرا شمارهٔ خوشهها باید پیش از مقایسهٔ دو قطعهبندی بازچینی شود.
ابزارها
چهار کتابخانه کافی است: NumPy برای آرایهها، matplotlib برای دیدنشان، KMeans از scikit-learn، و skimage برای عکس نمونهای که در نیمهٔ دوم به کار میرود.
Source
# Importing Necessary Libraries
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from skimage import data
from skimage.color import rgb2gray
from skimage.transform import resize

%matplotlib inline
۱. یک تصویر اسباببازی
عکسهای واقعی بزرگاند و هیستوگرامشان نرم است، و همین پنهان میکند که الگوریتم واقعاً چه میکند. پس مثال اول آرایهای 5 x 6 از عددهای کوچک است، چنان انتخابشده که هر عدد را با چشم بخوانید. هر درایه را یک سطح خاکستری بگیرید: 0 سیاه و 9 سفید.
دانهٔ تصادفی ثابت (default_rng(0)) به کار میرود تا عددها — و در نتیجه هر شکل این بخش — در هر بار ساخت صفحه یکسان بمانند.
Source
# A 5 x 6 image with integer gray levels from 0 (black) to 9 (white)
rng = np.random.default_rng(0)
img = rng.integers(10, size=(5, 6))
img
array([[8, 6, 5, 2, 3, 0],
[0, 0, 1, 8, 6, 9],
[5, 6, 9, 7, 6, 5],
[5, 9, 2, 8, 6, 0],
[3, 8, 5, 0, 7, 7]])imshow آرایه را بهصورت تصویر میکشد، ولی مقیاس رنگها را باید گفت: بی vmin و vmax، matplotlib نقشهٔ رنگ را به هر بازهای که در داده هست مقیاس میدهد و آنگاه دو تصویر از یک صحنه میتوانند متفاوت دیده شوند. اینجا مقیاس روی بازهٔ کامل 0..9 ثابت شده است.
Source
plt.figure(figsize=(3, 4))
plt.imshow(img, cmap=plt.cm.gray, vmin=0, vmax=9)
plt.colorbar(label="gray level")
plt.title("the toy image as numbers");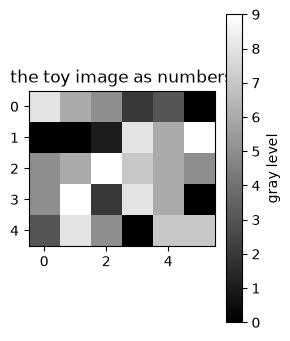
۲. سادهترین قطعهبندی: آستانهگذاری
عددی بگیرید، مثلاً 5، و هر پیکسل بالاتر از آن را پیشزمینه بنامید:
در NumPy این یک مقایسه است. نتیجه آرایهای بولی با همان شکل تصویر است، و True/False دقیقاً مثل 1/0 رفتار میکنند؛ از همین رو قطعهبندی دوناحیهای یک تصویر دودویی است.
Source
seg_img = img > 5
type(seg_img), seg_img
(numpy.ndarray,
array([[ True, True, False, False, False, False],
[False, False, False, True, True, True],
[False, True, True, True, True, False],
[False, True, False, True, True, False],
[False, True, False, False, True, True]]))قطعهبندی همان ماسک است، نه عددها. برای دیدنش، دو آرایه را کنار هم روی مقیاسهای خودشان بگذارید: 0..9 برای تصویر اصلی تا سطوح خاکستری همان معنایی را بدهند که داشتند، و 0..1 برای ماسک تا سیاه واقعاً برچسب 0 باشد.
Source
fig = plt.figure(figsize=(7, 3))
fig.add_subplot(1, 2, 1)
plt.imshow(img, cmap=plt.cm.gray, vmin=0, vmax=9)
plt.title("original")

fig.add_subplot(1, 2, 2)
plt.imshow(seg_img, cmap=plt.cm.gray, vmin=0, vmax=1)
plt.title("pixels above 5")

plt.tight_layout();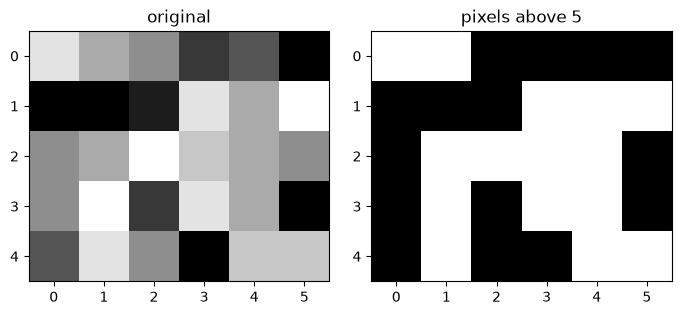
آستانهگذاری کجا میایستد
سه چیز بهمحض اینکه تصویر عکس باشد و نه اسباببازی خراب میشود:
برش از خود درآورده شده است. چرا
5و نه4یا6؟ روی این آرایهٔ اسباببازی جواب تقریباً اهمیتی ندارد؛ روی تصویر واقعی هر انتخاب مساحتی متفاوت میدهد و هیچکس نمیداند کدام درست است.یک برش از عهدهٔ نور ناهموار برنمیآید. فنجان سفید در سایه و میز تیره در نور میتوانند سطح خاکستری یکسان داشته باشند، پس هیچ عدد واحدی «فنجان» را از «میز» در همهجای تصویر جدا نمیکند.
ممکن است بیش از دو ناحیه باشند. ناحیهٔ سوم برش دومی میخواهد که با دست انتخاب شود، چهارمی برش سوم، و برشها دیگر مستقل از هم نیستند.
خوشهبندی برشِ درآوردهشده را با برشی که از داده برآورد میشود جانشین میکند: ما فقط میگوییم چند گروه میخواهیم، K، و k-means جای گروهها را مییابد.
۳. k-means با یک ویژگی در هر زمان
k-means با تناوب دو گام، نمونهها را به K گروه افراز میکند:
انتساب هر نمونه به نزدیکترین مرکز،
بهروزرسانی هر مرکز به میانگین نمونههای منتسبشده به آن،
تا وقتی چیزی جابهجا نشود. کلاس KMeans از scikit-learn همهٔ این کار را در .fit(X) انجام میدهد و دو نتیجه باقی میگذارد:
| ویژگی | شکل | معنا |
|---|---|---|
labels_ | (n_samples,) | هر نمونه در کدام گروه افتاد: 0، 1، …، K-1 |
cluster_centers_ | (K, n_features) | میانگین هر گروه |
شکلی که k-means انتظار دارد
KMeans هیچ از تصویر نمیداند. جدولی میگیرد با یک نمونه در هر سطر و یک ویژگی در هر ستون:
X.shape == (n_samples, n_features)پس فهرستی از هفت عدد جدول معتبری نیست: یک نمونه با هفت ویژگی است، که مسئلهٔ دیگری است. reshape(-1, 1) هفت عدد را به هفت سطر تکستونی تبدیل میکند و -1 یعنی «این بُعد را خودت حساب کن».
Source
integer_array = np.array([1, 2, 3, 7, 8, 9, 10])
X = integer_array.reshape(-1, 1)   # 7 samples, 1 feature each

kmeans = KMeans(n_clusters=2, n_init=10, random_state=0)
kmeans.fit(X)

labels = kmeans.labels_
cluster_centers = kmeans.cluster_centers_.ravel()

print("X.shape        :", X.shape)
print("labels         :", labels)
print("cluster centers:", cluster_centers)
X.shape : (7, 1)
labels : [1 1 1 0 0 0 0]
cluster centers: [8.5 2. ]
دو نکته دربارهٔ خروجی.
برچسبها
0و1هستند، ولی هیچ چیزی نمیگوید0گروه تیرهتر است. شمارهٔ خوشهها نامهای دلبخواهاند؛ اینجا به یک ترتیب درمیآید و در اجرای دیگری روی دادهای دیگر ممکن است برعکس شود.مرکزها میانگیناند، نه عضو: داده
2و7دارد، مرکزها2.0و8.0هستند. همان «برش آموختهشده» است — هر چه زیر5است به گروه اول و هر چه بالای آن است به گروه دوم میرود.
دام: برازش خود تصویر
حالا همان فراخوانی روی تصویر اسباببازی. img شکل 5 x 6 دارد، پس scikit-learn آن را ۵ نمونه با ۶ ویژگی میخواند — پنج سطر ششعددی — و پنج برچسب میدهد، یکی برای هر سطر. نتیجه گروهبندی خطوط افقی است، نه قطعهبندی پیکسلها.
Source
kmeans_wrong = KMeans(n_clusters=2, n_init=10, random_state=0)
kmeans_wrong.fit(img)          # img is 5 x 6, not 30 x 1

print("features K-means read:", kmeans_wrong.n_features_in_)
print("number of labels     :", len(kmeans_wrong.labels_))
print("labels               :", kmeans_wrong.labels_)
features K-means read: 6
number of labels : 5
labels : [0 1 0 0 0]
اصلاح کار این است که صریح بگوییم یک نمونه چیست: یک پیکسل، یک سطح خاکستری.
تختکردن تصویر به (H*W, 1) سی نمونه با یک ویژگی میدهد، و آنگاه دو گروه «پیکسلهای تیره» و «پیکسلهای روشن» میشوند — دقیقاً همان چیزی که آستانهگذاری حساب کرد، با این تفاوت که برش یاد گرفته شد و نه تایپ.
Source
X = img.reshape(-1, 1)          # 30 pixels, one gray value each
print("X.shape:", X.shape)

kmeans = KMeans(n_clusters=2, n_init=10, random_state=0)
kmeans.fit(X)

labels = kmeans.labels_
cluster_centers = kmeans.cluster_centers_.ravel()

print("labels :", labels)
print("centers:", np.sort(cluster_centers))
X.shape: (30, 1)
labels : [0 0 0 1 1 1 1 1 1 0 0 0 0 0 0 0 0 0 0 0 1 0 0 1 1 0 0 1 0 0]
centers: [1.1 6.75]
برگرداندن برچسبها
labels فهرستی تخت به ترتیب سطرمحور است: نخستین W درایه سطر اول تصویر است، W تای بعدی سطر دوم و به همین ترتیب — همان ترتیبی که reshape(-1, 1) پیکسلها را خواند. پس بازشکل به img.shape هر برچسب را روی پیکسل خودش برمیگرداند.
Source
seg_img_labels = labels.reshape(img.shape)   # back to 5 x 6

fig = plt.figure(figsize=(7, 3))
fig.add_subplot(1, 2, 1)
plt.imshow(img, cmap=plt.cm.gray, vmin=0, vmax=9)
plt.title("original")

fig.add_subplot(1, 2, 2)
plt.imshow(seg_img_labels, cmap=plt.cm.gray, vmin=0, vmax=1)
plt.title("K-means labels (arbitrary shades)")

plt.tight_layout();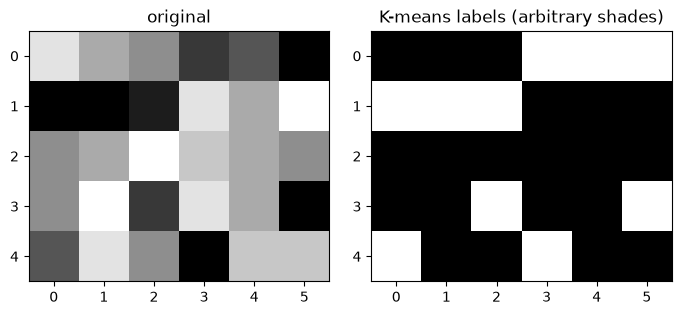
برچسبها ناماند؛ مرکزها سطح خاکستری
پنل راست برچسبها را نشان میدهد و شبیه قطعهبندی است — ولی رنگهایی که به کار میبرد شناسههای خوشه 0 و 1 است، نه روشنایی. اگر برچسبها برعکس درمیآمدند، همان ناحیهها با سایههای جابهجاشده رنگ میشدند، و همین مقایسهٔ دو قطعهبندی را ناممکن میکند.
رنگکردن هر پیکسل با مرکز خوشهاش این را جبران میکند. آنگاه تصویر پوستری میشود: هر ناحیه یک سطح خاکستری میگیرد و آن سطوح میانگین واقعی روشنایی ناحیهاند، پس ترتیبی وجود دارد.
Source
print("label -> learned gray level:",
      {k: round(float(c), 2) for k, c in enumerate(cluster_centers)})

# replace every pixel by the center of the cluster it belongs to
seg_img_centers = cluster_centers[labels].reshape(img.shape)
label -> learned gray level: {0: 6.75, 1: 1.1}
Source
fig = plt.figure(figsize=(9, 3))
fig.add_subplot(1, 3, 1)
plt.imshow(img, cmap=plt.cm.gray, vmin=0, vmax=9)
plt.title("original")

fig.add_subplot(1, 3, 2)
plt.imshow(seg_img_labels, cmap=plt.cm.gray, vmin=0, vmax=1)
plt.title("labels")

fig.add_subplot(1, 3, 3)
plt.imshow(seg_img_centers, cmap=plt.cm.gray, vmin=0, vmax=9)
plt.title("cluster centers")

plt.tight_layout();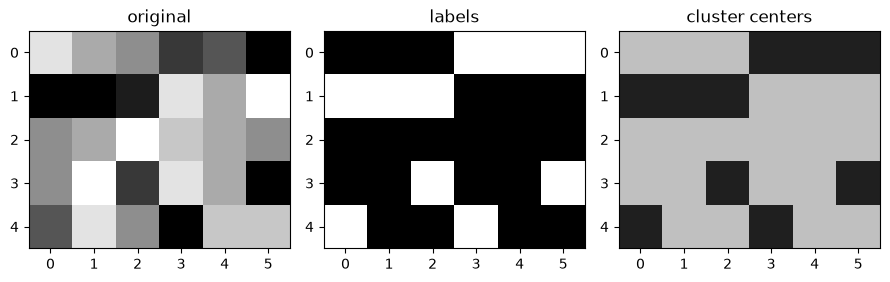
۴. یک عکس واقعی
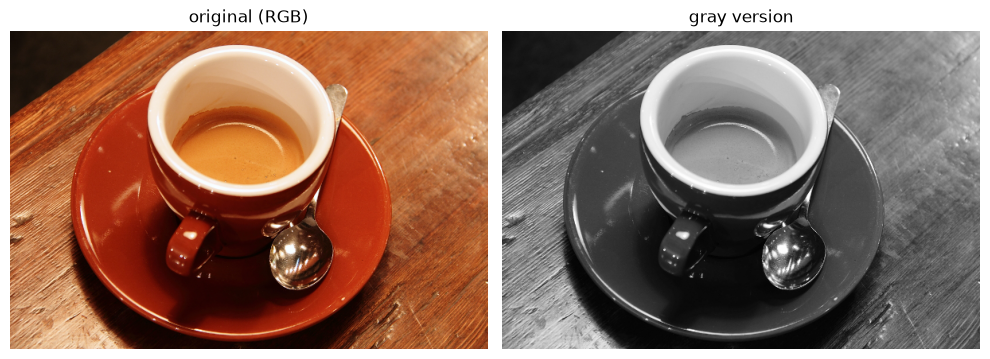
skimage.data چند تصویر آزمون دارد؛ آنکه اینجا به کار میرود عکس رنگی 400 x 600 از یک فنجان قهوه است. rgb2gray آن را با میانگین وزنی معمول سه کانال تبدیل میکند، پس هر پیکسل عددی در [0, 1] میشود. کار در خاکستری اول فضای ویژگی را یکبُعدی نگه میدارد و خواندن کار k-means را آسان میکند؛ خوشهبندی در رنگ یکی از تمرینهاست.
Source
coffee = data.coffee()
gray_coffee = rgb2gray(coffee)      # colour -> gray, values in [0, 1]

print("colour image:", coffee.shape, coffee.dtype)
print("gray image  :", gray_coffee.shape, gray_coffee.min(), gray_coffee.max())

fig, axes = plt.subplots(1, 2, figsize=(10, 4))
axes[0].imshow(coffee); axes[0].set_title("original (RGB)")
axes[1].imshow(gray_coffee, cmap="gray"); axes[1].set_title("gray version")
for a in axes:
    a.axis("off")
plt.tight_layout();
colour image: (400, 600, 3) uint8
gray image : (400, 600) 0.0002827450980392157 1.0
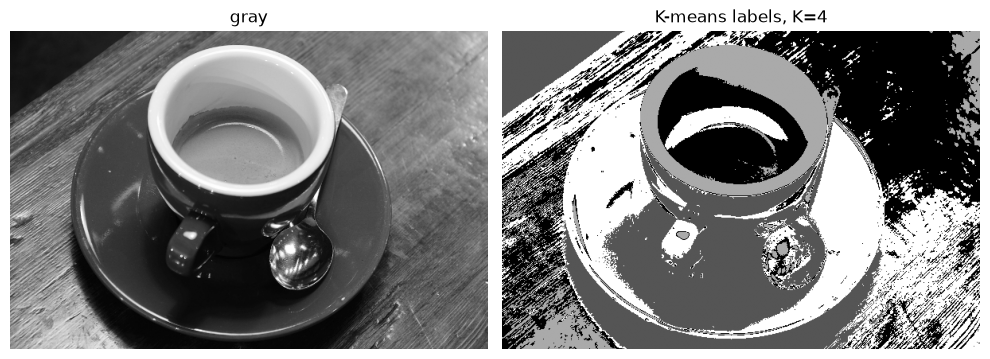
K = 4 چهار گروه روشنایی میخواهد: معمولاً میز تیره، بشقاب میانتیره، فنجان روشن و درخشش روی فنجان. هیچچیز در کد از فنجان و میز نمیداند — پیکسلها فقط بر پایهٔ سطح خاکستری مرتب میشوند و تصویر بعد نقاشی میشود.
Source
X = gray_coffee.reshape(-1, 1)      # one feature per pixel: its gray level
K = 4
kmeans = KMeans(n_clusters=K, n_init=10, random_state=0)
labels = kmeans.fit(X).labels_
cluster_centers = kmeans.cluster_centers_.ravel()

print("number of pixels   :", X.shape[0])
print("learned gray levels:", np.round(np.sort(cluster_centers), 3))

seg_img_labels = labels.reshape(gray_coffee.shape)

fig, axes = plt.subplots(1, 2, figsize=(10, 4))
axes[0].imshow(gray_coffee, cmap="gray"); axes[0].set_title("gray")
axes[1].imshow(seg_img_labels, cmap="gray")
axes[1].set_title(f"K-means labels, K={K}")
for a in axes:
    a.axis("off")
plt.tight_layout();
number of pixels : 240000
learned gray levels: [0.088 0.312 0.522 0.804]
Source
# paint every pixel with the gray level of its cluster center
seg_img_centers = cluster_centers[labels].reshape(gray_coffee.shape)

fig, axes = plt.subplots(1, 2, figsize=(10, 4))
axes[0].imshow(seg_img_labels, cmap="gray"); axes[0].set_title("labels")
axes[1].imshow(seg_img_centers, cmap="gray", vmin=0, vmax=1)
axes[1].set_title("cluster centers")
for a in axes:
    a.axis("off")
plt.tight_layout();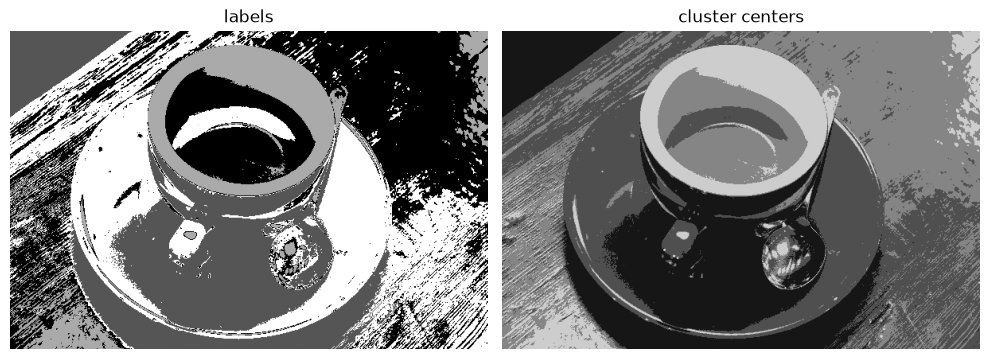
انتخاب K
K تنها عددی است که کاربر میدهد، و گزارهای است دربارهٔ صحنه، نه دربارهٔ الگوریتم: «باور دارم اینجا چهار نوع سطح هست». کوچکتر از اندازه، دو سطح متفاوت یک ناحیه را شریک میشوند؛ بزرگتر، یک سطح به سایههای خودش میشکند. تشخیصهای معمول — آرنج inertia، امتیاز سیلوئت — موضوع صفحهٔ اعتبارسنجی خوشهبندی است.
۵. مختصات پیکسل بهعنوان ویژگی اضافه
همهٔ بالا در هر زمان به یک پیکسل نگاه میکرد. تختکردن تصویر تنها چیزی را که میگفت پیکسل کجاست دور انداخت: دو پیکسل با سطح خاکستری یکسان برای k-means یک نمونهاند، چه کنار هم باشند چه در دو گوشهٔ مخالف. پس روشی که فقط روشنایی را به کار میبرد هرگز نمیتواند دو بخش از یک شیء با رنگ یکسان را جدا کند و با خوشحالی جزیرههای پراکندهٔ یک ناحیه را درون ناحیهٔ دیگر میکشد.
اصلاح کار این است که به هر پیکسل سه ویژگی بدهیم نه یکی: سطح خاکستری v، ستون x و سطر y. آنگاه k-means نقطهها را در فضای سهبُعدی خوشهبندی میکند و دو پیکسل باید هم در روشنایی توافق داشته باشند و هم در فضا نزدیک باشند تا ناحیهای را شریک شوند.
مقیاس مهم است
سطح خاکستری در [0, 1] است، در حالی که شمارهٔ ستون تا w - 1 میرود — چند صد. فاصلهٔ اقلیدسی را بزرگترین عددها میبلعند، پس با مختصات خام روشنایی نادیده میماند و نتیجه کاشیکاری تصویر به مربعهای برابر میشود. تقسیم هر ستون بر بیشینهاش هر سه ویژگی را به مقیاس [0, 1] میبرد که در آن میتوانند با هم رقابت کنند.
Source
coffee_small = resize(coffee, (coffee.shape[0] // 2, coffee.shape[1] // 2),
                      anti_aliasing=True)
gray_small = rgb2gray(coffee_small)
h, w = gray_small.shape
print("image size:", gray_small.shape, "-> pixels:", h * w)

# feature 1: the gray level of each pixel
X_intensity = gray_small.reshape(-1, 1)
image size: (200, 300) -> pixels: 60000
Source
# features 2 and 3: the column and the row of each pixel
xx, yy = np.meshgrid(np.arange(w), np.arange(h))
coords = np.column_stack([xx.ravel(), yy.ravel()])
print("coordinates of the first three pixels:\n", coords[:3])

X_xy = np.concatenate([X_intensity, coords], axis=1)
print("min / max of each feature before scaling:\n",
      np.vstack([X_xy.min(axis=0), X_xy.max(axis=0)]))

# put every column on a [0, 1] scale, so no feature wins by its units
X_xy = X_xy / X_xy.max(axis=0)
print("after scaling:\n", np.round(X_xy[:3], 3))
coordinates of the first three pixels:
[[0 0]
[1 0]
[2 0]]
min / max of each feature before scaling:
[[1.48394732e-02 0.00000000e+00 0.00000000e+00]
[9.94999902e-01 2.99000000e+02 1.99000000e+02]]
after scaling:
[[0.057 0. 0. ]
[0.057 0.003 0. ]
[0.059 0.007 0. ]]
Source
K = 16
labels_int = KMeans(n_clusters=K, n_init=10, random_state=0).fit(X_intensity).labels_
labels_xy = KMeans(n_clusters=K, n_init=10, random_state=0).fit(X_xy).labels_

seg_int = labels_int.reshape(gray_small.shape)
seg_xy = labels_xy.reshape(gray_small.shape)

fig, axes = plt.subplots(2, 2, figsize=(9, 7))
axes[0, 0].imshow(coffee_small); axes[0, 0].set_title("original (RGB)")
axes[0, 1].imshow(gray_small, cmap="gray"); axes[0, 1].set_title("gray")
axes[1, 0].imshow(seg_int, cmap="gray"); axes[1, 0].set_title("intensity only")
axes[1, 1].imshow(seg_xy, cmap="gray"); axes[1, 1].set_title("intensity + coordinates")
for a in axes.ravel():
    a.axis("off")
plt.tight_layout();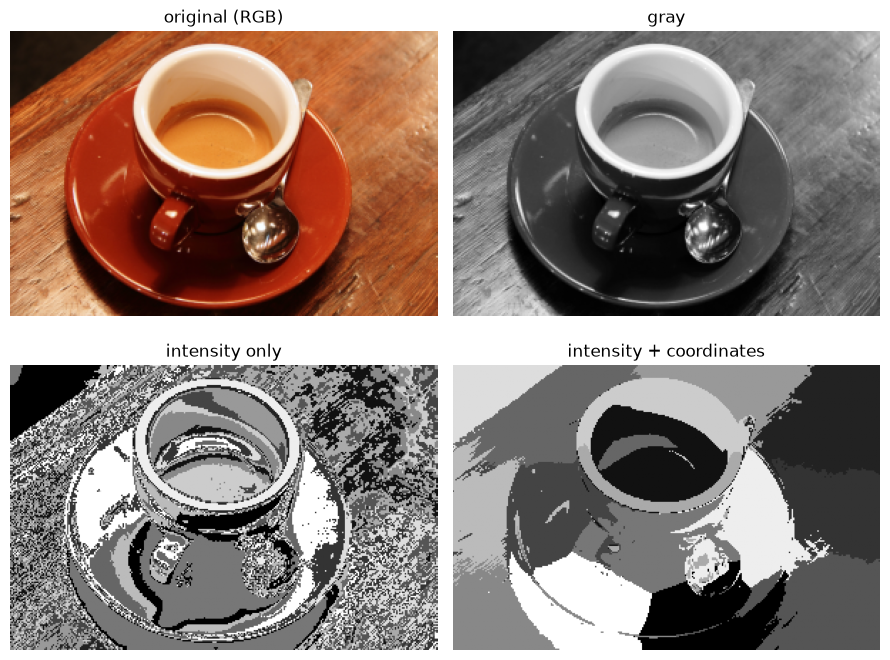
تفاوت فوراً دیده میشود: با مختصات، ناحیهها از خط دور فنجان پیروی میکنند و لکههای روشن پراکندهٔ نتیجهٔ تکویژگی ناپدید میشوند، چون یک لکه اکنون یا در فضا به ناحیهای واقعی نزدیک است یا نیست.
دو نکته پیش از ادامه.
با مختصات، فاصله اختلاف روشنایی و فاصلهٔ مکانی را در هم میآمیزد و نرمالسازی نرخ مبادله را تعیین میکند. مقیاسکردن ستونهای مختصات با ضریب
\lambda < 1جملهٔ مکانی را ضعیف میکند و نتیجه را به نسخهٔ تکویژگی نزدیکتر میسازد؛ این همان پیچ پیوسته میان دو انتهای بالا است.پنل سوم و چهارم با شناسههای خوشه رنگ شدهاند، پس سایههایشان دلبخواه است. مقایسهٔ منصفانهشان گام زیر را میخواهد.
بازچینی برچسبها بر پایهٔ روشنایی
خوشهٔ 0 در یک قطعهبندی و خوشهٔ 0 در قطعهبندی دیگر هیچ اشتراکی ندارند: شمارهگذاری بستگی دارد به اینکه مرکزها از کجا شروع کردهاند. برای مقایسهٔ دو قطعهبندی — و حتی برای دیدن یکی — خوشهها را بر پایهٔ میانگین سطح خاکستری پیکسلهایشان شماره بزنید تا 0 همیشه تیرهترین ناحیه و K-1 روشنترین باشد. np.argsort رتبهبندی را میدهد و حلقهٔ زیر آن را بر برچسبها اعمال میکند.
Source
def relabel_by_brightness(labels, pixels, K):
    """Number the clusters from the darkest (0) to the brightest (K - 1)."""
    mean_level = np.array([pixels[labels == k].mean() for k in range(K)])
    order = np.argsort(mean_level)          # order[rank] = old cluster id
    new_labels = np.zeros_like(labels)
    for k in range(K):
        new_labels[labels == k] = np.where(order == k)[0][0]
    return new_labels, mean_level[order]
Source
pixels = gray_small.ravel()

new_labels_int, levels_int = relabel_by_brightness(labels_int, pixels, K)
new_labels_xy, levels_xy = relabel_by_brightness(labels_xy, pixels, K)

print("intensity only :", np.round(levels_int, 3))
print("intensity + xy :", np.round(levels_xy, 3))
intensity only : [0.043 0.095 0.154 0.213 0.269 0.313 0.364 0.415 0.466 0.516 0.574 0.628
0.691 0.76 0.851 0.935]
intensity + xy : [0.091 0.101 0.105 0.124 0.254 0.294 0.362 0.377 0.444 0.468 0.493 0.558
0.57 0.642 0.814 0.885]
Source
seg_int = new_labels_int.reshape(gray_small.shape)
seg_xy = new_labels_xy.reshape(gray_small.shape)

fig, axes = plt.subplots(2, 2, figsize=(9, 7))
axes[0, 0].imshow(coffee_small); axes[0, 0].set_title("original (RGB)")
axes[0, 1].imshow(gray_small, cmap="gray"); axes[0, 1].set_title("gray")
axes[1, 0].imshow(seg_int, cmap="gray", vmin=0, vmax=K - 1)
axes[1, 0].set_title("intensity only, ordered")
axes[1, 1].imshow(seg_xy, cmap="gray", vmin=0, vmax=K - 1)
axes[1, 1].set_title("intensity + coordinates, ordered")
for a in axes.ravel():
    a.axis("off")
plt.tight_layout();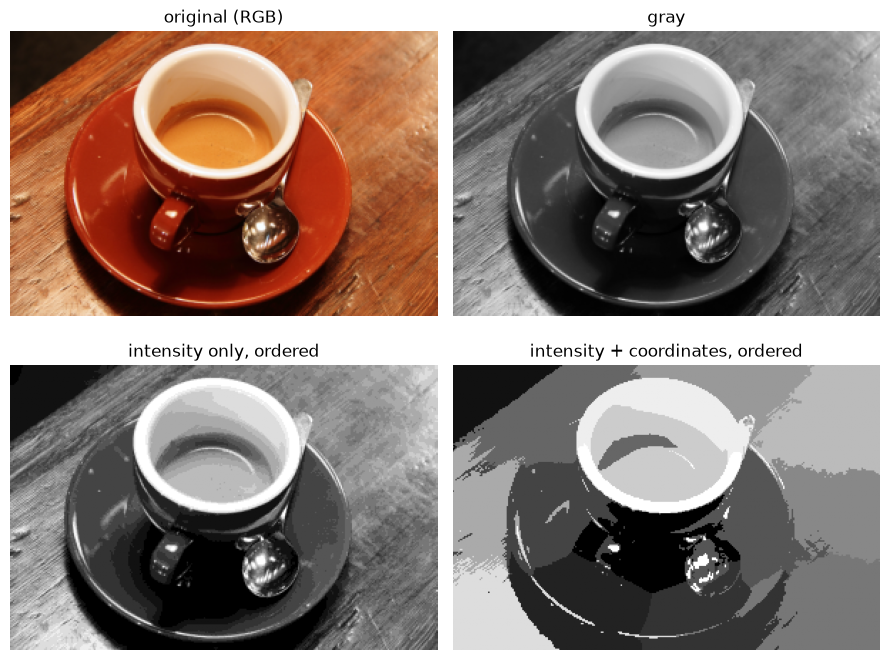
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans

# 1) Build a synthetic image where the same intensity appears in
#    two spatially distant regions.
h, w = 100, 200
yy, xx = np.meshgrid(np.arange(h), np.arange(w), indexing='ij')
img_syn = np.zeros((h, w))
img_syn[:, :100] = 0.2   # left background (dark)
img_syn[:, 100:] = 0.8   # right background (bright)

# Two circles with the SAME intensity 0.5, one in each half
left_circle  = (yy - 50) ** 2 + (xx - 50)  ** 2 < 20 ** 2
right_circle = (yy - 50) ** 2 + (xx - 150) ** 2 < 20 ** 2
img_syn[left_circle | right_circle] = 0.5

# 2) K-means with intensity only (1 feature)
X_int = img_syn.reshape(-1, 1)
labels_int = KMeans(n_clusters=2, n_init=10, random_state=0).fit_predict(X_int).reshape(h, w)

# 3) K-means with intensity + normalized (x, y) (3 features)
X_sp = np.column_stack([
    img_syn.ravel(),
    xx.ravel() / w,   # x in [0, 1]
    yy.ravel() / h,   # y in [0, 1]
])
labels_sp = KMeans(n_clusters=2, n_init=10, random_state=0).fit_predict(X_sp).reshape(h, w)

# 4) Visualization using distinct label colours (not cluster centres)
colors = np.array([[0.85, 0.20, 0.20],   # colour 0 (red)
                   [0.20, 0.30, 0.85]])  # colour 1 (blue)

fig, axes = plt.subplots(1, 3, figsize=(15, 5))
axes[0].imshow(img_syn, cmap='gray', vmin=0, vmax=1)
axes[0].set_title('Original synthetic image')
axes[0].axis('off')

axes[1].imshow(colors[labels_int])
axes[1].set_title('Intensity only (1 feature)')
axes[1].axis('off')

axes[2].imshow(colors[labels_sp])
axes[2].set_title('Intensity + (x, y) (3 features)')
axes[2].axis('off')

plt.tight_layout()
plt.show()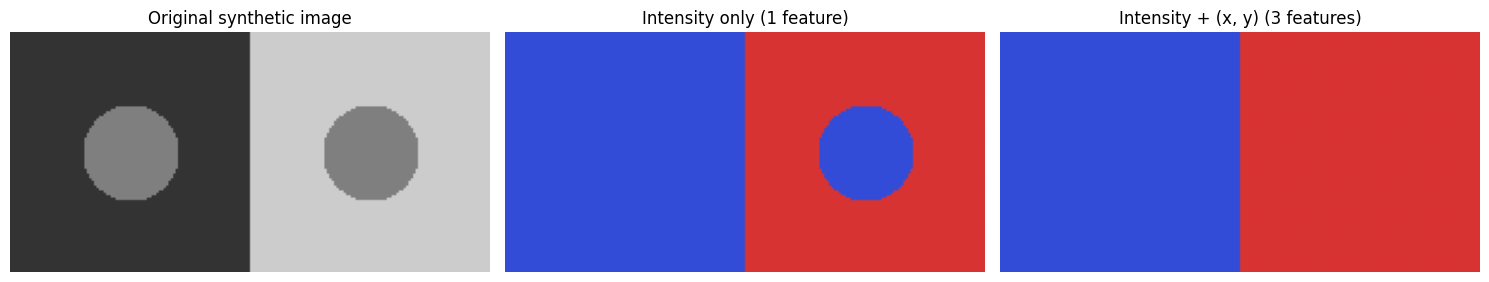
کاربرد: ابرپیکسل
نمونهٔ ابرپیکسل با پیادهسازی آمادهٔ SLIC
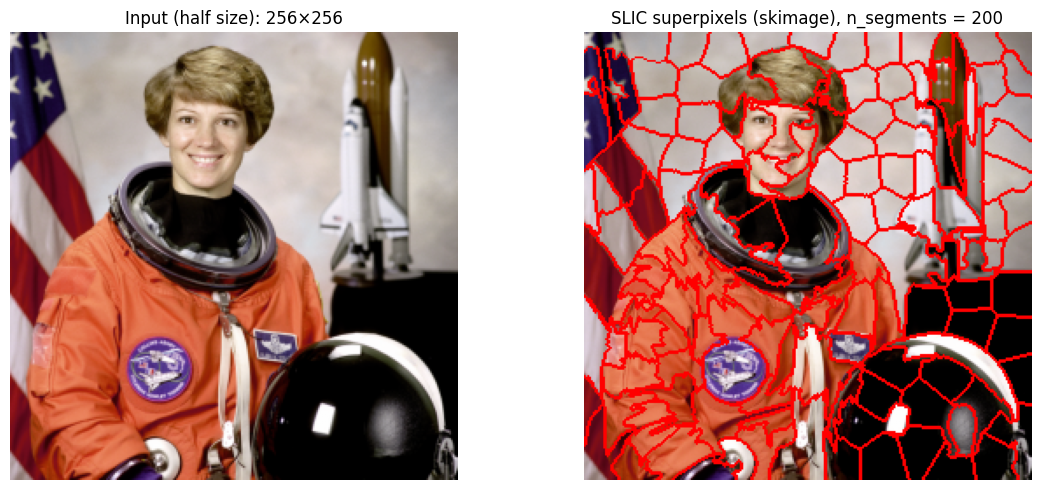
skimage الگوریتم SLIC را آماده دارد. برای اینکه نمایش سریع بماند و در همان حال شکل مشخصهٔ ابرپیکسلها دیده شود، عکس ورودی نخست به نیمِ اندازهٔ اصلی کوچک میشود (۵۱۲×۵۱۲ ← ۲۵۶×۲۵۶). سپس الگوریتم روی همین تصویر کوچکتر اجرا میشود.
SLIC با اجرای یک k-means محلی روی بردارهای ویژگی پنجبُعدی کار میکند که سه مؤلفهٔ رنگ (در فضای ادراکی-یکنواخت Lab) را با دو مختصات پیکسل (x, y) در هم میآمیزد. محدود کردن هر بهروزرسانی به پنجرهای کوچک گرد هر مرکز همان چیزی است که ناحیهها را جمعوجور و تقریباً شبکهای میکند. پارامتر compactness نقش وزن m روی جملهٔ مکانی را بازی میکند: مقدار بزرگتر ابرپیکسلها را منظمتر میکند؛ مقدار کوچکتر میگذارد جملهٔ رنگ چیره شود و ناحیهها آزادانهتر از مرزهای رنگ پیروی کنند.
# ============================================================
# Example 2a: SLIC superpixels (skimage) on a half-size image
# ============================================================
import numpy as np
import matplotlib.pyplot as plt
from skimage import data, segmentation
from skimage.segmentation import mark_boundaries
from skimage.transform import rescale

# 1) Load the colour photograph and downscale it to half size
image_full = data.astronaut()                  # 512 x 512 RGB
image = rescale(
    image_full,
    scale=0.5,
    channel_axis=-1,
    anti_aliasing=True,
)
print("image shape after rescaling:", image.shape)

# 2) Run the built-in SLIC
segments = segmentation.slic(
    image,
    n_segments=200,        # approximate number of superpixels
    compactness=10,        # balance between colour and space
    start_label=0,
    channel_axis=-1,
)

# 3) Visualise
fig, axes = plt.subplots(1, 2, figsize=(12, 5))
axes[0].imshow(image)
axes[0].set_title(f'Input (half size): {image.shape[0]}×{image.shape[1]}')
axes[0].axis('off')

axes[1].imshow(mark_boundaries(image, segments, color=(1, 0, 0)))
axes[1].set_title('SLIC superpixels (skimage), n_segments = 200')
axes[1].axis('off')

plt.tight_layout()
plt.show()
image shape after rescaling: (256, 256, 3)
قطعهبندی به سبک ابرپیکسل با k-means خودمان
همان ایده را میتوان با چیزی بیش از KMeans از scikit-learn بازتولید کرد. هر پیکسل یک نمونه میشود که ویژگیهایش سه مؤلفهٔ رنگ Lab (مقیاسشده به [0, 1]) بهعلاوهٔ موقعیت نرمالشدهٔ (x, y) پیکسل است. وزن مکانی تعیین میکند الگوریتم چقدر پیکسلهای نزدیک را بر شباهت رنگی ترجیح دهد.
ناحیههای بهدستآمده از SLIC واقعی نامنظمترند، چون این یک k-means جهانی است: انتسابها را به پنجرهای محلی محدود نمیکند و گام پیوستگی ندارد. با این حال همان ایده است و روشن میکند که تمام ترفند پشت SLIC بهسادگی این است: «مختصات پیکسل را ویژگی اضافه بگیر و بردارهای پنجبُعدی را خوشهبندی کن».
تصویر ورودی به نیمِ اندازهٔ اصلی کوچک میشود تا زمان اجرا روی مسئلهٔ ۶۵٬۵۳۶ نمونه معقول بماند و نتیجهٔ دیداری هم هنوز آگاهیبخش باشد.
# ============================================================
# Example 2b: superpixel-style segmentation with plain KMeans
#             on a half-size image
# ============================================================
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from skimage import data, color
from skimage.segmentation import mark_boundaries
from skimage.transform import rescale

# 1) Load the colour photograph and downscale it to half size
image_full = data.astronaut()                  # 512 x 512 RGB
image = rescale(
    image_full,
    scale=0.5,
    channel_axis=-1,
    anti_aliasing=True,
)
print("image shape after rescaling:", image.shape)

# 2) Build the 5-D feature matrix: (L, a, b, x, y)
lab = color.rgb2lab(image)
h, w = image.shape[:2]
yy, xx = np.meshgrid(np.arange(h), np.arange(w), indexing='ij')

# Scale colour channels to roughly [0, 1] so that neither
# the colour nor the position term dominates the distance.
spatial_weight = 0.4

features = np.column_stack([
    lab[..., 0].ravel() / 100.0,           # L / 100
    (lab[..., 1].ravel() + 128) / 255.0,   # a in [0, 1]
    (lab[..., 2].ravel() + 128) / 255.0,   # b in [0, 1]
    spatial_weight * xx.ravel() / w,       # normalised x
    spatial_weight * yy.ravel() / h,       # normalised y
])

# 3) Global K-means over the 5-D features
n_segments = 200
kmeans = KMeans(n_clusters=n_segments, n_init=10, random_state=0)
labels = kmeans.fit_predict(features).reshape(h, w)

# 4) Visualise
fig, axes = plt.subplots(1, 2, figsize=(12, 5))
axes[0].imshow(image)
axes[0].set_title(f'Input (half size): {h}×{w}')
axes[0].axis('off')

axes[1].imshow(mark_boundaries(image, labels, color=(1, 0, 0)))
axes[1].set_title('Our KMeans on Lab + (x, y), n_segments = 200')
axes[1].axis('off')

plt.tight_layout()
plt.show()
image shape after rescaling: (256, 256, 3)
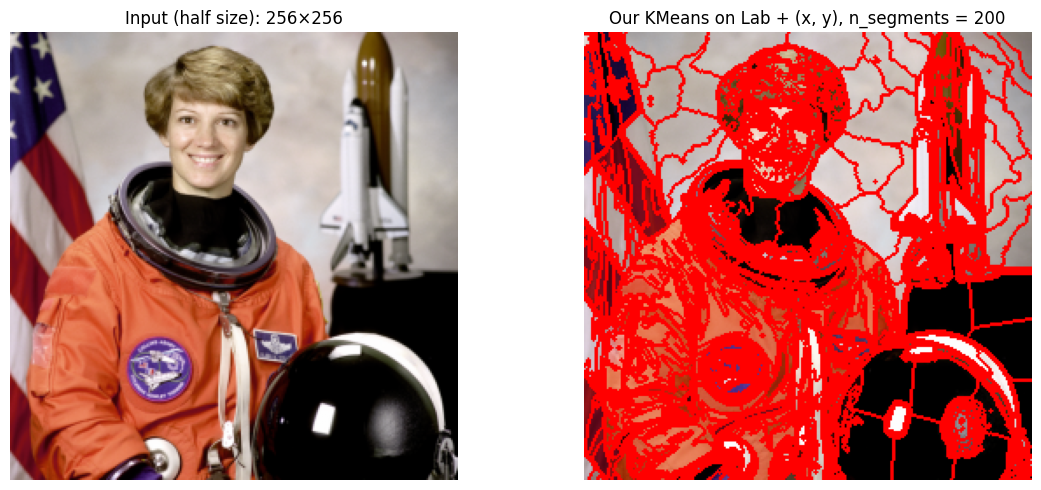
تفاوتی که میبینید ایراد نیست: دقیقاً همان دلیلی است که SLIC را گونهٔ محلی k-means مینامند. محدود کردن جستوجو به پنجرهای گرد هر مرکز و اعمال پیوستگی در پایان، دو جزءیاند که یک k-means جهانی را به الگوریتم درست ابرپیکسل تبدیل میکنند.
۶. سه روش در کنار هم
| روش | بردار ویژگی یک پیکسل | چه را میتواند جدا کند | چه را نمیتواند |
|---|---|---|---|
| آستانهگذاری | — (برشی روی v) | دو سطح روشنایی | هر چیز دیگر؛ برش دستی میخواهد |
k-means روی v | (v) | K سطح روشنایی، یادگرفته | ناحیههای همروشنایی در جاهای مختلف |
k-means روی (v, x, y) | (v, x, y) | روشنایی و جمعوجوری مکانی | اشیای غیرجمعوجور؛ وزن مقیاس میخواهد |
ترتیب جدول همان داستان صفحه است. هر سطر یک تکه اطلاعات میافزاید که سطر بالایی نمیدید: اولی هیچ پارامتر آموختهشدهای ندارد، دومی سطحها را میآموزد، سومی سطحها را میآموزد و از جای پیکسلها هم بهره میبرد.
هیچکدام نمیدانند فنجان چیست. آنچه عوض میشود فقط نمایش یک پیکسل است — یک عدد یا سه عدد — و قطعهبندی همان چیزی است که خوشهبندی این نمایش میدهد.
خلاصه
قطعهبندی به هر پیکسل برچسبی میدهد؛ توصیفی از تصویر است، نه تغییری در آن.
آستانهگذاری برشی دستی روی سطح خاکستری است: روی آرایهٔ اسباببازی درست، زیر نور ناهموار شکننده، و در بیش از دو ناحیه کور.
KMeansشکل(n_samples, n_features)میخواهد. برای تصویر یعنیimg.reshape(-1, 1)— یک پیکسل در هر سطر — هرگز آرایهٔ خامH x Wکه بهصورتHنمونه باWویژگی خوانده میشود.labels_نامهای دلبخواهاند؛cluster_centers_[labels]تصویر را با سطحهای خاکستری واقعی میکشد و نتیجه را قابلمقایسه میکند.برچسبها همیشه تخت و به ترتیب سطرمحور برمیگردند، پس
reshape(img.shape)آنها را روی پیکسل درست میگذارد.افزودن
(x, y)بهعنوان ویژگی به خوشهبندی امکان میدهد از موقعیت بهره ببرد؛ این کار جزیرههای پراکنده را برمیدارد و از خط دور اشیا پیروی میکند؛ ولی ستونها نخست باید به بازهٔ مشترکی مقیاس شوند و همان مقیاس وزن جملهٔ مکانی است.شناسههای خوشه باید پیش از مقایسهٔ دو قطعهبندی بازچینی شوند (اینجا بر پایهٔ میانگین روشنایی).
تمرینها
آستانهٔ بخش ۲ را از
5به6و4تغییر دهید. کدام پیکسلها ناحیه عوض میکنند، و جواب «درست» روی این آرایهٔ اسباببازی اصلاً چه معنایی میتواند داشته باشد؟تصویر رنگی را خوشهبندی کنید:
coffee.reshape(-1, 3)وK = 8را به کار ببرید، بعد هر پیکسل را باcluster_centers_[labels]بازشکلداده به(H, W, 3)رنگ کنید. رنگ کجا موفق میشود و خاکستری کجا شکست میخورد؟برای فنجان قهوه، قطعهبندی تکویژگی را با
K = 2, 4, 8, 16اجرا کنید و بگویید هر خوشهٔ اضافه چه میخرد. نتیجه از کجا دیگر قطعهبندی نیست و به کاهش سایهها تبدیل میشود؟در آزمایش مختصات
Kرا به4تغییر دهید و نرمالسازی را نگه دارید، سپس آن را با ستونهای مختصات ضربشده در0.2تکرار کنید. تفاوت را برحسب دو جملهٔ فاصله توضیح دهید.برای
K = 1..10روی تصویر خاکستری، inertia (kmeans.inertia_) را برحسبKرسم کنید. آرنجی هست و باKای که با چشم انتخاب میکنید توافق دارد؟
منابع
الگوریتم k-means و کاربردش در قطعهبندی تصویر: zaki2020data.
skimage.data.coffeeوrgb2gray: مستندات دادهٔ scikit-image و تبدیل رنگ.مثال آستانهگذاری از راهنمای قطعهبندی scikit-image پیروی میکند.