k نزدیکترین همسایه و سنجههای ارزیابی دستهبندی
k نزدیکترین همسایه و سنجههای ارزیابی دستهبندی
گروه علوم کامپیوتر، دانشگاه فردوسی مشهد
این نوتبوک پوشش میدهد:
مروری بر الگوریتم k نزدیکترین همسایه (kNN)
سنجههای ارزیابی دستهبندی: دقت، دقت مثبت (precision)، بازیابی (recall) و امتیاز F1
Notebook Cell
# Import necessary libraries
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd
from sklearn.datasets import make_classification, make_blobs
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay
import seaborn as sns

# Set plotting style
# plt.style.use('seaborn-whitegrid')
sns.set_context("notebook", font_scale=1.5)
مروری بر k نزدیکترین همسایه (kNN)
الگوریتم k نزدیکترین همسایه — که در ابرپارامترها و اعتبارسنجی مدل دیدیم — روشی ناپارامتری و نمونهمحور برای دستهبندی و رگرسیون است. الگوریتم k نمونهٔ آموزشیِ نزدیکتر به نمونهٔ تازه را مییابد و بر پایهٔ رأی اکثریت برچسب کلاس را پیشبینی میکند.
ویژگیهای کلیدی kNN:
ناپارامتری: الگوریتم دربارهٔ توزیع زیربنایی داده فرضی نمیگذارد.
نمونهمحور (یادگیری تنبل): فاز آموزش صریحی ندارد؛ مدل فقط دادهٔ آموزش را نگه میدارد.
فاصلهمحور: پیشبینی بر پایهٔ فاصلهٔ میان نقطهها انجام میشود.
الگوریتم kNN (به روایت دودا و همکاران):
همهٔ نمونههای آموزشی را با برچسب کلاسشان ذخیره کن.
برای نمونهٔ تازهٔ x:
فاصلهٔ x تا همهٔ نمونههای آموزشی را حساب کن.
k نمونهٔ آموزشی نزدیکتر (k نزدیکترین همسایه) را برگزین.
برچسب کلاس را بر پایهٔ رأی اکثریت میان این k همسایه نسبت بده.
سنجههای فاصله:
رایجترین سنجههای فاصله در kNN:
فاصلهٔ اقلیدسی:
فاصلهٔ منهتن:
فاصلهٔ مینکوفسکی:
بیایید الگوریتم kNN را پیاده و مصور کنیم:
# Generate a simple dataset
X, y = make_blobs(n_samples=300, centers=3, random_state=42, cluster_std=3)
# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
Source
# Visualize the dataset
plt.figure(figsize=(10, 6))
plt.scatter(X_train[:, 0], X_train[:, 1], c=y_train, cmap='viridis', s=50, alpha=0.8, edgecolors='k')
plt.scatter(X_test[:, 0], X_test[:, 1], c=y_test, cmap='viridis', s=100, alpha=0.3, marker='s')
plt.title('Dataset with 3 Classes')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.legend(['Training Data', 'Testing Data'])
plt.colorbar(label='Class Label')
plt.show()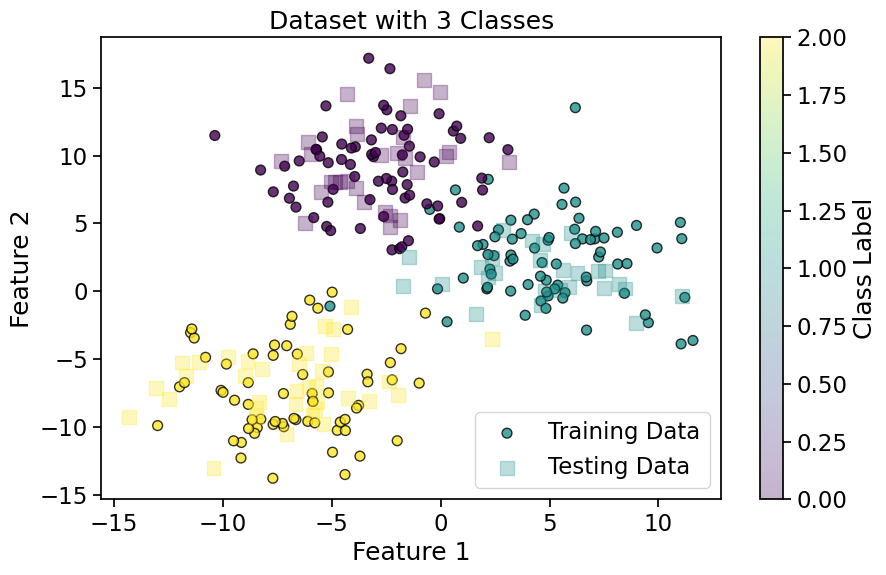
Source
# Implement kNN with different values of k
k_values = [1, 5, 15]
fig, axes = plt.subplots(1, 3, figsize=(15, 5))
axes = axes.flatten()

# Create a meshgrid for decision boundary visualization
h = 0.5  # Step size in the mesh
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, h), np.arange(y_min, y_max, h))

for i, k in enumerate(k_values):
    # Train kNN classifier
    knn = KNeighborsClassifier(n_neighbors=k)
    knn.fit(X_train, y_train)

    # Predict on the meshgrid
    Z = knn.predict(np.c_[xx.ravel(), yy.ravel()])
    Z = Z.reshape(xx.shape)

    # Plot decision boundaries
    axes[i].contourf(xx, yy, Z, alpha=0.3, cmap='viridis')
    axes[i].scatter(X_train[:, 0], X_train[:, 1], c=y_train, cmap='viridis', s=50, edgecolors='k')
    axes[i].scatter(X_test[:, 0], X_test[:, 1], c=y_test, cmap='viridis', s=100, alpha=0.3, marker='s')
    axes[i].set_title(f'kNN with k={k}')
    axes[i].set_xlabel('Feature 1')
    axes[i].set_ylabel('Feature 2')

    # Calculate and display accuracy
    y_pred = knn.predict(X_test)
    accuracy = accuracy_score(y_test, y_pred)
    axes[i].text(0.05, 0.95, f'Accuracy: {accuracy:.2f}', transform=axes[i].transAxes,
                 bbox=dict(facecolor='white', alpha=0.8))

plt.tight_layout()
plt.show()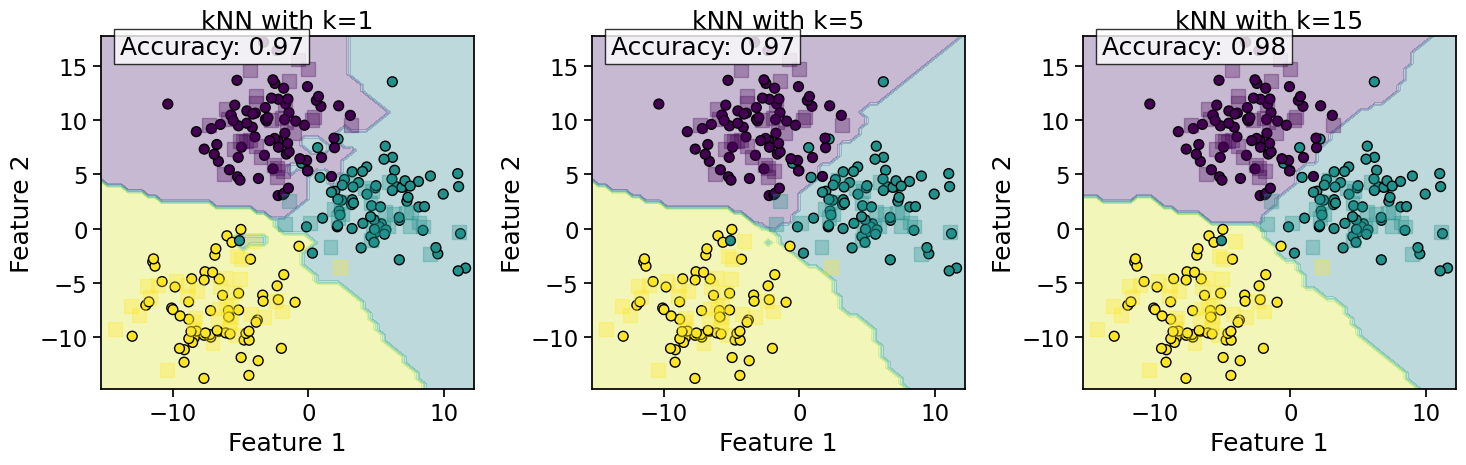
مشاهدههایی دربارهٔ رفتار kNN:
اثر k:
k کوچک: مرزهای تصمیم پیچیدهترند و میتوانند به بیشبرازش بینجامند
k بزرگ: مرزهای تصمیم نرمترند ولی ممکن است الگوهای مهم را از دست بدهند
پیچیدگی محاسباتی:
آموزش: O(1) — فقط داده ذخیره میشود
پیشبینی: O(nd) که n تعداد نمونههای آموزش و d تعداد ویژگیهاست
نفرین ابعاد:
با افزایش تعداد بُعدها، سنجهٔ فاصله معناداریاش را از دست میدهد
در ابعاد بالا همهٔ نقطهها گرایش دارند به یک اندازه از هم دور باشند
سنجههای ارزیابی دستهبندی
برای ارزیابی کارایی مدلهای دستهبندی به سنجههای مناسب نیاز داریم. انتخاب سنجه به بافت مسئله و اهمیت نسبی انواع خطا بستگی دارد.
ماتریس درهمریختگی
ماتریس درهمریختگی جدولی است که کارایی یک مدل دستهبندی را توصیف میکند. برای مسئلهٔ دستهبندی دودویی شامل اینهاست:
مثبتهای درست (TP): نمونههای مثبتی که درست پیشبینی شدهاند
مثبتهای نادرست (FP): نمونههای مثبتی که نادرست پیشبینی شدهاند (خطای نوع اول)
منفیهای درست (TN): نمونههای منفی که درست پیشبینی شدهاند
منفیهای نادرست (FN): نمونههای منفی که نادرست پیشبینی شدهاند (خطای نوع دوم)
بیایید با make_classification یک مسئلهٔ دستهبندی دودویی بسازیم و ماتریس درهمریختگی آن را ببینیم:
# Generate a binary classification dataset
X_binary, y_binary = make_classification(n_samples=1000, n_features=2, n_informative=2,
                                         n_redundant=0, n_clusters_per_class=1, random_state=42)
Source
# Split the data
X_train_bin, X_test_bin, y_train_bin, y_test_bin = train_test_split(X_binary, y_binary,
                                                                     test_size=0.3, random_state=42)
# Visualize the dataset
plt.figure(figsize=(10, 6))
plt.scatter(X_train_bin[:, 0], X_train_bin[:, 1], c=y_train_bin, cmap='viridis', s=50, alpha=0.8, edgecolors='k')
plt.scatter(X_test_bin[:, 0], X_test_bin[:, 1], c=y_test_bin, cmap='viridis', s=100, alpha=0.3, marker='s')
plt.title('Dataset with 2 Classes')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.legend(['Training Data', 'Testing Data'])
plt.colorbar(label='Class Label')
plt.show()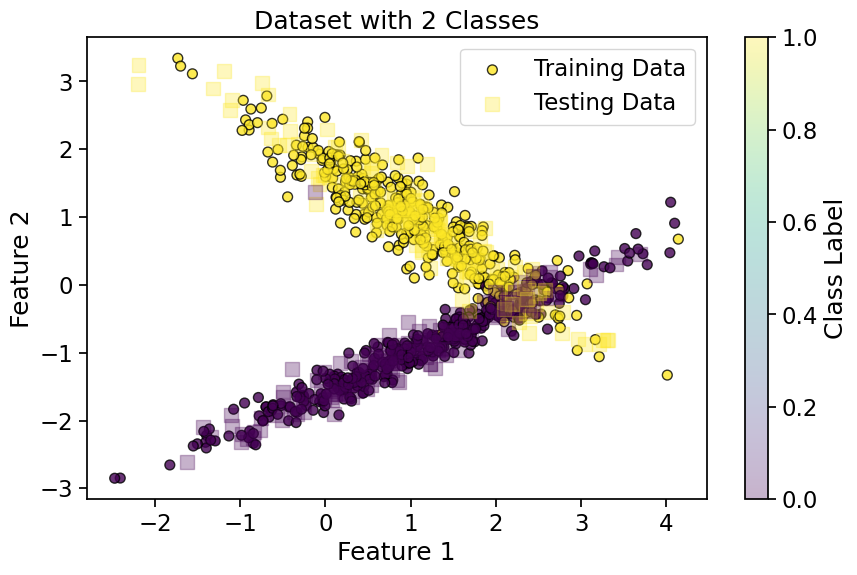
Source
# Train a kNN classifier
knn_binary = KNeighborsClassifier(n_neighbors=5)
knn_binary.fit(X_train_bin, y_train_bin)
y_pred_bin = knn_binary.predict(X_test_bin)

# Create and display the confusion matrix
cm = confusion_matrix(y_test_bin, y_pred_bin)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=['Class 0', 'Class 1'])

fig, ax = plt.subplots(figsize=(8, 4))
disp.plot(ax=ax, cmap='Blues', values_format='d')
plt.title('Confusion Matrix for Binary Classification')
plt.show()

# Extract values from confusion matrix
tn, fp, fn, tp = cm.ravel()
print(f"True Negatives (TN): {tn}")
print(f"False Positives (FP): {fp}")
print(f"False Negatives (FN): {fn}")
print(f"True Positives (TP): {tp}")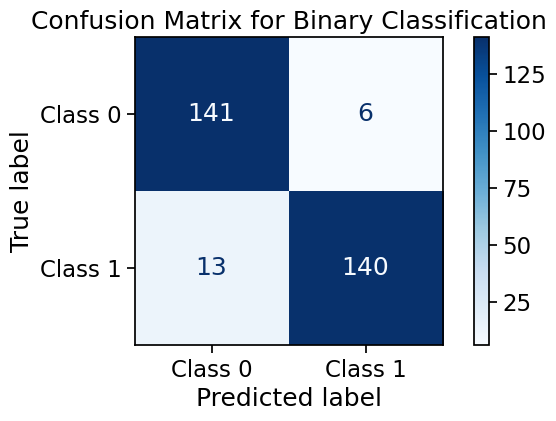
True Negatives (TN): 141
False Positives (FP): 6
False Negatives (FN): 13
True Positives (TP): 140
دقت
دقت نسبت نمونههای درستپیشبینیشده به کل نمونههاست.
مزایا:
ساده و شهودی
برای مجموعهدادهٔ متوازن خوب کار میکند
معایب:
برای مجموعهدادهٔ نامتوازن گمراهکننده است
میان انواع خطا تمایز نمیگذارد
# Calculate accuracy
acc = accuracy_score(y_test_bin, y_pred_bin)
print(f"Accuracy: {acc:.4f}")

# Manual calculation
acc_manual = (tp + tn) / (tp + tn + fp + fn)
print(f"Manually calculated accuracy: {acc_manual:.4f}")
Accuracy: 0.9367
Manually calculated accuracy: 0.9367
دقت مثبت و بازیابی

دقت مثبت (Precision)
دقت مثبت نسبت نمونههای مثبت درستپیشبینیشده به کل نمونههای مثبتِ پیشبینیشده است. به این پرسش پاسخ میدهد: «از همهٔ نمونههایی که مثبت پیشبینی شدند، چند تا واقعاً مثبتاند؟»
کاربردها و مثالهای کلیدی:
تشخیص هرزنامه — علامتزدن نادرست ایمیل مهم گران است
آزمایش پزشکی — پرهیز از تشخیص نادرست که به درمان بیمورد میانجامد
خودروهای خودگردان — تشخیص نادرست مانع میتواند واکنش خطرناکی بسازد
مزایا:
وقتی مثبتهای نادرست (FP) پیامد سنگین دارند حیاتی است
برای کاربردهایی که در آنها پیشبینی مثبتِ نادرست گران است ضروری است
در سامانههای بازیابی اطلاعات که مرتبط بودن مهم است بسیار ارزشمند است
معایب:
منفیهای نادرست را نادیده میگیرد (ممکن است موارد مهم را از دست بدهد)
اگر مدل در پیشبینی بیش از اندازه محافظهکار باشد میتواند بهطور گمراهکننده بالا باشد
برای مجموعهدادهٔ نامتوازن که منفیها غالباند بهتنهایی کافی نیست

# Calculate precision
prec = precision_score(y_test_bin, y_pred_bin)
print(f"Precision: {prec:.4f}")

# Manual calculation
prec_manual = tp / (tp + fp) if (tp + fp) > 0 else 0
print(f"Manually calculated precision: {prec_manual:.4f}")
Precision: 0.9589
Manually calculated precision: 0.9589
بازیابی (حساسیت)
بازیابی نسبت نمونههای مثبت درستپیشبینیشده به همهٔ مثبتهای واقعی است. به این پرسش پاسخ میدهد: «از همهٔ نمونههای مثبتِ واقعی، چند تا را درست پیشبینی کردیم؟»
کاربردها و مثالهای کلیدی:
تشخیص پزشکی
کشف تقلب
کشف مین
پایش امنیتی
سامانههای هشدار زودهنگام زلزله
کشف تهدید در امنیت سایبری
عملیات جستوجو و نجات
مزایا:
وقتی هزینهٔ منفیهای نادرست (FN) بالا است حیاتی میشود (مثلاً سناریوهای تهدیدکنندهٔ جان).
برای غربالگری پزشکی و کاربردهای ایمنی عمومی ضروری است.
معایب:
مثبتهای نادرست (FP) را در نظر نمیگیرد (میتواند به هشدارهای بیمورد بینجامد).
اگر مدل همهچیز را مثبت برچسب بزند میتواند مصنوعی بالا برود.
نکتهٔ بدهبستان: در بسیاری از سامانههای واقعی میان دقت مثبت و بازیابی رابطهٔ معکوس هست — بهبود یکی معمولاً دیگری را بدتر میکند. توازن درست به این بستگی دارد که کدام نوع خطا (FP یا FN) برای کاربرد شما گرانتر است.
# Calculate recall
rec = recall_score(y_test_bin, y_pred_bin)
print(f"Recall: {rec:.4f}")

# Manual calculation
rec_manual = tp / (tp + fn) if (tp + fn) > 0 else 0
print(f"Manually calculated recall: {rec_manual:.4f}")
Recall: 0.9150
Manually calculated recall: 0.9150
امتیاز F1
امتیاز F1 میانگین هارمونیک دقت مثبت و بازیابی است. توازنی میان این دو برقرار میکند.
مزایا:
دقت مثبت و بازیابی را متوازن میکند
برای مجموعهدادهٔ نامتوازن خوب کار میکند
معایب:
اگر یکی از دو سنجه مهمتر از دیگری باشد ممکن است مناسب نباشد
منفیهای درست را در نظر نمیگیرد
# Calculate F1-score
f1 = f1_score(y_test_bin, y_pred_bin)
print(f"F1-Score: {f1:.4f}")

# Manual calculation
f1_manual = 2 * (prec_manual * rec_manual) / (prec_manual + rec_manual) if (prec_manual + rec_manual) > 0 else 0
print(f"Manually calculated F1-Score: {f1_manual:.4f}")
F1-Score: 0.9365
Manually calculated F1-Score: 0.9365
بدهبستان دقت مثبت و بازیابی
اغلب میان دقت مثبت و بازیابی بدهبستان هست: افزایش یکی معمولاً دیگری را کم میکند.
بیایید این بدهبستان را با تغییر آستانهٔ تصمیم یک دستهبند احتمالاتی ببینیم:
# Generate a new dataset
X_new, y_new = make_classification(n_samples=1000, n_features=2, n_informative=2,
                                   n_redundant=0, random_state=42, weights=[0.7, 0.3])
# Split the data
X_train_new, X_test_new, y_train_new, y_test_new = train_test_split(X_new, y_new,
test_size=0.3, random_state=42)
# Visualize the dataset
plt.figure(figsize=(10, 6))
plt.scatter(X_train_new[:, 0], X_train_new[:, 1], c=y_train_new, cmap='viridis', s=50, alpha=0.8, edgecolors='k')
plt.scatter(X_test_new[:, 0], X_test_new[:, 1], c=y_test_new, cmap='viridis', s=100, alpha=0.3, marker='s')
plt.title('Dataset with 2 Classes')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.legend(['Training Data', 'Testing Data'])
plt.colorbar(label='Class Label')
plt.show()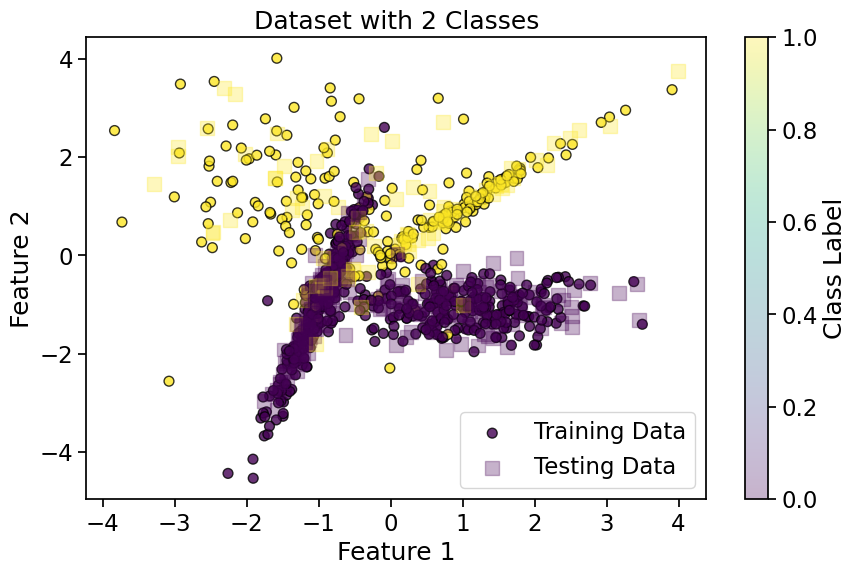
Source
# Train a kNN classifier with probability estimates
from sklearn.neighbors import KNeighborsClassifier
knn_prob = KNeighborsClassifier(n_neighbors=5, weights='distance')
knn_prob.fit(X_train_new, y_train_new)

# Get probability estimates
y_proba = knn_prob.predict_proba(X_test_new)[:, 1]
نمونهٔ این مثال sklearn دربارهٔ weights در kNN را ببینید
Source
fig, axes = plt.subplots(2, 3, figsize=(10, 5))
axes = axes.flatten()
axes[0].scatter(X_test_new[:, 0], X_test_new[:, 1], c=y_test_new, cmap='viridis', s=100, alpha=0.3, marker='s')
axes[0].set_title('Test Points')
axes[0].axis('off')

# Calculate precision and recall for different thresholds
thresholds = [0, 0.1, 0.5, 0.9, 1]
precisions = []
recalls = []
f1_scores = []
i = 1
for threshold in thresholds:
    y_pred_threshold = (y_proba >= threshold).astype(int)
    precisions.append(precision_score(y_test_new, y_pred_threshold, zero_division=1))
    recalls.append(recall_score(y_test_new, y_pred_threshold, zero_division=0))
    f1_scores.append(f1_score(y_test_new, y_pred_threshold, zero_division=0))
#     if threshold in [0,thresholds[len(thresholds)//2],1.0]:
    axes[i].scatter(X_test_new[:, 0], X_test_new[:, 1], c=y_pred_threshold, cmap='viridis',
        vmin=0, vmax=1, s=100, alpha=0.3, marker='s')
    axes[i].set_title(f'Threshold={threshold:.2f}')
    # axes[i].set_xlabel('Feature 1')
    # axes[i].set_ylabel('Feature 2')
    axes[i].axis('off')

    i += 1

plt.tight_layout()
plt.show()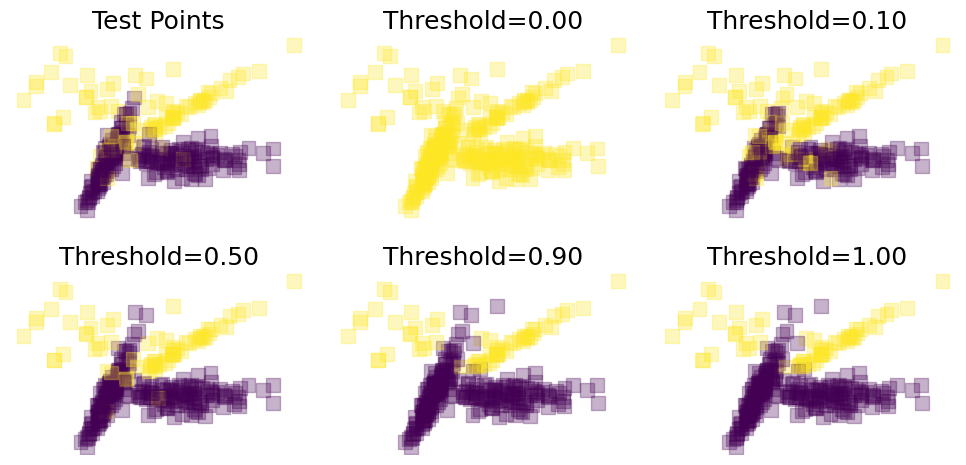
Source
# Plot precision-recall trade-off
plt.figure(figsize=(12, 6))

plt.subplot(1, 2, 1)
plt.plot(thresholds, precisions, 'b-', label='Precision')
plt.plot(thresholds, recalls, 'r-', label='Recall')
plt.plot(thresholds, f1_scores, 'g-', label='F1-Score')
plt.xlabel('Threshold')
plt.ylabel('Score')
plt.title('Precision, Recall, and F1-Score vs. Threshold')
plt.legend()
plt.grid(True)

plt.subplot(1, 2, 2)
plt.plot(recalls, precisions, 'b-')
plt.xlabel('Recall')
plt.ylabel('Precision')
plt.title('Precision-Recall Curve')
plt.grid(True)

plt.tight_layout()
plt.show()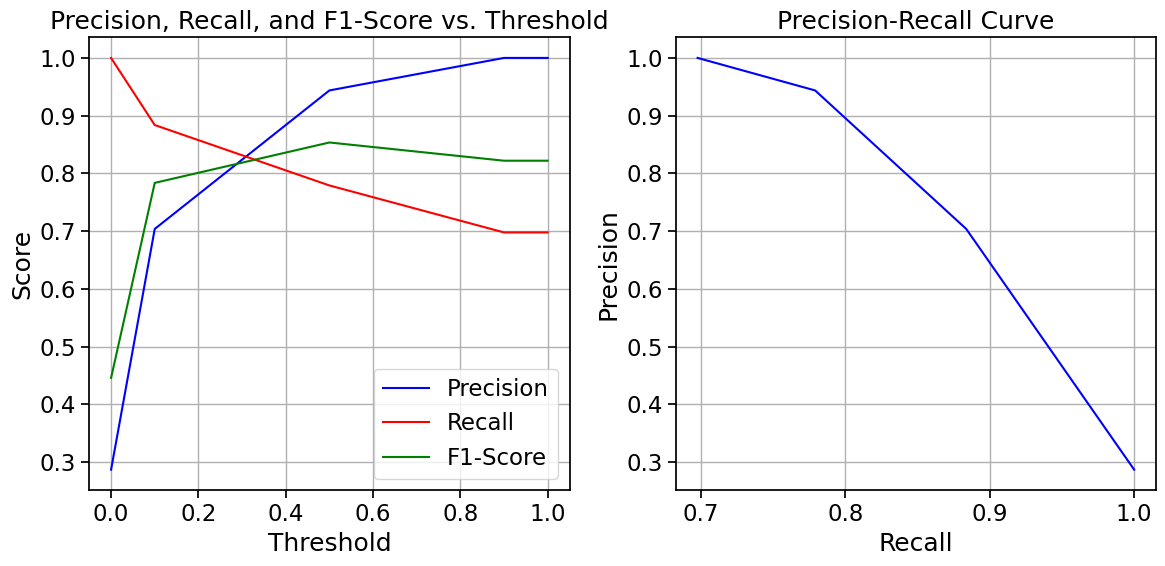
انتخاب سنجهٔ درست
انتخاب سنجهٔ ارزیابی به مسئلهٔ مشخص و هزینهٔ نسبی انواع خطا بستگی دارد:
دقت: وقتی کلاسها متوازناند و همهٔ انواع خطا هزینهٔ مشابه دارند
دقت مثبت: وقتی مثبتهای نادرست گرانترند (مثلاً تشخیص هرزنامه)
بازیابی: وقتی منفیهای نادرست گرانترند (مثلاً تشخیص بیماری)
امتیاز F1: وقتی به توازنی میان دقت مثبت و بازیابی نیاز دارید
مطالعهٔ بیشتر
سنجهها برای دستهبندی چندکلاسه
برای مسائل چندکلاسه این سنجهها را با راهبردهای میانگینگیری گوناگون میتوان گسترد:
میانگین ماکرو: سنجه را برای هر کلاس حساب کن و میانگین بگیر (همهٔ کلاسها برابر)
میانگین میکرو: سنجه را با مجموع مثبتهای درست، مثبتهای نادرست و… حساب کن (سوگرفته به کلاسهای بزرگتر)
میانگین وزنی: سنجه را برای هر کلاس حساب کن و بر پایهٔ فراوانی کلاس وزن بده
Source
# Multi-class metrics example
# Using the original multi-class dataset
knn_multi = KNeighborsClassifier(n_neighbors=5)
knn_multi.fit(X_train, y_train)
y_pred_multi = knn_multi.predict(X_test)

# Calculate metrics with different averaging strategies
precision_macro = precision_score(y_test, y_pred_multi, average='macro')
precision_micro = precision_score(y_test, y_pred_multi, average='micro')
precision_weighted = precision_score(y_test, y_pred_multi, average='weighted')

recall_macro = recall_score(y_test, y_pred_multi, average='macro')
recall_micro = recall_score(y_test, y_pred_multi, average='micro')
recall_weighted = recall_score(y_test, y_pred_multi, average='weighted')

f1_macro = f1_score(y_test, y_pred_multi, average='macro')
f1_micro = f1_score(y_test, y_pred_multi, average='micro')
f1_weighted = f1_score(y_test, y_pred_multi, average='weighted')

# Display results in a table
metrics_df = pd.DataFrame({
    'Macro': [precision_macro, recall_macro, f1_macro],
    'Micro': [precision_micro, recall_micro, f1_micro],
    'Weighted': [precision_weighted, recall_weighted, f1_weighted]
}, index=['Precision', 'Recall', 'F1-Score'])

print("Multi-class Classification Metrics:")
print(metrics_df.round(4))
Multi-class Classification Metrics:
Macro Micro Weighted
Precision 0.9652 0.9667 0.9677
Recall 0.9648 0.9667 0.9667
F1-Score 0.9645 0.9667 0.9666
خلاصه
در این نوتبوک پوشش دادیم:
k نزدیکترین همسایه (kNN):
الگوریتمی ناپارامتری و نمونهمحور
از سنجههای فاصله برای یافتن k نمونهٔ آموزشی نزدیکتر بهره میبرد
پیشبینی را بر پایهٔ رأی اکثریت انجام میدهد
انتخاب k پیچیدگی مرزهای تصمیم را تعیین میکند
سنجههای ارزیابی دستهبندی:
ماتریس درهمریختگی: جدولی از شمار مثبت/منفیهای درست و نادرست
دقت: نسبت پیشبینیهای درست
دقت مثبت: نسبت مثبتهای درست میان مثبتهای پیشبینیشده
بازیابی: نسبت مثبتهای درست میان مثبتهای واقعی
امتیاز F1: میانگین هارمونیک دقت مثبت و بازیابی
بدهبستان دقت مثبت و بازیابی: تغییر آستانهٔ تصمیم هر دو را عوض میکند
این مفاهیم پایهٔ فهم الگوریتمهای دستهبندی و ارزیابی کاراییشان را میسازند. در نوتبوک بعد نمودارهای ورونوی و پیوندشان با kNN و نظریهٔ تصمیم بیزی را میبینیم.
تمرینها
از ماتریس درهمریختگی نوتبوک، دقت مثبت، بازیابی و را برای هر کلاس، هم دستی و هم با
sklearnحساب کنید و هر تفاوت میان میانگین میکرو و ماکرو را توضیح دهید.دستهبندی که روی یک تقسیم ۹۵/۵ همیشه کلاس اکثریت را پیشبینی میکند به دقت میرسد. دقت مثبت، بازیابی و آن را برای کلاس اقلیت حساب کنید و بگویید یک سنجهٔ سودمند باید چه چیزی گزارش کند.
kNN را با فاصلهٔ و پیاده کنید و هر دو را روی مجموعهدادهای با چند دادهپرته مقایسه کنید. کدام سنجه اینجا استوارتر است و چرا؟
نشان دهید چرا kNN هزینهٔ آموزش ندارد ولی هزینهٔ پیشبینیاش در خطی است، و تعداد محاسبهٔ فاصله را برای ، و برآورد کنید.
منابع
Duda, R. O., Hart, P. E., & Stork, D. G. (2001). Pattern Classification (2nd ed.). Wiley-Interscience.