k نزدیکترین همسایه و سنجههای ارزیابی دستهبندی
این نوتبوک شامل اینها است:
مرور الگوریتم k نزدیکترین همسایه (kNN)
سنجههای ارزیابی دستهبندی: دقت، دقتِ مثبت (precision)، بازآوری و F1
Notebook Cell
# Import necessary libraries
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd
from sklearn.datasets import make_classification, make_blobs
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay
import seaborn as sns

# Set plotting style
# plt.style.use('seaborn-whitegrid')
sns.set_context("notebook", font_scale=1.5)
مرور k نزدیکترین همسایه (kNN)
الگوریتم k نزدیکترین همسایه روشی ناپارامتری و نمونهمحور است که برای دستهبندی و رگرسیون به کار میرود. الگوریتم k نمونهٔ آموزش نزدیکتر به نمونهٔ تازه را مییابد و برچسب دسته را با رأی اکثریت پیشبینی میکند.
ویژگیهای کلیدی kNN:
ناپارامتری: الگوریتم دربارهٔ توزیع زیربنایی داده فرضی نمیگذارد.
نمونهمحور (یادگیری تنبل): مرحلهٔ آموزش مشخصی ندارد؛ مدل فقط دادهٔ آموزش را ذخیره میکند.
فاصلهمحور: پیشبینی بر پایهٔ فاصلهٔ میان نقطهها انجام میشود.
الگوریتم kNN:
همهٔ نمونههای آموزش را با برچسب دستهٔ آنها ذخیره کن.
برای نمونهٔ تازهٔ x:
فاصلهٔ x را با همهٔ نمونههای آموزش حساب کن.
k نمونهٔ آموزش نزدیکتر (k نزدیکترین همسایه) را انتخاب کن.
برچسب دسته را بر پایهٔ رأی اکثریت میان k همسایه تعیین کن.
سنجههای فاصله:
رایجترین سنجههای فاصله در kNN اینها هستند:
فاصلهٔ اقلیدسی:
فاصلهٔ منهتن:
فاصلهٔ مینکوفسکی:
بیایید الگوریتم kNN را پیاده و تجسم کنیم:
# Generate a simple dataset
X, y = make_blobs(n_samples=300, centers=3, random_state=42, cluster_std=3)
Source
# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# Visualize the dataset
plt.figure(figsize=(10, 6))
plt.scatter(X_train[:, 0], X_train[:, 1], c=y_train, cmap='viridis', s=50, alpha=0.8, edgecolors='k')
plt.scatter(X_test[:, 0], X_test[:, 1], c=y_test, cmap='viridis', s=100, alpha=0.3, marker='s')
plt.title('Dataset with 3 Classes')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.legend(['Training Data', 'Testing Data'])
plt.colorbar(label='Class Label')
plt.show()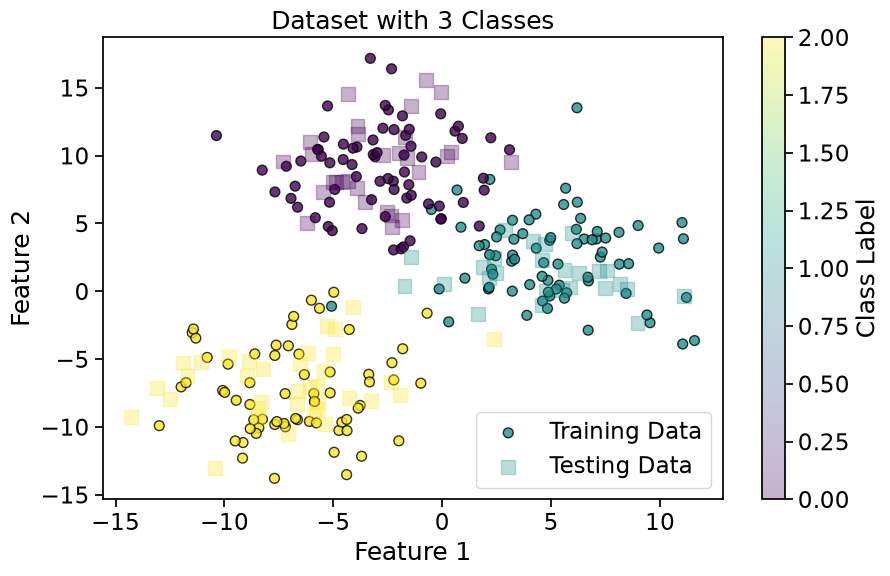
Source
# Implement kNN with different values of k
k_values = [1, 5, 15]
fig, axes = plt.subplots(1, 3, figsize=(15, 5))
axes = axes.flatten()

# Create a meshgrid for decision boundary visualization
h = 0.5  # Step size in the mesh
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, h), np.arange(y_min, y_max, h))

for i, k in enumerate(k_values):
    # Train kNN classifier
    knn = KNeighborsClassifier(n_neighbors=k)
    knn.fit(X_train, y_train)

    # Predict on the meshgrid
    Z = knn.predict(np.c_[xx.ravel(), yy.ravel()])
    Z = Z.reshape(xx.shape)

    # Plot decision boundaries
    axes[i].contourf(xx, yy, Z, alpha=0.3, cmap='viridis')
    axes[i].scatter(X_train[:, 0], X_train[:, 1], c=y_train, cmap='viridis', s=50, edgecolors='k')
    axes[i].scatter(X_test[:, 0], X_test[:, 1], c=y_test, cmap='viridis', s=100, alpha=0.3, marker='s')
    axes[i].set_title(f'kNN with k={k}')
    axes[i].set_xlabel('Feature 1')
    axes[i].set_ylabel('Feature 2')

    # Calculate and display accuracy
    y_pred = knn.predict(X_test)
    accuracy = accuracy_score(y_test, y_pred)
    axes[i].text(0.05, 0.95, f'Accuracy: {accuracy:.2f}', transform=axes[i].transAxes,
                 bbox=dict(facecolor='white', alpha=0.8))

plt.tight_layout()
plt.show()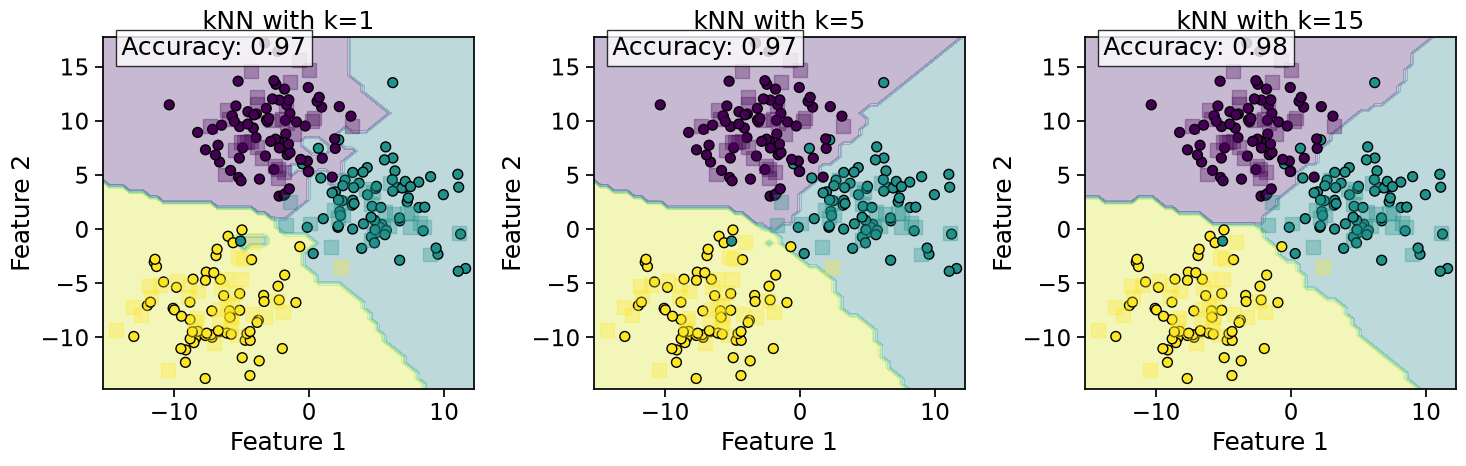
مشاهداتی دربارهٔ رفتار kNN:
اثر k:
k کوچک: مرزهای تصمیم پیچیدهترند و میتوانند به بیشبرازش بینجامند
k بزرگ: مرزهای تصمیم نرمترند ولی ممکن است الگوهای مهم را از دست بدهند
پیچیدگی محاسباتی:
آموزش: O(1) — فقط داده ذخیره میشود
پیشبینی: O(nd) که n تعداد نمونههای آموزش و d تعداد ویژگیها است
نفرین ابعاد:
با زیاد شدن ابعاد، سنجهٔ فاصله کممعناتر میشود
در ابعاد بالا همهٔ نقطهها گرایش دارند از هم همفاصله باشند
سنجههای ارزیابی دستهبندی
برای ارزیابی کارکرد مدلهای دستهبندی به سنجههای مناسب نیاز داریم. انتخاب سنجه به زمینهٔ مسئله و اهمیت نسبی انواع خطا بستگی دارد.
ماتریس درهمریختگی
ماتریس درهمریختگی جدولی است که کارکرد یک مدل دستهبندی را توصیف میکند. برای مسئلهٔ دستهبندی دودویی شامل اینها است:
مثبتهای درست (TP): موارد مثبتی که درست پیشبینی شدهاند
مثبتهای نادرست (FP): موارد مثبتی که نادرست پیشبینی شدهاند (خطای نوع اول)
منفیهای درست (TN): موارد منفی که درست پیشبینی شدهاند
منفیهای نادرست (FN): موارد منفی که نادرست پیشبینی شدهاند (خطای نوع دوم)
بیایید با make_classification
یک مسئلهٔ دستهبندی دودویی بسازیم و ماتریس درهمریختگی آن را تجسم کنیم:
# Generate a binary classification dataset
X_binary, y_binary = make_classification(n_samples=1000, n_features=2, n_informative=2,
                                         n_redundant=0, n_clusters_per_class=1, random_state=42)
Source
# Split the data
X_train_bin, X_test_bin, y_train_bin, y_test_bin = train_test_split(X_binary, y_binary,
                                                                     test_size=0.3, random_state=42)
# Visualize the dataset
plt.figure(figsize=(10, 6))
plt.scatter(X_train_bin[:, 0], X_train_bin[:, 1], c=y_train_bin, cmap='viridis', s=50, alpha=0.8, edgecolors='k')
plt.scatter(X_test_bin[:, 0], X_test_bin[:, 1], c=y_test_bin, cmap='viridis', s=100, alpha=0.3, marker='s')
plt.title('Dataset with 2 Classes')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.legend(['Training Data', 'Testing Data'])
plt.colorbar(label='Class Label')
plt.show()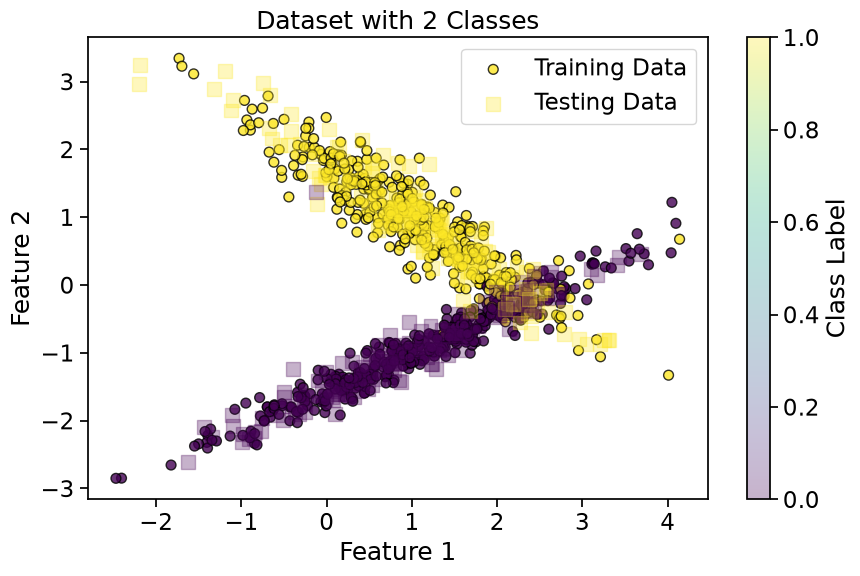
Source
# Train a kNN classifier
knn_binary = KNeighborsClassifier(n_neighbors=5)
knn_binary.fit(X_train_bin, y_train_bin)
y_pred_bin = knn_binary.predict(X_test_bin)

# Create and display the confusion matrix
cm = confusion_matrix(y_test_bin, y_pred_bin)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=['Class 0', 'Class 1'])

fig, ax = plt.subplots(figsize=(8, 4))
disp.plot(ax=ax, cmap='Blues', values_format='d')
plt.title('Confusion Matrix for Binary Classification')
plt.show()

# Extract values from confusion matrix
tn, fp, fn, tp = cm.ravel()
print(f"True Negatives (TN): {tn}")
print(f"False Positives (FP): {fp}")
print(f"False Negatives (FN): {fn}")
print(f"True Positives (TP): {tp}")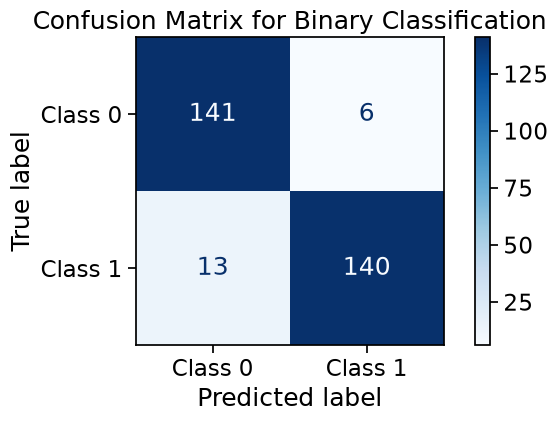
True Negatives (TN): 141
False Positives (FP): 6
False Negatives (FN): 13
True Positives (TP): 140
دقت
دقت نسبت نمونههای درستپیشبینیشده به کل نمونهها است.
مزایا:
ساده و شهودی
برای مجموعهدادههای متوازن خوب کار میکند
معایب:
برای مجموعهدادههای نامتوازن گمراهکننده است
میان انواع خطا تمایز نمیگذارد
# Calculate accuracy
acc = accuracy_score(y_test_bin, y_pred_bin)
print(f"Accuracy: {acc:.4f}")

# Manual calculation
acc_manual = (tp + tn) / (tp + tn + fp + fn)
print(f"Manually calculated accuracy: {acc_manual:.4f}")
Accuracy: 0.9367
Manually calculated accuracy: 0.9367
دقتِ مثبت و بازآوری
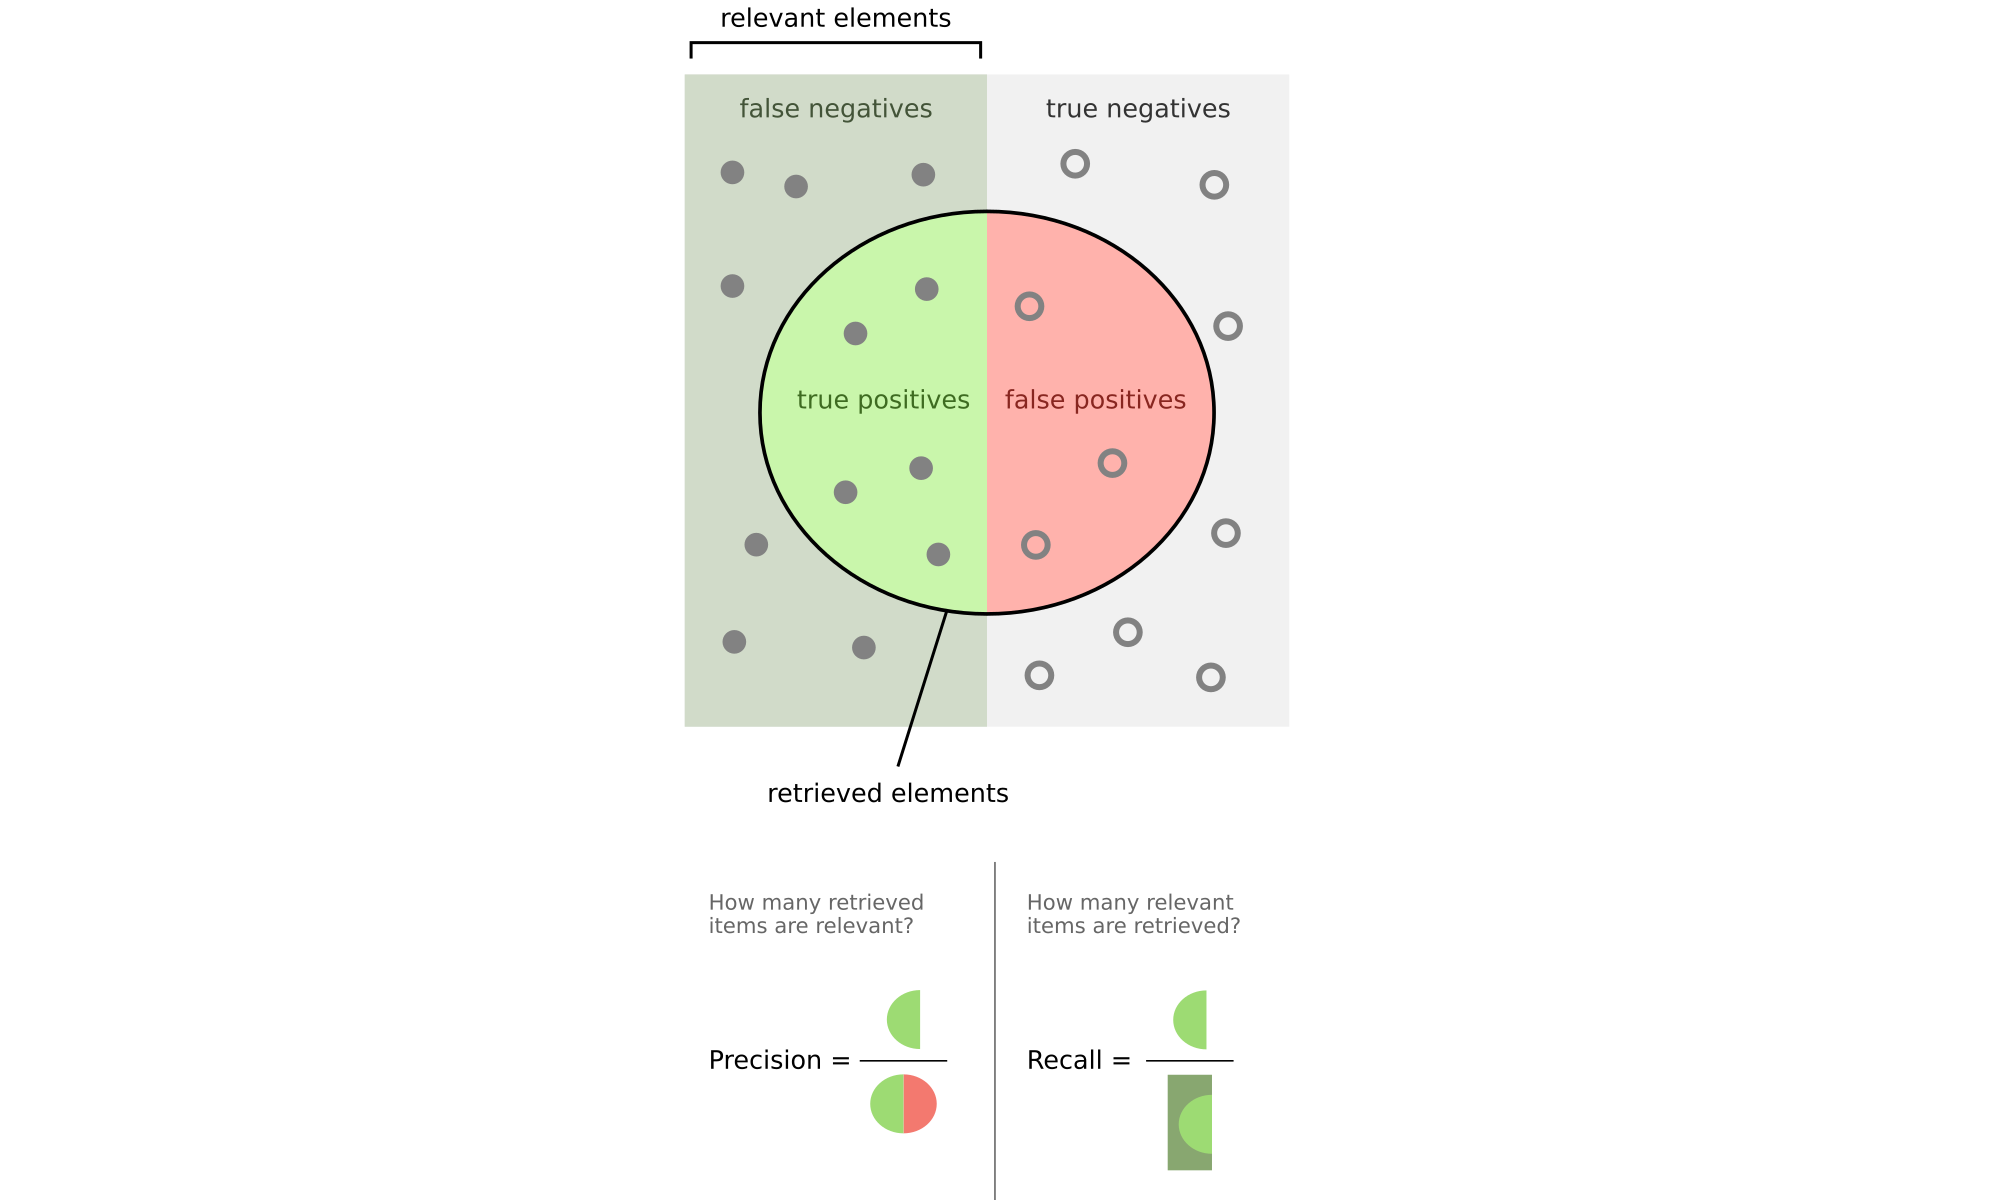
دقتِ مثبت (precision)
دقتِ مثبت نسبت مشاهدات مثبتِ درستپیشبینیشده به کل موارد مثبتِ پیشبینیشده است. به این پرسش پاسخ میدهد: «از همهٔ نمونههایی که مثبت پیشبینی شدند، چند تا واقعاً مثبتاند؟»
کاربردها و مثالهای کلیدی:
تشخیص هرزنامه — پرچمزدن نادرست روی ایمیلهای مهم گران است
آزمون پزشکی — پرهیز از تشخیص نادرستی که به درمان بیمورد میانجامد
خودروهای خودران — تشخیص نادرست مانع میتواند واکنش خطرناک بسازد
مزایا:
وقتی مثبتهای نادرست (FP) پیامد سنگین دارند حیاتی است
برای کاربردهایی که در آنها پیشبینی مثبتِ نادرست گران است ضروری است
بهویژه در سامانههای بازیابی اطلاعات که مربوطبودن کلید است ارزشمند است
معایب:
منفیهای نادرست را نادیده میگیرد (ممکن است موارد مهم را از دست بدهد)
اگر مدل در پیشبینی بیش از حد محافظهکار باشد، میتواند بهطور گمراهکننده بالا باشد
برای مجموعهدادههای نامتوازن که منفیها غالباند بهتنهایی کافی نیست
# Calculate precision
prec = precision_score(y_test_bin, y_pred_bin)
print(f"Precision: {prec:.4f}")

# Manual calculation
prec_manual = tp / (tp + fp) if (tp + fp) > 0 else 0
print(f"Manually calculated precision: {prec_manual:.4f}")
Precision: 0.9589
Manually calculated precision: 0.9589
بازآوری (حساسیت)
بازآوری نسبت مشاهدات مثبتِ درستپیشبینیشده به همهٔ موارد مثبتِ واقعی است. به این پرسش پاسخ میدهد: «از همهٔ نمونههای مثبتِ واقعی، چند تا را درست پیشبینی کردیم؟»
کاربردها و مثالهای کلیدی:
تشخیص پزشکی
تشخیص تقلب
تشخیص مین زمینی
پایش امنیتی
سامانههای هشدار زودهنگام زمینلرزه
تشخیص تهدید امنیت سایبری
عملیات جستوجو و نجات
مزایا:
وقتی هزینهٔ منفیهای نادرست (FN) بالا است حیاتی است (مثلاً موقعیتهای تهدیدکنندهٔ جان).
برای غربالگری پزشکی و کاربردهای ایمنی عمومی ضروری است.
معایب:
مثبتهای نادرست (FP) را در نظر نمیگیرد (میتواند به هشدارهای بیمورد بینجامد).
اگر مدل همهچیز را مثبت برچسب بزند، میتواند بهطور مصنوعی بالا برود.
نکتهٔ مبادله: در بسیاری از سامانههای واقعی رابطهٔ معکوسی میان دقتِ مثبت و بازآوری هست — بهبود یکی معمولاً دیگری را بدتر میکند. توازن درست به این بستگی دارد که کدام نوع خطا (FP یا FN) برای کاربرد شما گرانتر است.
# Calculate recall
rec = recall_score(y_test_bin, y_pred_bin)
print(f"Recall: {rec:.4f}")

# Manual calculation
rec_manual = tp / (tp + fn) if (tp + fn) > 0 else 0
print(f"Manually calculated recall: {rec_manual:.4f}")
Recall: 0.9150
Manually calculated recall: 0.9150
امتیاز F1
امتیاز F1 میانگین هارمونیک دقتِ مثبت و بازآوری است. توازنی میان این دو میسازد.
مزایا:
دقتِ مثبت و بازآوری را متوازن میکند
برای مجموعهدادههای نامتوازن خوب کار میکند
معایب:
اگر یکی از سنجهها مهمتر از دیگری باشد، ممکن است مناسب نباشد
منفیهای درست را در نظر نمیگیرد
# Calculate F1-score
f1 = f1_score(y_test_bin, y_pred_bin)
print(f"F1-Score: {f1:.4f}")

# Manual calculation
f1_manual = 2 * (prec_manual * rec_manual) / (prec_manual + rec_manual) if (prec_manual + rec_manual) > 0 else 0
print(f"Manually calculated F1-Score: {f1_manual:.4f}")
F1-Score: 0.9365
Manually calculated F1-Score: 0.9365
مبادلهٔ دقتِ مثبت و بازآوری
اغلب میان دقتِ مثبت و بازآوری مبادلهای هست. بالا بردن یکی معمولاً دیگری را کم میکند.
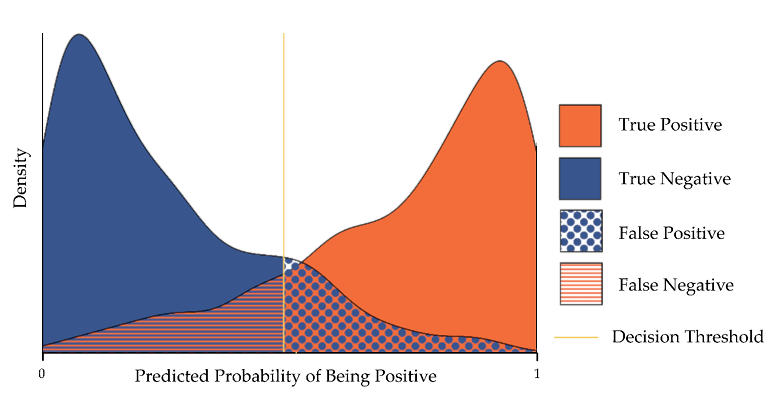
بیایید این مبادله را با تغییر آستانهٔ تصمیم یک دستهبند احتمالاتی تجسم کنیم:
# Generate a new dataset
X_new, y_new = make_classification(n_samples=1000, n_features=2, n_informative=2, n_clusters_per_class=2,
                                   n_redundant=0, random_state=42, weights=[0.7, 0.3])
# Split the data
X_train_new, X_test_new, y_train_new, y_test_new = train_test_split(X_new, y_new,
test_size=0.3, random_state=42)
# Visualize the dataset
plt.figure(figsize=(10, 6))
plt.scatter(X_train_new[:, 0], X_train_new[:, 1], c=y_train_new, cmap='viridis', s=50, alpha=0.8, edgecolors='k')
plt.scatter(X_test_new[:, 0], X_test_new[:, 1], c=y_test_new, cmap='viridis', s=100, alpha=0.3, marker='s')
plt.title('Dataset with 2 Classes')
plt.xlabel('Feature 1')
plt.ylabel('Feature 2')
plt.legend(['Training Data', 'Testing Data'])
plt.colorbar(label='Class Label')
plt.show()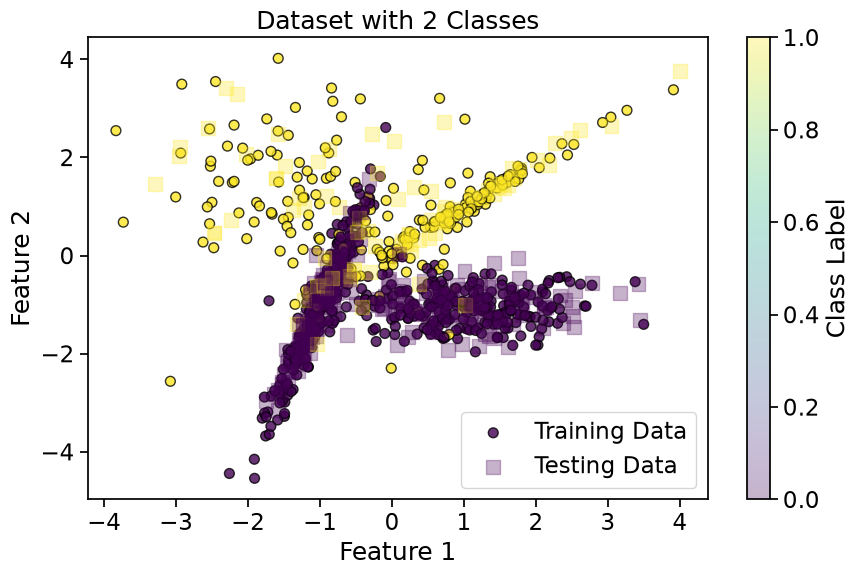
Source
# Train a kNN classifier with probability estimates
from sklearn.neighbors import KNeighborsClassifier
knn_prob = KNeighborsClassifier(n_neighbors=5, weights='distance')
knn_prob.fit(X_train_new, y_train_new)

# Get probability estimates
y_proba = knn_prob.predict_proba(X_test_new)[:, 1]
این مثال sklearn
دربارهٔ weights در kNN را ببینید
Source
fig, axes = plt.subplots(2, 3, figsize=(10, 5))
axes = axes.flatten()
axes[0].scatter(X_test_new[:, 0], X_test_new[:, 1], c=y_test_new, cmap='viridis', s=100, alpha=0.3, marker='s')
axes[0].set_title('Test Points')
axes[0].axis('off')

# Calculate precision and recall for different thresholds
thresholds = [0, 0.1, 0.5, 0.9, 1]
precisions = []
recalls = []
f1_scores = []
i = 1
for threshold in thresholds:
    y_pred_threshold = (y_proba >= threshold).astype(int)
    precisions.append(precision_score(y_test_new, y_pred_threshold, zero_division=1))
    recalls.append(recall_score(y_test_new, y_pred_threshold, zero_division=0))
    f1_scores.append(f1_score(y_test_new, y_pred_threshold, zero_division=0))
#     if threshold in [0,thresholds[len(thresholds)//2],1.0]:
    axes[i].scatter(X_test_new[:, 0], X_test_new[:, 1], c=y_pred_threshold, cmap='viridis',
        vmin=0, vmax=1, s=100, alpha=0.3, marker='s')
    axes[i].set_title(f'Threshold={threshold:.2f}')
    # axes[i].set_xlabel('Feature 1')
    # axes[i].set_ylabel('Feature 2')
    axes[i].axis('off')

    i += 1

plt.tight_layout()
plt.show()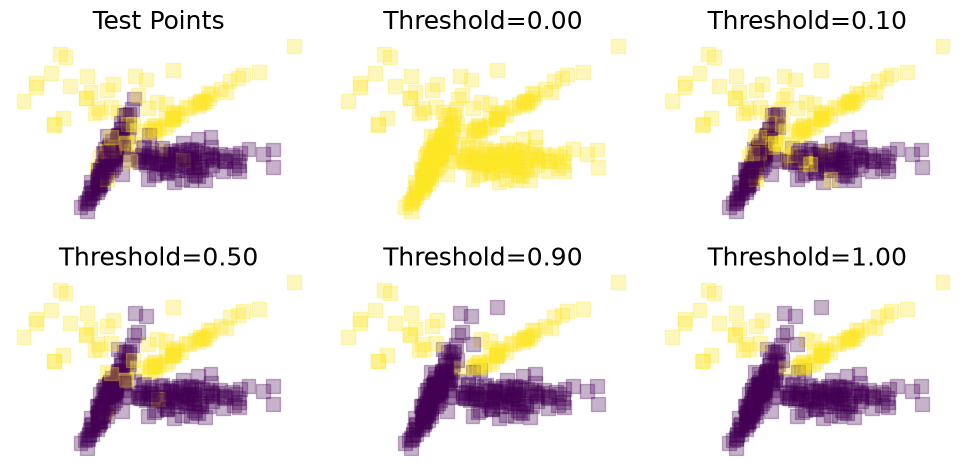
Source
# Plot precision-recall trade-off
plt.figure(figsize=(12, 6))

plt.subplot(1, 2, 1)
plt.plot(thresholds, precisions, 'b-', label='Precision')
plt.plot(thresholds, recalls, 'r-', label='Recall')
plt.plot(thresholds, f1_scores, 'g-', label='F1-Score')
plt.xlabel('Threshold')
plt.ylabel('Score')
plt.title('Precision, Recall, and F1-Score vs. Threshold')
plt.legend()
plt.grid(True)

plt.subplot(1, 2, 2)
plt.plot(recalls, precisions, 'b-')
plt.xlabel('Recall')
plt.ylabel('Precision')
plt.title('Precision-Recall Curve')
plt.grid(True)

for i, threshold in enumerate(thresholds):
    plt.annotate(f'{threshold:.1f}',
                 (recalls[i], precisions[i]),
                 textcoords="offset points",
                 xytext=(0, 10),
                 ha='center',
                 fontsize=9)
plt.grid(True)

plt.tight_layout()
plt.show()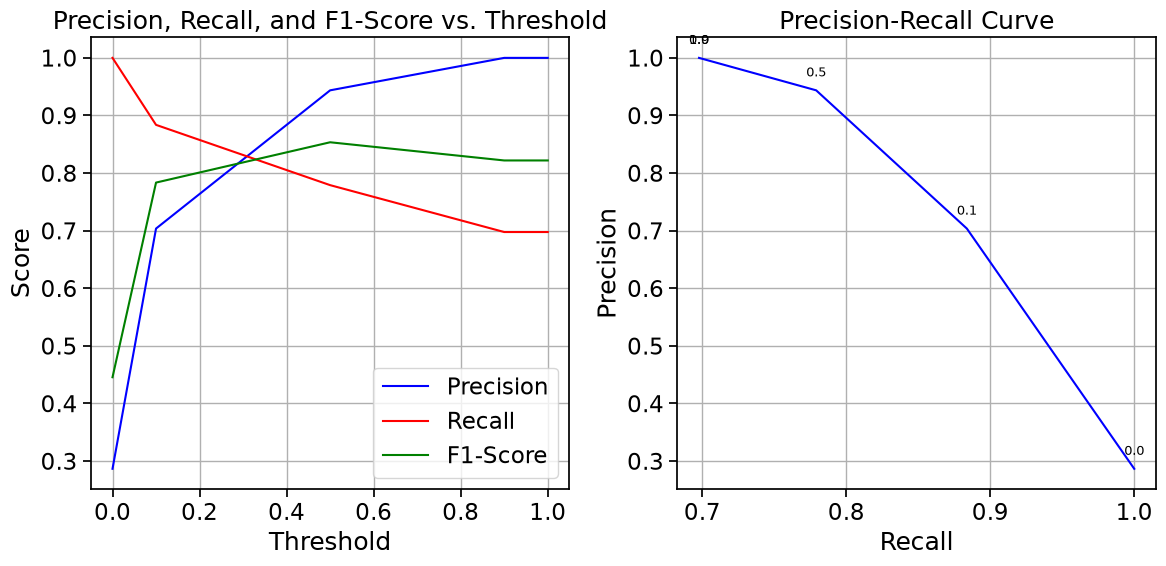
انتخاب سنجهٔ درست
انتخاب سنجهٔ ارزیابی به مسئلهٔ مشخص و هزینههای نسبی انواع خطا بستگی دارد:
دقت: وقتی دستهها متوازناند و همهٔ انواع خطا هزینهٔ مشابه دارند
دقتِ مثبت: وقتی مثبتهای نادرست گرانترند (مثلاً تشخیص هرزنامه)
بازآوری: وقتی منفیهای نادرست گرانترند (مثلاً تشخیص بیماری)
امتیاز F1: وقتی به توازنی میان دقتِ مثبت و بازآوری نیاز دارید
آیا «نقطهٔ بهینه» روی منحنی دقتِ مثبت–بازآوری وجود دارد؟
پاسخ کوتاه: نه، یک نقطهٔ بهینهٔ یکتا و جهانی روی منحنی دقتِ مثبت–بازآوری وجود ندارد. ولی مفهوم «نقطهٔ بهینه» را میتوان به چند معنای معنادار و وابسته به زمینهٔ مسئله تعریف کرد.
چرا نقطهٔ بهینهٔ مطلق وجود ندارد
1. ماهیت مبادله
هر نقطه روی منحنی دقتِ مثبت–بازآوری به یک آستانهٔ تصمیم متفاوت متناظر است. با حرکت روی منحنی:
بالا بردن آستانه دقتِ مثبت را زیاد و بازآوری را کم میکند.
پایین آوردن آستانه بازآوری را زیاد و دقتِ مثبت را کم میکند.
پس هر نقطه توازنی متفاوت میان این دو سنجه است و هیچ نقطهای همزمان هر دو را بیشینه نمیکند (مگر حالت آرمانی که منحنی به گوشهٔ بالا-راست میرسد).
2. وابستگی به هزینهٔ خطا
«بهینه» با هزینهٔ نسبی مثبتهای نادرست در برابر منفیهای نادرست در کاربرد دادهشده تعریف میشود:
اگر FP گرانتر باشد (مثلاً تشخیص هرزنامه)، نقطهای با دقتِ مثبت بالا بهینه است.
اگر FN گرانتر باشد (مثلاً تشخیص سرطان)، نقطهای با بازآوری بالا بهینه است.
اگر هزینهها متوازن باشند، نقطهای که امتیاز F1 را بیشینه میکند انتخاب معقولی است.
چه چیزی را میتوان «بهینه» دانست؟
1. نقطهای با بالاترین امتیاز F1
این رایجترین معیار انتخاب نقطه روی منحنی است. امتیاز F1 میانگین هارمونیک دقتِ مثبت و بازآوری است و نقطهای که آن را بیشینه میکند توازن معقولی میان این دو میدهد.
با نگاه به نمودار سمت چپ بالا (دقتِ مثبت، بازآوری و F1 در برابر آستانه)، امتیاز F1 (خط سبز) در آستانهٔ مشخصی به قله میرسد. توجه کنید این قله ممکن است در 0.5 نباشد — بهویژه برای مجموعهدادههای نامتوازن، آستانهٔ بهینهٔ F1 اغلب کمتر از 0.5 است (در این مثال حدود 0.29 تا 0.32).
2. نقطهای نزدیکترین به گوشهٔ بالا-راست
در برخی تحلیلها نقطهای با کمترین فاصلهٔ اقلیدسی تا (Precision=1, Recall=1) بهینه انتخاب میشود. این معیار ساده است ولی هزینهٔ واقعی مسئله را نادیده میگیرد.
یافتن آستانهٔ بهینه با یک شبکهٔ متراکم
این کد 100 آستانهٔ یکنواخت میان 0 و 1 را ارزیابی میکند تا آستانهای را بیابد که امتیاز F1 را بیشینه میکند؛ تقریبی ریزدانه از مرز تصمیم بهینه.
thresholds = np.linspace(0, 1, 100)
precisions = []
recalls = []
f1_scores = []
for threshold in thresholds:
    y_pred_threshold = (y_proba >= threshold).astype(int)
    precisions.append(precision_score(y_test_new, y_pred_threshold, zero_division=1))
    recalls.append(recall_score(y_test_new, y_pred_threshold, zero_division=0))
    f1_scores.append(f1_score(y_test_new, y_pred_threshold, zero_division=0))

best_threshold = thresholds[np.argmax(f1_scores)]
best_f1 = max(f1_scores)
print(f"Best threshold: {best_threshold:.2f}, Best F1: {best_f1:.4f}")
Best threshold: 0.29, Best F1: 0.8757
یافتن آستانهٔ بهینه با precision_recall_curve در Scikit-learn
این کد از تابع آمادهٔ precision_recall_curve در Scikit-learn استفاده میکند که دقتِ مثبت و
بازآوری را در هر مقدار احتمال متمایزی که مدل تولید میکند حساب میکند و برآورد دقیقتر و
اصولیتری از آستانهٔ بهینه میدهد.
from sklearn.metrics import precision_recall_curve
precision, recall, thresholds = precision_recall_curve(y_test_new, y_proba)
f1 = 2 * precision * recall / (precision + recall + 1e-10)
best_idx = np.argmax(f1)
print(f"Best threshold: {thresholds[best_idx]:.2f}")
Best threshold: 0.32
چرا نقطهٔ «بهینه»ی دیداری در 0.5 با نتیجهٔ محاسباتی فرق دارد
در نوتبوک اصلی فقط پنج آستانه (0، 0.1، 0.5، 0.9، 1) ارزیابی شده بود. پس نمودار حاصل تقریب بسیار زبری است — فقط پنج نقطه که با خط به هم وصل شدهاند. بهطور دیداری F1 در 0.5 قله میزند فقط چون هیچ آستانهٔ ریزتری میان 0.1 و 0.5 آزموده نشده بود.
وقتی از شبکهٔ متراکمی از آستانهها (مثلاً 100 نقطه با np.linspace) یا از
precision_recall_curve استفاده شود، بیشینهٔ واقعی امتیاز F1 در آستانهٔ پایینتری (حدود 0.29
تا 0.32 در این مثال) پیدا میشود. این برای مجموعهدادههای نامتوازن انتظار میرود:
در آستانهٔ بالا (مثلاً 0.5) مدل فقط وقتی با اطمینان بالاست دستهٔ مثبت را پیشبینی میکند و نتیجه بازآوری کم است.
در آستانهٔ پایینتر (مثلاً 0.3) مدل بیشتر دستهٔ مثبت را پیشبینی میکند و بازآوری را بالا میبرد با هزینهٔ کوچکی در دقتِ مثبت. چون F1 میانگین هارمونیک است، این توازن معمولاً امتیاز F1 بالاتری میدهد.
تفاوت کوچک دو روش (0.29 در برابر 0.32)
دو رویکرد آستانههای بهینهٔ کمی متفاوت مییابند:
روش
np.linspace100 آستانهٔ یکنواخت را ارزیابی میکند و نزدیکترین را برمیگرداند (0.29).روش
precision_recall_curveآستانهها را در هر مقدار احتمال متمایز تولیدشده توسط مدل ارزیابی میکند و برآورد اصولیتری میدهد (0.32).
تفاوت حدود 0.03 ناچیز است و هر دو روش به همان ناحیهٔ بهینه اشاره میکنند. برای گزارش نهایی،
precision_recall_curve عموماً ترجیح دارد چون بر توزیع واقعی احتمالهای پیشبینیشده استوار است و
نه بر یک شبکهٔ دلبخواه.
| معیار | نقطهٔ بهینه |
|---|---|
| بیشینه کردن امتیاز F1 | نقطهای با بالاترین F1 (در این مثال ≈ 0.29–0.32) |
| کمینه کردن هزینهٔ کل | به هزینههای نسبی FP و FN بستگی دارد |
| نزدیکترین به (1, 1) | کمترین فاصلهٔ اقلیدسی تا گوشهٔ بالا-راست |
| بیشترین بازآوری با دقتِ مثبت قابل قبول | آستانهای که دقتِ مثبت را بالای سطح مطلوب نگه میدارد |
به کوتاهی، «نقطهٔ بهینه» مفهومی نسبی است که به معیار انتخاب و هزینهٔ خطاهای مسئلهٔ مشخص بستگی دارد. در این نوتبوک معقولترین انتخاب نقطهای است که امتیاز F1 را بیشینه میکند، یعنی آستانهای حدود 0.3، نه پیشفرض 0.5.
مطالعهٔ بیشتر
سنجهها برای دستهبندی چنددستهای
برای مسائل چنددستهای، این سنجهها را میتوان با راهبردهای میانگینگیری مختلف بسط داد:
میانگین کلان (macro): سنجه را برای هر دسته حساب کن و میانگین بگیر (همهٔ دستهها برابر)
میانگین خرد (micro): سنجه را با مجموع مثبتهای درست، مثبتهای نادرست و … حساب کن (سوگیرانه به سمت دستههای بزرگتر)
میانگین وزنی (weighted): سنجه را برای هر دسته حساب کن و بر پایهٔ فراوانی دسته میانگین وزنی بگیر
مطالعهٔ بیشتر
سنجهها برای دستهبندی چنددستهای
برای مسائل چنددستهای، این سنجهها را میتوان با راهبردهای میانگینگیری مختلف بسط داد:
میانگین کلان (macro): سنجه را برای هر دسته حساب کن و میانگین بگیر (همهٔ دستهها برابر)
میانگین خرد (micro): سنجه را با مجموع مثبتهای درست، مثبتهای نادرست و … حساب کن (سوگیرانه به سمت دستههای بزرگتر)
میانگین وزنی (weighted): سنجه را برای هر دسته حساب کن و بر پایهٔ فراوانی دسته میانگین وزنی بگیر
Source
# Multi-class metrics example
# Using the original multi-class dataset
knn_multi = KNeighborsClassifier(n_neighbors=5)
knn_multi.fit(X_train, y_train)
y_pred_multi = knn_multi.predict(X_test)

# Calculate metrics with different averaging strategies
precision_macro = precision_score(y_test, y_pred_multi, average='macro')
precision_micro = precision_score(y_test, y_pred_multi, average='micro')
precision_weighted = precision_score(y_test, y_pred_multi, average='weighted')

recall_macro = recall_score(y_test, y_pred_multi, average='macro')
recall_micro = recall_score(y_test, y_pred_multi, average='micro')
recall_weighted = recall_score(y_test, y_pred_multi, average='weighted')

f1_macro = f1_score(y_test, y_pred_multi, average='macro')
f1_micro = f1_score(y_test, y_pred_multi, average='micro')
f1_weighted = f1_score(y_test, y_pred_multi, average='weighted')

# Display results in a table
metrics_df = pd.DataFrame({
    'Macro': [precision_macro, recall_macro, f1_macro],
    'Micro': [precision_micro, recall_micro, f1_micro],
    'Weighted': [precision_weighted, recall_weighted, f1_weighted]
}, index=['Precision', 'Recall', 'F1-Score'])

print("Multi-class Classification Metrics:")
print(metrics_df.round(4))
Multi-class Classification Metrics:
Macro Micro Weighted
Precision 0.9652 0.9667 0.9677
Recall 0.9648 0.9667 0.9667
F1-Score 0.9645 0.9667 0.9666
جمعبندی
در این نوتبوک پوشش دادیم:
k نزدیکترین همسایه (kNN):
الگوریتمی ناپارامتری و نمونهمحور
از سنجههای فاصله برای یافتن k نمونهٔ آموزش نزدیکتر استفاده میکند
پیشبینی بر پایهٔ رأی اکثریت
انتخاب k پیچیدگی مرزهای تصمیم را تعیین میکند
سنجههای ارزیابی دستهبندی:
ماتریس درهمریختگی: جدولی از شمار مثبت/منفیهای درست و نادرست
دقت: نسبت پیشبینیهای درست
دقتِ مثبت: نسبت مثبتهای درست میان موارد مثبتِ پیشبینیشده
بازآوری: نسبت مثبتهای درست میان موارد مثبتِ واقعی
امتیاز F1: میانگین هارمونیک دقتِ مثبت و بازآوری
مبادلهٔ دقتِ مثبت–بازآوری: تغییر آستانهٔ تصمیم هر دو را تحت تأثیر میگذارد
این مفاهیم پایهٔ فهم الگوریتمهای دستهبندی و ارزیابی کارکرد آنها هستند. در نوتبوک بعدی نمودارهای ورونوی و پیوندشان با kNN و نظریهٔ تصمیم بیزی را بررسی میکنیم.
منابع
Duda, R. O., Hart, P. E., & Stork, D. G. (2001). Pattern Classification (2nd ed.). Wiley-Interscience.