رگرسیون خطی، بخش 1
در این فصل با مروری سریع بر ریاضیات پشت این مسئلهٔ شناختهشده شروع میکنیم و بعد میبینیم مدلهای خطی چگونه میتوانند به الگوهای پیچیدهتر در داده تعمیم یابند.
با واردکردنهای استاندارد شروع میکنیم:
Source
%matplotlib inline

# Import necessary libraries
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.preprocessing import PolynomialFeatures
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error
from sklearn.pipeline import make_pipeline

# Set plot style
sns.set_style("whitegrid")
plt.rcParams['figure.figsize'] = (12, 8)
رگرسیون خطی ساده
با آشناترین رگرسیون خطی شروع میکنیم: برازش یک خط راست به داده. برازش خط راست مدلی به این شکل است:
که را معمولاً شیب و را عرض از مبدأ مینامند.
دادهٔ زیر را در نظر بگیرید که حول خطی با شیب 2 و عرض از مبدأ −5 پراکنده شده است (شکل زیر):
rng = np.random.RandomState(1)
x = 10 * rng.rand(50)
y = 2 * x - 5 + rng.randn(50)
plt.scatter(x, y);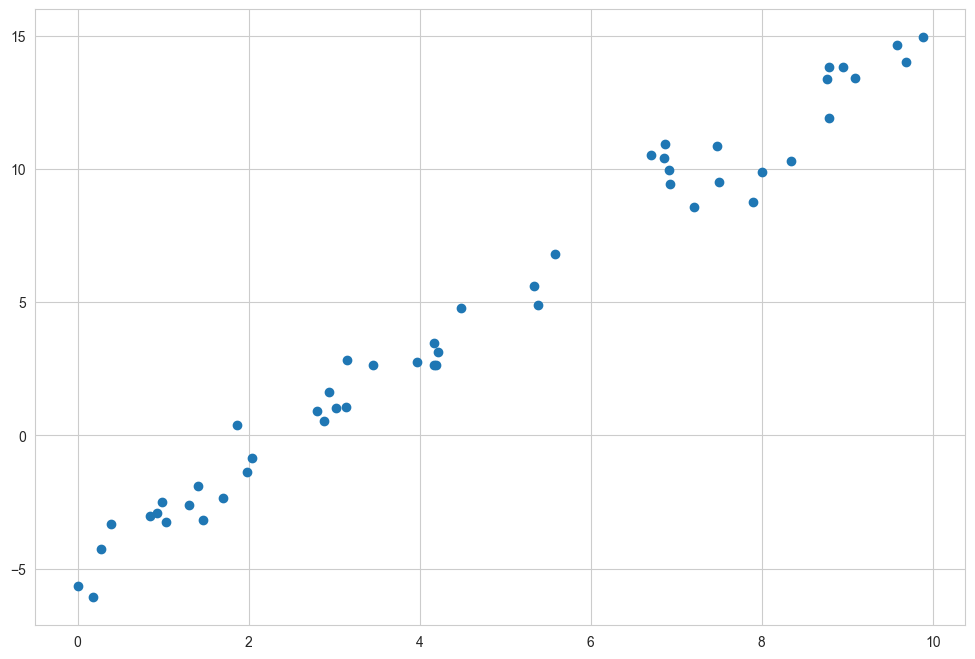
میتوانیم از برآوردگر LinearRegression در Scikit-Learn برای برازش این داده و ساختن خط بهترین
برازش استفاده کنیم، همانطور که در شکل زیر آمده است:
Source
from sklearn.linear_model import LinearRegression
model = LinearRegression(fit_intercept=True)

model.fit(x[:, np.newaxis], y)

xfit = np.linspace(0, 10, 1000)
yfit = model.predict(xfit[:, np.newaxis])

plt.scatter(x, y)
plt.plot(xfit, yfit);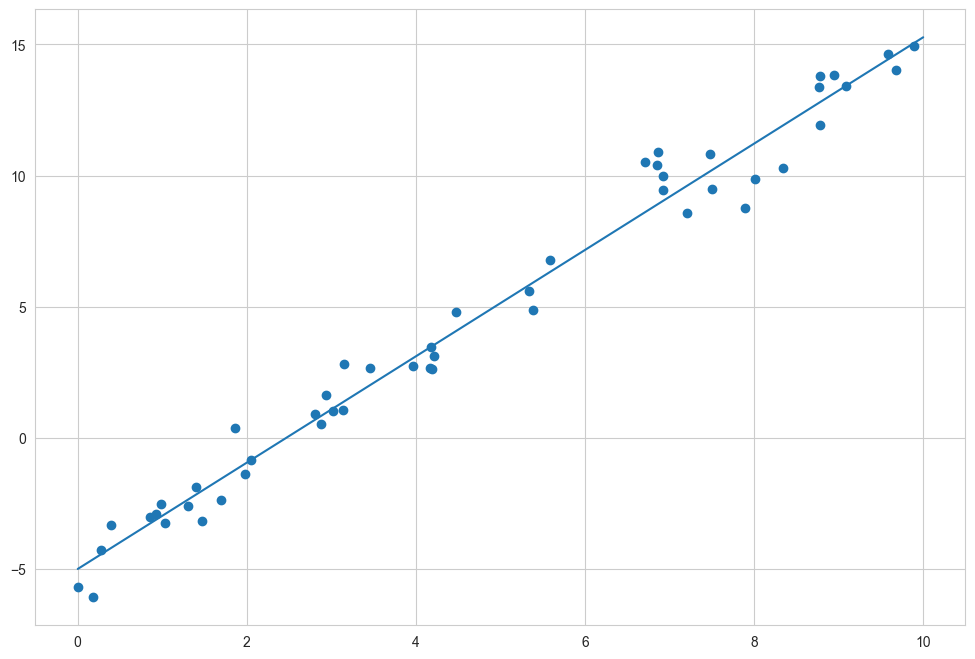
شیب و عرض از مبدأ در پارامترهای برازش مدل قرار دارند که در Scikit-Learn همیشه با زیرخط پایانی
نشانهگذاری میشوند. اینجا پارامترهای مربوطه coef_ و intercept_ هستند:
Source
print("Model slope:    ", model.coef_[0])
print("Model intercept:", model.intercept_)
Model slope: 2.0272088103606944
Model intercept: -4.9985770855532
میبینیم که نتیجهها بسیار نزدیک به مقدارهایی است که داده با آنها تولید شده — همانطور که انتظار داریم.
البته برآوردگر LinearRegression خیلی تواناتر از این است — در کنار برازش سادهٔ خط راست،
مدلهای خطی چندبعدی به این شکل را هم پوشش میدهد:
که در آن چند مقدار داریم. بهطور هندسی، این مانند برازش یک صفحه به نقطههای سهبعدی، یا برازش یک ابرصفحه به نقطههای با ابعاد بالاتر است.
چندبعدی بودن چنین رگرسیونهایی تجسمشان را مشکلتر میکند، ولی میتوانیم یکی از این برازشها را با ساختن دادهٔ نمونه و استفاده از عملگر ضرب ماتریسی NumPy در عمل ببینیم:
rng = np.random.RandomState(1)
X = 10 * rng.rand(100, 3)
y = 0.5 + np.dot(X, [1.5, -2., 1.])

model.fit(X, y)
print(model.intercept_)
print(model.coef_)
0.5000000000000033
[ 1.5 -2. 1. ]
اینجا دادهٔ از ترکیب خطی سه مقدار تصادفی ساخته شده و رگرسیون خطی همان ضریبهایی را که داده با آنها ساخته شده بازیابی میکند.
به این ترتیب میتوانیم با همان برآوردگر LinearRegression خط، صفحه یا ابرصفحه را به داده برازش
دهیم. هنوز به نظر میرسد این رویکرد به رابطههای کاملاً خطی میان متغیرها محدود است، ولی میشود این
قید را هم سست کرد.
رگرسیون چندجملهای
یک شگرد برای سازگار کردن رگرسیون خطی با رابطههای غیرخطی میان متغیرها این است که داده را بر اساس
توابع پایه تبدیل کنیم. یک نسخهٔ این کار را پیشتر در خط لولهٔ PolynomialRegression در صفحههای
ابرپارامترها و اعتبارسنجی مدل و مهندسی ویژگی دیدهایم. ایده این است که مدل خطی چندبعدی خود
را بگیریم و و … را از ورودی یکبعدی بسازیم. یعنی بگذاریم که تابعی تبدیلساز روی داده است.
مثلاً اگر ، مدل ما رگرسیون چندجملهای میشود:
توجه کنید این هنوز یک مدل خطی است — خطیبودن به این معناست که ضریبهای هرگز در هم ضرب یا بر هم تقسیم نمیشوند. کاری که عملاً کردیم این است که مقدارهای یکبعدی را به بُعد بالاتر تصویر کردیم تا یک برازش خطی بتواند رابطههای پیچیدهتر میان و را برازش دهد.
توابع پایهٔ چندجملهای
این تصویر چندجملهای بهقدری سودمند است که در Scikit-Learn با تبدیلگر PolynomialFeatures ساخته
شده است:
from sklearn.preprocessing import PolynomialFeatures
x = np.array([2, 3, 4])
poly = PolynomialFeatures(3, include_bias=False)
poly.fit_transform(x[:, None])
array([[ 2., 4., 8.],
[ 3., 9., 27.],
[ 4., 16., 64.]])اینجا میبینیم تبدیلگر آرایهٔ یکبعدی ما را به آرایهای سهبعدی تبدیل کرده که هر ستونش مقدار بهتوانرسیده را دارد. این نمایش تازه و پرابعادِ داده را میتوان به رگرسیون خطی داد.
همانطور که در مهندسی ویژگی دیدیم، پاکیزهترین راه انجام این کار استفاده از خط لوله است. بیایید اینگونه مدلی چندجملهای با درجهٔ 7 بسازیم:
from sklearn.pipeline import make_pipeline
poly_model = make_pipeline(PolynomialFeatures(7),
                           LinearRegression())
با این تبدیل، میتوانیم از مدل خطی برای برازش رابطههای بسیار پیچیدهتر میان و استفاده کنیم. مثلاً اینجا یک موج سینوسی با نوفه است (شکل زیر):
# rng = np.random.RandomState(1)
# x = 10 * rng.rand(50)
# y = np.sin(x) + 0.1 * rng.randn(50)

n_samples = 100
x = np.sort(np.random.uniform(0, 1, n_samples))
y = np.sin(2 * np.pi * x) + 0.3 * np.random.randn(n_samples)

poly_model.fit(x[:, np.newaxis], y)
yfit = poly_model.predict(x[:, np.newaxis])

plt.scatter(x, y)
plt.plot(x, yfit)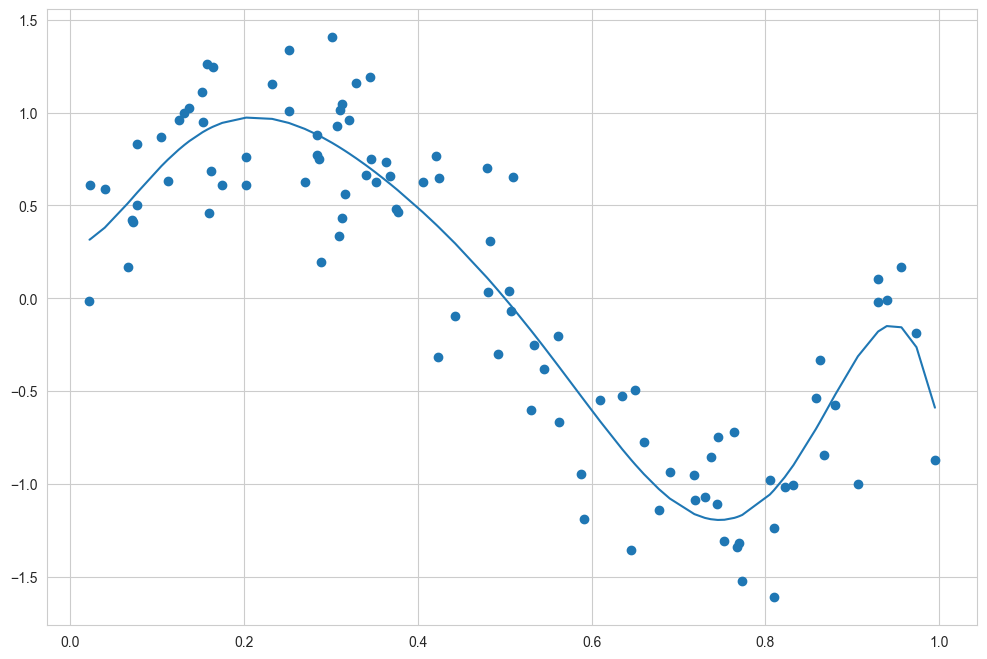
مدل خطی ما، با استفاده از توابع پایهٔ چندجملهای مرتبهٔ هفت، برازش بسیار خوبی به این دادهٔ غیرخطی میدهد!
تنظیمکننده
وارد کردن توابع پایه به رگرسیون خطی مدل را بسیار انعطافپذیر میکند، ولی میتواند خیلی سریع به بیشبرازش بینجامد (برای بحث این موضوع به صفحهٔ ابرپارامترها و اعتبارسنجی مدل نگاه کنید).
مدلهای بسیار انعطافپذیر میتوانند دادهٔ آموزش را با ترکیب اجزای زیادی با ضریبهای بزرگ و مخالف هم برازش کنند و برازشهای ناپایداری بسازند که ممکن است بد تعمیم یابند. این نمود رایج بیشبرازش است. درمان طبیعی این است که مدل را با جریمه کردن مقدارهای بزرگ پارامتر صریحاً مقید کنیم، تا تابع برازششده تشویق نشود به چنین حذفهای ناپایدار تکیه کند. چنین جریمهای تنظیمکننده نامیده میشود و چند شکل دارد.
رگرسیون ریج (تنظیمکنندهٔ )
شاید رایجترین شکل تنظیمکننده رگرسیون ریج یا تنظیمکنندهٔ باشد (که گاهی تنظیمکنندهٔ تیخونوف هم نامیده میشود). این روش مجموع مربعها (نُرمهای 2) ضریبهای مدل را جریمه میکند. در این حالت جریمهٔ برازش مدل چنین است:
که پارامتری آزاد است که قدرت جریمه را کنترل میکند. این نوع مدل جریمهشده در Scikit-Learn
با برآوردگر Ridge ساخته شده است (شکل زیر):
پارامتر اساساً پیچی است که پیچیدگی مدل حاصل را کنترل میکند. در حد نتیجهٔ رگرسیون خطی استاندارد را بازیابی میکنیم؛ در حد همهٔ پاسخهای مدل سرکوب میشوند. یک مزیت ویژهٔ رگرسیون ریج این است که میتوان آن را بسیار کارا حساب کرد — تقریباً بدون هزینهٔ محاسباتی بیشتر از مدل رگرسیون خطی اصلی.
تولید دادهٔ مصنوعی
بیایید دادهٔ مصنوعی بسازیم که الگویی غیرخطی با کمی نوفه را دنبال میکند:
Source
# Set random seed for reproducibility
np.random.seed(42)

# Generate synthetic data
n_samples = 100
X = np.sort(np.random.uniform(0, 1, n_samples))
y = np.sin(2 * np.pi * X) + 0.3 * np.random.randn(n_samples)

# Create a dataframe
data = pd.DataFrame({
    'x': X,
    'y': y
})

# Generate polynomial features
for i in range(2, 16):
    data['x_%d' % i] = data['x'] ** i

# Plot the data
plt.figure(figsize=(10, 6))
plt.scatter(data['x'], data['y'], color='blue', s=30, alpha=0.6)
plt.title('Synthetic Data')
plt.xlabel('x')
plt.ylabel('y')
plt.show()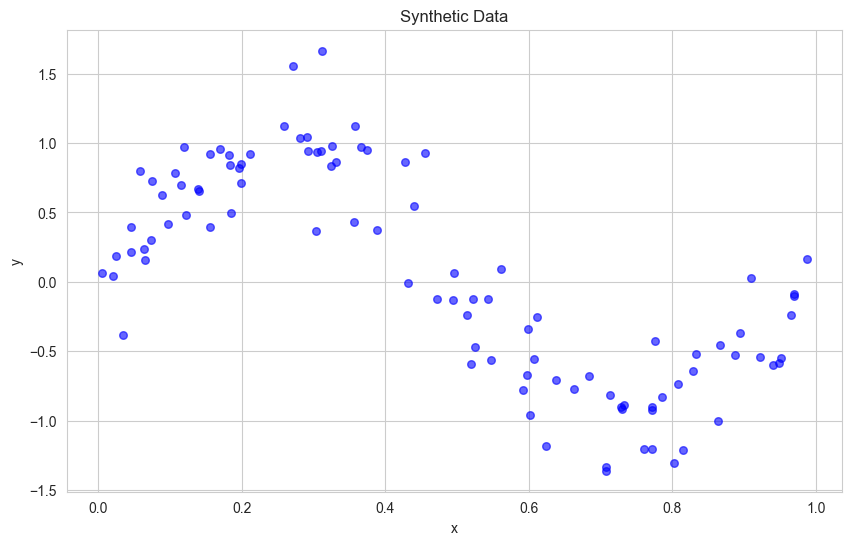
فهم بیشبرازش
بیایید توابعی برای برازش هم رگرسیون خطی استاندارد و هم رگرسیون ریج با ویژگیهای چندجملهای بنویسیم:
Source
def linear_regression(data, power, models_to_plot):
    # Initialize predictors
    predictors = ['x']
    if power >= 2:
        predictors.extend(['x_%d' % i for i in range(2, power+1)])

    # Fit the model
    linreg = LinearRegression()
    linreg.fit(data[predictors], data['y'])
    y_pred = linreg.predict(data[predictors])

    # Check if a plot is to be made for the entered power
    if power in models_to_plot:
        plt.subplot(models_to_plot[power])
        plt.tight_layout()
        plt.plot(data['x'], y_pred, 'r-', linewidth=2)
        plt.plot(data['x'], data['y'], 'b.', alpha=0.6)
        plt.title('Linear Regression with Polynomial Degree: %d' % power)

    # Return the result in pre-defined format
    rss = sum((y_pred - data['y'])**2)
    ret = [rss]
    ret.extend([linreg.intercept_])
    ret.extend(linreg.coef_)

    # Pad with zeros to match the number of columns in the DataFrame
    # We need 17 values total: 'rss', 'intercept', and 15 coefficients
    while len(ret) < 17:
        ret.append(0)

    return ret[:17]  # Ensure we return exactly the right number of values

def ridge_regression(data, power, alpha, models_to_plot):
    # Initialize predictors
    predictors = ['x']
    if power >= 2:
        predictors.extend(['x_%d' % i for i in range(2, power+1)])

    # Fit the model
    ridgereg = Ridge(alpha=alpha)
    ridgereg.fit(data[predictors], data['y'])
    y_pred = ridgereg.predict(data[predictors])

    # Check if a plot is to be made for the entered power
    if power in models_to_plot:
        # Use subplot position as a single integer (e.g., 1, 2, 3, 4, 5)
        # and convert it to the correct format for plt.subplot
        subplot_pos = models_to_plot[power]
        plt.subplot(2, 3, subplot_pos)  # 2 rows, 3 columns, position subplot_pos

        plt.plot(data['x'], y_pred, 'r-', linewidth=2)
        plt.plot(data['x'], data['y'], 'b.', alpha=0.6)
        plt.title(f'Ridge Regression with Polynomial Degree: {power}, Alpha: {alpha:.2f}')

    # Return the result in pre-defined format
    rss = sum((y_pred - data['y'])**2)
    ret = [rss]
    ret.extend([ridgereg.intercept_])
    ret.extend(ridgereg.coef_)

    # Pad with zeros to match the number of columns in the DataFrame
    while len(ret) < power + 2:  # rss, intercept, and power coefficients
        ret.append(0)

    return ret[:power + 2]  # Ensure we return exactly the right number of values
مقایسهٔ رگرسیون خطی با درجههای مختلف چندجملهای
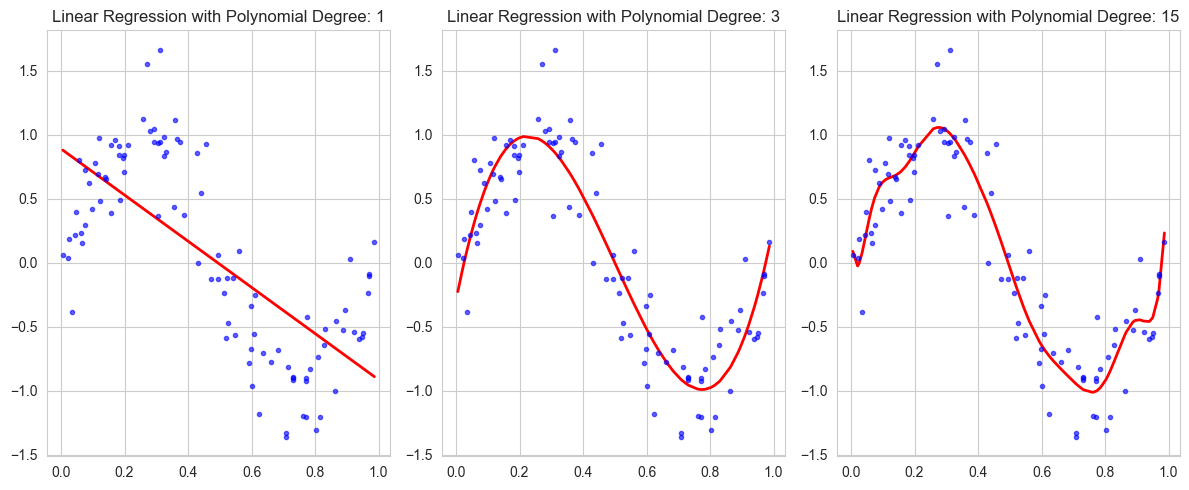
بیایید تجسم کنیم رگرسیون خطی استاندارد با افزایش درجهٔ چندجملهای چگونه رفتار میکند:
Source
# Initialize a dataframe to store the results
# This should have 17 columns: 'rss', 'intercept', and 15 coefficient columns
linear_model = pd.DataFrame(columns=['rss', 'intercept'] + ['coef_x_%d' % i for i in range(1, 16)])

# Print the number of columns to verify
print(f"Number of columns in DataFrame: {len(linear_model.columns)}")

# Set the powers for which we want to plot the models
models_to_plot = {1: 131, 3: 132, 15: 133}

# Fit linear regression models with different powers
plt.figure(figsize=(12, 5))
for power in range(1, 16):
    linear_model.loc[power] = linear_regression(data, power, models_to_plot)

plt.tight_layout()
plt.show()
Number of columns in DataFrame: 17
تحلیل پیچیدگی مدل و بیشبرازش
در این مثال بررسی میکنیم افزایش پیچیدگی مدل رگرسیون چندجملهای چگونه کارکرد آن را روی دادهٔ آموزش و آزمون تحت تأثیر میگذارد. این کارها را انجام میدهیم:
دادهٔ مصنوعی را به مجموعهٔ آموزش (50٪) و آزمون (50٪) تقسیم میکنیم
مدلهای رگرسیون چندجملهای با درجههای 1 تا 15 را برازش میدهیم
پیشبینی مدل را برای درجههای 1، 3، 6، 12 و 15 تجسم میکنیم
خطای آموزش و آزمون (RSS) را در برابر پیچیدگی مدل رسم میکنیم
مشاهدات کلیدی که باید ببینید:
هر مدل چقدر خوب به دادهٔ آموزش برازش میشود؟
آیا افزایش درجهٔ چندجملهای همیشه به پیشبینی بهتر میانجامد؟
میتوانید جایی را که بیشبرازش آغاز میشود شناسایی کنید؟
توجه کنید خطای آموزش بهطور پیوسته کم میشود در حالی که خطای آزمون ممکن است شروع به افزایش کند
Source
# Split the data into training and testing sets
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(data['x'], data['y'], test_size=0.5, random_state=42)

# Create training and testing dataframes
train_data = pd.DataFrame({'x': X_train, 'y': y_train})
test_data = pd.DataFrame({'x': X_test, 'y': y_test})

# Generate polynomial features for both sets
for i in range(2, 16):
    train_data[f'x_{i}'] = train_data['x'] ** i
    test_data[f'x_{i}'] = test_data['x'] ** i

# Initialize a dataframe to store the results
linear_model = pd.DataFrame(columns=['train_rss', 'test_rss', 'intercept'] + [f'coef_x_{i}' for i in range(1, 16)])

# Set the powers for which we want to plot the models
models_to_plot = {1: 231, 3: 232, 6: 233, 12: 234, 15:235}

# Create figure with more subplots
plt.figure(figsize=(15, 10))

# Lists to store errors for plotting
train_errors = []
test_errors = []

# Fit linear regression models with different powers
for power in range(1, 16):
    # Initialize predictors
    predictors = ['x']
    if power >= 2:
        predictors.extend([f'x_{i}' for i in range(2, power+1)])

    # Fit the model
    linreg = LinearRegression()
    linreg.fit(train_data[predictors], train_data['y'])

    # Make predictions
    y_train_pred = linreg.predict(train_data[predictors])
    y_test_pred = linreg.predict(test_data[predictors])

    # Calculate RSS for both sets
    train_rss = sum((y_train_pred - train_data['y'])**2)
    test_rss = sum((y_test_pred - test_data['y'])**2)

    # Store errors for plotting
    train_errors.append(train_rss)
    test_errors.append(test_rss)

    # Store results
    ret = [train_rss, test_rss, linreg.intercept_] + list(linreg.coef_) + [0] * (15 - power)
    linear_model.loc[power] = ret

    # Plot if this is one of our selected models
    if power in models_to_plot:
        plt.subplot(models_to_plot[power])
        # Sort for proper line plotting
        train_points = pd.DataFrame({'x': train_data['x'], 'y_pred': y_train_pred}).sort_values('x')
        test_points = pd.DataFrame({'x': test_data['x'], 'y_pred': y_test_pred}).sort_values('x')

        plt.plot(train_points['x'], train_points['y_pred'], 'r-', linewidth=2, label='Prediction')
        plt.scatter(train_data['x'], train_data['y'], color='blue', s=30, alpha=0.6, label='Train')
        plt.scatter(test_data['x'], test_data['y'], color='green', s=30, alpha=0.6, label='Test')
        plt.title(f'Polynomial Degree: {power}')
        plt.legend()

# Add the error plot
plt.subplot(236)
plt.plot(range(1, 16), train_errors, 'b-', label='Training Error')
plt.plot(range(1, 16), test_errors, 'r-', label='Test Error')
plt.xlabel('Polynomial Degree')
plt.ylabel('RSS')
plt.title('Training vs Testing Error')
plt.legend()

plt.tight_layout()
plt.show()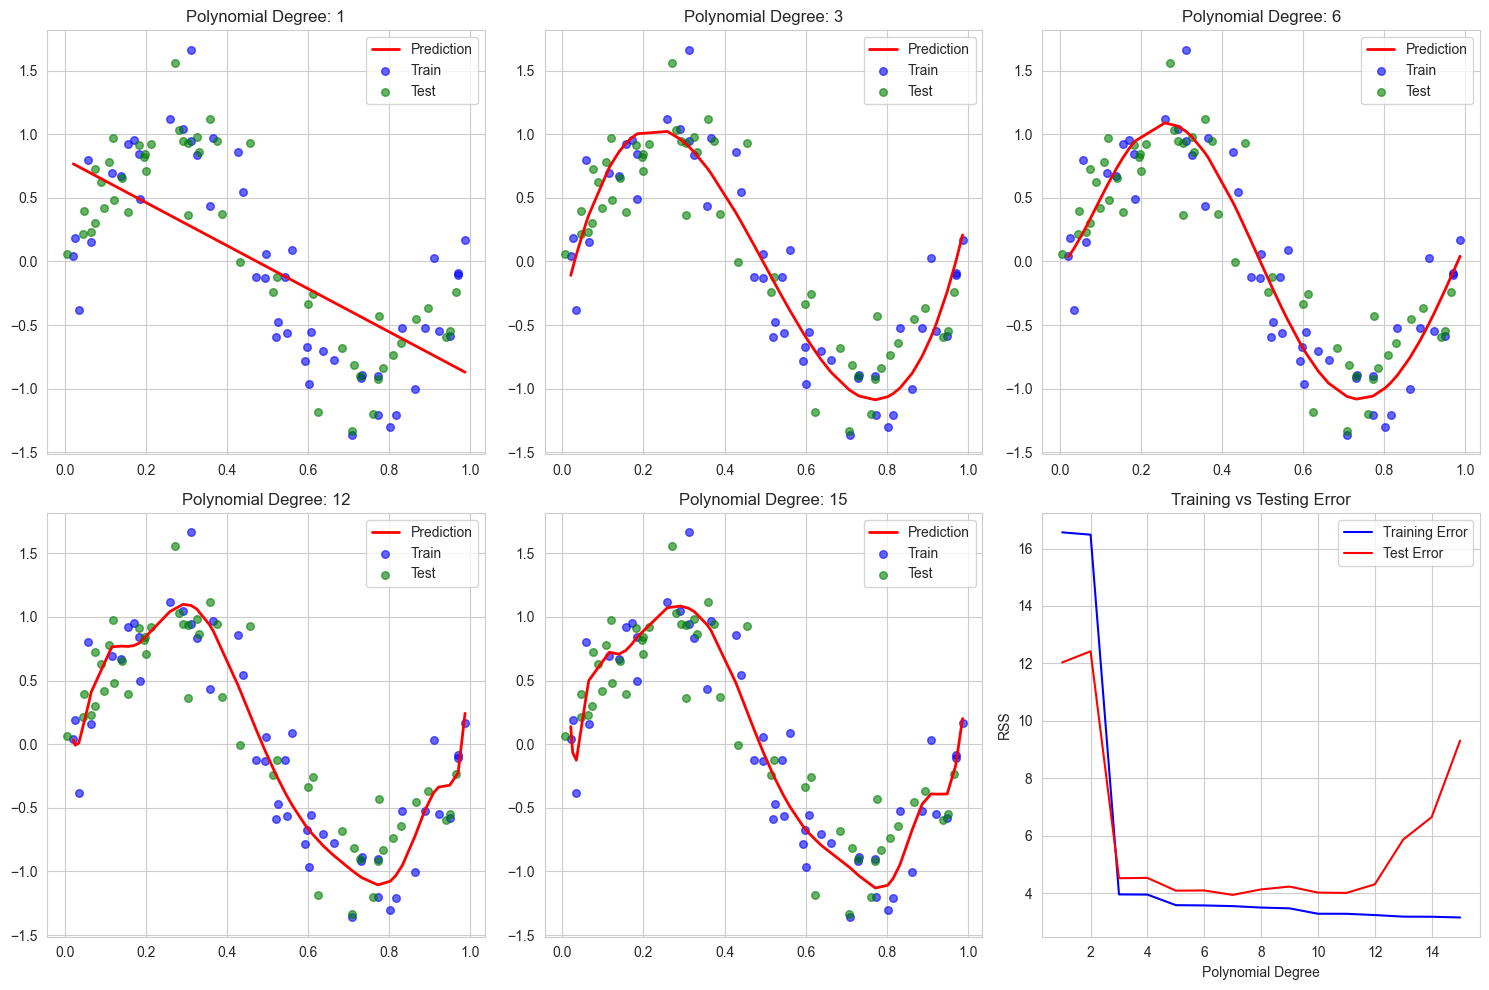
رگرسیون ریج یک جملهٔ جریمه به تابع هزینه میافزاید، یعنی مجموع مربع ضریبها ضرب در پارامتر تنظیمکنندهٔ آلفا. این کار با کوچک نگه داشتن ضریبها از بیشبرازش جلوگیری میکند.
تابع هزینهٔ رگرسیون ریج چنین است:
که در آن:
MSE میانگین مربع خطاست
α (آلفا) پارامتر تنظیمکننده است
θᵢ ضریبهای مدلاند (بهجز عرض از مبدأ)
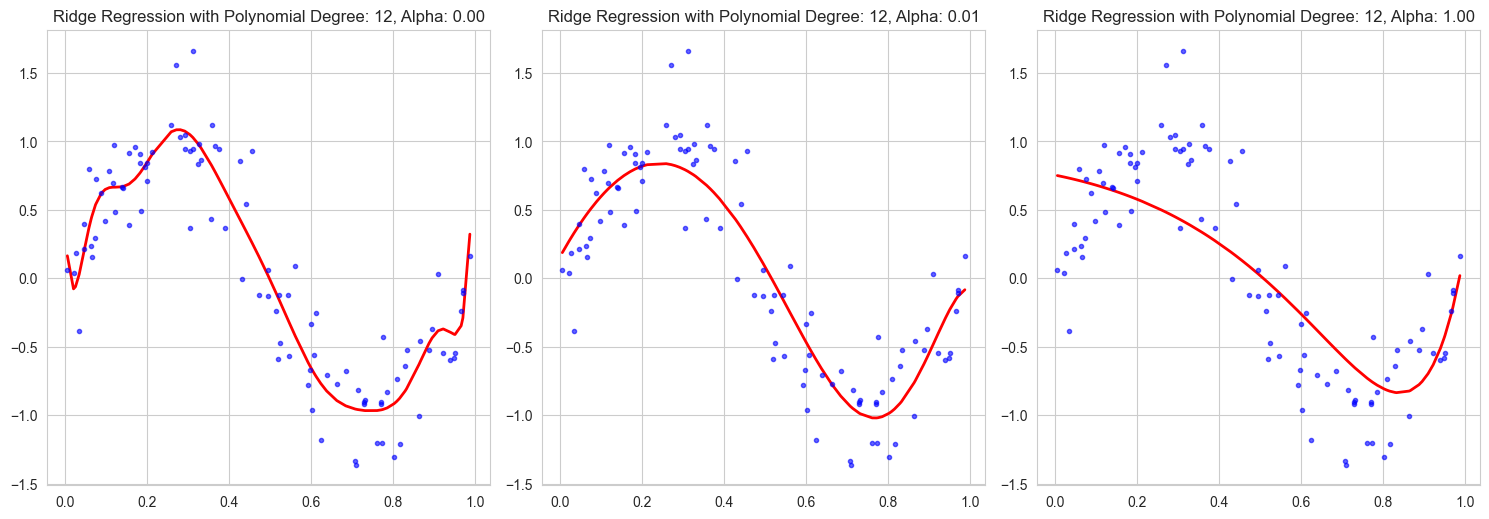
بیایید رگرسیون ریج را با مقدارهای مختلف آلفا برای یک چندجملهای با درجهٔ بالا مقایسه کنیم:
Source
# Initialize a dataframe to store the results
ridge_models = {}
alphas = [0,  0.01, 1]
power = 12  # Using a high polynomial degree to demonstrate overfitting

plt.figure(figsize=(15, 10))
counter = 1

for alpha in alphas:
    ridge_models[alpha] = pd.DataFrame(columns=['rss', 'intercept'] + ['coef_x_%d' % i for i in range(1, power+1)])
    # Pass the counter as the subplot position (1, 2, 3, 4, 5)
    ridge_models[alpha].loc[power] = ridge_regression(data, power, alpha, {power: counter})
    counter += 1

plt.tight_layout()
plt.show()
c:\programs\anaconda3\envs\pth\lib\site-packages\sklearn\linear_model\_ridge.py:216: LinAlgWarning: Ill-conditioned matrix (rcond=1.187e-18): result may not be accurate.
return linalg.solve(A, Xy, assume_a="pos", overwrite_a=True).T
تجسم اثر آلفا بر ضریبها
ببینیم ضریبها با مقدارهای مختلف آلفا چگونه تغییر میکنند:
Source
# Extract the coefficients for different alpha values
coef_matrix = pd.DataFrame(index=range(1, power+1))

for alpha in alphas:
    # Take the absolute value and then log transform the coefficients
    coef_matrix['alpha = %.2f' % alpha] = np.log10(np.abs(ridge_models[alpha].loc[power][2:]) + 1e-10)

# Plot the log-transformed coefficient values
plt.figure(figsize=(12, 6))
for alpha in alphas:
    # Plot log10 of absolute coefficient values
    plt.plot(range(1, power+1), np.log10(np.abs(ridge_models[alpha].loc[power][2:]) + 1e-10),
             'o-', label='alpha = %.2f' % alpha)

plt.title('Log10 of Absolute Coefficient Values for Different Alpha Values')
plt.xlabel('Coefficient Index')
plt.ylabel('Log10(|Coefficient Value|)')
plt.legend()
plt.grid(True)
plt.show()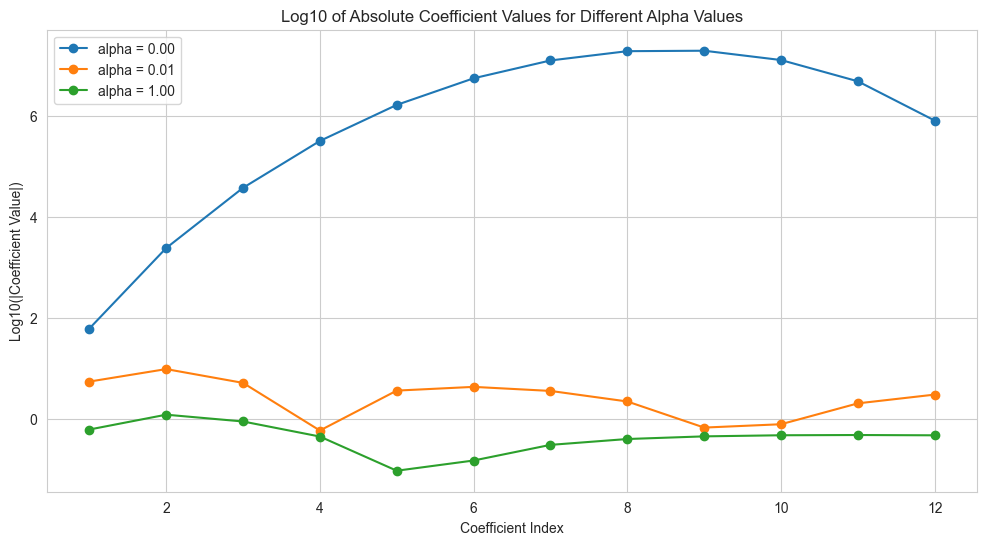
رگرسیون لاسو (تنظیمکنندهٔ )
نوع رایج دیگری از تنظیمکننده رگرسیون لاسو یا تنظیمکنندهٔ است که مجموع قدر مطلقها (نُرمهای 1) ضریبهای رگرسیون را جریمه میکند:
هرچند این مفهوم بسیار شبیه رگرسیون ریج است، نتیجهها میتوانند بهطور غافلگیرکنندهای متفاوت باشند. مثلاً لاسو بهدلیل ساختارش گرایش دارد در جایی که ممکن است مدلهای تُنُک را ترجیح دهد: یعنی ترجیحاً بسیاری از ضریبهای مدل را دقیقاً صفر میکند.
با جریمهٔ رگرسیون لاسو، بیشتر ضریبها دقیقاً صفر میشوند و رفتار تابعی با زیرمجموعهٔ کوچکی از توابع پایهٔ موجود مدل میشود. مانند تنظیمکنندهٔ ریج، پارامتر قدرت جریمه را تنظیم میکند و باید مثلاً با اعتبارسنجی متقاطع تعیین شود (برای بحث این موضوع به صفحهٔ ابرپارامترها و اعتبارسنجی مدل نگاه کنید).
برای اطلاعات بیشتر دربارهٔ مطالب مرتبط Mathematics for Machine Learning را ببینید
مثال: پیشبینی ترافیک دوچرخه
بهعنوان مثال ببینیم میتوانیم تعداد سفرهای دوچرخه روی پل فریمونت سیاتل را بر پایهٔ آبوهوا، فصل و عوامل دیگر پیشبینی کنیم یا نه. این داده را پیشتر در کار با سریهای زمانی دیدهایم، ولی اینجا دادهٔ دوچرخه را با مجموعهدادهٔ دیگری میپیوندیم و میکوشیم تعیین کنیم عوامل آبوهوا و فصلی — دما، بارش و ساعتهای روشنایی — تا چه حد بر حجم ترافیک دوچرخه در این مسیر اثر میگذارند.
خوشبختانه ادارهٔ ملی اقیانوس و جو (NOAA) دادهٔ روزانهٔ ایستگاه هواشناسی را در دسترس میگذارد — من شناسهٔ ایستگاه USW00024233 را به کار بردم — و میتوانیم بهآسانی با Pandas دو منبع داده را بپیوندیم. یک رگرسیون خطی ساده انجام میدهیم تا آبوهوا و اطلاعات دیگر را با شمار دوچرخهها مرتبط کنیم و برآورد کنیم تغییر هر یک از این پارامترها چگونه شمار دوچرخهسواران در یک روز را تحت تأثیر میگذارد.
بهویژه، این مثالی است از اینکه ابزارهای Scikit-Learn چگونه در چارچوب مدلسازی آماری به کار میروند، چارچوبی که در آن پارامترهای مدل معنای تفسیرپذیر دارند. همانطور که پیشتر گفتیم، این رویکرد استانداردی در یادگیری ماشین نیست، ولی برای برخی مدلها چنین تفسیری ممکن است.
با بارگذاری دو مجموعهداده و نمایهگذاری بر پایهٔ تاریخ شروع میکنیم:
# url = 'https://raw.githubusercontent.com/jakevdp/bicycle-data/main'
# !curl -O {url}/FremontBridge.csv
# !curl -O {url}/SeattleWeather.csv
import pandas as pd
counts = pd.read_csv('FremontBridge.csv',
index_col='Date', parse_dates=True, date_format='mixed')
# The raw export repeats every hour up to 2020 (two differing rows per timestamp);
# keep a single row per timestamp so the daily sums are not doubled.
counts = counts[~counts.index.duplicated(keep='first')].sort_index()
# weather = pd.read_csv('SeattleWeather.csv',
# index_col='DATE', parse_dates=True)
weather = pd.read_csv('BicycleWeather.csv', index_col='DATE', parse_dates=True)
برای سادگی، داده پس از 2020 را نادیده بگیریم تا از اثرهای دنیاگیری COVID-19 که الگوهای رفتوآمد سیاتل را بهشدت تحت تأثیر گذاشت دور بمانیم:
counts = counts[counts.index < "2020-01-01"]
weather = weather[weather.index < "2020-01-01"]
بعد کل ترافیک روزانهٔ دوچرخه را حساب میکنیم و در DataFrame جداگانهای میگذاریم:
daily = counts.resample('d').sum()
# 'Fremont Bridge Total' already equals East + West sidewalk, so summing all
# three columns would double the real daily traffic.
daily['Total'] = daily['Fremont Bridge Total']
daily = daily[['Total']] # remove other columns
پیشتر دیدیم که الگوهای استفاده عموماً روزبهروز فرق میکند. بیایید این را با افزودن ستونهای دودویی که روز هفته را نشان میدهند در داده لحاظ کنیم:
days = ['Mon', 'Tue', 'Wed', 'Thu', 'Fri', 'Sat', 'Sun']
for i in range(7):
    daily[days[i]] = (daily.index.dayofweek == i).astype(float)
به همین ترتیب، شاید انتظار داشته باشیم دوچرخهسواران در تعطیلات رفتار متفاوتی داشته باشند؛ بیایید نشانگر این را هم اضافه کنیم:
from pandas.tseries.holiday import USFederalHolidayCalendar
cal = USFederalHolidayCalendar()
holidays = cal.holidays('2012', '2020')
daily = daily.join(pd.Series(1, index=holidays, name='holiday'))
daily.fillna({'holiday': 0}, inplace=True)
همچنین شاید گمان کنیم ساعتهای روشنایی بر شمار دوچرخهسواران اثر میگذارد. بیایید با محاسبهٔ نجومی استاندارد این اطلاعات را اضافه کنیم (شکل زیر):
def hours_of_daylight(date, axis=23.44, latitude=47.61):
    """Compute the hours of daylight for the given date"""
    days = (date - pd.Timestamp(2000, 12, 21)).days
    m = (1. - np.tan(np.radians(latitude))
         * np.tan(np.radians(axis) * np.cos(days * 2 * np.pi / 365.25)))
    return 24. * np.degrees(np.arccos(1 - np.clip(m, 0, 2))) / 180.

daily['daylight_hrs'] = list(map(hours_of_daylight, daily.index))
daily[['daylight_hrs']].plot()
plt.ylim(8, 17)
(8.0, 17.0)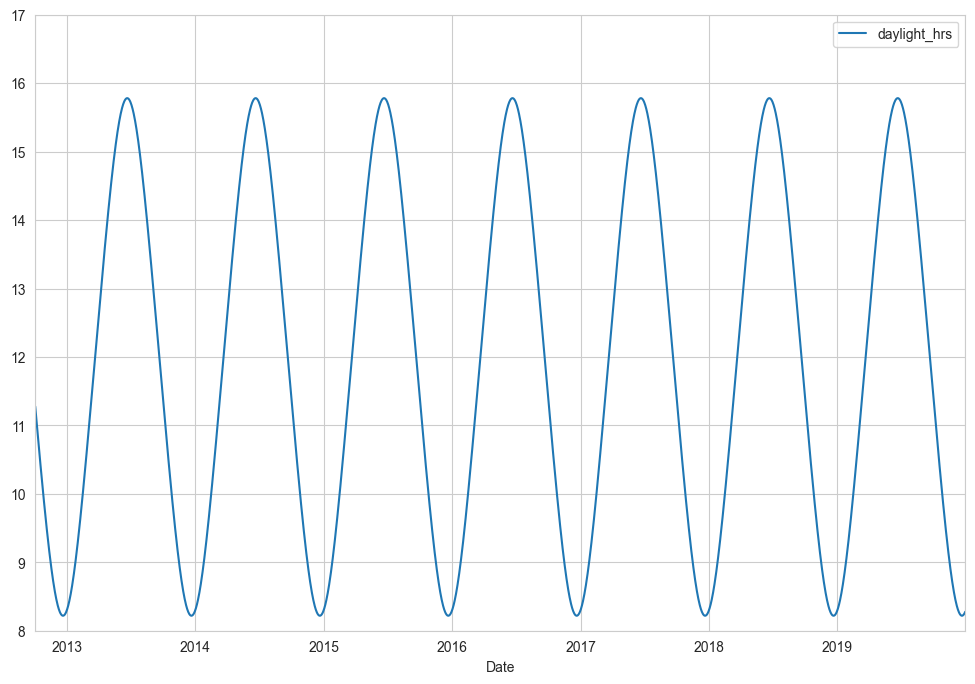
میتوانیم میانگین دما و مجموع بارش را هم به داده اضافه کنیم. در کنار اینچ بارش، پرچمی هم اضافه کنیم که نشان دهد روز خشک است (بارش صفر):
# weather['Temp (F)'] = 0.5 * (weather['TMIN'] + weather['TMAX'])
# temperatures are in 1/10 deg C; convert to C
weather['TMIN'] /= 10
weather['TMAX'] /= 10
weather['Temp (C)'] = 0.5 * (weather['TMIN'] + weather['TMAX'])

# precip is in 1/10 mm; convert to inches
weather['PRCP'] /= 25
# weather['Rainfall (in)'] = weather['PRCP']
weather['dry day'] = (weather['PRCP'] == 0).astype(int)

daily = daily.join(weather[['PRCP', 'Temp (C)', 'dry day']])
سرانجام یک شمارنده اضافه کنیم که از روز 1 افزایش مییابد و میسنجد چند سال گذشته است. این به ما اجازه میدهد هر افزایش یا کاهش سالانهٔ مشاهدهشده در گذرهای روزانه را بسنجیم:
daily['annual'] = (daily.index - daily.index[0]).days / 365.اکنون داده مرتب است و میتوانیم نگاهی به آن بیندازیم:
daily.head()با این کار میتوانیم ستونهای مورد استفاده را انتخاب کنیم و مدل رگرسیون خطی را به داده برازش دهیم.
fit_intercept=False میگذاریم، چون پرچمهای روزانه عملاً خودشان بهعنوان عرض از مبدأ مخصوص هر روز
کار میکنند:
# Drop any rows with null values
daily.dropna(axis=0, how='any', inplace=True)

column_names = ['Mon', 'Tue', 'Wed', 'Thu', 'Fri', 'Sat', 'Sun',
                'holiday', 'daylight_hrs', 'PRCP',
                'dry day', 'Temp (C)', 'annual']
X = daily[column_names]
y = daily['Total']

model = LinearRegression(fit_intercept=False)
model.fit(X, y)
daily['predicted'] = model.predict(X)
سرانجام میتوانیم ترافیک کل و پیشبینیشدهٔ دوچرخه را بهطور دیداری مقایسه کنیم (شکل زیر):
daily[['Total', 'predicted']].plot(alpha=0.5);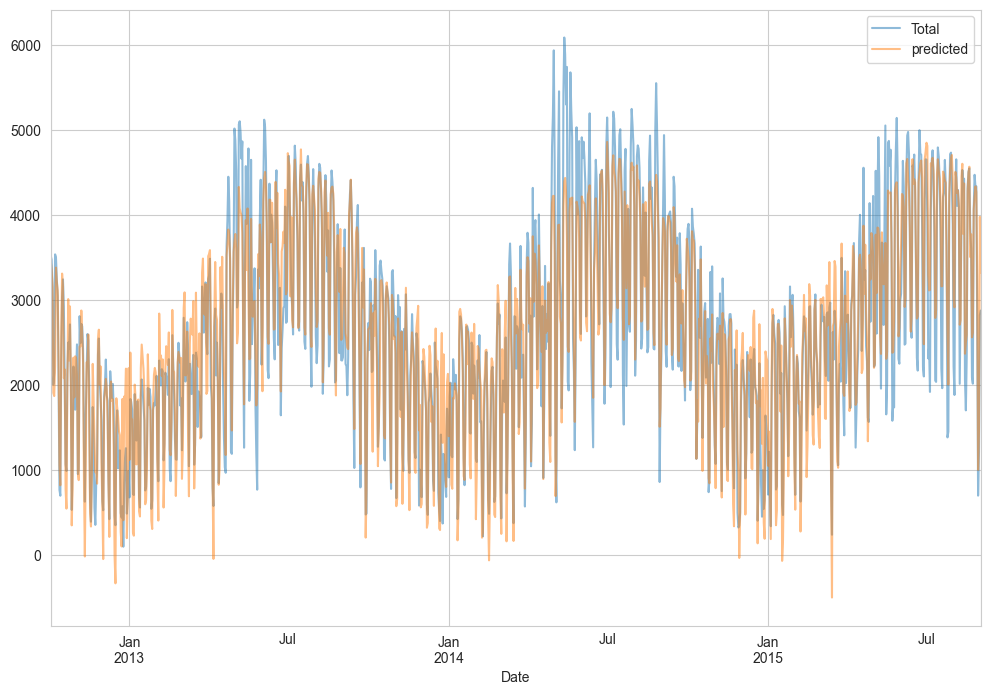
از اینکه داده و پیشبینیهای مدل دقیقاً بر هم نمیافتند پیداست که چند ویژگی کلیدی را از دست دادهایم. یا ویژگیهای ما کامل نیستند (یعنی مردم بر پایهٔ بیش از این ویژگیها تصمیم میگیرند دوچرخه سواری کنند) یا رابطههای غیرخطیای هست که در نظر نگرفتهایم (مثلاً شاید در دمای بالا و پایین مردم کمتر دوچرخه سوار میشوند). با این حال تقریب زبر ما برای گرفتن چند بینش کافی است و میتوانیم ضریبهای مدل خطی را ببینیم تا برآورد کنیم هر ویژگی چقدر در شمار روزانهٔ دوچرخه سهم دارد:
params = pd.Series(model.coef_, index=X.columns)
params
Mon 504.882756
Tue 610.233936
Wed 592.673642
Thu 482.358115
Fri 177.980345
Sat -1103.301710
Sun -1133.567246
holiday -1187.401381
daylight_hrs 128.851511
PRCP -65.436504
dry day 547.698592
Temp (C) 65.162791
annual 26.942713
dtype: float64تفسیر این عددها بدون سنجهای از عدمقطعیتشان دشوار است. میتوانیم این عدمقطعیتها را بهسرعت با بازنمونهگیری بوتاسترپ از داده حساب کنیم:
from sklearn.utils import resample
np.random.seed(1)
err = np.std([model.fit(*resample(X, y)).coef_
              for i in range(1000)], 0)
با برآورد این خطاها، بیایید دوباره نتیجهها را ببینیم:
print(pd.DataFrame({'effect': params.round(0),
                    'uncertainty': err.round(0)}))
effect uncertainty
Mon 505.0 86.0
Tue 610.0 83.0
Wed 593.0 83.0
Thu 482.0 85.0
Fri 178.0 81.0
Sat -1103.0 80.0
Sun -1134.0 83.0
holiday -1187.0 163.0
daylight_hrs 129.0 9.0
PRCP -65.0 6.0
dry day 548.0 33.0
Temp (C) 65.0 4.0
annual 27.0 18.0
نخست میبینیم که در خط پایهٔ هفتگی روند نسبتاً پایداری هست: در روزهای کاری بسیار بیشتر از آخر هفته و تعطیلات دوچرخهسوار هست. میبینیم برای هر ساعت روشنایی اضافه، 129 ± 9 نفر بیشتر دوچرخه سواری میکنند؛ افزایش یک درجهٔ سلسیوس دما 65 ± 4 نفر را به دوچرخه تشویق میکند؛ روز خشک بهطور میانگین 548 ± 33 دوچرخهسوار بیشتر یعنی، و هر اینچ بارش 665 ± 62 نفر را دوچرخهشان را در خانه میگذارد. وقتی همهٔ این اثرها در نظر گرفته شوند، افزایش اندک 27 ± 18 دوچرخهسوار روزانه در هر سال میبینیم.
مدل ما تقریباً بهیقین چند اطلاعات مرتبط را از دست داده است. مثلاً اثرهای غیرخطی (مثل اثر بارش و دمای سرد) و روندهای غیرخطی درون هر متغیر (مثل بیمیلی به سواری در دمای بسیار سرد و بسیار گرم) در این مدل لحاظ نمیشوند. در کنار این، بخشی از اطلاعات ریزدانهتر را دور انداختهایم (مثل تفاوت صبح بارانی و بعدازظهر بارانی) و همبستگی میان روزها را نادیده گرفتهایم (مثل اثر احتمالی سهشنبهٔ بارانی بر شمار چهارشنبه، یا اثر یک روز آفتابی غیرمنتظره پس از چند روز بارانی). اینها همه اثرهای بالقوه جالبی هستند و اکنون ابزار کاوش آنها را دارید!
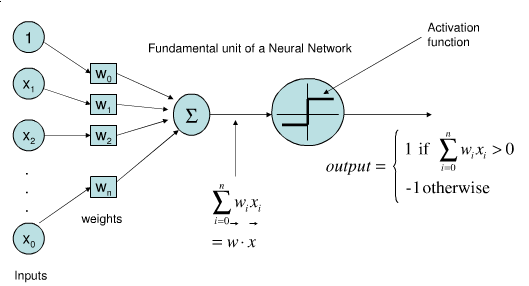
پرسپترون
نمایندهٔ یک نورون (گره) با ورودیهای ، بایاس و خروجی
هر اتصال یک وزن (سیناپسی) دارد. گره خروجی میدهد
تابع فعالساز اگر باشد 1 و در غیر این صورت -1 پیشبینی میکند
وزنها را میتوان با گرادیان کاهشی (تصادفی) و هزینهٔ Hinge(0) یاد گرفت
فقط روی دستهبندی نادرست بهروز میشود و خروجی را با اصلاح میکند