مقدمه
چند نکتهٔ سودمند دربارهٔ یادگیری ماشین محمود امینطوسی، پاییز ۱۴۰۵ گروه علوم کامپیوتر، دانشگاه فردوسی مشهد یادآوری میکنم که مطالب اولیهٔ این درس از درس باز یادگیری ماشین، نوشتهٔ Joaquin Vanschoren و دیگران گرفته شده است.
Source
# Auto-setup when running on Google Colab
import os
if 'google.colab' in str(get_ipython()) and not os.path.exists('/content/machine-learning'):
    !git clone -q https://github.com/fum-cs/machine-learning.git /content/machine-learning
    !pip --quiet install -r /content/machine-learning/requirements_colab.txt
    %cd machine-learning/notebooks

# Global imports and settings
%matplotlib inline
from preamble import *
interactive = True # Set to True for interactive plots
if interactive:
    fig_scale = 1.5
else: # For printing
    fig_scale = 0.3
    plt.rcParams.update(print_config)
چرا یادگیری ماشین؟
موتورهای جستوجو (مثلاً Google)
سامانههای پیشنهاددهنده (مثلاً Netflix)
ترجمهٔ خودکار (مثلاً Google Translate)
درک گفتار (مثلاً Siri، Alexa)
بازی کردن (مثلاً AlphaGo)
خودروهای خودران
پزشکی شخصیسازیشده
پیشرفت در همهٔ علوم: ژنتیک، ستارهشناسی، شیمی، عصبشناسی، فیزیک، …
یادگیری ماشین چیست؟
یاد گرفتن انجام یک وظیفه بر پایهٔ تجربه (نمونهها) ، با کمینه کردن خطای
مثلاً تشخیص یک شخص در تصویر، با بیشترین دقت ممکن
اغلب میخواهیم تابعی (مدلی) با پارامترهای مدل یاد بگیریم که خروجی درست بدهد
معمولاً بخشی از سامانهای بسیار بزرگتر هستیم که دادهٔ را در شکل درست فراهم میکند
داده باید گردآوری، پاکسازی، نرمالسازی و از نظر سوگیری بررسی شود، …
سوگیری استقرایی
هر مدل فرضهایی را رمز میکند: سوگیری استقرایی = کلاس فرضیه
مدل چه تابعهایی را میتواند نمایش دهد؟
ترکیب واحدهای غیرخطی ساده ← شبکههای عصبی
قواعد همراستا با محورها ← درختهای تصمیم
رابطهٔ خطی / جمعی ← مدلهای خطی
نمونهمحور (تنبل) ← k نزدیکترین همسایه
حاشیهمحور + هسته ← SVM
مدلهای مولد احتمالاتی ← Naive Bayes، GMM
مدلهای احتمالاتی ممکن است فرضهای توزیعی هم روی داده یا نوفه بگذارند (مثلاً ، نوفهٔ گاوسی)
اینها فرضهای مولد هستند — دربارهٔ یا ، نه دربارهٔ
برای مدلهای تفکیکی لازم نیستند (مثلاً SVM چنین فرضی ندارد)
دو سطح متمایز از «چیزهایی که انتخاب میکنیم، نه یاد میگیریم»:
کلاس مدل = سوگیری استقرایی (با مقایسهٔ مدلها انتخاب میشود)
ابرپارامترها = ظرفیت درون (روی مجموعهٔ اعتبارسنجی تنظیم میشود)
مثلاً عمق درخت، معماری شبکه، قدرت تنظیمکننده
میتوان دانش را از وظیفههای پیشین هم انتقال داد:
سوگیری استقرایی یادگرفته: پیشآموزش، تنظیم دقیق، بازاستفادهٔ ویژگی
بازاستفاده از یادگرفتهشده بهعنوان مقدار اولیه
به کوتاهی (یک مسئلهٔ دوسطحی):
یادگیری ماشین در برابر آمار
دو فرهنگ
هر دو هدفشان پیشبینی پدیدههای طبیعی است:
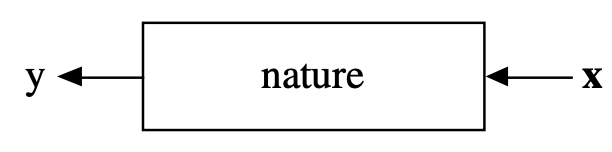
آمار:
کمک به انسان برای فهم جهان
فرض اینکه داده بر اساس مدلی فهمپذیر تولید شده است
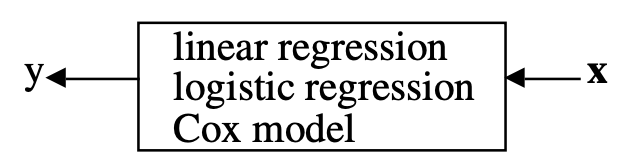
یادگیری ماشین:
خودکارسازی کامل یک وظیفه (تا حدی جانشینی انسان)
فرض اینکه فرایند تولید داده نامعلوم است
مهندسیمحور، با نظریهٔ ریاضی کمتر (شاید خیلی کم)
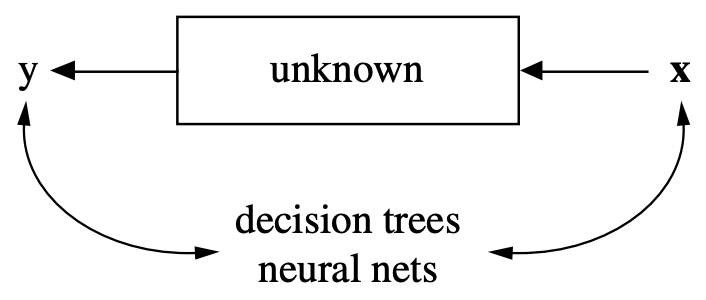
انواع یادگیری ماشین
یادگیری با نظارت: یاد گرفتن یک مدل از دادهٔ برچسبدار (حقیقتمبنا)
با ورودی تازهٔ X، خروجی درست y را پیشبینی کن
با نمونههایی از ستارهها و کهکشانها، اجرام تازه در آسمان را شناسایی کن
یادگیری بینظارت: کاوش ساختار داده (X) برای استخراج اطلاعات معنادار
با ورودیهای X، پیدا کن کدامها خاص، مشابه یا ناهنجارند، …
یادگیری نیمهنظارتی: یاد گرفتن مدل از نمونههای برچسبدار (کم) و بیبرچسب (زیاد)
نمونههای بیبرچسب اطلاعاتی دربارهٔ این میافزایند که کدام نمونههای تازه احتمالاً رخ میدهند
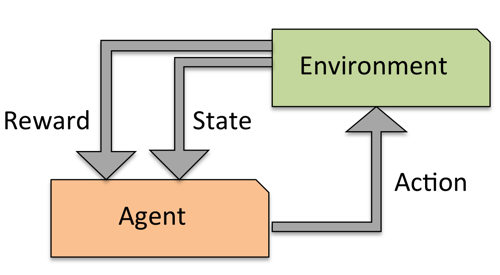
یادگیری تقویتی: ساختن عاملی که کارکردش را بر پایهٔ تعامل با محیط بهتر میکند
توجه: سامانههای عملی یادگیری ماشین میتوانند چند نوع را در یک سامانه ترکیب کنند.
یادگیری ماشین با نظارت
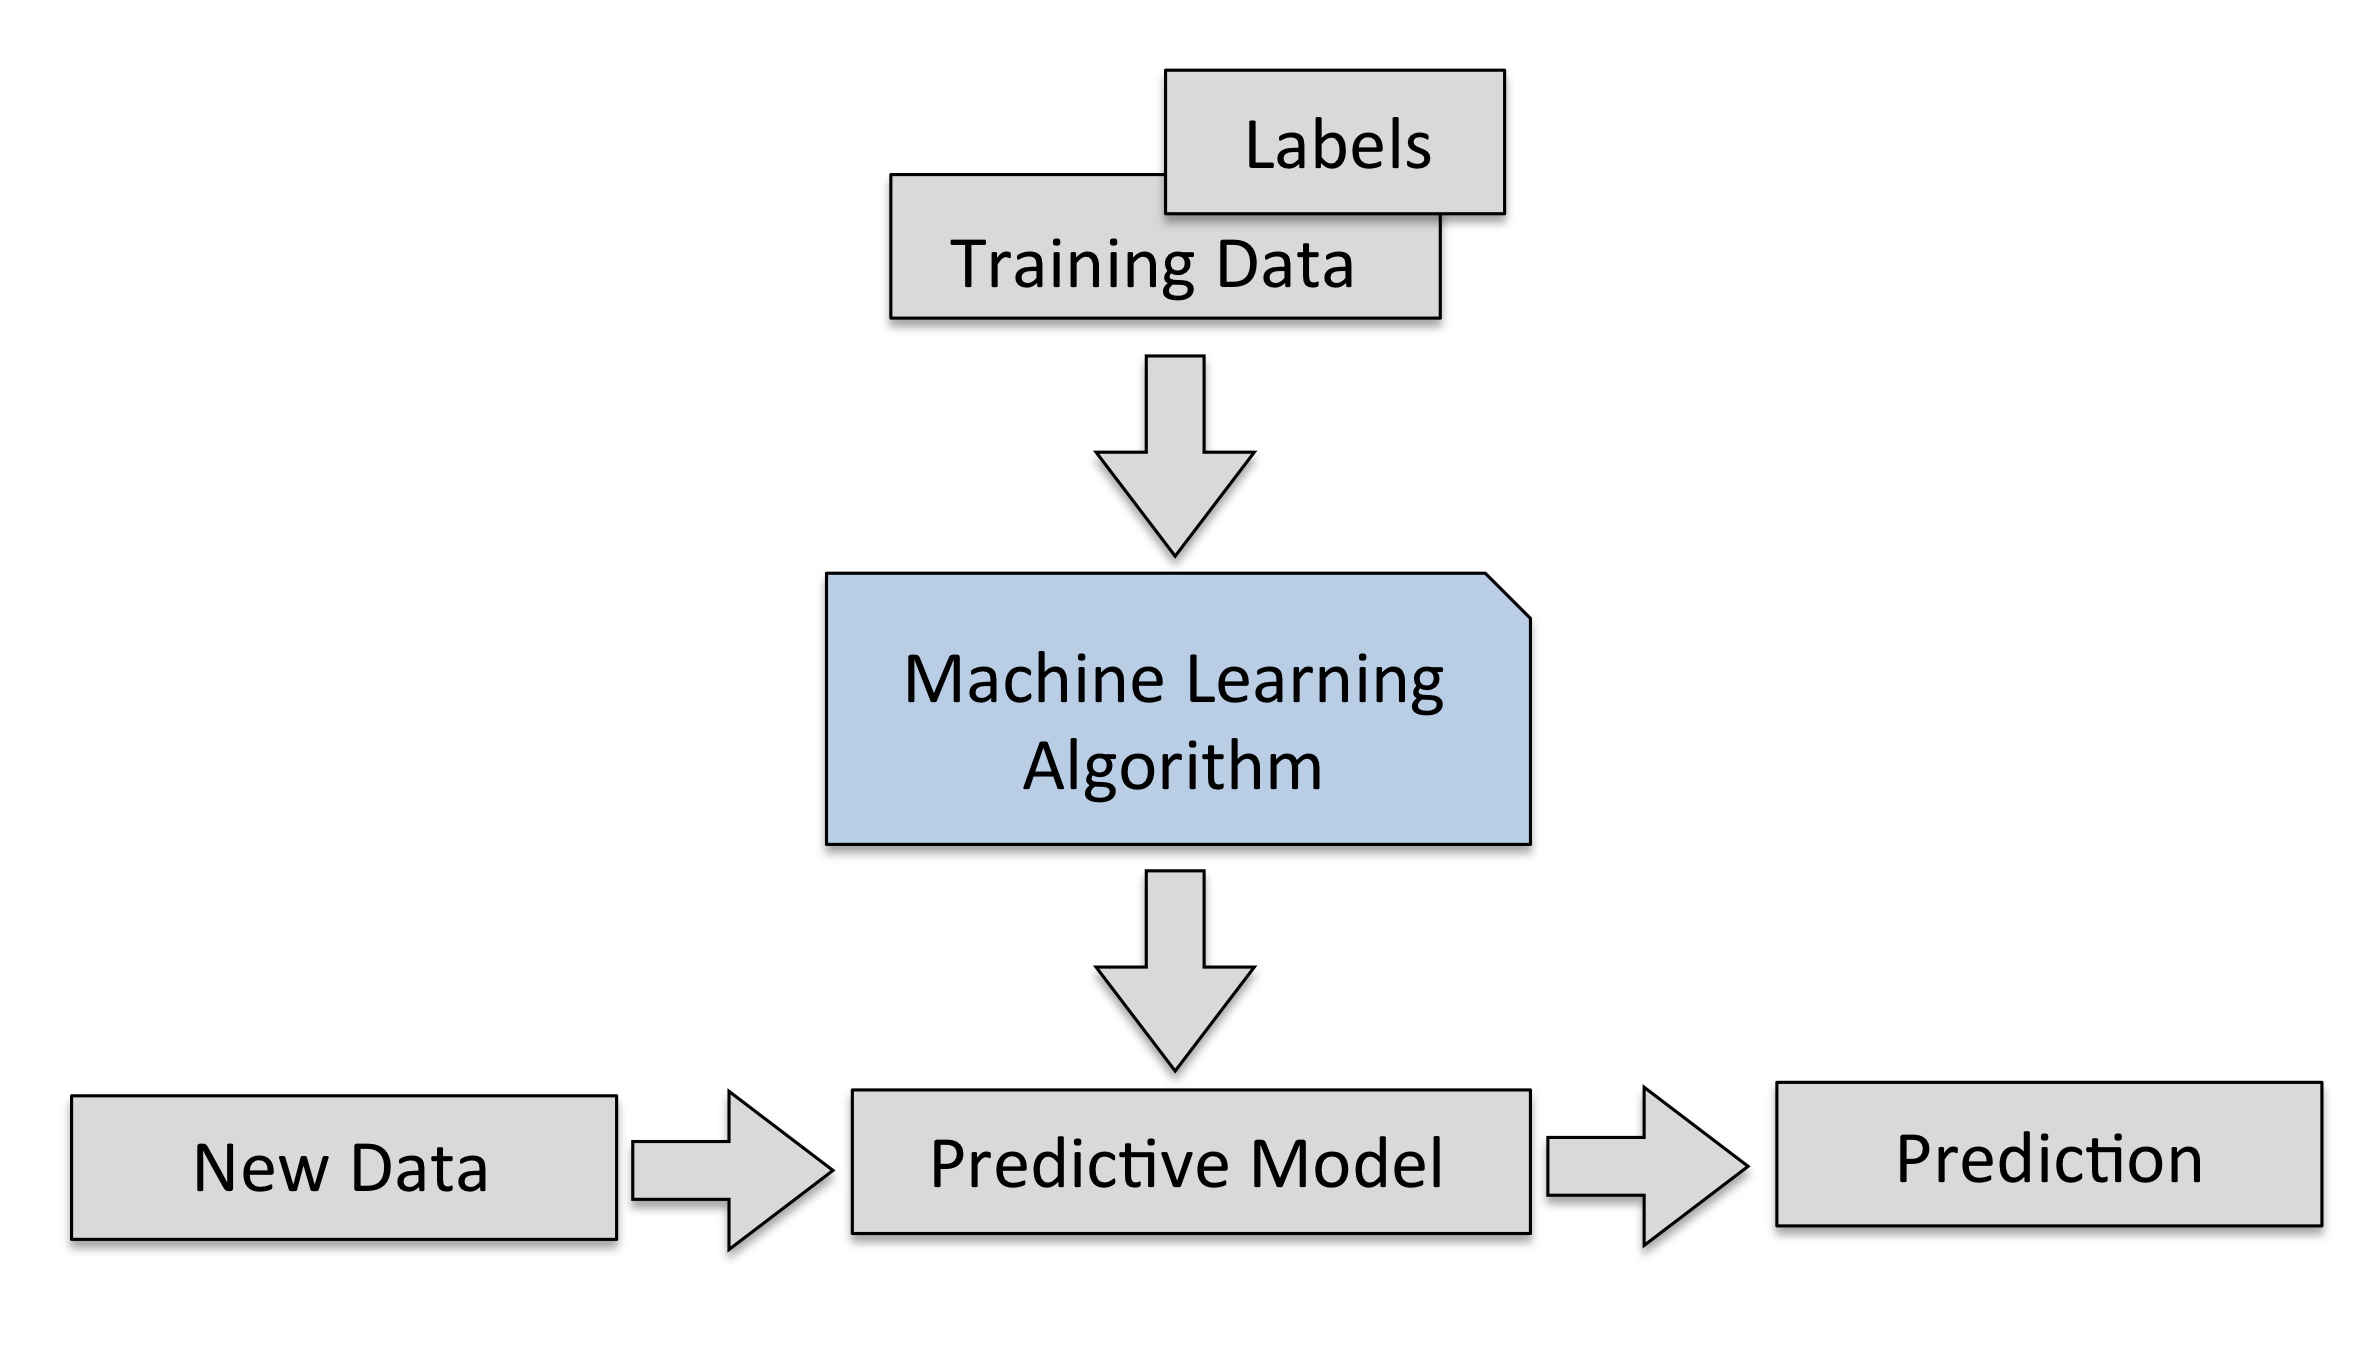
یاد گرفتن مدل از دادهٔ آموزش برچسبدار و بعد پیشبینی کردن
با نظارت: نتیجهٔ درست/مطلوب (برچسب) را میدانیم
زیرشاخهها: دستهبندی (پیشبینی یک دسته) و رگرسیون (پیشبینی یک مقدار عددی)
بیشتر الگوریتمهای با نظارتی که خواهیم دید هر دو را انجام میدهند
دستهبندی
پیشبینی یک برچسب دسته (مقوله)، گسسته و بیترتیب
میتواند دودویی (مثلاً هرزنامه/غیرهرزنامه) یا چنددستهای (مثلاً بازشناسی حرف) باشد
بسیاری از دستهبندها میتوانند برای هر دسته یک اطمینان برگردانند
پیشبینیهای مدل یک مرز تصمیم میسازند که دستهها را جدا میکند
Source
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC
from sklearn.neighbors import KNeighborsClassifier
from sklearn.datasets import make_moons
import ipywidgets as widgets
from ipywidgets import interact, interact_manual

# create a synthetic dataset
X1, y1 = make_moons(n_samples=70, noise=0.2, random_state=8)

# Train classifiers
lr = LogisticRegression().fit(X1, y1)
svm = SVC(kernel='rbf', gamma=2, probability=True).fit(X1, y1)
knn = KNeighborsClassifier(n_neighbors=3).fit(X1, y1)

# Plotting
# @interact
def plot_classifier(classifier=[lr,svm,knn]):
    fig, axes = plt.subplots(1, 2, figsize=(12*fig_scale, 4*fig_scale))
    mglearn.tools.plot_2d_separator(
        classifier, X1, ax=axes[0], alpha=.4, cm=mglearn.cm2)
    scores_image = mglearn.tools.plot_2d_scores(
        classifier, X1, ax=axes[1], alpha=.5, cm=mglearn.ReBl, function='predict_proba')
    for ax in axes:
        mglearn.discrete_scatter(X1[:, 0], X1[:, 1], y1,
                                 markers='.', ax=ax)
        ax.set_xlabel("Feature 0")
        ax.set_ylabel("Feature 1", labelpad=0)
        ax.tick_params(axis='y', pad=0)

    cbar = plt.colorbar(scores_image, ax=axes.tolist())
    cbar.set_label('Predicted probability', rotation=270, labelpad=6)
    cbar.set_alpha(1)
axes[0].legend(["Class 0", "Class 1"], ncol=4, loc=(.1, 1.1));Source
if interactive:
    interact(plot_classifier, classifier=[lr, svm, knn])
else:
    plot_classifier(classifier=svm)
مثال: دستهبندی گل
دستههای گل زنبق را دستهبندی کنید (setosa، versicolor یا virginica). چگونه این کار را میکنید؟
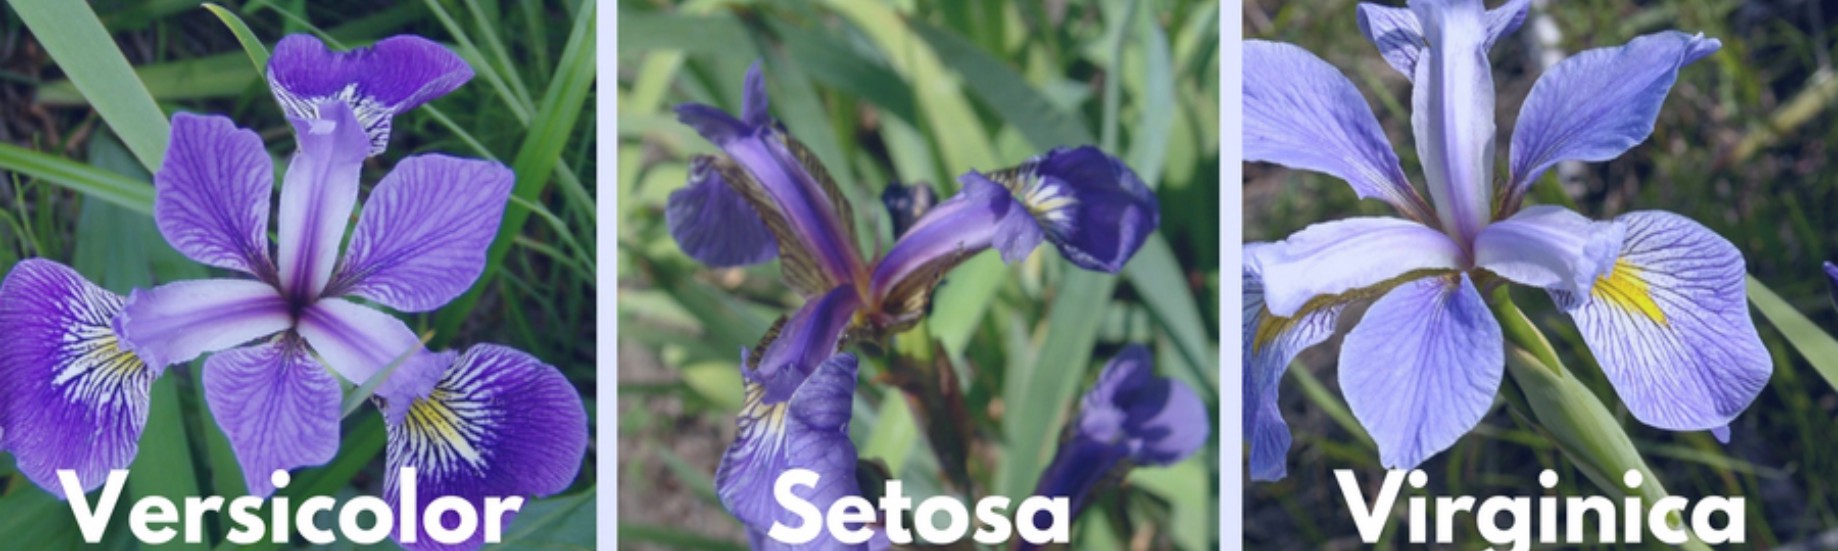
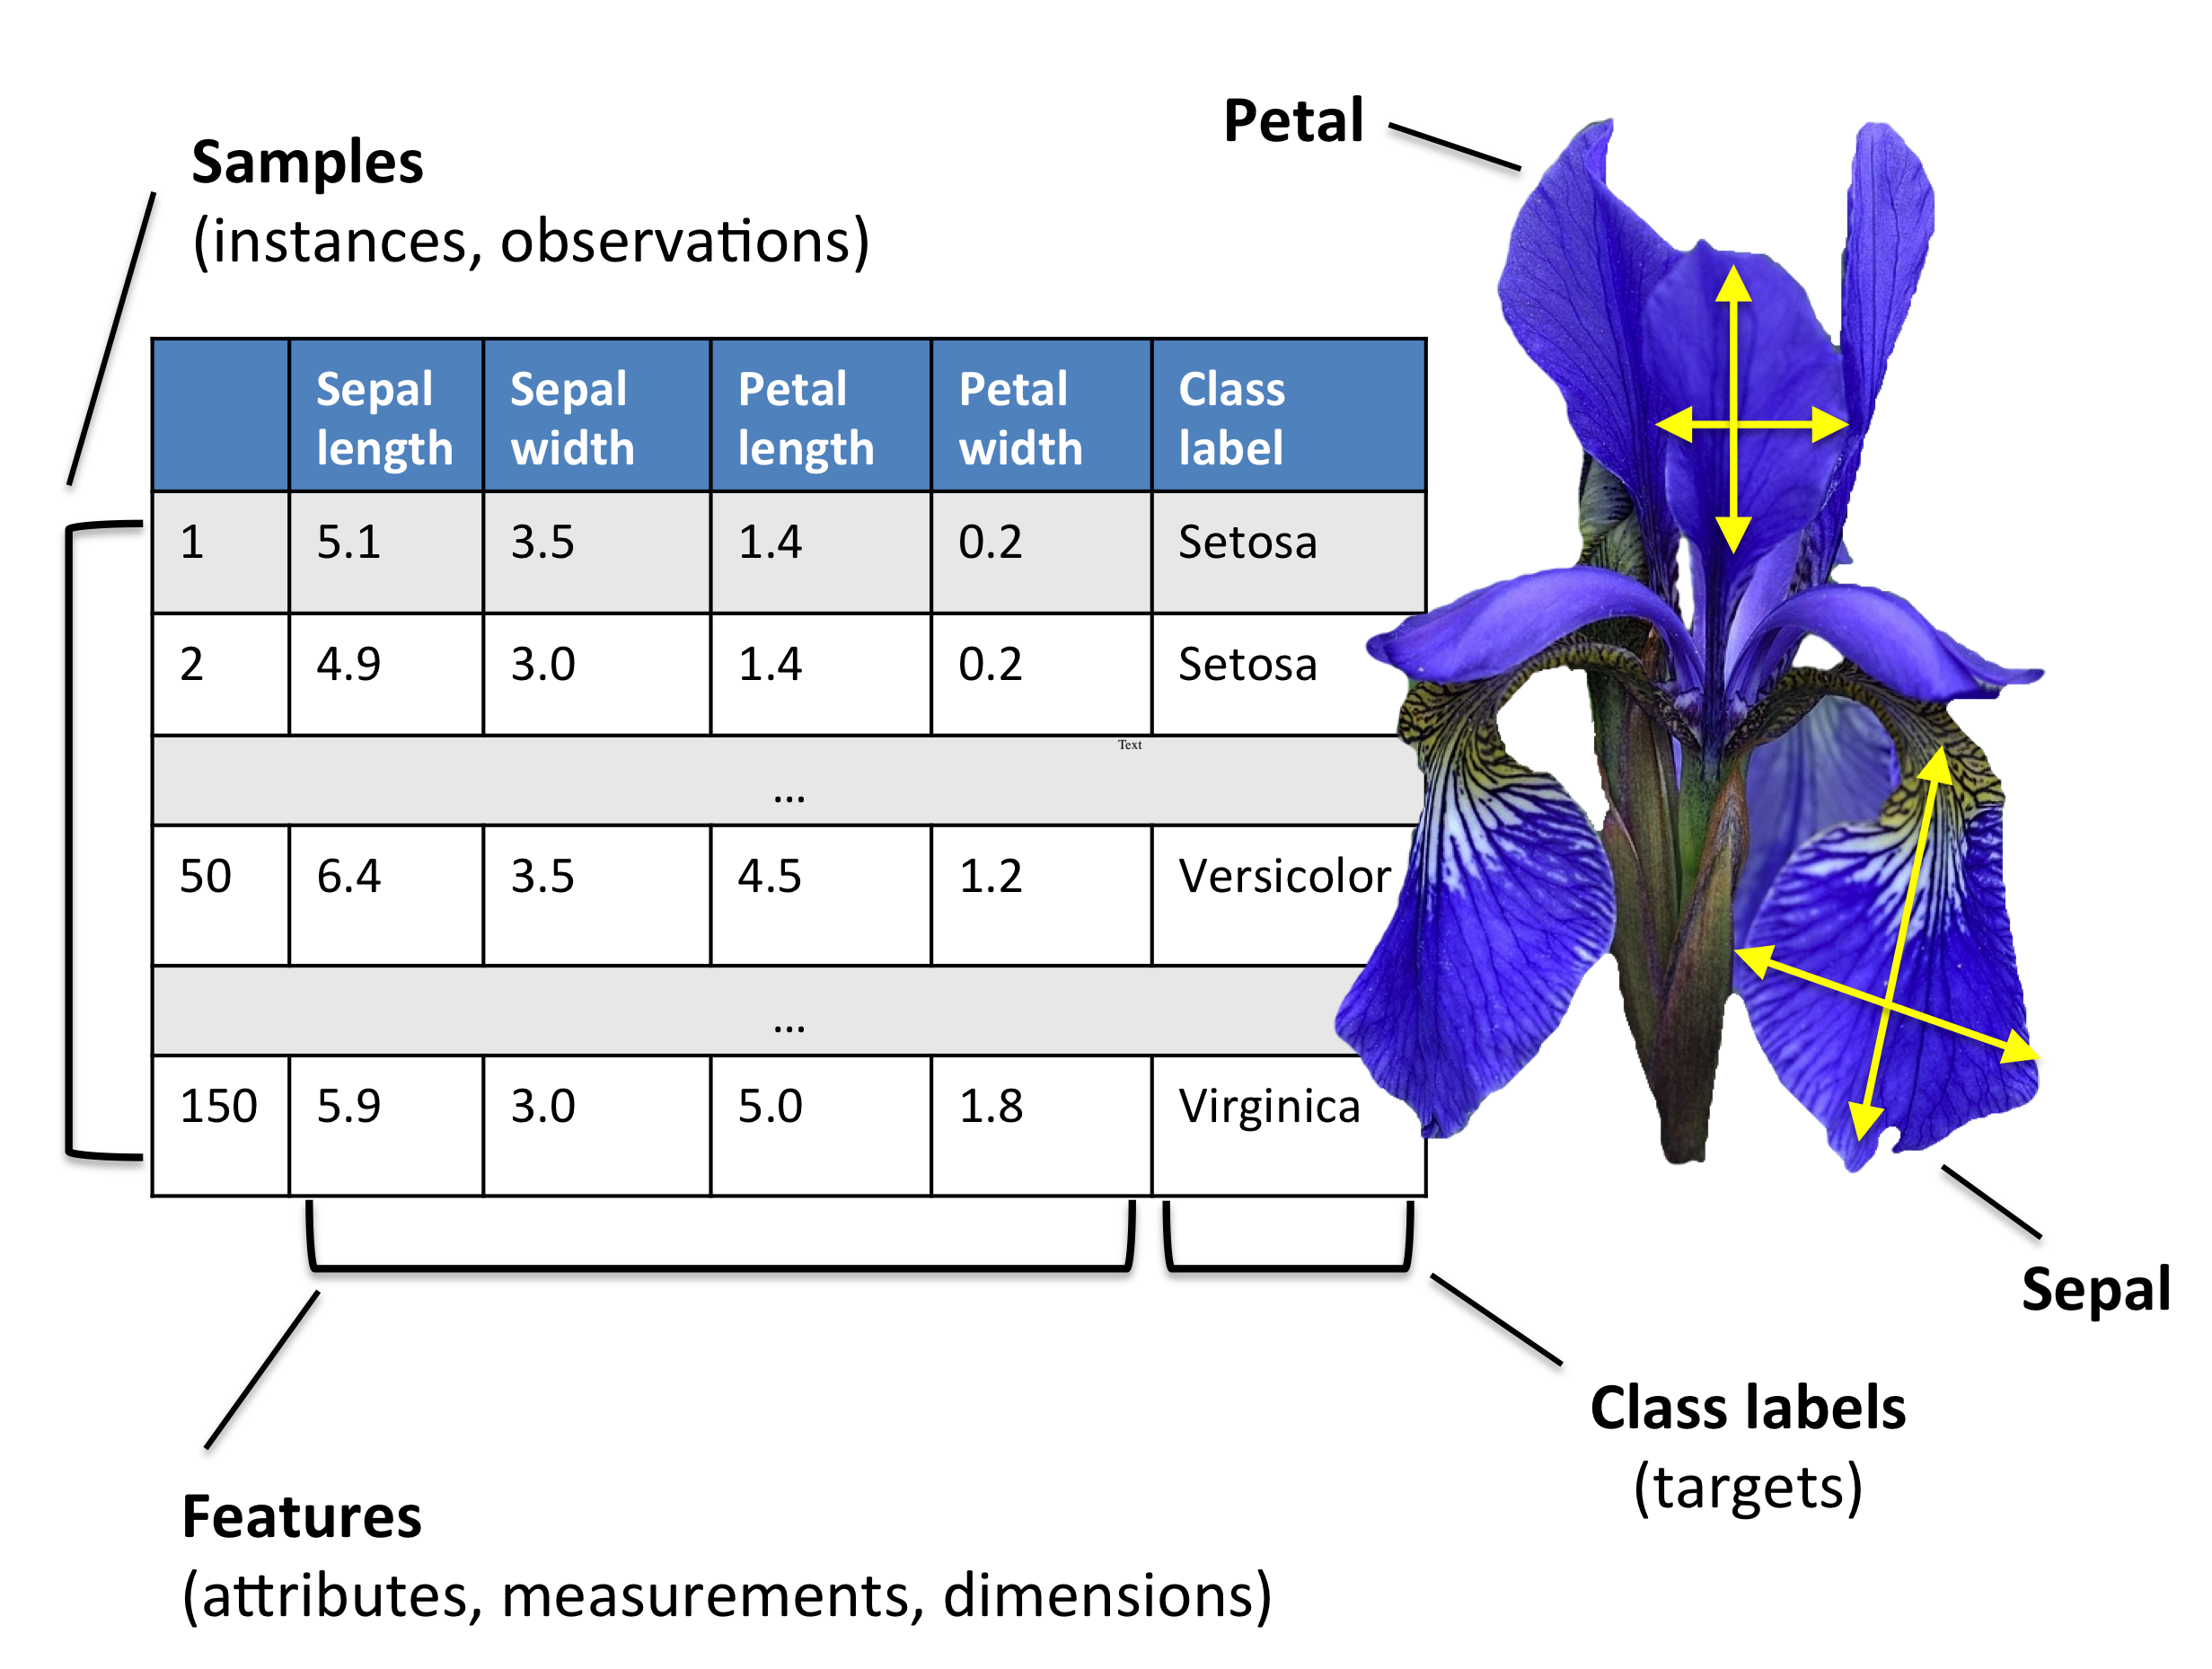
نمایش: ویژگیهای ورودی و برچسبها
میتوانستیم عکس بگیریم و آنها را (مقدار پیکسلها) بهعنوان ورودی استفاده کنیم (← یادگیری عمیق)
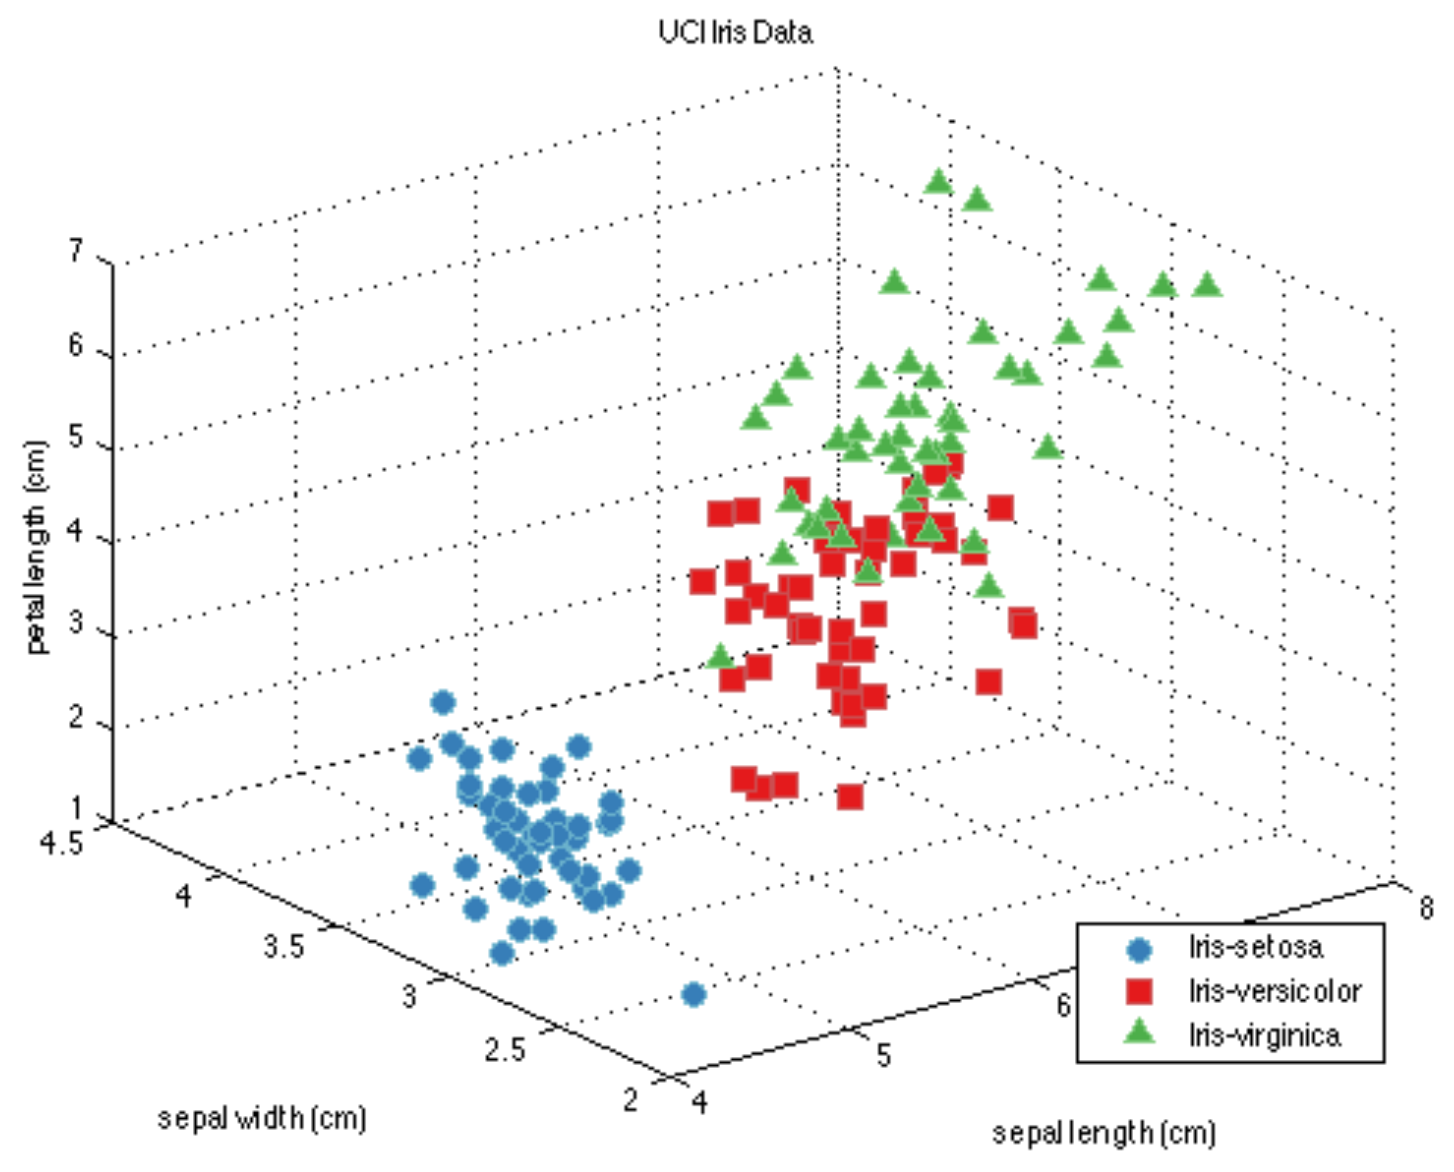
میتوانیم دستی چند ویژگی ورودی تعریف کنیم (متغیرها)، مثلاً طول و عرض برگها
هر
نمونهنقطهای در فضایی (احتمالاً با ابعاد بالا) است
رگرسیون
پیشبینی یک مقدار پیوسته، مثلاً دما
متغیر هدف عددی است
برخی الگوریتمها میتوانند یک بازهٔ اطمینان برگردانند
یافتن رابطهٔ میان پیشبینها و متغیر هدف.
Source
from mglearn.datasets import make_wave
from mglearn.plot_helpers import cm2
from sklearn.linear_model import LinearRegression, BayesianRidge
from sklearn.gaussian_process import GaussianProcessRegressor
from sklearn.gaussian_process.kernels import RBF

X2, y2 = make_wave(n_samples=60)
x = np.atleast_2d(np.linspace(-3, 3, 100)).T
lr = LinearRegression().fit(X2, y2)
ridge = BayesianRidge().fit(X2, y2)
gp = GaussianProcessRegressor(kernel=RBF(10, (1e-2, 1e2)), n_restarts_optimizer=9, alpha=0.1, normalize_y=True).fit(X2, y2)

@interact
def plot_regression(regressor=[lr, ridge, gp]):
    line = np.linspace(-3, 3, 100).reshape(-1, 1)
    plt.figure(figsize=(5*fig_scale, 5*fig_scale))
    plt.plot(X2, y2, 'o', c=cm2(0))
    if(regressor.__class__.__name__ == 'LinearRegression'):
        y_pred = regressor.predict(x)
    else:
        y_pred, sigma = regressor.predict(x, return_std=True)
        plt.fill(np.concatenate([x, x[::-1]]),
             np.concatenate([y_pred - 1.9600 * sigma,
                            (y_pred + 1.9600 * sigma)[::-1]]),
             alpha=.5, fc='b', ec='None', label='95% confidence interval')

    plt.plot(line, y_pred, 'b-')
    plt.xlabel("Input feature 1")
plt.ylabel("Target")Source
if not interactive:
    plot_regression(regressor=gp)
یادگیری ماشین بینظارت
دادهٔ بیبرچسب، یا داده با ساختار نامعلوم
کاوش ساختار داده برای استخراج اطلاعات
انواع زیادی دارد، فقط دو نوع را بررسی میکنیم.
خوشهبندی
سازمان دادن اطلاعات به زیرگروههای معنادار (خوشهها)
اشیای یک خوشه درجهای از شباهت دارند (و عدم شباهت به خوشههای دیگر)
مثال: تمایز انواع مختلف مشتری
Source
# Note: the most recent versions of numpy seem to cause problems for KMeans
# Uninstalling and installing the latest version of threadpoolctl fixes this

from sklearn.cluster import KMeans
from sklearn.datasets import make_blobs

nr_samples = 1500

@interact
def plot_clusters(randomize=(1,100,1)):
    # Generate data
    X, y = make_blobs(n_samples=nr_samples, cluster_std=[1.0, 1.5, 0.5], random_state=randomize)
    # Cluster
    y_pred = KMeans(n_clusters=3, random_state=randomize).fit_predict(X)
    # PLot
    plt.figure(figsize=(5*fig_scale, 5*fig_scale))
    plt.scatter(X[:, 0], X[:, 1], c=y_pred)
    plt.title("KMeans Clusters")
    plt.xlabel("Feature 0")
    plt.ylabel("Feature 1")
Source
if not interactive:
    plot_clusters(randomize=2)
کاهش بُعد
داده میتواند با ابعاد بسیار بالا و سخت برای فهمیدن، یادگیری و ذخیره کردن باشد، …
کاهش بُعد میتواند داده را به ابعاد کمتر فشرده کند، در حالی که بیشتر اطلاعات حفظ شود
برخلاف انتخاب ویژگی، ویژگیهای تازه معنای (اصلی) خود را از دست میدهند
نمایش تازه میتواند بسیار سادهتر مدلسازی (و تجسم) شود
Source
from sklearn.datasets import make_swiss_roll
from sklearn.manifold import locally_linear_embedding
from sklearn.decomposition import PCA
from mpl_toolkits.mplot3d import Axes3D

X, color = make_swiss_roll(n_samples=800, random_state=123)

fig = plt.figure(figsize=plt.figaspect(0.3)*fig_scale*2.5)
ax1 = fig.add_subplot(1, 3, 1, projection='3d')
ax1.xaxis.pane.fill = False
ax1.yaxis.pane.fill = False
ax1.zaxis.pane.fill = False
ax1.scatter(X[:, 0], X[:, 1], X[:, 2], c=color, cmap=plt.cm.rainbow, s=10*fig_scale)
plt.title('Swiss Roll in 3D')

ax2 = fig.add_subplot(1, 3, 2)
scikit_pca = PCA(n_components=2)
X_spca = scikit_pca.fit_transform(X)
plt.scatter(X_spca[:, 0], X_spca[:, 1], c=color, cmap=plt.cm.rainbow)
plt.title('PCA');

ax3 = fig.add_subplot(1, 3, 3)
X_lle, err = locally_linear_embedding(X, n_neighbors=12, n_components=2)
plt.scatter(X_lle[:, 0], X_lle[:, 1], c=color, cmap=plt.cm.rainbow)
plt.title('Locally Linear Embedding');یادگیری تقویتی
ساختن عاملی که کارکردش را بر پایهٔ تعامل با محیط بهتر میکند
مثال: بازیهایی مثل شطرنج، Go، …
جستوجو در فضای (بزرگی از) کنشها و حالتها
تابع پاداش تعیین میکند یک (رشته از) کنشها چقدر خوب کار میکند
یاد گرفتن رشتهای از کنشها (سیاست) که پاداش را با کاوش بیشینه میکند
یادگیری = نمایش + ارزیابی + بهینهسازی
همهٔ الگوریتمهای یادگیری ماشین از 3 جزء تشکیل شدهاند:
نمایش: مدل باید در زبانی صوری نمایش یابد که رایانه بفهمد
«مفهومهایی» را که میتواند یاد بگیرد تعیین میکند: فضای فرضیه
مثلاً درختهای تصمیم، شبکههای عصبی، نمونهمحور (k-NN)، مدلهای خطی
ارزیابی: راهی درونی برای ترجیح یک فرضیه بر دیگری
تابع هزینهٔ که کمینه میکنیم (اغلب با تنظیمکننده: )
متمایز از سنجهٔ وظیفه (مثلاً دقت، F1) که گزارش میکنیم
مثلاً اختلاف خروجی درست و پیشبینی
بهینهسازی: راهی کارا برای جستوجو در فضای فرضیه
راهبردها متفاوتاند: بهینهسازی محدب (خطی، SVM)، رشد حریصانه (درخت، boosting)، گرادیان کاهشی (شبکههای عصبی)، تنبل / بدون بهینهسازی (k-NN)
از یک فرضیهٔ اولیه شروع میکند و آن را پالایش (یا گامبهگام رشد) میدهد
روشهای زیاد، با تفاوت در سرعت، تعداد بهینه و تضمینها
مدل قدرتمند تنها وقتی سودمند است که بتوان آن را بهطور کارا نمایش، ارزیابی و بهینه کرد — این سه جزء باید متوازن باشند.
شبکههای عصبی: نمایش
شبکههای عصبی را نمونه بگیریم
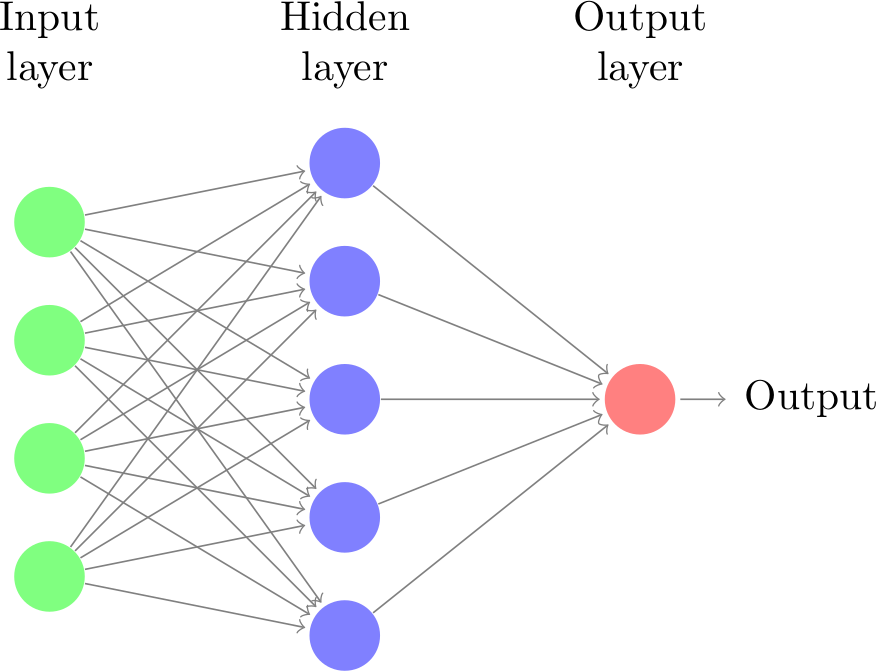
نمایش: یک شبکهٔ عصبی (لایهای)
هر اتصال یک وزن دارد (که پارامتر مدل هم نامیده میشود)
هر گره ورودیهای وزندار میگیرد، یک فعالساز غیرخطی اعمال میکند و مقدار تازه میفرستد
مدل خروجی آخرین لایه را برمیگرداند
معماری (تعداد لایهها، تعداد/نوع نورونها) ثابت است
اینها را ابرپارامتر مینامیم (کاربر تعیین میکند، در آموزش ثابت میماند)
شبکههای عصبی: ارزیابی و بهینهسازی
نمایش: با ساختار دادهشده، مدل کاملاً با پارامترهایش توصیف میشود
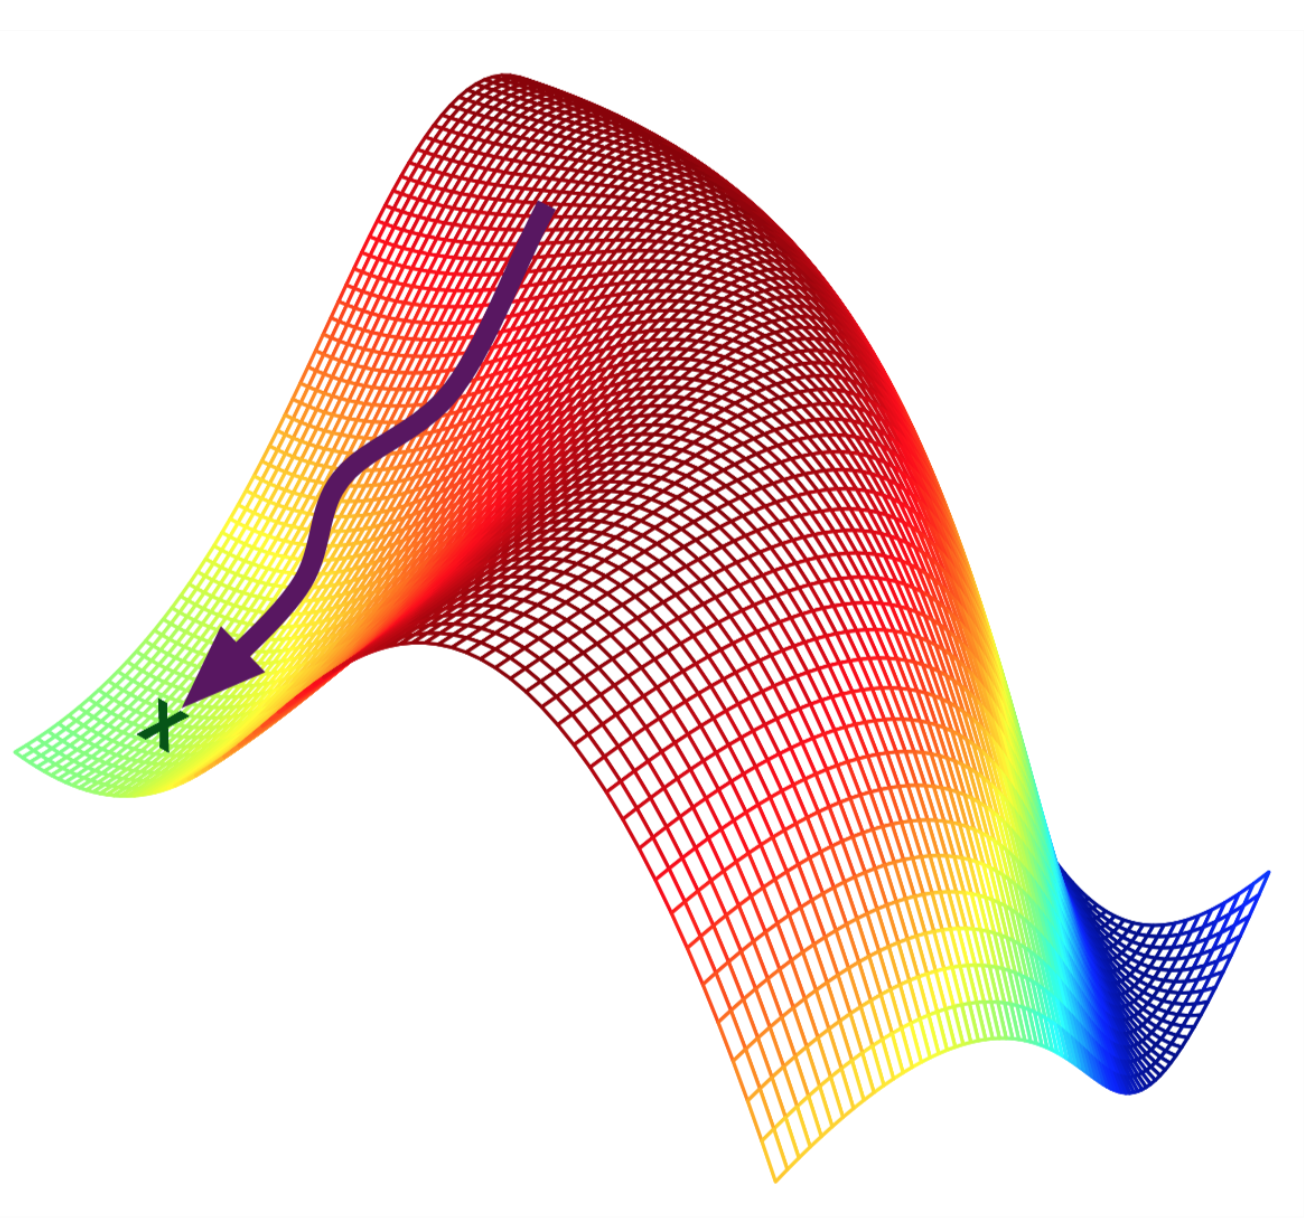
شبکهٔ کوچکی با دو وزن را تصور کنید: فضای جستوجوی دوبعدی
ارزیابی: تابع هزینهٔ میسنجد پیشبینیها چقدر با هدفها میخوانند
روی مجموعهای از دادهٔ آموزش با پیشبینیهای «درست» برآورد میشود
سطح کامل هزینه را نمیتوانیم ببینیم — فقط مجموعههای خاصی از پارامترها را میتوانیم ارزیابی کنیم
بهینهسازی: یافتن مجموعهٔ پارامتر که را کمینه میکند
معمولاً نوعی جستوجو در فضای فرضیه
مثلاً گرادیان کاهشی (بهروزرسانی همزمان همهٔ پارامترها):
بیشبرازش و کمبرازش
ساختن مدلی پیچیده که روی دادهٔ آموزش 100٪ درست است ولی روی دادهٔ تازه بسیار بد، آسان است
بیشبرازش: ساختن مدلی بسیار پیچیده برای مقدار دادهٔ در دسترس
مدل، ویژگیهای عجیب دادهٔ آموزش (نوفه، سوگیریها، …) را یاد میگیرد
حل: سادهتر کردن مدل (تنظیمکننده) یا دادهٔ بیشتر
بیشتر الگوریتمها ابرپارامتری دارند که تنظیمکنندگی را ممکن میکند
کمبرازش: ساختن مدلی بسیار ساده بهنسبت پیچیدگی داده
مدل پیچیدهتری به کار ببرید
روشهایی برای تشخیص بیشبرازش هست (مثلاً تحلیل بایاس–واریانس). بعداً بیشتر
میتوانید مجموعههایی از مدلهای زیاد بسازید تا هم کمبرازش و هم بیشبرازش را بپوشانید
اغلب یک نقطهٔ بهینه وجود دارد که باید با بهینه کردن انتخاب الگوریتمها و ابرپارامترها، یا با دادهٔ بیشتر، پیدا شود.
مثال: رگرسیون با توابع چندجملهای
Source
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score

def true_fun(X):
    return np.cos(1.5 * np.pi * X)

np.random.seed(0)
n_samples = 30
X3 = np.sort(np.random.rand(n_samples))
y3 = true_fun(X3) + np.random.randn(n_samples) * 0.1
X3_test = np.linspace(0, 1, 100)
scores_x, scores_y = [], []

show_output = True

@interact
def plot_poly(degrees = (1, 16, 1)):
    polynomial_features = PolynomialFeatures(degree=degrees,
                                             include_bias=False)
    linear_regression = LinearRegression()
    pipeline = Pipeline([("polynomial_features", polynomial_features),
                         ("linear_regression", linear_regression)])
    pipeline.fit(X3[:, np.newaxis], y3)

    # Evaluate the models using crossvalidation
    scores = cross_val_score(pipeline, X3[:, np.newaxis], y3,
                             scoring="neg_mean_squared_error", cv=10)
    scores_x.append(degrees)
    scores_y.append(-scores.mean())

    if show_output:
        fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12*fig_scale, 4*fig_scale))
        ax1.plot(X3_test, pipeline.predict(X3_test[:, np.newaxis]), label="Model")
        ax1.plot(X3_test, true_fun(X3_test), label="True function")
        ax1.scatter(X3, y3, edgecolor='b', label="Samples")
        ax1.set_xlabel("x")
        ax1.set_ylabel("y")
        ax1.set_xlim((0, 1))
        ax1.set_ylim((-2, 2))
        ax1.legend(loc="best")
        ax1.set_title("Degree {}\nMSE = {:.2e}(+/- {:.2e})".format(
            degrees, -scores.mean(), scores.std()))

        # Plot scores
        ax2.scatter(scores_x, scores_y, edgecolor='b')
        order = np.argsort(scores_x)
        ax2.plot(np.array(scores_x)[order], np.array(scores_y)[order])
        ax2.set_xlim((0, 16))
        ax2.set_ylim((10**-2, 10**11))
        ax2.set_xlabel("degree")
        ax2.set_ylabel("error", labelpad=0)
        ax2.set_yscale("log")

fig.show()Source
from IPython.display import clear_output
from ipywidgets import IntSlider, Output

if not interactive:
    show_output = False
    for i in range(1,15):
        plot_poly(degrees = i)

    show_output = True
    plot_poly(degrees = 15)
انتخاب مدل
در کنار تابع هزینهٔ (درونی) به یک تابع ارزیابی (بیرونی) نیاز داریم
سیگنال بازخورد: آیا واقعاً چیز درست را یاد میگیریم؟
آیا کمبرازش/بیشبرازش داریم؟
با دقت چنان انتخاب شود که با کاربرد بخواند.
برای انتخاب میان مدلها (و تنظیم ابرپارامترها) لازم است
© XKCD
داده باید به مجموعهٔ آموزش و آزمون تقسیم شود
پارامترهای مدل را روی مجموعهٔ آموزش بهینه کنید، روی مجموعهٔ آزمونِ مستقل ارزیابی کنید
از نشت داده بپرهیزید:
هرگز ابرپارامترها را روی دادهٔ آزمون بهینه نکنید
هرگز تکنیکهای پیشپردازش را بر اساس دادهٔ آزمون انتخاب نکنید
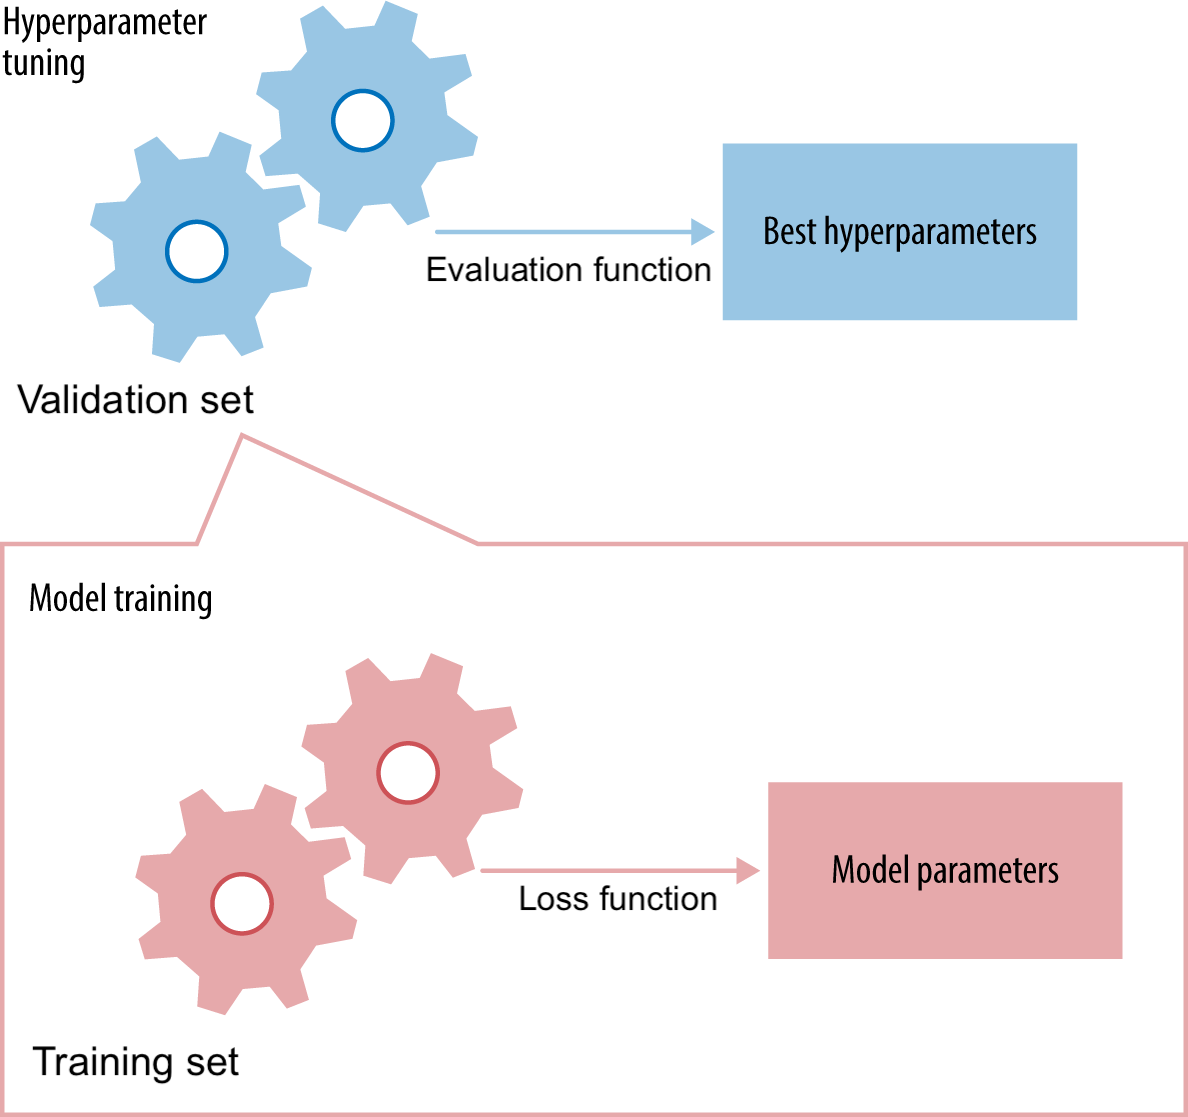
برای بهینه کردن ابرپارامترها و پیشپردازش هم، بخشی از مجموعهٔ آموزش را بهعنوان مجموعهٔ اعتبارسنجی کنار بگذارید
مجموعهٔ آزمون را در همهٔ مرحلهٔ آموزش پنهان نگه دارید
Source
import mglearn
mglearn.plots.plot_threefold_split()برای یک تنظیم ابرپارامتر، پارامترهای مدل را روی مجموعهٔ آموزش یاد بگیرید
هزینه را کمینه کنید
مدل آموزشدیده را روی مجموعهٔ اعتبارسنجی ارزیابی کنید
ابرپارامترها را طوری تنظیم کنید که سنجهٔ مشخصی (مثلاً دقت) بیشینه شود
فقط تعمیم اهمیت دارد!
هرگز مدلهای نهایی را روی دادهٔ آموزش ارزیابی نکنید، مگر برای:
پیگیری همگرایی بهینهساز (منحنیهای یادگیری)
تشخیص کمبرازش/بیشبرازش:
امتیاز کم آموزش و آزمون: کمبرازش
امتیاز بالای آموزش، امتیاز کم آزمون: بیشبرازش
همیشه یک مجموعهٔ آزمون کاملاً مستقل نگه دارید
روی مجموعهدادههای کوچک، از چند تقسیم آموزش–آزمون استفاده کنید تا سوگیری نمونهبرداری کم شود
ممکن است بهطور تصادفی مجموعهٔ آزمون «آسانی» نمونهبرداری کنید
مثلاً از اعتبارسنجی متقاطع استفاده کنید (بعداً)
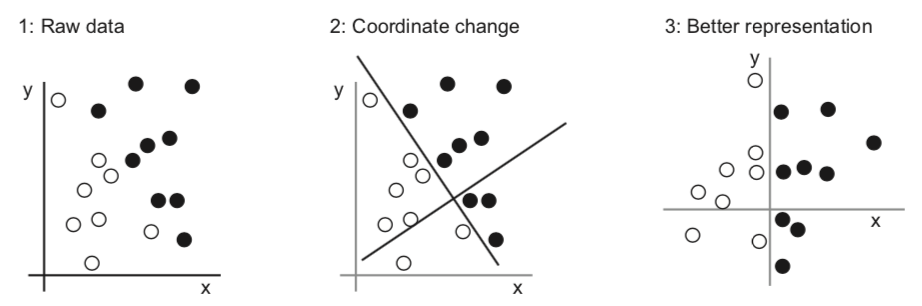
نمایش دادهٔ بهتر، مدل بهتر
الگوریتم باید ورودیها را درست به خروجیهای درست تبدیل کند
خیلی چیز به این بستگی دارد که داده را چگونه به الگوریتم نشان میدهیم
تبدیل داده به نمایشی بهتر (که کدگذاری یا جاسازی نامیده میشود)
میتواند سرتاسری انجام شود (مثلاً یادگیری عمیق) یا با «پیشپردازش» اولیهٔ داده (مثلاً انتخاب/تولید ویژگی)
مهندسی ویژگی
بیشتر تکنیکهای یادگیری ماشین نیاز دارند انسان نمایش خوبی از داده بسازد
بهویژه وقتی داده بهطور طبیعی ساختاریافته است (مثلاً جدولی با ستونهای معنادار)
مهندسی ویژگی اغلب هنوز برای بهترین نتیجه لازم است
انتخاب ویژگی، کاهش بُعد، مقیاسبندی، …
یادگیری ماشین کاربردی اساساً مهندسی ویژگی است (Andrew Ng)
هیچ چیز به پای دانش حوزه (وقتی در دسترس است) برای رسیدن به نمایش خوب نمیرسد
مثلاً دادهٔ Iris: طول/عرض برگ دستهها را خوب جدا میکند
پیشنمونهها را زود بسازید
یاد گرفتن تبدیلهای داده بهصورت سرتاسری
برای دادهٔ بیساختار (مثلاً تصویر، متن)، استخراج ویژگی خوب سخت است
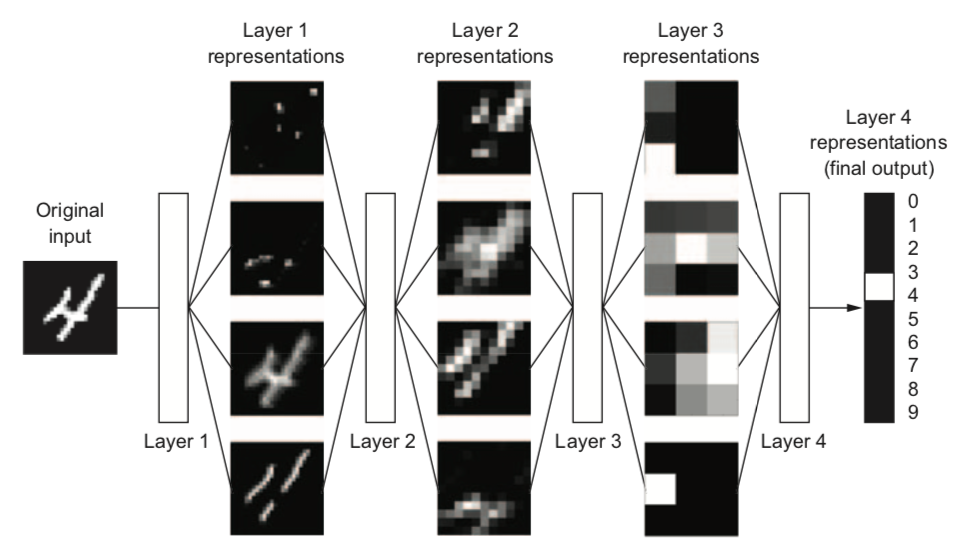
یادگیری عمیق: نمایش (جاسازی) خودتان از داده را یاد بگیرید
از راه چند لایهٔ نمایش (مثلاً لایههای نورون)
هر لایه داده را کمی دگرگون میکند، بر اساس آنچه خطا را کم میکند
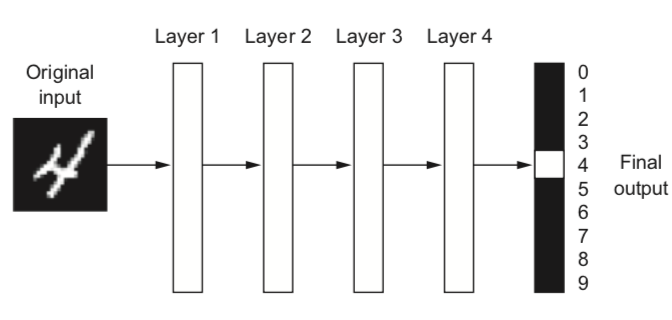
مثال: دستهبندی رقم
پیکسلهای ورودی وارد میشوند و هر لایه آنها را به نمایشی آگاهیبخشتر برای وظیفهٔ دادهشده تبدیل میکند
اغلب برای انسان کمشهودتر است
نفرین ابعاد
فقط افزودن ویژگیهای زیاد و واگذاشتن کار به مدل جواب نمیدهد
فرضهای ما (سوگیریهای استقرایی) در ابعاد بالا اغلب میشکنند:
نقطهها را بهطور تصادفی در فضایی n-بعدی نمونه بگیرید (مثلاً ابرمکعب یکه)
تقریباً همهٔ نقطهها در لبهٔ فضا پرت میشوند
فاصلهٔ هر دو نقطه تقریباً یکسان میشود
Source
# Code originally by Peter Norvig
def sample(d=2, N=100):
    return [[np.random.uniform(0., 1.) for i in range(d)] for _ in range(N)]

def corner_count(points):
    return np.mean([any([(d < .01 or d > .99) for d in p]) for p in points])

def go(Ds=range(1,200)):
    plt.figure(figsize=(5*fig_scale, 4*fig_scale))
    plt.plot(Ds, [corner_count(sample(d)) for d in Ds])
    plt.xlabel("Number of dimensions")
    plt.ylabel("Proportion of point that are 1% outliers")

go()پیامدهای عملی
برای هر بُعد (ویژگی) که میافزایید، به دادهای بهطور نمایی بیشتر نیاز دارید تا تُنُکی پیش نیاید
هر الگوریتمی را که بر فاصله استوار است تحت تأثیر میگذارد (مثلاً kNN، SVM، روشهای هسته، روشهای درختی، …)
برکت نامتوازنی: در بسیاری از کاربردها داده در زیرفضایی بسیار کوچک زندگی میکند
با انتخاب ویژگی یا استفاده از نمایشهای کمبعد میتوانید کارکرد را بهشدت بهتر کنید
«دادهٔ بیشتر میتواند الگوریتم باهوشتر را شکست دهد»
(ولی به هر دو نیاز دارید)
دادهٔ نمایندهتر احتمال بیشبرازش را کم میکند
دادهٔ بیشتر نفرین ابعاد را تخفیف میدهد: همان تعداد نقطه در فضای ویژگی با ابعاد بالا متراکمتر میشوند
مدلهای ناپارامتری: تعداد مؤثر پارامترها با داده رشد میکند
روشهای درختی، k نزدیکترین همسایه، روشهای هسته، …
تقریبزنندهٔ جهانی: با دادهٔ کافی میتوانند تابعهای پیچیدهتر را برازش دهند
مدلهای پارامتری (با اندازهٔ ثابت): تعداد ثابتی پارامتر مدل
مدلهای خطی، شبکههای عصبی با معماری ثابت، …
ظرفیت را میتوان بالا برد (میلیونها وزن) تا از دادهٔ بیشتر سود ببرد
شبکههای عمیق تقریباً هر تابعی را میتوانند تقریب بزنند، ولی آموزش ممکن است از کمینههای محلی / بهینهسازی غیرمحدب رنج ببرد
الگوریتمها هنوز مهماند: سوگیری استقرایی بهتر (فرضهای همخوان با ساختار داده) کارایی نمونه بالاتری میدهد — مدل با دادهٔ کمتر به همان دقت میرسد. همین دلیل برتری CNN بر MLP در تصویر است، و همین دلیل انتقال سوگیریهای سودمند با پیشآموزش به وظیفههای کمداده.
گلوگاه از داده به توان محاسباتی/مقیاسپذیری جابهجا میشود
ساختن سامانههای یادگیری ماشین
یک سامانهٔ معمول یادگیری ماشین چند جزء دارد که در درسهای آینده میبینیم:
پیشپردازش: دادهٔ خام بهندرت برای یادگیری آرمانی است
مقیاسبندی ویژگی: آوردن مقدارها به یک بازه
کدگذاری: عددی کردن ویژگیهای مقولهای
گسستهسازی: مقولهای کردن ویژگیهای عددی
اصلاح نامتوازنی برچسب (مثلاً نمونهکاهی)
انتخاب ویژگی: حذف ویژگیهای بیربط/همبسته
کاهش بُعد هم میتواند یادگیری داده را سادهتر کند
استفاده از جاسازیهای از پیش یادگرفته (مثلاً word-to-vector، image-to-vector)
یادگیری و ارزیابی
هر الگوریتم سوگیریهای خودش را دارد
هیچ الگوریتم واحدی همیشه بهترین نیست
انتخاب مدل مدلهای بهتر را مقایسه و انتخاب میکند
الگوریتمهای مختلف، تنظیمهای مختلف ابرپارامتر
داده را به مجموعههای آموزش، اعتبارسنجی و آزمون تقسیم کنید
پیشبینی
مدل نهاییِ بهینهشده را میتوان برای پیشبینی به کار برد
کارکرد انتظاری، کارکرد اندازهگیریشده روی مجموعهٔ آزمونِ مستقل است
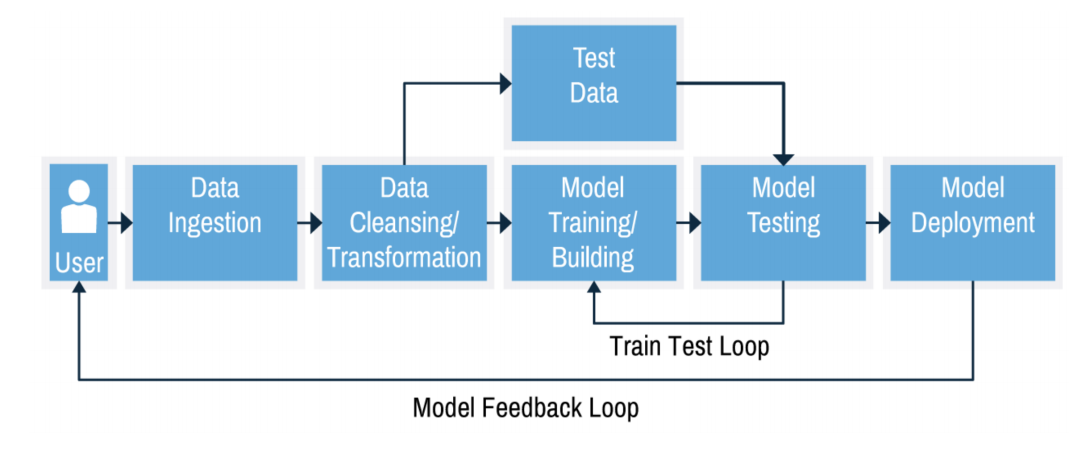
اینها با هم یک گردشکار یا خط لوله میسازند
خط لوله = زنجیرهٔ خطی و خودکار (مثلاً sklearn Pipeline)
گردشکار = چرخهٔ عمر گستردهتر شامل انسان، نسخهبندی و پایش
AutoML برای ساختن و تنظیم این خطوط لوله وجود دارد
مسئلهٔ CASH (انتخاب الگوریتم و بهینهسازی ابرپارامتر بهطور همزمان)
روشها: بهینهسازی بیزی، Hyperband، NAS، ترکیب خط لوله (TPOT)
AutoML تخصص را مقیاس میدهد؛ جانشین آن نمیشود
باید خطوط لوله را بهطور پیوسته بهینه کنید — مدل هیچوقت «تمام» نمیشود
رانش مفهوم: P(Y|X) با زمان عوض میشود (ناگهانی / تدریجی / بازگشتی)
متمایز از جابهجایی هموردا (که فقط P(X) عوض میشود)
حلقههای بازخورد: پیشبینیها دادهٔ آینده را شکل میدهند (پیشبینی اجرایی)
حلقههای خودتقویتکننده (پیشنهاددهندهها، پلیس پیشبینیکننده، پزشکی) ← تشدید سوگیری
تخفیف: آزمون A/B، کاوش، ارزیابی پادواقعی
جمعبندی
الگوریتمهای یادگیری سه جزء دارند:
نمایش: مدل که ورودی را به پیشبینی مینگارد
پارامترهای مدل با داده برازش میشوند
تابع هزینهٔ : میسنجد پیشبینیها چقدر با هدفها میخوانند
بهینهسازی:
انتخاب مدل یک مسئلهٔ دوسطحی است:
حلقهٔ درونی: برازش روی دادهٔ آموزش
حلقهٔ بیرونی: انتخاب ابرپارامترهای روی دادهٔ اعتبارسنجی
سوگیری استقرایی: فرضها دربارهٔ کلاس مدل (خطیبودن، محلیبودن، هموردایی)؛ ابرپارامترها ظرفیت درون آن کلاس را کنترل میکنند
جانشین (مشتقپذیر)ی است که بهینه میکنیم؛ سنجهٔ وظیفهای است که گزارش میکنیم (مثلاً دقت)
بیشبرازش: خطای آموزش کم، خطای آزمون زیاد
تقسیم به (چند) تقسیم آموزش–اعتبارسنجی–آزمون؛ مجموعهٔ آزمون را فقط یک بار لمس کنید
تنظیمکننده (L1/L2، dropout، توقف زودهنگام): پیچیدگی را جریمه میکند؛ قدرتش ابرپارامتری است که روی اعتبارسنجی تنظیم میشود
دادهٔ بیشتر، افزونسازی داده، انتخاب ویژگی، مجموعهها
کمبرازش: خطای آموزش و آزمون بالا — مدل بسیار ساده است؛ ظرفیت را بالا ببرید یا ویژگیها را بهتر کنید
خطوط لولهٔ یادگیری ماشین: پیشپردازش + یادگیری + استقرار + پایش