خوشهبندی، بخش 1
الگوریتمهای خوشهبندی میکوشند از ویژگیهای داده، تقسیم بهینه یا برچسبگذاری گسستهٔ گروههایی از نقطهها را یاد بگیرند.
خوشهبندی وظیفهٔ افراز نقطههای داده به گروههای طبیعیِ خوشه است، چنان که نقطههای درون یک گروه بسیار شبیه و نقطههای گروههای مختلف تا حد ممکن نامشابه باشند Zaki & Meira (2020).
بسته به داده و ویژگیهای مطلوب خوشه، الگووارههای مختلفی وجود دارد: نمایندهمحور، سلسلهمراتبی، چگالیمحور، گرافمحور و خوشهبندی طیفی. خوشهبندی رویکردی بینظارت است، چون برای یاد گرفتن پارامترهای مدل به مجموعهدادهٔ آموزش جداگانه نیاز ندارد.
یک الگوریتم جستوجوی کامل یا تمامشماری برای یافتن خوشهبندی خوب این است که همهٔ افرازهای ممکن نقطه به خوشه تولید شود، برای هر کدام امتیازی حساب شود و خوشهبندی با بهترین امتیاز نگه داشته شود. ولی این آشکارا ناممکن است، چون تعداد خوشهبندیهای نقطه به گروه است.
الگوریتمهای خوشهبندی زیادی در Scikit-Learn و جاهای دیگر هست، ولی شاید سادهترین برای فهمیدن
الگوریتمی به نام خوشهبندی k-means باشد که در sklearn.cluster.KMeans پیاده شده است.
با واردکردنهای استاندارد شروع میکنیم:
Source
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('seaborn-v0_8-whitegrid')
import numpy as np
import warnings
warnings.filterwarnings("ignore")
معرفی k-means
الگوریتم k-means در مجموعهدادهٔ چندبعدیِ بیبرچسب، تعداد از پیش تعیینشدهای خوشه میجوید. این کار را با تصور سادهای از خوشهبندی بهینه انجام میدهد:
مرکز خوشه میانگین حسابی همهٔ نقطههای آن خوشه است.
هر نقطه به مرکز خوشهٔ خودش نزدیکتر است تا به مراکز خوشههای دیگر.
این دو فرض پایهٔ مدل k-means هستند. بهزودی میبینیم الگوریتم چگونه به این جواب میرسد، ولی فعلاً یک مجموعهدادهٔ ساده را ببینیم و نتیجهٔ k-means را نگاه کنیم.
نخست یک مجموعهدادهٔ دوبعدی با چهار تودهٔ متمایز تولید کنیم. برای تأکید بر اینکه این الگوریتم بینظارت است، برچسبها را از تجسم کنار میگذاریم (شکل زیر):
from sklearn.datasets import make_blobs
X, y_true = make_blobs(n_samples=300, centers=4,
                       cluster_std=0.60, random_state=0)

fig, ax = plt.subplots()
plt.scatter(X[:, 0], X[:, 1], s=20)
ax.set_aspect('equal')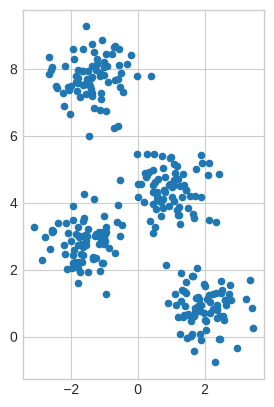
با چشم نسبتاً آسان میتوان چهار خوشه را تشخیص داد. الگوریتم k-means این کار را خودکار انجام میدهد و در Scikit-Learn از API معمول برآوردگر استفاده میکند:
from sklearn.cluster import KMeans
kmeans = KMeans(n_clusters=4)
kmeans.fit(X)
y_kmeans = kmeans.predict(X)
نتایج را با رنگآمیزی داده بر پایهٔ این برچسبها تجسم کنیم (شکل زیر). مراکز خوشه را هم که برآوردگر k-means تعیین کرده رسم میکنیم:
fig, ax = plt.subplots()
plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=20, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='black', s=100)
ax.set_aspect('equal')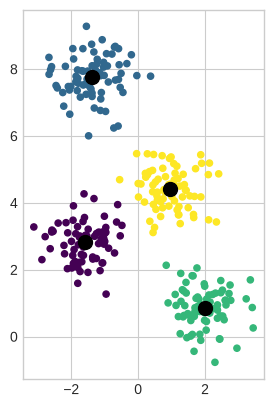
خبر خوب این است که الگوریتم k-means (دستکم در این حالت ساده) نقطهها را بسیار شبیه به آنچه با چشم تخصیص میدادیم به خوشهها میدهد. ولی شاید بپرسید این الگوریتم چگونه این خوشهها را چنان سریع مییابد: تعداد ترکیبهای ممکن تخصیص خوشه با تعداد نقطهها بهطور نمایی رشد میکند و جستوجوی تمامشماری بسیار پرهزینه میشد.
خوشبختانه چنین جستوجویی لازم نیست: رویکرد معمول k-means یک روش تکراری شهودی به نام امید–بیشینهسازی است.
امید–بیشینهسازی
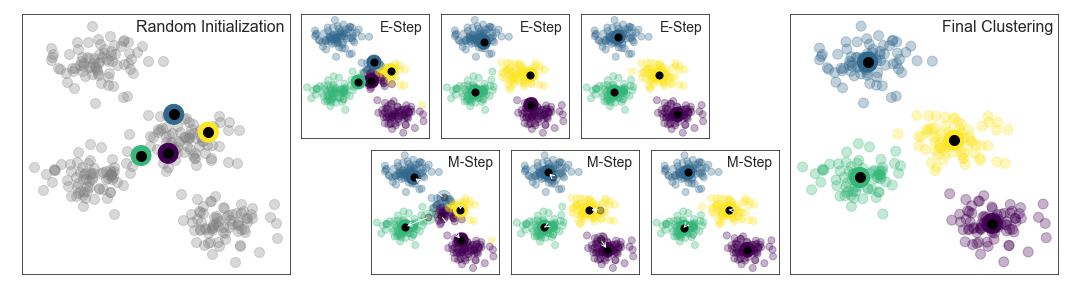
امید–بیشینهسازی (E–M) الگوریتمی توانمند است که در زمینههای گوناگون علم داده پیش میآید. k-means نمونهای بهویژه ساده و فهمپذیر از این الگوریتم است و اینجا کوتاه مرور میکنیم. به کوتاهی، رویکرد امید–بیشینهسازی اینجا از روند زیر تشکیل میشود:
چند مرکز خوشه حدس بزن.
تا همگرایی تکرار کن:
گام E: نقطهها را به نزدیکترین مرکز خوشه تخصیص بده.
گام M: مراکز خوشه را میانگین نقطههای تخصیصیافتهشان بگذار.
گام E یا گام امید چنین نامیده میشود چون انتظار ما از اینکه هر نقطه به کدام خوشه تعلق دارد را بهروز میکند. گام M یا گام بیشینهسازی چنین نامیده میشود چون تابع برازشی را بیشینه میکند که جای مراکز خوشه را تعیین میکند — در این حالت این بیشینهسازی با گرفتن میانگین سادهٔ داده در هر خوشه انجام میشود.
ادبیات این الگوریتم بسیار گسترده است ولی میتوان چنین خلاصه کرد: در شرایط معمول، هر تکرار گام E و گام M همیشه به برآورد بهتری از ویژگیهای خوشه میانجامد.
میتوانیم الگوریتم را مطابق شکل زیر تجسم کنیم. برای این مقدار اولیهٔ خاص، خوشهها در فقط سه تکرار همگرا میشوند. (برای نسخهٔ تعاملی این شکل، به کد در پیوست آنلاین نگاه کنید.)
الگوریتم k-means بهقدری ساده است که در چند خط کد نوشته شود. پیادهسازی بسیار سادهای در ادامه است (شکل زیر را ببینید):
from sklearn.metrics import pairwise_distances_argmin

def find_clusters(X, n_clusters, rseed=2):
    # 1. Randomly choose clusters
    rng = np.random.RandomState(rseed)
    i = rng.permutation(X.shape[0])[:n_clusters]
    centers = X[i]

    while True:
        # 2a. Assign labels based on closest center
        labels = pairwise_distances_argmin(X, centers)

        # 2b. Find new centers from means of points
        new_centers = np.array([X[labels == i].mean(0)
                                for i in range(n_clusters)])

        # 2c. Check for convergence
        if np.all(centers == new_centers):
            break
        centers = new_centers

    return centers, labels

centers, labels = find_clusters(X, 4)
fig, ax = plt.subplots()
plt.scatter(X[:, 0], X[:, 1], c=labels,
            s=20, cmap='viridis')
ax.set_aspect('equal') 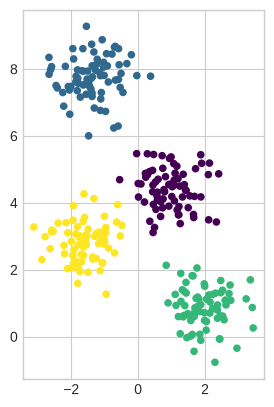
بیشتر پیادهسازیهای آزمودهشده کمی بیش از این کار میکنند، ولی تابع بالا جانِ رویکرد امید–بیشینهسازی را نشان میدهد.
هنگام استفاده از الگوریتم امید–بیشینهسازی باید به چند نکته توجه داشت:
ممکن است نتیجهٔ بهینهٔ کلی به دست نیاید
نخست اینکه هرچند روند E–M تضمین میشود در هر گام نتیجه را بهتر کند، تضمینی نیست به جواب کلی بهترین برسد. مثلاً اگر در روند سادهٔ خود از بذر تصادفی دیگری استفاده کنیم، حدسهای آغازینِ آن اجرا به نتیجههای بدی میرسند (شکل زیر):
centers, labels = find_clusters(X, 4, rseed=0)
fig, ax = plt.subplots()
plt.scatter(X[:, 0], X[:, 1], c=labels,
            s=20, cmap='viridis')
ax.set_aspect('equal')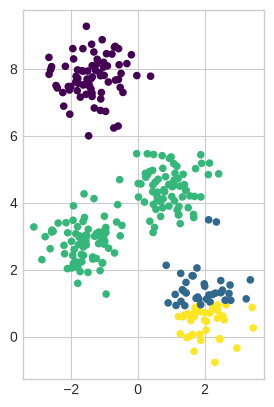
اینجا رویکرد E–M همگرا شده، ولی به پیکربندی بهینهٔ کلی همگرا نشده است. به همین دلیل رایج است که
الگوریتم با چند حدس آغازین متفاوت اجرا شود، همانطور که Scikit-Learn بهطور پیشفرض انجام میدهد
(این تعداد با پارامتر n_init تعیین میشود که پیشفرضش 10 است).
تعداد خوشهها باید از پیش انتخاب شود
چالش رایج دیگر k-means این است که باید بگویید چند خوشه انتظار دارید: نمیتواند تعداد خوشهها را از داده یاد بگیرد. مثلاً اگر از الگوریتم بخواهیم شش خوشه پیدا کند، بیدرنگ پیش میرود و بهترین شش خوشه را مییابد، همانطور که در شکل 47-6 آمده است:
labels = KMeans(6, random_state=0).fit_predict(X)
fig, ax = plt.subplots()
plt.scatter(X[:, 0], X[:, 1], c=labels, s=20, cmap='viridis')
ax.set_aspect('equal')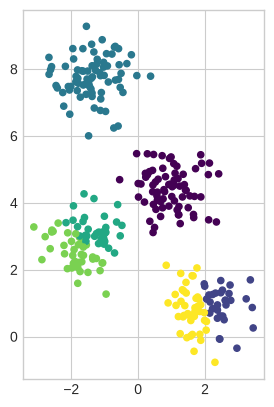
اینکه نتیجه معنادار است یا نه پرسشی است که پاسخ قطعی به آن سخت است؛ یک رویکرد نسبتاً شهودی که اینجا بیشتر دربارهٔ آن بحث نمیکنیم تحلیل سیلوئت نام دارد.
بهجای آن میتوانید الگوریتم خوشهبندی پیچیدهتری به کار ببرید که سنجهٔ کمّی بهتری برای برازش به ازای
تعداد خوشه دارد (مثلاً مدلهای مخلوط گاوسی؛ به صفحهٔ مدلهای مخلوط گاوسی نگاه کنید) یا میتواند
تعداد مناسب خوشه را انتخاب کند (مثلاً DBSCAN، mean-shift یا affinity propagation، که همه در
زیرماژول sklearn.cluster موجودند).
k-means به مرزهای خوشهٔ خطی محدود است
فرضهای بنیادی مدل k-means (نقطهها به مرکز خوشهٔ خود نزدیکترند تا به بقیه) باعث میشود الگوریتم اگر خوشهها هندسهٔ پیچیده داشته باشند اغلب بیاثر باشد.
بهویژه، مرزهای میان خوشههای k-means همیشه خطیاند (مثل حالت 1 در نظریهٔ تصمیم بیزی)، یعنی برای مرزهای پیچیدهتر شکست میخورد. دادهٔ زیر را همراه با برچسبهای خوشهای که رویکرد معمول k-means یافته ببینید (شکل زیر):
from sklearn.datasets import make_moons
X, y = make_moons(200, noise=.05, random_state=0)
labels = KMeans(2, random_state=0).fit_predict(X)
plt.scatter(X[:, 0], X[:, 1], c=labels, s=50, cmap='viridis')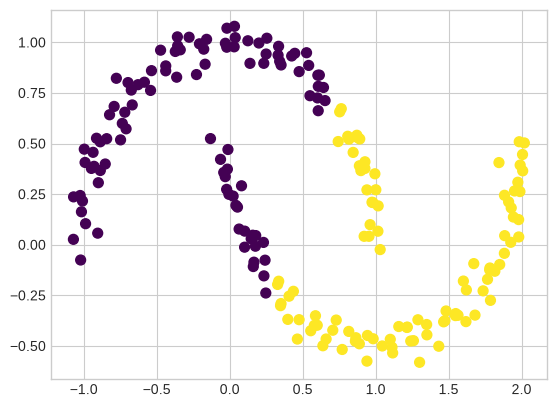
این وضعیت یادآور بحث فصلهای بعدی است، جایی که از تبدیل هسته برای تصویر کردن داده به فضایی با ابعاد بالاتر استفاده کردیم که جداسازی خطی در آن ممکن است. میتوان تصور کرد همین شگرد به k-means اجازه دهد مرزهای غیرخطی را کشف کند.
یک نسخه از k-means هستهای در Scikit-Learn با برآوردگر SpectralClustering پیاده شده است
Fayaz (2015)Nemati (2018). این روش از گراف نزدیکترین همسایهها برای محاسبهٔ
نمایشی با ابعاد بالاتر از داده استفاده میکند و بعد برچسبها را با الگوریتم k-means تعیین میکند:
from sklearn.cluster import SpectralClustering
model = SpectralClustering(n_clusters=2, affinity='nearest_neighbors',
                           assign_labels='kmeans')
labels = model.fit_predict(X)
plt.scatter(X[:, 0], X[:, 1], c=labels, s=50, cmap='viridis')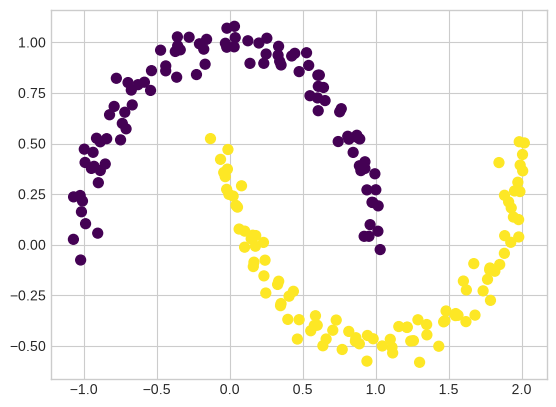
میبینیم که با این رویکرد تبدیل هسته، k-means هستهای میتواند مرزهای غیرخطیِ پیچیدهتر میان خوشهها را بیابد.
k-means برای تعداد زیاد نمونه میتواند کند باشد
چون هر تکرار k-means باید به همهٔ نقطههای مجموعهداده دسترسی داشته باشد، الگوریتم با رشد تعداد نمونهها نسبتاً کند میشود. شاید بپرسید آیا میتوان این نیاز به استفاده از همهٔ داده در هر تکرار را سست کرد؛ مثلاً در هر گام فقط از زیرمجموعهای از داده برای بهروزرسانی مراکز خوشه استفاده کنید.
این همان ایدهٔ الگوریتمهای k-means دستهای است که یک شکلش در
sklearn.cluster.MiniBatchKMeans پیاده شده است. رابط آن همانند KMeans استاندارد است؛ در ادامه
مثالی از کاربردش را میبینیم.
مثالها
با دقت در این محدودیتهای الگوریتم، میتوانیم از k-means در موقعیتهای گوناگون به سود خود استفاده کنیم. اکنون چند مثال را میبینیم.
مثال 1: k-means روی ارقام
برای شروع، k-means را روی همان دادهٔ سادهٔ ارقام به کار میبریم که در درختهای تصمیم و جنگلهای تصادفی و تحلیل مؤلفههای اصلی هم به کار بردیم. اینجا میکوشیم با k-means ارقام مشابه را بدون استفاده از اطلاعات برچسب اصلی شناسایی کنیم؛ این میتواند شبیه گام اول استخراج معنا از مجموعهدادهٔ تازهای باشد که هیچ اطلاعات برچسب پیشینی دربارهٔ آن ندارید.
با بارگذاری مجموعهداده شروع میکنیم و بعد خوشهها را مییابیم. یادآوری میکنیم مجموعهدادهٔ ارقام از 1797 نمونه با 64 ویژگی تشکیل شده که هر یک از 64 ویژگی روشنایی یک پیکسل در تصویری 8×8 است:
from sklearn.datasets import load_digits
digits = load_digits()
digits.data.shape
(1797, 64)خوشهبندی مانند قبل انجام میشود:
kmeans = KMeans(n_clusters=10, random_state=0)
clusters = kmeans.fit_predict(digits.data)
kmeans.cluster_centers_.shape
(10, 64)نتیجه 10 خوشه در 64 بعد است. توجه کنید که خود مراکز خوشه نقطههایی 64-بعدیاند و میتوان آنها را نمایندهٔ رقم «معمول» درون خوشه دانست. ببینیم این مراکز خوشه چه شکلیاند (شکل زیر):
fig, ax = plt.subplots(2, 5, figsize=(8, 3))
centers = kmeans.cluster_centers_.reshape(10, 8, 8)
for axi, center in zip(ax.flat, centers):
    axi.set(xticks=[], yticks=[])
    axi.imshow(center, interpolation='nearest', cmap=plt.cm.binary)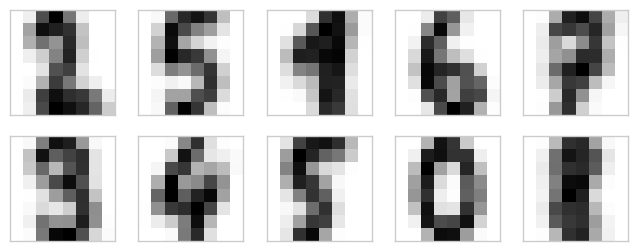
میبینیم که حتی بدون برچسبها، KMeans میتواند خوشههایی بیابد که مراکزشان ارقام قابل
بازشناسیاند، شاید بهجز 1 و 8.
چون k-means هیچ چیزی از هویت خوشهها نمیداند، برچسبهای 0 تا 9 ممکن است جای هم باشند. میتوانیم این را با تناظر دادن هر برچسب خوشهٔ یادگرفته با برچسبهای واقعیِ یافتشده در خوشهها اصلاح کنیم:
from scipy.stats import mode

labels = np.zeros_like(clusters)
for i in range(10):
    mask = (clusters == i)
    labels[mask] = mode(digits.target[mask])[0]
اکنون میتوانیم بررسی کنیم خوشهبندی بینظارتمان در یافتن ارقام مشابه در داده چقدر دقیق بوده است:
from sklearn.metrics import accuracy_score
accuracy_score(digits.target, labels)0.7440178074568725با فقط یک الگوریتم سادهٔ k-means، گروهبندی درست 74٪ از ارقام ورودی را کشف کردیم! ماتریس درهمریختگی این کار را در شکل زیر ببینیم:
from sklearn.metrics import confusion_matrix
import seaborn as sns
mat = confusion_matrix(digits.target, labels)
sns.heatmap(mat, square=True, annot=True, fmt='d',
            cbar=False, cmap='Blues',
            xticklabels=digits.target_names,
            yticklabels=digits.target_names)
plt.xlabel('predicted label')
plt.ylabel('true label');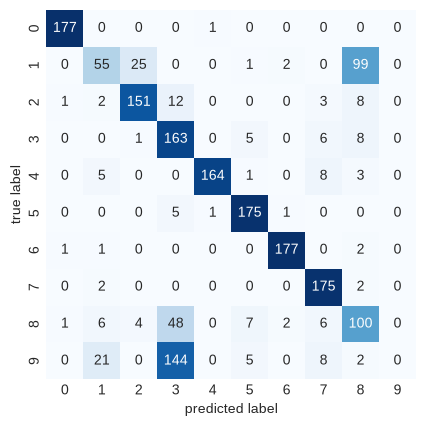
همانطور که از مراکز خوشهٔ پیشین انتظار داشتیم، نقطهٔ اصلی ابهام میان هشتها و یکها است. با این حال این نشان میدهد با k-means میتوانیم اساساً یک دستهبند رقم بدون ارجاع به هیچ برچسب شناختهشده بسازیم!
برای تفریح، کمی جلوتر برویم. میتوانیم الگوریتم جاسازی همسایگی تصادفی تیتوزیع (t-SNE) را (که در یادگیری منیفولد آمده) برای پیشپردازش داده پیش از اجرای k-means به کار ببریم. t-SNE الگوریتم جاسازی غیرخطی است که بهویژه در حفظ نقطههای درون خوشهها توانا است. ببینیم چطور کار میکند:
from sklearn.manifold import TSNE

# Project the data: this step will take several seconds
tsne = TSNE(n_components=2, init='random',
            learning_rate='auto',random_state=0)
digits_proj = tsne.fit_transform(digits.data)

# Compute the clusters
kmeans = KMeans(n_clusters=10, random_state=0)
clusters = kmeans.fit_predict(digits_proj)

# Permute the labels
labels = np.zeros_like(clusters)
for i in range(10):
    mask = (clusters == i)
    labels[mask] = mode(digits.target[mask])[0]

# Compute the accuracy
accuracy_score(digits.target, labels)0.9415692821368948این 94٪ دقت دستهبندی بدون استفاده از برچسبها است. این توان یادگیری بینظارت است وقتی با دقت به کار رود: میتواند اطلاعاتی از مجموعهداده استخراج کند که استخراجش با دست یا چشم دشوار است.
مثال 2: k-means برای فشردهسازی رنگ
یک کاربرد جالب خوشهبندی، فشردهسازی رنگ در تصویر است (این مثال از «چندهگذاری رنگ با K-Means» در Scikit-Learn گرفته شده). مثلاً تصور کنید تصویری با میلیونها رنگ دارید. در بیشتر تصویرها بخش بزرگی از رنگها به کار نمیروند و بسیاری از پیکسلها رنگهای مشابه یا حتی یکسان دارند.
برای نمونه، تصویر شکل زیر را از ماژول datasets در Scikit-Learn در نظر بگیرید (برای این کار باید
بستهٔ PIL نصب باشد): (برای نسخهٔ رنگی این تصویر و تصویرهای بعدی، نسخهٔ آنلاین کتاب را ببینید).
# Note: this requires the PIL package to be installed
from sklearn.datasets import load_sample_image
china = load_sample_image("china.jpg")
ax = plt.axes(xticks=[], yticks=[])
ax.imshow(china);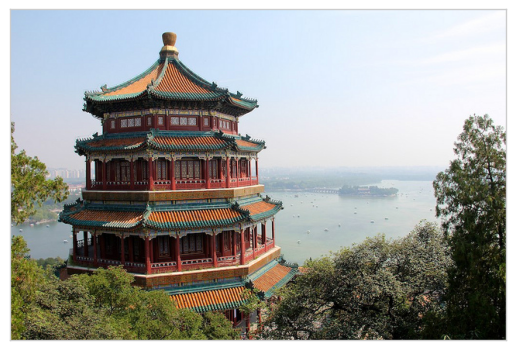
خود تصویر در آرایهای سهبعدی با اندازهٔ (height, width, RGB) ذخیره شده است که سهم قرمز/آبی/سبز
را بهصورت عددهای صحیحی از 0 تا 255 دارد:
china.shape(427, 640, 3)یک راه دیدن این مجموعه پیکسلها، ابری از نقطهها در فضای رنگ سهبعدی است. داده را به شکل
[n_samples, n_features] تغییر میدهیم و رنگها را چنان مقیاسبندی میکنیم که میان 0 و 1 بیفتند:
data = china / 255.0  # use 0...1 scale
data = data.reshape(-1, 3)
data.shape
(273280, 3)میتوانیم این پیکسلها را در فضای رنگ تجسم کنیم و برای کارایی از زیرمجموعهای با 10000 پیکسل استفاده کنیم (شکل زیر):
def plot_pixels(data, title, colors=None, N=10000):
    if colors is None:
        colors = data

    # choose a random subset
    rng = np.random.default_rng(0)
    i = rng.permutation(data.shape[0])[:N]
    colors = colors[i]
    R, G, B = data[i].T

    fig, ax = plt.subplots(1, 2, figsize=(16, 6))
    ax[0].scatter(R, G, color=colors, marker='.')
    ax[0].set(xlabel='Red', ylabel='Green', xlim=(0, 1), ylim=(0, 1))

    ax[1].scatter(R, B, color=colors, marker='.')
    ax[1].set(xlabel='Red', ylabel='Blue', xlim=(0, 1), ylim=(0, 1))

    fig.suptitle(title, size=20);
plot_pixels(data, title='Input color space: 16 million possible colors')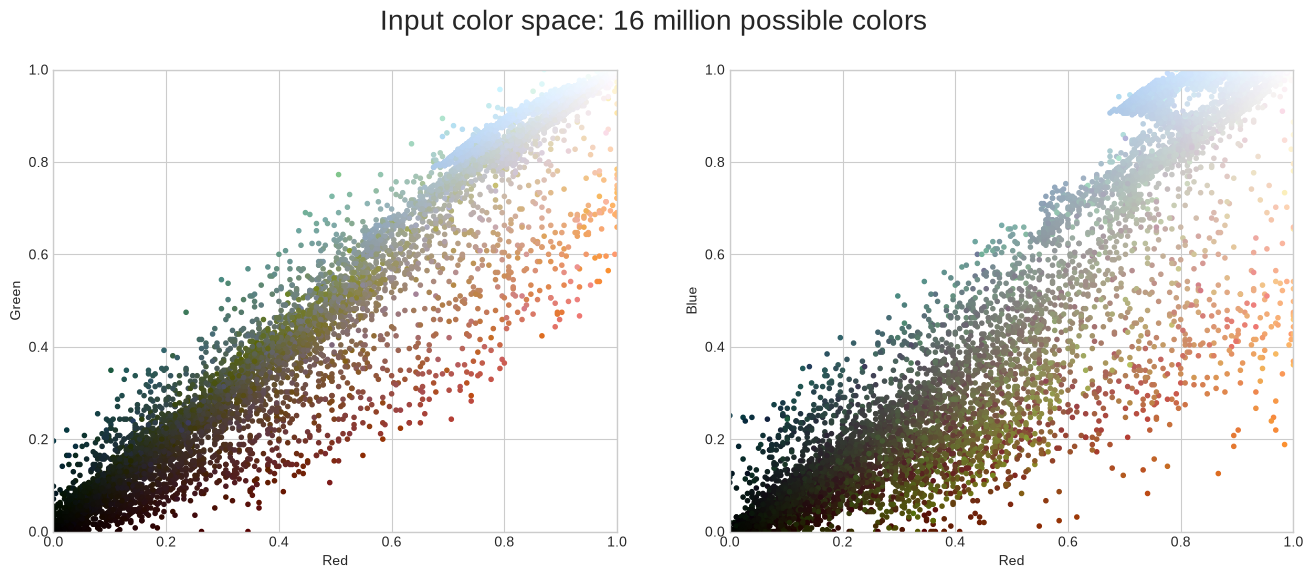
اکنون این 16 میلیون رنگ را به فقط 16 رنگ کاهش دهیم و از خوشهبندی k-means روی فضای پیکسل استفاده کنیم. چون با مجموعهدادهٔ بسیار بزرگی سر و کار داریم، از k-means کوچکدستهای استفاده میکنیم که روی زیرمجموعههایی از داده کار میکند و نتیجه را (شکل زیر) بسیار سریعتر از الگوریتم استاندارد k-means میدهد:
from sklearn.cluster import MiniBatchKMeans
kmeans = MiniBatchKMeans(16)
kmeans.fit(data)
new_colors = kmeans.cluster_centers_[kmeans.predict(data)]

plot_pixels(data, colors=new_colors,
            title="Reduced color space: 16 colors")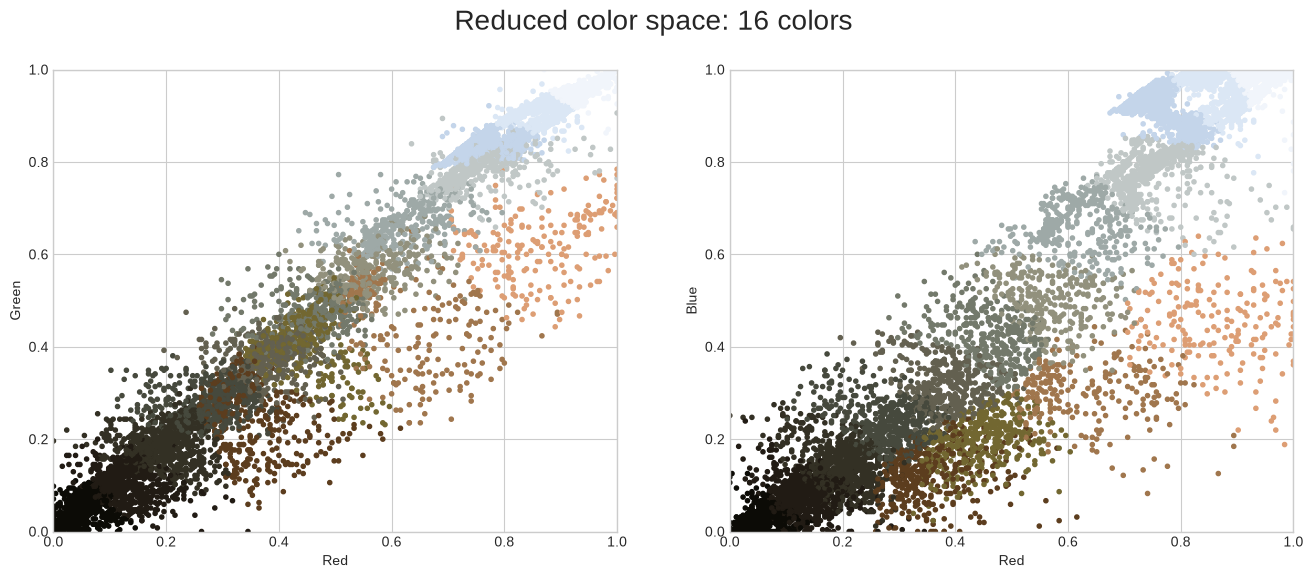
نتیجه بازرنگیکردن پیکسلهای اصلی است که هر پیکسل رنگ نزدیکترین مرکز خوشهاش را میگیرد. رسم این رنگهای تازه در فضای تصویر بهجای فضای پیکسل اثر این کار را نشان میدهد (شکل زیر):
china_recolored = new_colors.reshape(china.shape)

fig, ax = plt.subplots(1, 2, figsize=(16, 6),
                       subplot_kw=dict(xticks=[], yticks=[]))
fig.subplots_adjust(wspace=0.05)
ax[0].imshow(china)
ax[0].set_title('Original Image', size=16)
ax[1].imshow(china_recolored)
ax[1].set_title('16-color Image', size=16);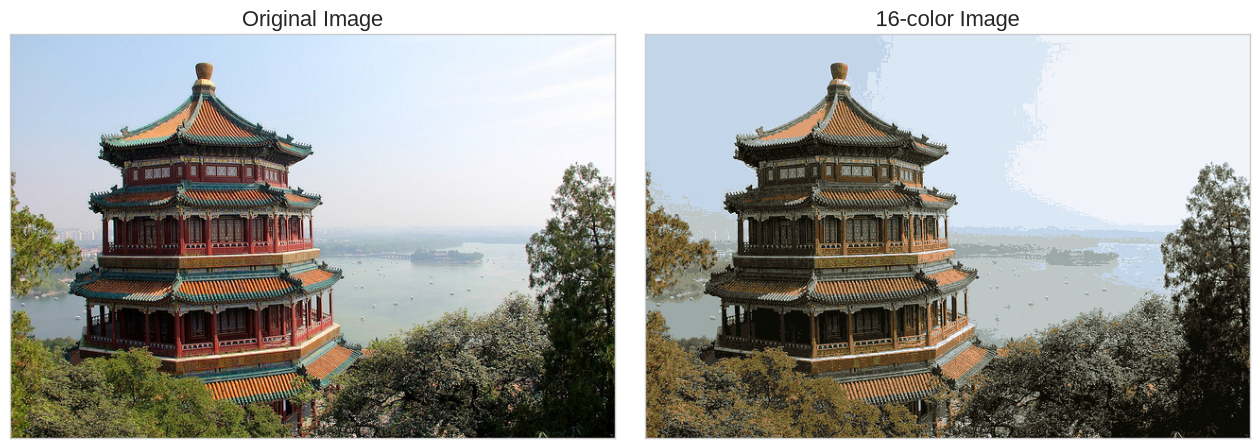
بیشک جزئیاتی در پنل سمت راست از دست رفته، ولی تصویر کلی هنوز بهآسانی قابل بازشناسی است. از نظر بایتهای لازم برای ذخیرهٔ دادهٔ خام، تصویر سمت راست ضریب فشردهسازی حدود یک میلیون میدهد! البته این رویکرد به وفاداری روشهای فشردهسازی تصویرِ ساختهشده برای همین کار مثل JPEG نمیرسد، ولی مثال توانِ فکر کردن بیرون از چارچوب با روشهای بینظارت مثل k-means را نشان میدهد.
تمرینها
اتحاد را اثبات کنید و با آن نشان دهید تخصیص هر نقطه به نزدیکترین مرکز نمیتواند SSE را زیاد کند.
نشان دهید برای افرازی ثابت، SSE با مرکز کمینه میشود: نسبت به مشتق بگیرید و گرادیان را صفر بگذارید. چرا این کار جواب بستهٔ کل مسئله را نمیدهد؟
k-means نوتبوک را روی ارقام با و پنج مقدار اولیهٔ متفاوت اجرا کنید و پراکندگی SSE نهایی و شاخص رند تعدیلشده را گزارش کنید. کدام بیشتر تغییر میکند و چرا؟
یک گام E و یک گام M را دستی برای مخلوط گاوسی دوجزئی یکبعدی روی نقطههای انجام دهید. مسئولیتها را با تخصیص سخت k-means مقایسه کنید.
مطالعهٔ بیشتر
Scikit-learn: Comparing different clustering algorithms on toy datasets
مطالعهٔ بیشتر
Scikit-learn: Comparing different clustering algorithms on toy datasets
- Zaki, M. J., & Meira, W. (2020). Data Mining and Machine Learning: Fundamental Concepts and Algorithms (2nd ed.). Cambridge University Press. https://www.cambridge.org/9781108497367
- Fayaz, T. (2015). Spectral clustering for image segmentation [Mathesis, Hakim Sabzevari University, Faculty of Mathematics]. https://hcloud.hsu.ac.ir/index.php/s/Y4BedGEY7OjXVgK
- Nemati, M. (2018). A Gradient Based Method for the Spectral Graph Partitioning [Mathesis, Hakim Sabzevari University, Faculty of Mathematics]. https://hcloud.hsu.ac.ir/index.php/s/tR53d9306yZSAc7