نظریهٔ تصمیم بیزی
محمود امینطوسی، پاییز ۱۴۰۵
گروه علوم کامپیوتر، دانشگاه فردوسی مشهد
این صفحه از فصل 2 کتاب Pattern Classification نوشتهٔ دودا، هارت و استورک (Duda et al. (2000)) پیروی میکند، همراه با شکلها و مثال ماهی همان کتاب. برآوردهایی که چگالیها را پر میکنند از صفحهٔ MLE میآیند؛ هندسهٔ حالت گاوسی در صفحهٔ فاصلهٔ ماهالانوبیس کار شده است، و فرض سادهکنندهای که چگالیها را محاسباتی میکند موضوع Naive Bayes است.
هدفهای یادگیری. در پایان باید بتوانید
فرمول بیز را برای یک مسئلهٔ دستهبندی بنویسید و بگویید کدام عامل پیشین، درستنمایی، شاهد و پسین است؛
ماتریس زیان و ریسک شرطی را تعریف کنید و نشان دهید زیان صفر-یک همان قاعدهٔ کمینهنرخ خطاست؛
تابع ممیز کلاسهای گاوسی را در سه حالت فصل دودا — کوواریانس همسانگرد، برابر و دلخواه — استنتاج کنید؛
بگویید مرز تصمیم در هر حالت چه شکلی است: ابرصفحهای عمود بر خط میان میانگینها، ابرصفحهای کلی، یا سطحی درجهدوم؛
هندسه را از مقادیر ویژهٔ ماتریس کوواریانس بخوانید.
مقدمه
نظریهٔ تصمیم بیزی رویکردی آماری به دستهبندی الگو است.
مبادلههای میان تصمیمهای دستهبندی را با احتمالها و هزینهها کمّی میکند.
فرض میکند همهٔ احتمالهای مربوط شناختهشدهاند.
مثال: دستهبندی ماهی (سیباس در برابر سالمون) بر پایهٔ ویژگیهایی مثل روشنایی.
مفاهیم کلیدی
وضعیت طبیعت (): دستهٔ واقعی را نشان میدهد (مثلاً سیباس یا سالمون).
احتمال پیشین (): احتمال یک دسته پیش از مشاهدهٔ هر دادهای.
چگالی احتمال شرطی-دسته (): چگالی احتمال مشاهدهٔ بهشرط دستهٔ .
احتمال پسین (): احتمال دستهٔ پس از مشاهدهٔ ویژگیهای .
فرمول بیز
قضیهٔ بیز:
یعنی پسین = درستنمایی × پیشین / شاهد. شاهد () ثابت نرمالسازی است و در دستهبندی اغلب نادیده گرفته میشود چون برای همهٔ دستهها یکسان است.
مثال ماهی در ادامه یکبعدی است: آنجا مشاهدهٔ یک ویژگی تک است، روشنایی ماهی، و منحنی است نه سطح.
خواندن فرمول
آنچه پسین را تعیین میکند ضرب درستنمایی در پیشین است؛ شاهد فقط عاملی مقیاسی است که هست تا پسینها جمعشان یک شود. درستنمایی را به این نام میخوانند چون با فرض ثابت بودن بقیه چیزها، دستهای که این مقدار برایش بزرگ است محتملتر است.
شکلهای 2.1 و 2.2 دو نیمهٔ استدلال را برای ماهی نشان میدهند: چگالیهای شرطی-دسته، و پسینهایی که با پیشینهای و میسازند.
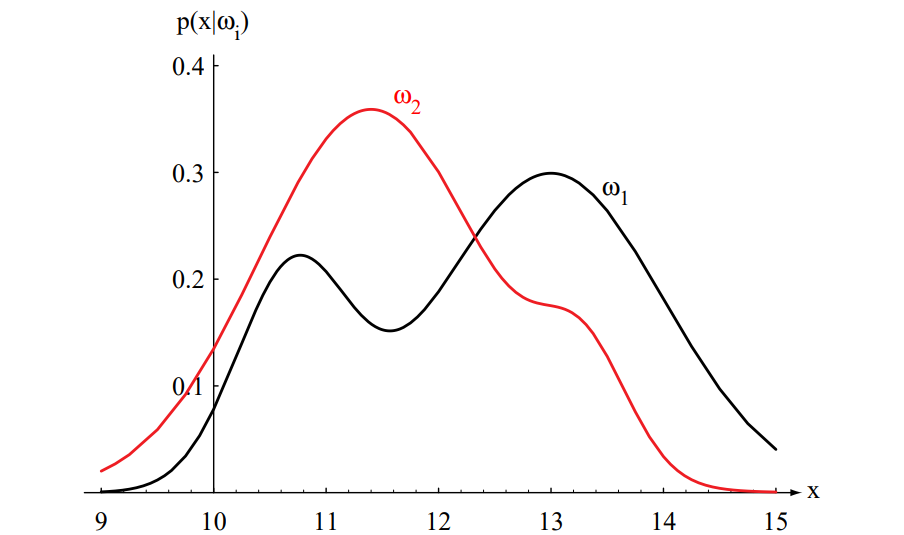
شکل 2.1: چگالیهای شرطی-دستهٔ فرضی برای روشنایی سیباس () و سالمون (). هر منحنی یک چگالی است، پس مساحت زیرش 1 است.
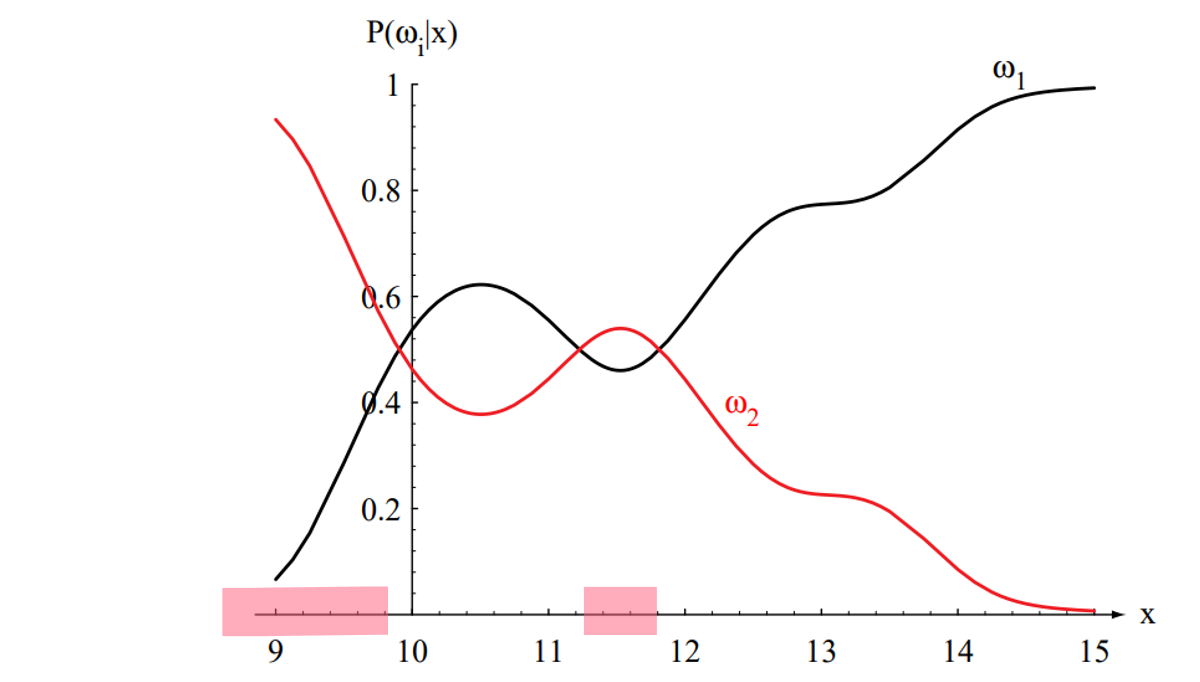
شکل 2.2: پسینهای چگالیهای شکل 2.1 با و . در پسین حدود و پسین حدود است؛ در هر جمع دو پسین 1 است.
ریسک و قاعدههای تصمیم
زیان و ریسک شرطی
قاعدهٔ کمینهخطا حالت خاص معیاری کلیتر است. کنشهای موجود باشند — در دستهبندی، «تصمیم بگیر » — و زیان گرفتن کنش وقتی دستهٔ واقعی است. ریسک شرطی کنش برای مشاهدهٔ چنین است
و قاعدهٔ تصمیم بیز کنش با کمترین ریسک را برمیگزیند:
زیان صفر-یک وقتی مقدار و در غیر این صورت 1 میگذارد، یعنی هر خطا را یکسان قیمتگذاری میکند. ریسک شرطیاش احتمال اشتباه بودن است،
پس کمینه کردن ریسک همان بیشینه کردن پسین است. زیانهای نابرابر — اینکه بیماری از دست رفته گرانتر از هشدار کاذب تمام شود — فقط آستانهٔ تصمیم را جابهجا میکنند؛ ماشین را عوض نمیکنند.
دستهبندی با کمترین نرخ خطا
اگر تصمیم بگیر ، وگرنه .
همارز آن، چون شاهد برای هر دو دسته مشترک است، اگر
باشد تصمیم بگیر .
احتمال خطا برای یک مشاهدهٔ دادهشده چنین است
حالتهای خاص
دو حالت نشان میدهند کدام عامل تصمیم را میراند.
اگر ، مشاهده در هر دو دسته به یک اندازه محتمل است و چیزی به ما نمیگوید؛ تصمیم کاملاً بر پیشینها میایستد.
اگر ، دستهها از پیش هماحتمالاند و تصمیم کاملاً بر درستنماییها میایستد.
در حالت کلی هر دو مهماند و قاعدهٔ آنها را ترکیب میکند؛ همین ترکیب است که احتمال خطا را کمینه میکند.
بیش از دو دسته
با دسته همان قاعده بدون تغییر اعمال میشود: را به دستهای بده که پسین را بیشینه میکند، که — همانطور که بالا نشان داده شد — کنش کمترین ریسک زیر زیان صفر-یک است:
برای هر دسته یک پسین حساب میکنیم و نواحی که دستهٔ در آنها برنده است با سطوح از هم جدا میشوند.
توابع ممیز
تابع ممیز هر تابعی است که مقدارش برای دستهای که میخواهیم برگزینیم بزرگترین است؛ دستهبند برای هر دسته یکی حساب میکند و بیشینه را برمیگزیند.
برای کمترین نرخ خطا انتخاب آشکار خود پسین است،
و چون شاهد عاملی مثبت و مشترک است میتوان از صورت استفاده کرد،
یا از لگاریتمش، که ضرب را به جمع و نمایی گاوسی را به صورت درجهدوم تبدیل میکند:
هر تابع یکنوای یک ممیز، خودش یک ممیز است، و هر ضریب مثبت یا ثابت جمعی را میتوان حذف کرد: دستهبندی تغییر نمیکند. همین آزادی است که حالت گاوسی را در ادامه محاسباتی میکند.
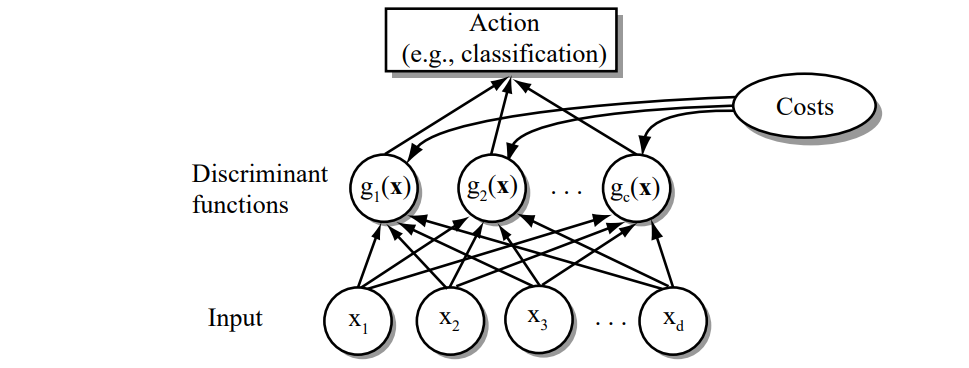
شکل 2.5: ساختار یک دستهبند آماری کلی — ورودی، تابع ممیز، و یک انتخابگر بیشینه. فلشها جریان اطلاعات را نشان میدهند.
چگالی نرمال
حالت تکمتغیره
چگالی نرمال تکمتغیره چنین است
با امید ریاضی (میانگینی روی فضای ویژگی)
و واریانس
نرمال تکمتغیره کاملاً با و مشخص میشود؛ مینویسیم . نمونهها حول میانگین جمع میشوند با پخششدگیای که انحراف معیار تعیین میکند (شکل 2.7).
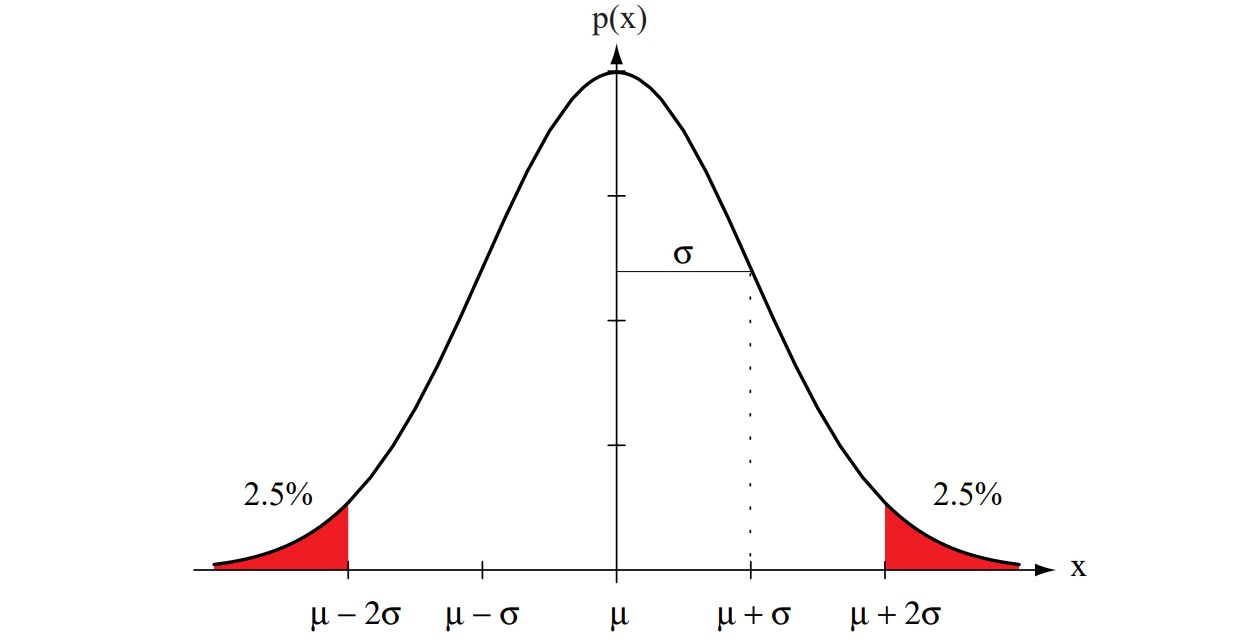
شکل 2.7: نرمال تکمتغیره تقریباً مساحتش داخل است؛ مقدار قله است.
چگالی نرمال چندمتغیره
که بردار میانگین و ماتریس کوواریانس جای دو اسکالر حالت تکمتغیره را میگیرند.
تعریفهای رسمی
امید ریاضی یک بردار یا ماتریس درایهبهدرایه گرفته میشود: با مؤلفهٔ ام و درایهٔ ام ،
ویژگیهای ماتریس کوواریانس
متقارن و مثبت نیمهمعین است؛ فرض میکنیم مثبت معین است، تا و وارونش وجود داشته باشد.
درایهٔ قطری واریانس است، یعنی .
درایهٔ غیرقطری کوواریانس و است؛ برای طول و وزن جمعیتی از ماهی انتظار مثبت بودنش را داریم.
اگر و از نظر آماری مستقل باشند ؛ اگر همهٔ درایههای غیرقطری صفر شوند، به ضرب چگالیهای نرمال تکمتغیره تجزیه میشود.
پارامترها و هندسه
نرمال چندمتغیره کاملاً با پارامتر مشخص میشود: درایهٔ و درایهٔ مستقل .
نمونهها در یک خوشه میافتند که مرکزش و شکلش است. مکانهای چگالی ثابت ابربیضیهای
هستند که محورهای اصلیشان بردارهای ویژهٔ و طول محورهایشان از مقادیر ویژه میآید. خود صورت درجهدوم همان مربع فاصلهٔ ماهالانوبیس از تا است: کانتورهای چگالی ثابت، کانتورهای فاصلهٔ ماهالانوبیس ثابتاند و حجمی که در بر میگیرند پخششدگی نمونهها را میسنجد.
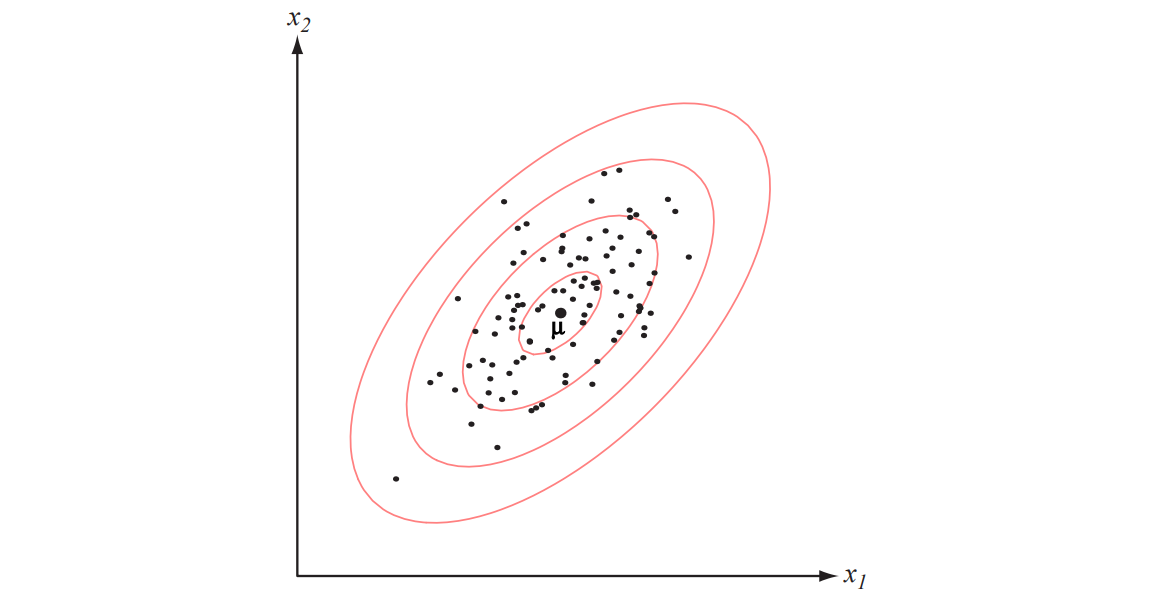
شکل 2.9: نمونههای یک گاوسی دوبعدی در ابری به مرکزیت میافتند؛ بیضیهای قرمز خطوط چگالی احتمال برابرند.
توابع ممیز برای چگالیهای نرمال
حالت 1: کوواریانس همسانگرد، 
سادهترین حالت: همهٔ دستهها کوواریانس کرهگون یکسان دارند. آنگاه و ، پس چگالی و لگاریتمش چنیناند
با جایگذاری در و حذف جملهٔ چون برای همهٔ دستهها یکسان است:
با پیشینهای برابر قاعده این است که « را به نزدیکترین میانگین بده»، با فاصلهٔ اقلیدسی مقیاسشده با . با پیشینهای نابرابر، نقطهای که به دو میانگین یکسان نزدیک است به دستهٔ از پیش محتملتر داده میشود، چون داور تساوی است.
شکل خطی و مرز
با بسط صورت درجهدوم،
جملهٔ به بستگی ندارد و بهعنوان ثابت جمعی حذف میشود، که ممیزی خطی باقی میگذارد
که آستانه (یا بایاس) دستهٔ است. دستهبندی که از ممیزهای خطی ساخته شود یک ماشین خطی است: سطوح تصمیمش تکههایی از ابرصفحهاند که با برای دو دستهای که پسینشان بزرگترین است داده میشوند. برای دو دسته آن معادله چنین خوانده میشود
پس مرز ابرصفحهای است که از میگذرد و بر عمود است — عمود، یعنی بر خطی که دو میانگین را وصل میکند. با پیشینهای برابر نقطهٔ میانی است و مرز عمودمنصف پارهٔ میان دو میانگین؛ با پیشینهای نابرابر مرز از میانگین محتملتر دور میشود، به اندازهای که وقتی در برابر بزرگ است بزرگ میشود و وقتی میانگینها دورند ناچیز.
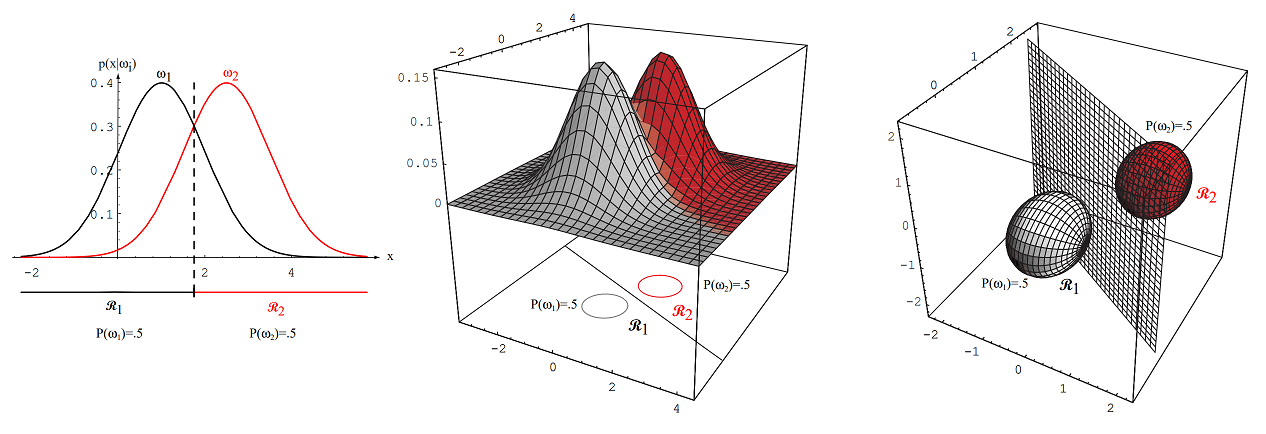
شکل 2.10: با کوواریانسهای همسانگرد برابر، نواحی دستهها با ابرصفحهای تعمیمیافته از بُعد جدا میشوند که بر خط وصلکنندهٔ میانگینها عمود است.
دستهبند کمترین فاصله
اگر همهٔ پیشینها هم برابر باشند، ثابت جمعی است و قاعده به سنجیدن فاصلهٔ اقلیدسی و دادن نزدیکترین میانگین فرو میکاهد. این همان دستهبند کمترین فاصله است. اگر هر میانگین را نمونهٔ آرمانی (prototype) دستهاش بخوانیم، رویهای تطبیق الگو میشود، و دقیقاً همان قاعدهٔ نزدیکترین همسایهٔ فصل پیش است با یک الگو برای هر دسته بهجای کل مجموعهٔ آموزش.
ابرصفحه در دو بُعد چه شکلی است
معادلهٔ میگوید برای هر نقطهٔ روی سطح، بردار بر عمود است، پس:
عمود بر سطح است و جهتگیریاش را تعیین میکند؛
یک نقطهٔ ثابت روی سطح است؛
در سطح یک خط است و معادله به تبدیل میشود.
مثلاً با و خط است. سلول بعد آن را همراه با بردار عمود رسم میکند.
import matplotlib.pyplot as plt
import numpy as np

# Define the normal vector w and point x0
w = np.array([2, 1])  # Normal vector
x0 = np.array([1, 1])  # Point on the line

# Define the line equation: 2x + y - 3 = 0 => y = -2x + 3
x_values = np.linspace(-5, 5, 100)  # Range of x values
y_values = -2 * x_values + 3  # Corresponding y values

# Plot the line
plt.plot(x_values, y_values, label=r"Line: $2x + y - 3 = 0$")

# Plot the point x0
plt.scatter(x0[0], x0[1], color="red", label=r"Point $\mathbf{x}_0 = (1, 1)$")

# Plot the normal vector w starting from x0
plt.quiver(x0[0], x0[1], w[0], w[1], angles='xy', scale_units='xy', scale=1, color="green", label=r"Normal vector $\mathbf{w} = (2, 1)$")

# Add labels and legend
plt.xlabel("x")
plt.ylabel("y")
plt.axhline(0, color="black", linewidth=0.5)  # x-axis
plt.axvline(0, color="black", linewidth=0.5)  # y-axis
plt.grid(True)
plt.legend()
plt.title("Line and Normal Vector Visualization")
plt.xlim(-5, 5)  # Adjust x-axis limits
plt.ylim(-5, 5)  # Adjust y-axis limits
plt.gca().set_aspect("equal", adjustable="box")  # Equal aspect ratio
plt.show()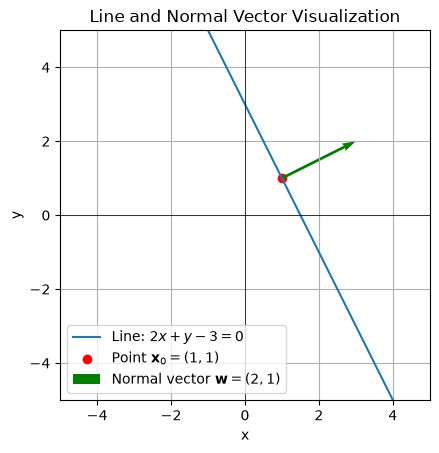
حالت 2: ماتریسهای کوواریانس برابر ولی دلخواه، 
وقتی همهٔ دستهها کوواریانس غیرکرهگون یکسان دارند، ممیز کلی
از گاوسی پس از حذف و به دست میآید، که اکنون برای همهٔ دستهها مشترکاند. با بسط جملهٔ درجهدوم (با استفاده از اینکه متقارن است، پس ):
جملهٔ اول به بستگی ندارد و حذف میشود؛ آنچه میماند باز هم خطی است،
پس مرزها ابرصفحهاند. با گذاشتن :
هندسهٔ حالت 2
مرز را بهصورت بنویسید با
بردار عمود در راستای است که بهطور کلی راستای نیست: کوواریانس مشترک مرز را میچرخاند. فقط وقتی متناسب با باشد به حالت 1 برمیگردیم. با پیشینهای برابر لگاریتم حذف میشود و مرز از میگذرد، ولی بر خط میان میانگینها عمود نیست.
سطوح فاصلهٔ ماهالانوبیس ثابت از دو میانگین ابربیضیهایی همشکل و همجهتاند، یکی برای هر دسته، چون مشترک است. خطیبودن مرز فقط به این دلیل است که جملههای درجهدوم در حذف میشوند.
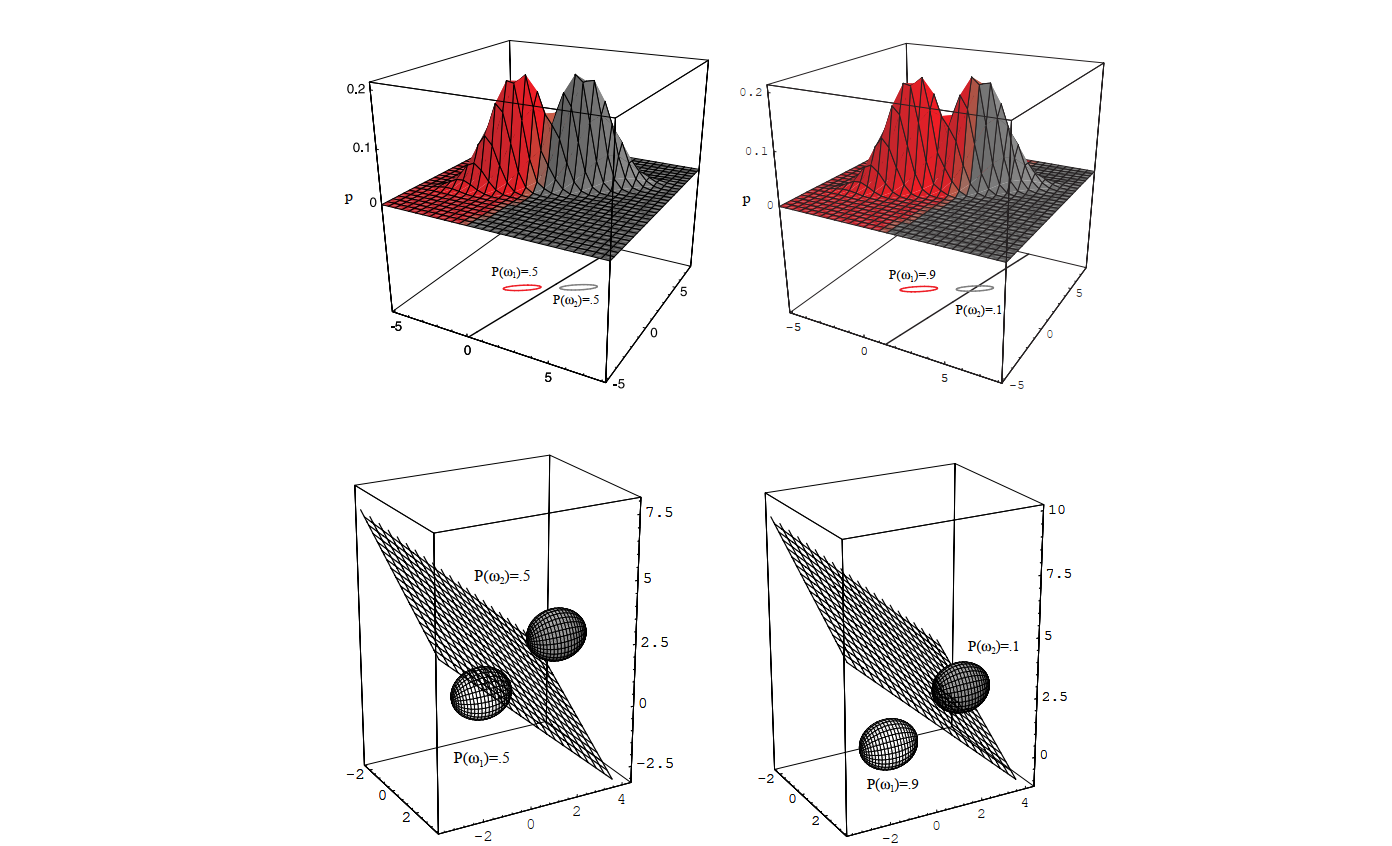
شکل 2.12: ماتریسهای کوواریانس برابر مرزهای خطی میدهند که لزوماً بر خط وصلکنندهٔ میانگینها عمود نیستند؛ هر دو دسته با بیضیهای چگالی برابر یکسان نشان داده شدهاند و مرز با پیشینها جابهجا میشود. شکل بعد لغزیدن آن را با تغییر پیشینها، برای دستههای کرهگون یک، دو و سهبعدی نشان میدهد.
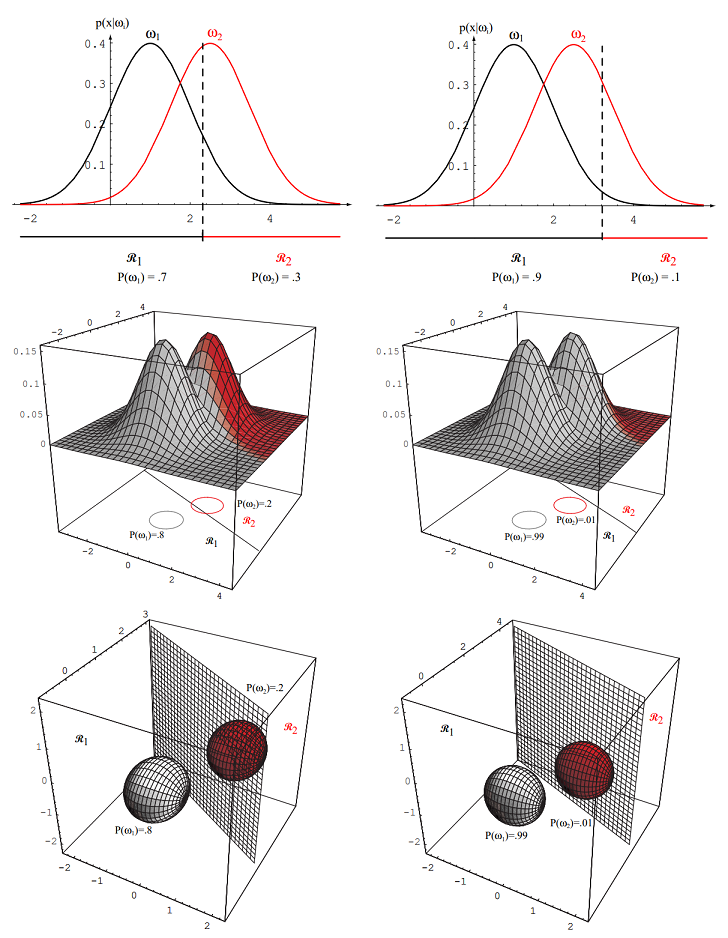
شکل 2.11: با تغییر پیشینها مرز تصمیم جابهجا میشود؛ برای پیشینهای بهقدر کافی نابرابر، مرز میان میانگینهای این توزیعهای گاوسی کرهگون یک، دو و سهبعدی نخواهد افتاد
حالت 3: ماتریسهای کوواریانس دلخواه، 
حالت کلی: هر دسته میانگین و کوواریانس خودش را دارد. با شروع از
و بسط صورت درجهدوم دقیقاً مانند حالت 2، ولی این بار با :
این صورتی درجهدوم در است،
تفاوت با حالت 2 جملهٔ است: با کوواریانسهای نابرابر حجم دسته مهم میشود و دستهٔ پخششده جریمه میشود. ممیز اکنون درجهدوم در است و مرز، که با داده میشود،
جملهٔ درجهدومش را از دست نمیدهد، چون .
مرزهای درجهدوم چه شکلیاند
سطحی از این نوع یک ابرسطح درجهدوم است — ابرصفحه، جفت ابرصفحه، ابرکره، ابربیضی، ابرسهمیگون یا ابرهایپربولویید، بسته به مقادیر ویژهٔ و جملههای خطی و ثابت. در دو بُعد اینها خط، جفت خط، دایره، بیضی، سهمی و هذلولیاند. هر یک از این شکلها میتواند از دو گاوسی برخیزد و برعکس هر ابرسطح درجهدوم مرز بیز برخی جفت گاوسی است.
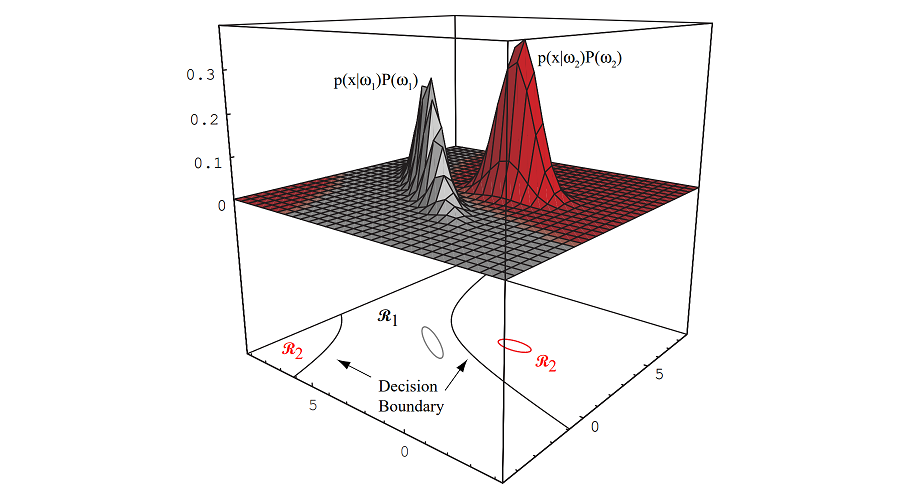
شکل 2.6: دستهبند گاوسی دوبعدی دودسته با کوواریانسهای نابرابر. دو هذلولی مرزند، پس ناحیهٔ تصمیم بهسادگی همبند نیست — یادآوری اینکه «آن» مرز میتواند چند شاخه داشته باشد.
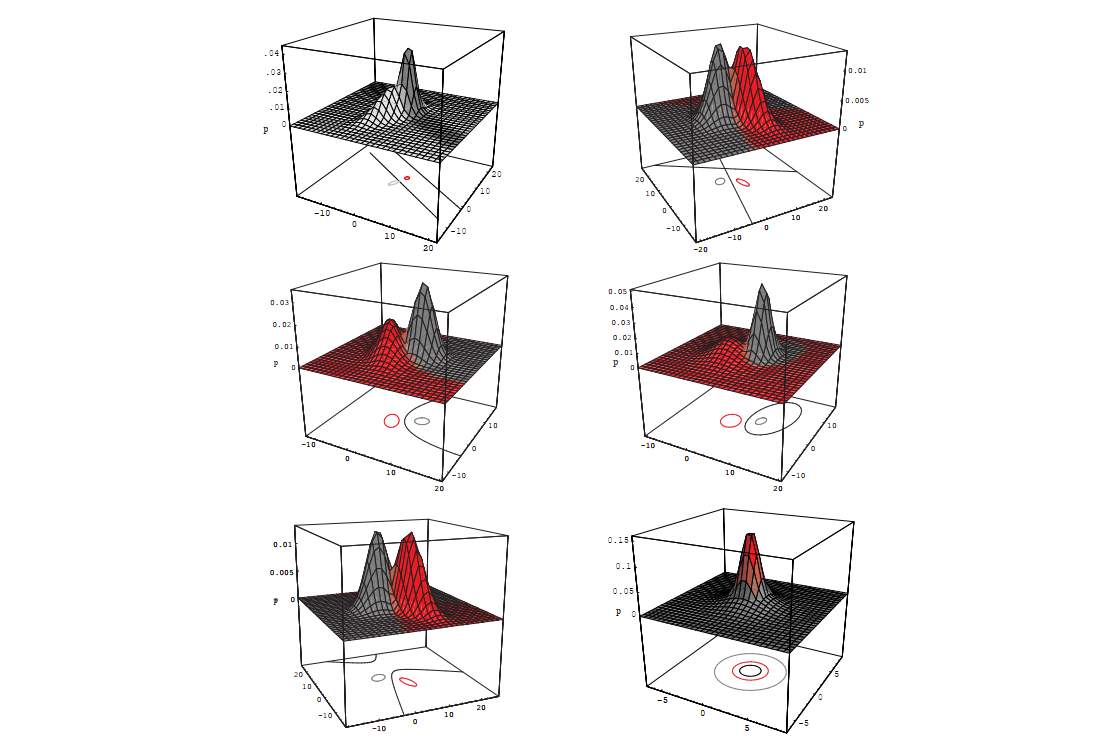
شکل 2.14: گاوسیهای دلخواه مرزهای ابرسطح درجهدوم میدهند؛ چهار پنل بیضی، هذلولی، سهمی و جفت خط را نشان میدهند.
بیش از دو دسته
گسترش نتیجه به دسته روراست است، ولی باید مراقب بود کدام دو دسته مسئول هر تکه از یک مرزند. شکل 2.16 نواحی تصمیم مسئلهای چهاردسته با دستههای گاوسی را نشان میدهد: حتی با چهار دسته نواحی از پیش پیچیدهاند و همان نظریه هنوز بر آنها حکم میراند.
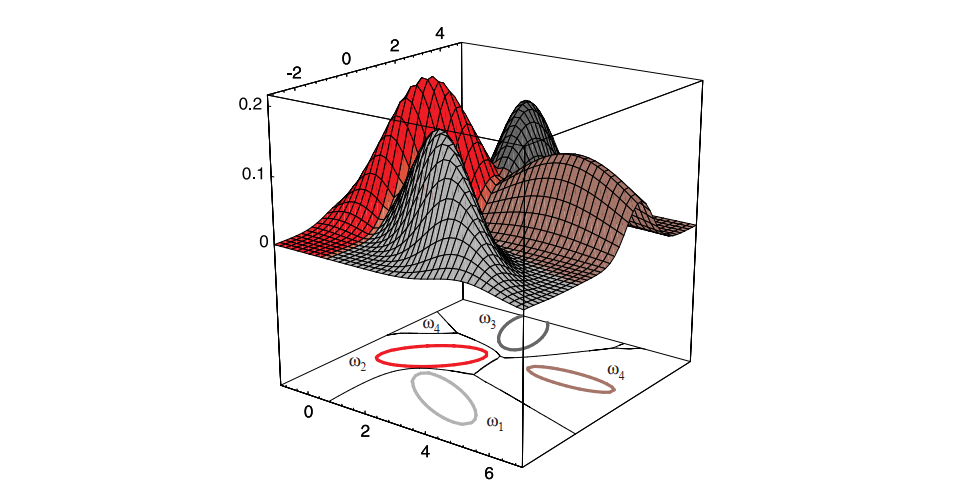
شکل 2.16: نواحی تصمیم چهار توزیع نرمال.
تمرین: بازبینی حالت 2 با Scikit-Learn
هدف. مرز حالت 2 را دو بار بازتولید کنید — یک بار از فرمول بالا و یک بار از GaussianNB — و بررسی
کنید که میخوانند.
تولید داده. دو دسته، هر کدام 200 نقطه، هر دو با کوواریانس و میانگینهای ، .
مرز نظری. با از
استفاده کنید و منحنی را روی شبکهای با
plt.contourرسم کنید.مرز برآوردشده.
GaussianNBرا روی 200 + 200 نقطه برازش دهید و مرز پیشبینیهایش را روی همان شبکه رسم کنید.مقایسه. دو مرز را با هم، همراه با نقطهها، خط وصلکنندهٔ دو میانگین و عمودمنصفش رسم کنید. دو مرز باید نزدیک ولی نه یکسان باشند:
GaussianNBمقدارهای و را از نمونه برآورد میکند، در حالی که گام 2 پارامترهای واقعی را به کار میبرد. زاویهٔ میان بردار عمود بر مرز و خط وصلکنندهٔ میانگینها، پیامد دیداری کوواریانس مشترک (حالت 2) است.
جمعبندی
نظریهٔ تصمیم بیزی احتمالها را به تصمیم تبدیل میکند.
مواد لازم پیشینها ، چگالیهای شرطی-دسته ، پسینها و شاهد است که پسینها را نرمال میکند و از هر تصمیمی حذف میشود.
معیار کلی ریسک شرطی با ماتریس زیان است؛ زیان صفر-یک آن را به قاعدهٔ کمینهنرخ خطا فرو میکاهد: «بزرگترین پسین را برگزین».
هر تابع یکنوای پسین یک ممیز معتبر است؛ با گرفتن لگاریتم، گاوسی به صورت درجهدوم تبدیل میشود.
برای دستههای گاوسی سه رژیم هست: کوواریانس همسانگرد و برابر ممیزهای خطی و مرزهای ابرصفحهای میدهد؛ کوواریانسهای دلخواه ممیزهای درجهدوم و مرزهای ابرسطح درجهدوم.
صورت درجهدوم درون گاوسی همان مربع فاصلهٔ ماهالانوبیس است، و سه رژیم دقیقاً LDA، LDA با کلی، و QDA هستند.
پارامترهای چگالی با بیشترین درستنمایی برآورد میشوند؛ وقتی دستهها برای برآورد یک کوواریانس کامل کوچکاند، فرض سادهکننده (استقلال ویژگیها) راه خروج معمول است.
منابع
Duda et al. (2000)
Duda, R. O., Hart, P. E., & Stork, D. G. (2000). Pattern Classification (2nd ed.). Wiley-Interscience, chapter 2.
- Duda, R. O., Hart, P. E., & Stork, D. G. (2000). Pattern Classification (2nd ed.). Wiley-Interscience.