نقشههای خودسازمانده
جای این صفحه در درس
بند ۱۴.۴ از hastie2009esl (صص ۵۲۸–۵۳۳) آخرین روش خوشهبندی فصل است، و کتاب آن را با جملهای معرفی میکند که خودش تعریفش هم هست: نقشهٔ خودسازمانده (SOM) همان K-means است با این قید که پیشنمونهها روی خمینهای یک یا دوبعدی در فضای ویژگی بمانند. همین قید است که نتیجه را به یک نقشه بدل میکند: پیشنمونهها مختصات شبکهای دارند، پس هر مشاهده را میتوان روی نمایشی دوبعدی نشاند، و سلولهای همسایهٔ نمایش مشاهدههای مشابه را در خود دارند.
روش Kohonen از واژگان یادگیری ماشین پیرامونش قدیمیتر است، و هنوز ابزار استاندارد تصویرسازی مجموعههای سند است؛ WEBSOM، مثالی که بند با آن بسته میشود، نقشهای از دوازده هزار مقالهٔ گروه خبری است.
در پایان باید بتوانید
یک SOM را شبکهای از پیشنمونهها توصیف کنید و بهروزرسانی برخط (۱۴.۴۶) را بنویسید؛
بگویید شعاع همسایگی و نرخ یادگیری چه میکنند، و هر دو چگونه برنامهریزی میشوند؛
بهروزرسانی دستهای (۱۴.۴۸) را بنویسید و نشان دهید وقتی همسایگی به یک سلول کوچک شود به K-means بدل میشود؛
با سنجیدن خطای بازسازی در برابر K-means داوری کنید که آیا قید دوبعدی روی مجموعهدادهٔ دادهشده پذیرفتنی است.
۱. مدل
شبکهای را ثابت کنید، مثلاً سلول، و یک پیشنمونه برای هر سلول. هر پیشنمونه یک جفت مختصات صحیح دارد — جایش روی نقشه، نه در فضای ویژگی. نقشه یک دستگاه مختصات دوبعدی است و پیشنمونهها نقطههای فضای ویژگیاند که به سلولهای آن نسبت داده شدهاند.
تصویر کتاب ارزش نگهداشتن دارد: پیشنمونهها را در صفحهٔ دو مؤلفهٔ اصلی نخستین مقداردهی کنید و آنها را دکمههایی بدانید که با الگویی منظم روی آن صفحه دوخته شدهاند. برازش SOM صفحه را خم میکند تا دکمهها داده را دنبال کنند. فاصلهٔ دکمهها روی نقشه سنجیده میشود، نه در فضای ویژگی، و همین قید است: پیشنمونههایی که روی شبکه همسایهاند بهسوی همان مشاهدهها کشیده میشوند، پس در فضای ویژگی هم همسایه میمانند.
۲. الگوریتم برخط
مشاهدهها یکییکی پردازش میشوند. نزدیکترین پیشنمونه به را در بیابید، بعد آن و همسایههای نقشهایاش را بهسوی ببرید:
همسایگی همیشه خود برنده را در بر دارد. شکل کلی گام را با فاصلهٔ نقشه وزن میدهد،
که در فاصلهٔ نقشه کاهش مییابد — گاوسی، یا نشانگر یک قرص.
هر دو برنامهٔ کتاب از درشت به ریز میروند: نرخ یادگیری در چند هزار تکرار از حدود 1.0 به 0 میافتد، و شعاع خطی از آغازین به 1 میرسد. همسایگیهای بزرگ در آغاز نقشه را بهطور کلی صاف میکنند؛ همسایگیهای کوچک در پایان میگذارند ساختار محلی را برازش کند. این همان ایدهٔ بازپخت در LVQ است و همان هشدار هم صادق است: روش با برنامهاش تعریف میشود، نه با کمینهسازی یک معیار.
اگر بهقدری کوچک باشد که هر همسایگی یک سلول شود، پیوند مکانی از دست میرود و الگوریتم به K-means برخط بدل میشود: به یکی از همان کمینههای محلیای همگرا میشود که K-means هم مییابد. این همان معنایی است که SOM را K-means مقید میداند، و همچنین میگوید قید را روی یک مسئله چگونه بسنجید:
این خطا برای SOM ناگزیر بزرگتر از K-means با همان تعداد پیشنمونه است. اگر بسیار بزرگتر باشد، نقشهٔ دوبعدی توصیف بدی از داده است.
۳. یک مثال حلشده: سه خوشه روی نیمکره
مثال کتاب ۹۰ نقطه در نزدیک سطح نیمکرهای به شعاع ۱ است، در سه خوشه نزدیک ، و . خوشهٔ سرخ عامدانه بسیار جمعوجورتر از دو خوشهٔ دیگر است، و همین است که نقشهٔ برازششده را روی خودش تا میزند.
import warnings

import numpy as np
import matplotlib.pyplot as plt

warnings.filterwarnings("ignore", message="KMeans is known to have a memory leak")

rng = np.random.default_rng(0)


def on_sphere(centre, sd, count):
    P = np.asarray(centre, float) + rng.normal(0.0, sd, size=(count, 3))
    return P / np.linalg.norm(P, axis=1, keepdims=True)


red = on_sphere((0, 1, 0), 0.04, 30)      # the tight cluster
green = on_sphere((0, 0, 1), 0.13, 30)
blue = on_sphere((1, 0, 0), 0.13, 30)
X = np.vstack([red, green, blue])
truth = np.repeat([0, 1, 2], 30)
colours = np.array(["tab:red", "tab:green", "tab:blue"])[truth]

fig = plt.figure(figsize=(5.5, 5))
ax = fig.add_subplot(111, projection="3d")
ax.scatter(X[:, 0], X[:, 1], X[:, 2], c=colours, s=14)
ax.set_title("90 points near a half sphere, in three clusters")
plt.show()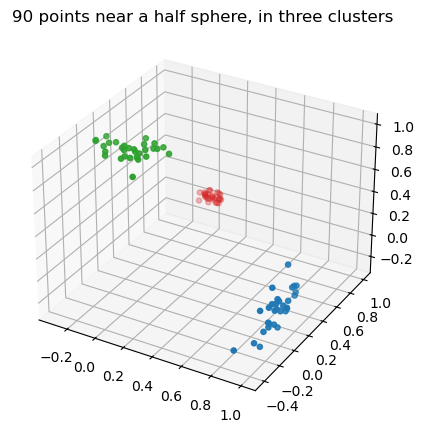
پیشنمونهها روی دو مؤلفهٔ اصلی نخستین مقداردهی میشوند و در گسترهٔ داده پخش میشوند — همان «دکمههای دوخته روی صفحهٔ» این بند.
q1 = q2 = 5                       # a 5 x 5 grid: 25 prototypes
mu = X.mean(axis=0)
U, S, Vt = np.linalg.svd(X - mu, full_matrices=False)
scores = (X - mu) @ Vt[:2].T

a1 = np.linspace(scores[:, 0].min(), scores[:, 0].max(), q1)
a2 = np.linspace(scores[:, 1].min(), scores[:, 1].max(), q2)
grid = np.array([[u, v] for u in a1 for v in a2])     # map coordinates, row-major
M0 = mu + grid @ Vt[:2]                               # prototypes in R^3
node = np.array([[i, j] for i in range(q1) for j in range(q2)], float)

print("prototypes:", M0.shape, " map coordinates:", node.shape)
prototypes: (25, 3) map coordinates: (25, 2)
حلقهٔ آموزش عیناً (۱۴.۴۶) است: ۴۰ گذر روی ۹۰ مشاهده، یعنی ۳۶۰۰ تکرار، با و که در این تکرارها خطی کاهش مییابند.
def som(X, M, epochs=40, R0=2.0, seed=0, node=node):
    rng = np.random.default_rng(seed)
    M = M.copy()
    errors = []
    total = epochs * len(X)
    t = 0
    for _ in range(epochs):
        for _ in range(len(X)):
            x = X[rng.integers(len(X))]
            j = int(np.argmin(((M - x) ** 2).sum(axis=1)))
            eps = 1.0 - t / total                        # 1.0 -> 0.0
            r = R0 + (1.0 - R0) * t / total              # R0 -> 1
            neighbours = ((node - node[j]) ** 2).sum(axis=1) <= r ** 2
            M[neighbours] += eps * (x - M[neighbours])
            t += 1
        err = (((X[:, None, :] - M[None, :, :]) ** 2).sum(-1).min(axis=1)).sum()
        errors.append(err)
    return M, errors


M, errors = som(X, M0)
print(f"reconstruction error after training: {errors[-1]:.3f}")

from sklearn.cluster import KMeans

km = KMeans(n_clusters=len(M), n_init=10, random_state=0).fit(X)
print(f"K-means with the same 25 prototypes : {km.inertia_:.3f}")
reconstruction error after training: 0.636
K-means with the same 25 prototypes : 0.124
این دو عدد همان سنجشی است که کتاب میخواهد، و اینجا بسیار از هم دورند: برازش مقید حدوداً پنج برابر هزینه دارد. این بهای پخش یکنواخت ۲۵ دکمه روی سطحی است که دادهاش در سه تودهٔ تنگ نشسته — شبکه نمیتواند همهٔ سلولهایش را روی تودهها خرج کند. دادهٔ خود کتاب پخشتر است و SOM آن در حدود یکچهارم K-means تمام میشود (شکل ۱۴.۱۸)؛ این نسبت خاصیت داده است، نه پیادهسازی، و خواندنش همان راهی است که تصمیم میگیرید نقشهٔ دوبعدی توصیف منصفانهای از دادهٔ شما هست یا نه.
۴. خواندن نقشه
نمایش همان شبکه است. هر سلول مشاهدههای نزدیکترین به پیشنمونهاش را در خود دارد، که در جایگاههای تصادفی درون سلول کشیده میشوند — چیدمان شکل ۱۴.۱۶. پنل چپ نقشهٔ آغازین و پنل راست نقشهٔ آموزشدیده است.
def draw_map(ax, M, X, truth, title, seed):
    r = np.random.default_rng(seed)
    labels = np.argmin(((X[:, None, :] - M[None, :, :]) ** 2).sum(-1), axis=1)
    for i in range(q1):
        for j in range(q2):
            ax.add_patch(plt.Circle((j, q1 - 1 - i), 0.44, fill=False, color="0.6", lw=0.8))
    jitter = r.uniform(-0.26, 0.26, size=(len(X), 2))
    for k, colour in enumerate(["tab:red", "tab:green", "tab:blue"]):
        mask = truth == k
        xs = (labels[mask] % q2) + jitter[mask, 0]
        ys = (q1 - 1 - labels[mask] // q2) + jitter[mask, 1]
        ax.scatter(xs, ys, s=14, color=colour)
    ax.set_xlim(-0.8, q2 - 0.2)
    ax.set_ylim(-0.8, q1 - 0.2)
    ax.set_aspect("equal")
    ax.set_title(title)
    ax.set_xticks([])
    ax.set_yticks([])


fig, axes = plt.subplots(1, 2, figsize=(9, 4.2))
draw_map(axes[0], M0, X, truth, "initial configuration", seed=1)
draw_map(axes[1], M, X, truth, "after 3600 iterations", seed=2)
plt.tight_layout()
plt.show()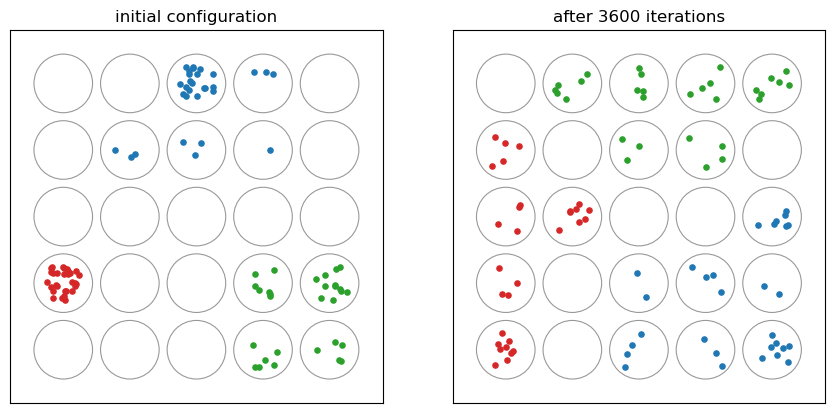
نقشهٔ آموزشدیده سه رنگ را در نواحی همسایه جدا کرده، و این کار را با مرزی صاف کرده است: سلولهای مجاور مشاهدههای مشابه دارند. همین خاصیتی است که K-means ندارد — برچسبهایش هیچ مجاورتی حمل نمیکنند، پس همان ۲۵ مرکز میتوانستند دلبخواه جابهجا شوند و معنایشان عوض نشود.
چیزی که نقشه نشان نمیدهد چگالی یا اندازه است. خوشهٔ سرخ بسیار جمعوجورتر از دو خوشهٔ دیگر است و هیچ چیز در نمایش این را نمیگوید، چون فاصلههای بهکاررفته در چیدمان، فاصلههای نقشهاند. کتاب همین نکته را دربارهٔ شکل ۱۴.۱۶ میگوید.
۵. شبکه در فضای ویژگی
کشیدن پیشنمونهها و یالهای شبکه در نشان میدهد «خمکردن صفحه» هندسی چه معنایی دارد. جایی که سطح باید روی خودش تا بخورد تا به خوشهٔ تنگ سرخ برسد، یالها روی هم میافتند — همان تای شکل ۱۴.۱۷.
fig = plt.figure(figsize=(6, 5.5))
ax = fig.add_subplot(111, projection="3d")
for i in range(q1):
    for j in range(q2):
        k = i * q2 + j
        if i + 1 < q1:
            ax.plot(*zip(M[k], M[k + q2]), color="0.4", lw=1)
        if j + 1 < q2:
            ax.plot(*zip(M[k], M[k + 1]), color="0.4", lw=1)
ax.scatter(X[:, 0], X[:, 1], X[:, 2], c=colours, s=10)
ax.scatter(M[:, 0], M[:, 1], M[:, 2], s=70, facecolors="none",
           edgecolors="purple", linewidths=1.4)
ax.set_title("the fitted lattice in feature space")
plt.show()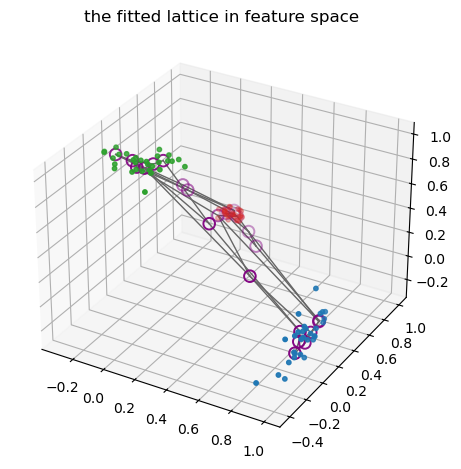
۶. خطای بازسازی در مسیر
منحنیای که قید را توجیه میکند خطای بازسازی برحسب شمارهٔ تکرار است، با مقدار K-means بهصورت خطی افقی (شکل ۱۴.۱۸).
fig, ax = plt.subplots(figsize=(6.5, 4))
ax.plot(np.arange(1, len(errors) + 1) * len(X), errors, "o-", ms=3, label="SOM")
ax.axhline(km.inertia_, color="tab:red", linestyle="--", label="K-means, 25 centroids")
ax.set_xlabel("iteration (one per observation)")
ax.set_ylabel("reconstruction error")
ax.legend()
ax.set_title("error of the constrained and the unconstrained fit")
plt.show()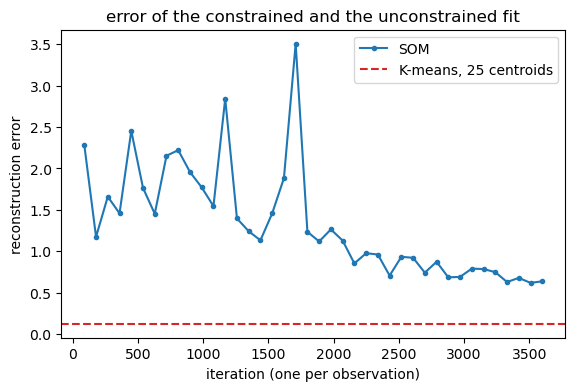
خطا تا وقتی همسایگی پهن است سریع میافتد — نقشه دارد باز میشود — و به سطح K-means نزدیک میشود بیآنکه به آن برسد. خواندن بخش آخر منحنی راه صادقانهٔ پاسخ به «آیا نقشهٔ دوبعدی برای این داده مناسب است؟» است، و این پرسشی دربارهٔ داده است، نه دربارهٔ الگوریتم.
۷. نسخهٔ دستهای، و نسبتش با K-means
بازمحاسبهٔ پیشنمونه بهصورت میانگین وزنی مشاهدههایی که به همسایههایش نگاشت شدهاند SOM دستهای را میدهد:
که جمع روی مشاهدههایی میرود که نزدیکترین پیشنمونهشان همسایهٔ نقشهای است، و برای همسایگی مستطیلی یک است یا با فاصلهٔ نقشه کم میشود. دو حالت خاص ارزش دانستن دارند:
همسایگی مستطیلی با شعاع ۰ بهروزرسانی را به «هر پیشنمونه را با میانگین مشاهدههای خودش جانشین کن» بدل میکند، که همان K-means است؛
صاف و شعاع کوچکشونده SOM دستهای را به نسخهای گسسته از خمهای اصلی بدل میکند، که موضوع بعدی کتاب پس از این بند است.
مبادلهٔ نسخهٔ برخط و دستهای همان مبادلهٔ آشناست: برخط خودش را با جریان سازگار میکند و به برنامه وابسته است، دستهای با تخصیص دادهشده قطعی است، سریعتر همگرا میشود، و پیشفرض بیشتر پیادهسازیهاست.
۸. کجا به کار میرود
مثال پایانی بند WEBSOM است: ۱۲ ۰۸۸ مقاله از comp.ai.neural-nets، هر یک به برداری تُنُک از بسامد
نسبی واژهها بر واژهنامهای با دهها هزار واژه (یا جفت واژه) بدل میشود، بهاختیار با SVD تصادفی
کاهش مییابد، و بعد روی شبکهای نگاشت میشود که سلولهایش از محتوایشان خودکار برچسب میگیرند.
نقشه نمایهای مرورشدنی است — نزدیکشدن روی یک سلول مقالههایش را نشان میدهد — و همان کاربردی
است که روش برایش ساخته شد: نه افراز کردن برای خودش، بلکه چیدن مجموعهای بزرگ چنان که چیزهای
مشابه در یک صفحه نزدیک هم باشند.
خلاصه
SOM شبکهای از پیشنمونهها با مختصات نقشه است؛ بهروزرسانی پیشنمونهٔ برنده و همسایههای نقشهایاش را بهسوی مشاهده میبرد (۱۴.۴۶).
نرخ یادگیری و شعاع همسایگی هر دو کاهش مییابند؛ برنامه بخشی از تعریف است، و همین دلیل این است که روش معیاری برای بهینهکردن ندارد.
با همسایگی تکسلولی الگوریتم K-means برخط است؛ شکل دستهای (۱۴.۴۸) با شعاع ۰ دقیقاً K-means است.
خطای اضافه بر K-means بهای قید دوبعدی را میسنجد، و خواندنش راه تصمیم دربارهٔ مناسب بودن نقشه است.
خروجی نمایشی است که سلولهای همسایهاش مشابهاند — همان خاصیتی که روش را برای مرور مجموعههای بزرگ سودمند میکند.
تمرینها
از آغاز با آموزش دهید. منحنی خطا و نقشه را با برچسبهای K-means که روی شبکه بازچیده شدهاند بسنجید. چه چیزی از دست رفته است؟
همسایگی سخت (۱۴.۴۶) را با گاوسی از (۱۴.۴۷) جانشین کنید و خطاهای بازسازی نهایی را بسنجید.
اندازهٔ شبکه را (، ، ) با دادهٔ ثابت تغییر دهید. خطا چگونه به خط K-means نزدیک میشود، و نقشه در چه شکلی است؟
از شبکهٔ ششگوش استفاده کنید (شش همسایه در هر سلول بهجای چهار). آیا نمایش بهتر میشود، و خطا فرق میکند؟
SOM را روی دادهٔ ۱۰۰-بعدی (مثلاً ارقام) اجرا کنید و بسنجید جواب مقید چهقدر بدتر است. آیا نقشهٔ دوبعدی هنوز قابل دفاع است؟
نسخهٔ دستهای (۱۴.۴۸) را با شعاع ۱ پیاده کنید و شمار تکرارهای لازم برای رسیدن به همان خطای نسخهٔ برخط را بسنجید.
منابع
تعریف، (۱۴.۴۶)–(۱۴.۴۸)، مثال نیمکره با شکلهای ۱۴.۱۵–۱۴.۱۸، و کاربرد WEBSOM: بند ۱۴.۴ از hastie2009esl، صص ۵۲۸–۵۳۳.
نسبتش با K-means همان است که در Clustering-Part2 به کار رفت؛ مبادلهٔ برخط و دستهای همان است که در پرسپترون و یادگیری برخط بحث شد.
شرح خود Kohonen از روش، و مقالههای WEBSOM، همان ارجاعهایی هستند که در بند داده شدهاند.