یادگیری چندهگذاری برداری (LVQ)
جای این صفحه در درس
فصل ۱۳ از hastie2009esl دربارهٔ روشهای پیشنمونه است: بهجای برازش یک مدل پارامتری، مجموعهای کوچک از نقطهها در فضای ویژگی نگه میداریم و بر پایهٔ نزدیکی به آنها دستهبندی میکنیم. فصل سه نمونه از اینها را به ترتیب میآورد:
| روش | پیشنمونهها با چه چیزی جایگذاری میشوند | نظارت |
|---|---|---|
| خوشهبندی K-means (بند ۱۳.۲.۱) | هندسهٔ هر کلاس جداگانه | برچسبها فقط بعد از خوشهبندی |
| LVQ (بند ۱۳.۲.۲) | هندسهٔ همهٔ کلاسها با هم | برچسبها در حین آموزش |
| مخلوطهای گاوسی (بند ۱۳.۲.۳) | مدل چگالی برای هر کلاس | نرم، بر پایهٔ درستنمایی |
این صفحه بند ۱۳.۲.۲ را دنبال میکند. دستهبند را بیان میکند، الگوریتم را میدهد (الگوریتم ۱۳.۱ کتاب)، آن را در چند خط NumPy از صفر پیاده میکند، و پیشنمونههایی که میسازد را با پیشنمونههای K-means روی همان داده میسنجد — همان مقایسهای که کتاب در شکل ۱۳.۱ میکند.
در پایان باید بتوانید
دستهبند نزدیکترین پیشنمونه را بیان کنید و بگویید پیشنمونهها چه هستند؛
قاعدهٔ بهروزرسانی LVQ1 را از حافظه بنویسید و علامت دو شاخه (جذب/دفع) را توضیح دهید؛
توضیح دهید چرا نرخ یادگیری باید به صفر برود، و چرا پیشنمونههای K-means نقطهٔ آغاز خوبیاند؛
توصیف کنید پیشنمونههای K-means در یک تصویر چه تفاوتی با پیشنمونههای LVQ دارند و چرا این تفاوت نتیجهٔ این است که چه کسی در جایگذاری آنها «حرف دارد»؛
بهای اینکه روش با یک الگوریتم تعریف شود، نه با کمینهسازی یک معیار، را نام ببرید.
۱. دستهبند نزدیکترین پیشنمونه
تعداد پیشنمونهٔ هر کلاس، R، و تعداد کلاسها، K، را ثابت کنید. آموزش K*R پیشنمونه m_1, ..., m_{K*R} تولید میکند که هر یکی برچسب کلاس c_j دارد. نقطهٔ تازهٔ x با برچسب نزدیکترین پیشنمونه دستهبندی میشود:
دو چیز این را برای آموزش و عمل جذاب میکند: مرز تصمیم میتواند هر قدر خمیده باشد (اجتماع سلولهای ورونوی است)، و مدل فقط فهرستی از نقطههاست، پس میتوان کشیدش، ذخیرهاش کرد و توضیحش داد. هر چیز دشوار در پرسش پیشنمونهها را کجا بگذاریم است، و همانجاست که روشها فرق میکنند.
کتاب پیش از بهکارگیری فاصلهٔ اقلیدسی، ویژگیها را به میانگین ۰ و واریانس ۱ استاندارد میکند (ص ۴۶۱)، و ما هم همین کار را میکنیم.
۲. مسئلهای که LVQ پاسخ میدهد
دستور سرراست بند ۱۳.۲.۱ این است: دادهٔ آموزشی هر کلاس را جداگانه با R مرکز خوشهبندی کن، همهٔ مرکزها را نگه دار، و با نزدیکترین مرکز دستهبندی کن. کار میکند، و ضعف دیدنیای دارد که کتاب میگوید (ص ۴۶۲):
… پیشنمونهها نزدیک مرزهای کلاساند و همین به خطاهای دستهبندی برای نقطههای نزدیک این > مرزها میانجامد. این از کاستی آشکار این روش میآید: برای هر کلاس، کلاسهای دیگر در > جایگذاری پیشنمونههای آن کلاس حرفی برای گفتن ندارند.
پیشنمونهای که درون یک کلاس حساب شده هیچ خبری از کلاس همسایه ندارد، پس با خیال راحت روی مرز مینشیند. LVQ دقیقاً همین را درست میکند: قاعدهٔ بهروزرسانی برچسب نقطهٔ آموزشی و برچسب نزدیکترین پیشنمونه را میبیند، پس پیشنمونهای که نقطههای کلاس اشتباه را میبرد دفع میشود.
۳. یک مسئلهٔ شبیهسازیشدهٔ سهکلاسی
برای دیدن تفاوت به دادهای نیاز داریم که کلاسهایش به هم برسند، چون با کلاسهای خوبجدا هر روشی یکسان به نظر میرسد. شبیهسازی بند ۲.۳.۳ از ESL را به کار میبریم — همان که پشت شکل ۱۳.۱ است — این بار با سه کلاس بهجای دو:
سه کلاس، دو ویژگی؛
هر کلاس ۱۰ میانگین دارد که از توزیع نرمالی با مرکز مختص کلاس —
(1.5,0)،(0,1.5)و(1.5,1.5)— و کوواریانسI/4کشیده شدهاند؛هر مشاهده با برگزیدن تصادفی یکی از آن ده میانگین (احتمال
1/10) و افزودن نوفهٔ گاوسی با کوواریانسI/5ساخته میشود.
این همان «مدلی میان دو سناریو» در ص ۱۶ است: کلاسها نه خطیجداپذیرند و نه دور از هم، و مرز بیز واقعاً خمیده است. پراکندگی ده میانگین (I/4) از I کتاب تنگتر است، که مسئله را سخت نگه میدارد بدون آنکه ناامیدکننده کند: حتی یک قاعدهٔ خوب روی کسر قابلتوجهی از نقطهها خطا میکند، ولی هیچجا نزدیک دو-از-سه یک سکهٔ انداختن میان سه کلاس نیست.
Source
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from skimage import data
from skimage.color import rgb2gray
from skimage.util import view_as_blocks

%matplotlib inline
COLORS = np.array(["tab:blue", "tab:orange", "tab:green"])
Source
def make_mixture(n_per_class=100, n_means=10, seed=0):
    """ESL section 2.3.3 simulation, extended to three classes (Figure 13.1).

    Each class owns ten means, drawn around that class's own centre with
    covariance I/4; every observation is one mean plus N(0, I/5) noise.
    """
    rng = np.random.default_rng(seed)
    centres = np.array([[1.5, 0.0], [0.0, 1.5], [1.5, 1.5]])   # one per class
    X, y = [], []
    for k in range(3):
        means = centres[k] + rng.normal(scale=0.5, size=(n_means, 2))  # 10 means
        pick = rng.integers(0, n_means, size=n_per_class)      # one mean per observation
        noise = rng.normal(scale=np.sqrt(1 / 5), size=(n_per_class, 2))
        X.append(means[pick] + noise)
        y.append(np.full(n_per_class, k))
    return np.vstack(X), np.concatenate(y)


def standardize(X_train, *others):
    """Standardise with the statistics of the training set only."""
    mu, sd = X_train.mean(axis=0), X_train.std(axis=0)
    return [(Z - mu) / sd for Z in (X_train, *others)]


X_train, y_train = make_mixture(seed=0)
X_test, y_test = make_mixture(seed=1)          # same distribution, new sample
X_train, X_test = standardize(X_train, X_test)  # scale with training statistics
X_train.shape, np.bincount(y_train)
((300, 2), array([100, 100, 100]))Source
fig, ax = plt.subplots(figsize=(6, 5))
for k in range(3):
    ax.scatter(X_train[y_train == k, 0], X_train[y_train == k, 1],
               s=14, color=COLORS[k], alpha=0.7, label=f"class {k}")
ax.set_title("the simulated problem: three overlapping classes")
ax.legend();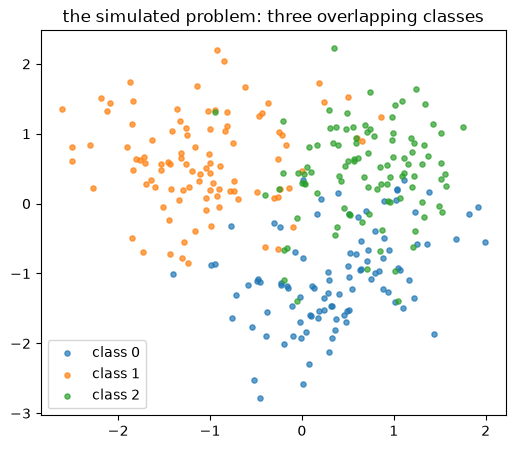
۴. پیشنمونههای K-means (نقطهٔ آغاز)
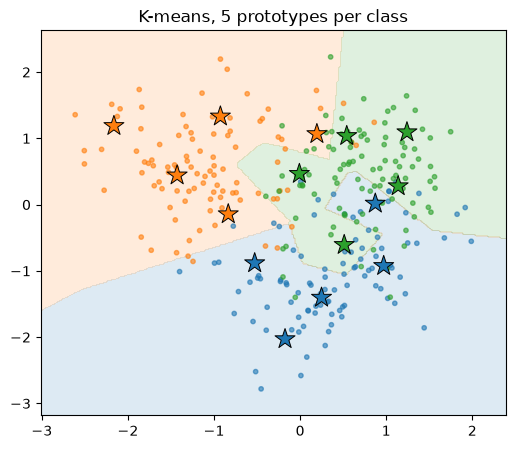
R = 5 پیشنمونه در هر کلاس، که با خوشهبندی جداگانهٔ نقطههای هر کلاس ساخته میشوند. هر پیشنمونه برچسب کلاسی را به ارث میبرد که در آن حساب شده است.
Source
def kmeans_prototypes(X, y, R=5, seed=0):
    """R centres per class: ESL section 13.2.1."""
    protos, pclass = [], []
    for k in np.unique(y):
        km = KMeans(n_clusters=R, n_init=10, random_state=seed).fit(X[y == k])
        protos.append(km.cluster_centers_)
        pclass.append(np.full(R, k))
    return np.vstack(protos), np.concatenate(pclass)


def predict(X, protos, pclass):
    """Nearest-prototype classifier: the label of the closest prototype."""
    d = ((X[:, None, :] - protos[None, :, :]) ** 2).sum(axis=2)
    return pclass[d.argmin(axis=1)]


def plot_regions(ax, protos, pclass, X, y, title):
    pad = 0.4
    xs = np.linspace(X[:, 0].min() - pad, X[:, 0].max() + pad, 300)
    ys = np.linspace(X[:, 1].min() - pad, X[:, 1].max() + pad, 300)
    xx, yy = np.meshgrid(xs, ys)
    zz = predict(np.c_[xx.ravel(), yy.ravel()], protos, pclass).reshape(xx.shape)
    ax.contourf(xx, yy, zz, levels=[-0.5, 0.5, 1.5, 2.5], colors=COLORS, alpha=0.15)
    ax.scatter(X[:, 0], X[:, 1], c=COLORS[y], s=10, alpha=0.6)
    ax.scatter(protos[:, 0], protos[:, 1], c=COLORS[pclass], marker="*",
               s=230, edgecolor="black", linewidth=0.7)
    ax.set_title(title)


protos_km, class_km = kmeans_prototypes(X_train, y_train, R=5)
print("prototypes:", protos_km.shape)
fig, ax = plt.subplots(figsize=(6, 5))
plot_regions(ax, protos_km, class_km, X_train, y_train, "K-means, 5 prototypes per class");
prototypes: (15, 2)
۵. الگوریتم LVQ
الگوریتم ۱۳.۱ (یادگیری چندهگذاری برداری — LVQ)، بهصورت چاپشده در hastie2009esl، ص ۴۶۲
برای هر کلاس
Rپیشنمونهٔ آغازین برگزینیدm_1^(k), ..., m_R^(k)،k = 1..K— مثلاً با نمونهگیری تصادفیRنقطهٔ آموزشی از هر کلاس، یا با اجرای K-means روی هر کلاس.نقطهٔ آموزشی
x_iرا بهطور تصادفی (با جایگذاری) نمونهگیری کنید و بگذارید(j,k)نزدیکترین پیشنمونهm_j^(k)بهx_iرا نشان دهد.(a) اگر
g_i = k— همان کلاس — پیشنمونه را بهسوی نقطهٔ آموزشی برانید:(b) اگر
g_i != k— کلاسی دیگر — پیشنمونه را از نقطهٔ آموزشی دور کنید:
گام ۲ را تکرار کنید، و نرخ یادگیری
εرا با هر تکرار بهسوی صفر کم کنید.
سه نکتهای که کتاب در پی میآورد:
LVQ الگوریتمی برخط است: مشاهدهها یکییکی میرسند و هر یک تنها یک پیشنمونه را بهروز میکند.
کاهش
εباید شرایط تقریب تصادفی بند ۱۱.۴ را برآورده کند (ε_t -> 0،sum ε_t = infinity،sum ε_t^2 < infinity)؛ برنامهای مانندε_t = ε_0 / (1 + t)اینها را برآورده میکند.رویهٔ بالا LVQ1 است؛ گونههای دیگر (LVQ2، LVQ3) هم هستند. عیب کل خانواده این است که با یک الگوریتم تعریف میشوند، نه با کمینهسازی یک معیار ثابت، و همین تحلیل خواصشان را سختتر میکند. نسخههای تازهتر بر پایهٔ تابع هزینه (LVQ تعمیمیافته) دقیقاً برای ترمیم همین ساخته شدند.
کتاب جواب K-means را هم بهعنوان مقدار آغازین به کار میبرد و نتیجهٔ شکل ۱۳.۱ خود (پنل پایین) را میگیرد: پیشنمونهها از مرزهای تصمیم فاصله گرفتهاند و از پیشنمونههای کلاسهای رقیب دور شدهاند.
Source
def lvq1(X, y, protos, pclass, epochs=150, eps0=0.1, seed=0):
    """Online LVQ1, as Algorithm 13.1 of ESL."""
    m, c = protos.copy(), pclass.copy()
    rng = np.random.default_rng(seed)
    errors = []

    for epoch in range(epochs):
        eps = eps0 / (1.0 + epoch)              # step 3: eps -> 0 as 1/t
        for i in rng.permutation(len(X)):       # step 2: sample a point at random
            x = X[i]
            j = ((m - x) ** 2).sum(axis=1).argmin()   # the closest prototype
            if c[j] == y[i]:
                m[j] += eps * (x - m[j])        # (a) same class    -> attract
            else:
                m[j] -= eps * (x - m[j])        # (b) other class   -> repel
        errors.append((predict(X, m, c) != y).mean())

    return m, c, errors
Source
protos_lvq, class_lvq, errors = lvq1(X_train, y_train, protos_km, class_km)

fig, axes = plt.subplots(1, 2, figsize=(12, 5))
plot_regions(axes[0], protos_km, class_km, X_train, y_train,
             "K-means prototypes (before LVQ)")
plot_regions(axes[1], protos_lvq, class_lvq, X_train, y_train,
             "after LVQ1: prototypes leave the boundary")
plt.tight_layout()
print(f"training error before LVQ: {(predict(X_train, protos_km, class_km) != y_train).mean():.3f}")
print(f"training error after  LVQ: {(predict(X_train, protos_lvq, class_lvq) != y_train).mean():.3f}")
training error before LVQ: 0.240
training error after LVQ: 0.170
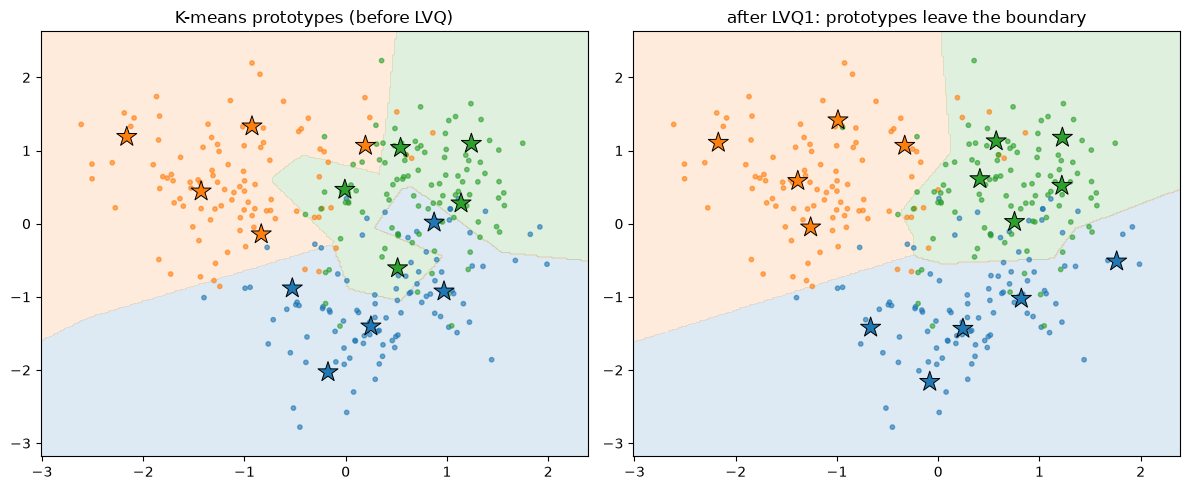
به ستارهها در دو پنل نگاه کنید. در پنل چپ چند پیشنمونه درون قلمرو رنگ دیگر نشستهاند؛ در پنل راست به منطقهٔ خودشان کشیده و از مرز دور شدهاند. این تمام اثر علامت در گام ۲ است، که چند هزار بار تکرار شده.
Source
fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(errors, color="tab:blue")
ax.set_xlabel("epoch")
ax.set_ylabel("training error of the nearest-prototype rule")
ax.set_title("LVQ1 on the simulated problem")
ax.grid(alpha=0.3);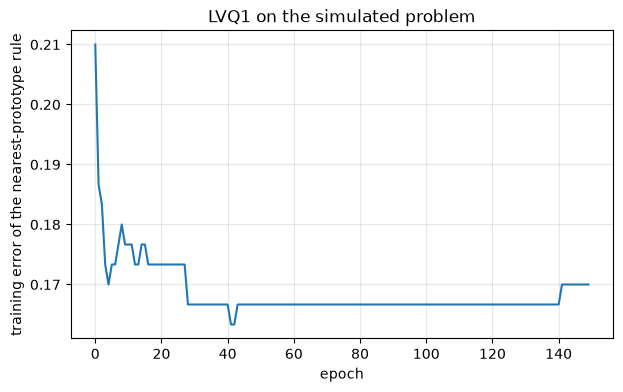
سنجش «فاصله از مرز»
یک عدد تنها ادعا را آزمودنی میکند: برای هر پیشنمونه فاصله تا نزدیکترین پیشنمونهٔ کلاسی متفاوت را حساب کنید و میانه را بگیرید. LVQ باید آن را زیاد کند، چون پیشنمونهای که به دشمن نزدیک است همان است که گام دفع پیوسته میزندش.
Source
def median_gap_to_enemy(protos, pclass):
    d = np.sqrt(((protos[:, None, :] - protos[None, :, :]) ** 2).sum(axis=2))
    d[pclass[:, None] == pclass[None, :]] = np.inf      # ignore same-class pairs
    return np.median(d.min(axis=1))


print(f"median distance to the nearest other-class prototype")
print(f"  before LVQ : {median_gap_to_enemy(protos_km, class_km):.3f}")
print(f"  after  LVQ : {median_gap_to_enemy(protos_lvq, class_lvq):.3f}")
median distance to the nearest other-class prototype
before LVQ : 0.800
after LVQ : 1.493
۶. آیا روی دادهٔ دیدهنشده کمک میکند؟
پیشنمونههایی که نقطههای آموزشی را ترک میکنند ممکن است نقطههای سودمند را هم ترک کنند، پس خطای آموزش بهتنهایی چیزی ثابت نمیکند. آزمون صادقانه نمونهٔ تازهای از همان توزیع است که با دانهٔ دیگری ساختیم.
Source
rows = []
for name, protos, pclass in [
    ("K-means prototypes", protos_km, class_km),
    ("LVQ1 prototypes", protos_lvq, class_lvq),
]:
    rows.append((name, (predict(X_train, protos, pclass) != y_train).mean(),
                 (predict(X_test, protos, pclass) != y_test).mean()))

print(f"{'prototypes':22s}{'train error':>13s}{'test error':>12s}")
for name, tr, te in rows:
    print(f"{name:22s}{tr:13.3f}{te:12.3f}")
prototypes train error test error
K-means prototypes 0.240 0.277
LVQ1 prototypes 0.170 0.227
عددها چند واحد جابهجا میشوند، در همان جهتی که کتاب میگوید، و اندازهٔ بهبود خودش بخشی از درس است: LVQ یک ترمیم ارزان و محلی برای جواب K-means است، نه یک ردهٔ مدل دیگر. جایی که کلاسها خوبجدا هستند تقریباً هیچ چیز را عوض نمیکند؛ جایی که همپوشانی دارند مرز را از نو میکشد.
۷. نکتههای عملی
مقدار آغازین. ESL از جواب K-means شروع میکند، و در عمل هر کسی هم باید: شروع از نقطههای آموزشی تصادفی کار بسیار بیشتری برای بهروزرسانیهای برخط باقی میگذارد. سلول بعد تفاوت را روی همان داده نشان میدهد.
نرخ یادگیری. ε_0 تعیین میکند پیشنمونه در یک مشاهده چهقدر جابهجا شود؛ epochs تعیین میکند برنامه چهقدر ادامه یابد. زیادی بزرگ و پیشنمونهها نوسان میکنند، زیادی کوچک و هرگز نمیرسند. ε_t = ε_0/(1+t) پیشفرض ایمنی است.
R، تعداد پیشنمونه در هر کلاس. پیشنمونهٔ بیشتر مرز ریزتری و مدل بزرگتری میدهد؛ R = 1 LVQ را به دستهبند نزدیکترین مرکز فرو میکاهد و قاعدهٔ بهروزرسانی را به تصحیحی شبیه پرسپترون روی مرکزها.
مقیاس ویژگیها. فاصلهٔ اقلیدسی بدون آن بیمعناست؛ همچون ESL با آمارههای آموزش استاندارد کنید.
نمونهگیری با جایگذاری. گام ۲ هر بار نقطهٔ آموزشی تصادفی میکشد، نه یک گذر روی فهرست بههمریخته، پس کلاسهای پرنقطهتر بیشتر دیده میشوند. برای دادهٔ نامتوازن این بایاسی است که خوب است بدانید.
Source
def random_prototypes(X, y, R=5, seed=0):
    rng = np.random.default_rng(seed)
    protos, pclass = [], []
    for k in np.unique(y):
        idx = rng.choice(np.flatnonzero(y == k), size=R, replace=False)
        protos.append(X[idx])
        pclass.append(np.full(R, k))
    return np.vstack(protos), np.concatenate(pclass)


rng_protos, rng_class = random_prototypes(X_train, y_train, R=5)
trials = [
    ("random start, eps0=0.1", rng_protos, rng_class, 0.1),
    ("k-means start, eps0=0.1", protos_km, class_km, 0.1),
    ("k-means start, eps0=0.5", protos_km, class_km, 0.5),
]
for name, p0, c0, eps0 in trials:
    m, c, _ = lvq1(X_train, y_train, p0, c0, eps0=eps0)
    print(f"{name:26s} test error = {(predict(X_test, m, c) != y_test).mean():.3f}")
random start, eps0=0.1 test error = 0.250
k-means start, eps0=0.1 test error = 0.227
k-means start, eps0=0.5 test error = 0.207
۸. روی دادهٔ واقعی: گلهای زنبق
چهار ویژگی، سه کلاس، R = 3 پیشنمونه در هر کلاس. وقتی R برابر تعداد کلاسها و داده خوشرفتار باشد، پیشنمونهها نزدیک میانگین کلاسها میافتند، پس LVQ چیز کمی برای ترمیم دارد — و همین دلیل نیاز به مسئلهٔ شبیهسازیشدهٔ بالا بود تا اثر دیده شود.
Source
iris = load_iris()
Xi, yi = iris.data, iris.target
Xi_train, Xi_test, yi_train, yi_test = train_test_split(
    Xi, yi, test_size=0.3, random_state=0, stratify=yi)
Xi_train, Xi_test = standardize(Xi_train, Xi_test)

p0, c0 = kmeans_prototypes(Xi_train, yi_train, R=3)
m_i, c_i, _ = lvq1(Xi_train, yi_train, p0, c0, epochs=100)

centroids = np.vstack([Xi_train[yi_train == k].mean(axis=0) for k in range(3)])
for name, protos, pclass in [
    ("nearest centroid (R=1)", centroids, np.arange(3)),
    ("K-means prototypes (R=3)", p0, c0),
    ("LVQ1 prototypes (R=3)", m_i, c_i),
]:
    te = (predict(Xi_test, protos, pclass) != yi_test).mean()
    print(f"{name:26s} test error = {te:.3f}")
nearest centroid (R=1) test error = 0.244
K-means prototypes (R=3) test error = 0.000
LVQ1 prototypes (R=3) test error = 0.000
۹. نام از کجا میآید
«چندهگذاری» ایدهٔ قدیمیتر پشت روش است: یک بردار را با اندیس نزدیکترین پیشنمونه جانشین کنید و فقط همان اندیس را ذخیره کنید. با K پیشنمونه هر اندیس log2(K) بیت هزینه دارد بهجای بیتهای یک بردار کامل، پس مجموعهٔ پیشنمونهها کتابکد میشود و روش به فشردهسازی اتلافی بدل میشود.
نام در عنوان LVQ مانده، ولی کاربرد فشردهسازی درس دیگری است: از K-means بدون هیچ برچسبی بهره میبرد و با بیت و دسیبل سنجیده میشود، نه با نرخ خطا. پس صفحهٔ خودش را دارد:
چندهگذاری برداری و فشردهسازی تصویر — بند ۱۴.۳.۹ از ESL، با مبادلهٔ نرخ/اعوجاج که روی تصویری آزمونی سنجیده میشود.
خلاصه
روش پیشنمونه با برچسب نزدیکترین پیشنمونه دستهبندی میکند؛
K*Rپیشنمونه یک مرز تصمیم خمیده را رمزگذاری میکند.خوشهبندی هر کلاس بهتنهایی (بند ۱۳.۲.۱) پیشنمونهها را جایی میگذارد که آن کلاس چگال است، بیاعتنا به بقیه، پس روی مرزها میلغزند — همان کاستیای که کتاب صریح نامش را میبرد.
LVQ (بند ۱۳.۲.۲) برخط و برچسبآگاه است: نقطه نزدیکترین پیشنمونهٔ کلاس خودش را جذب و نزدیکترین پیشنمونهٔ کلاسی دیگر را دفع میکند، با گامی
εکه به صفر میرسد.این LVQ1 است؛ LVQ2 و LVQ3 گسترشش میدهند، و کل خانواده تابع هدف ثابتی ندارد — همان بهای روش.
شروع از پیشنمونههای K-means (انتخاب ESL) بسیار بهتر از شروع از نقطههای تصادفی است، و اثر LVQ یک ترمیم محلی مرز است.
همان ایدهٔ «نزدیکترین پیشنمونه + ذخیرهٔ اندیس»، اگر روی بلوکهای تصویر به کار رود، چندهگذاری برداری است: خاستگاه نام، و روشی فشردهساز که صفحهٔ خودش را دارد.
تمرینها
R = 1بگذارید و LVQ را روی دادهٔ شبیهسازیشده اجرا کنید. قاعدهٔ بهروزرسانی چه میشود، و چرا مرز تقریباً مستقیم میماند؟برنامهٔ
ε_t = ε_0/(1+t)را با ثابتε = 0.1جانشین کنید. خطای آموزش را برحسب دوره رسم کنید: چه میبینید، و کدام یک از سه شرط تقریب تصادفی نقض میشود؟R = 2, 5, 10, 20پیشنمونه در هر کلاس را به کار ببرید و خطای آزمون را رسم کنید. منحنی کجا صاف میشود، و هزینهٔ هر پیشنمونه چیست؟گونهٔ فقطجذب: شاخهٔ دفع را حذف کنید و از شروع K-means آموزش دهید. نتیجه را با جملهٔ کتاب دربارهٔ اینکه چه کسی در جایگذاری پیشنمونهها حرف دارد توضیح دهید.
خطای بیز مسئلهٔ شبیهسازیشده را تحلیلی حساب کنید (یا با مدل 1-NN بسیار بزرگ برآورد کنید) و با خطای دو مجموعهٔ پیشنمونه بسنجید.
برای آزمایش فشردهسازی،
bs = 2وbs = 8را با همان تعداد بیت بر پیکسل امتحان کنید. کدام اندازهٔ بلوک تصویر بهتری میدهد، و چرا ساختار کاشی در بازسازی دیده میشود؟
منابع
روش، الگوریتمش (الگوریتم ۱۳.۱) و مثال شبیهسازیشده: بند ۱۳.۲.۲ و ۱۳.۲ از hastie2009esl (چاپ دوم، صص ۴۶۱–۴۶۳)؛ کاربرد فشردهسازی در صفحهٔ خودش است (بند ۱۴.۳.۹ همان کتاب). شکلهای این صفحه با کد بالا ساخته میشوند و مقایسهٔ شکل ۱۳.۱ از ESL را بازتولید میکنند.
مقالههای اصلی LVQ از Kohonen همان ارجاعهایی هستند که آنجا داده شده؛ بازفرمولبندی GLVQ همان ترمیم بر پایهٔ تابع هزینه برای ایراد «معیار ثابت ندارد» است.
مستندات
sklearn.cluster.KMeansبرای پیادهسازیای که پیشنمونههای آغازین را میسازد.