خوشهبندی — بخش ۲
تعریف خوشهبندی
خوشهبندی مجموعهای از نقاط داده ، افراز آن نقاط به زیرمجموعهٔ جدا از هم (یا خوشه) است، ، بهطوریکه نقاط درون یک گروه، به یک معنا که تحلیلگر تعیین میکند، به هم شبیهتر باشند تا به نقاط گروههای دیگر.
خوشهبندی نمایندهبنیان
دادهای با نقطه در فضای -بُعدی، ، و تعداد خوشهٔ دلخواه را در نظر بگیرید. هدف خوشهبندی نمایندهبنیان، افراز داده به گروه یا خوشه است که خوشهبندی نامیده و با نشان داده میشود.
برای هر خوشهٔ یک نقطهٔ نماینده وجود دارد که خوشه را خلاصه میکند؛ انتخاب رایج، میانگین (یا مرکز) همهٔ نقاط آن خوشه است:
که در آن تعداد نقاط خوشهٔ است.
خوشهبندی k-means
خوشهبندی k-means یک خوشهبندی نمایندهبنیان است که نقاط را بر اساس شباهتشان به مرکز هر خوشه، به خوشه افراز میکند. هدف، یافتن افرازی است که مجموع مجذور فاصلهٔ هر نقطه تا مرکز خوشهٔ خودش را کمینه کند.
لم ۱: مجموع مجذور فاصلهها تا یک نقطهٔ دلخواه
فرض کنید مجموعهای از نقاط و مرکز آنها باشد. مجموع مجذور فاصلهٔ نقاط تا هر نقطهٔ دلخواه ، برابر است با مجموع مجذور فاصلهها تا مرکز، بهاضافهٔ برابر مجذور فاصلهٔ تا مرکز:
اثبات:
زیرا .
نتیجهٔ ۱: مرکز، مجموع مجذور فاصلهها را کمینه میکند
چون جملهٔ دوم، ، همیشه نامنفی است، مجموع مجذور فاصلهها در کمینه میشود.
اثبات: مستقیم از لم ۱ نتیجه میشود.
لم ۲: مجموع مجذور فاصلهها بین همهٔ جفتنقاط
فرض کنید مجموعهای از نقاط و مرکز آنها باشد. مجموع مجذور فاصلهها بین همهٔ جفتنقاط، برابر است با برابر مجموع مجذور فاصلههای نقاط تا مرکز:
اثبات:
الگوریتم خوشهبندی k-means
الگوریتم با مرکز اولیه شروع میکند و تا همگرایی، مرکزها را بهروز و هر نقطه را به نزدیکترین مرکز نسبت میدهد.
مرکز اولیهٔ را تصادفی مقداردهی کن.
در هر تکرار:
هر نقطهٔ را به خوشهٔ با نزدیکترین مرکز نسبت بده.
مرکزهای را میانگین نقاط هر خوشه بگذار.
گام ۲ را تا همگرایی تکرار کن.
همگرایی الگوریتم k-means
الگوریتم همیشه همگرا میشود، ولی ممکن است به کمینهٔ محلی برسد. برای اثبات همگرایی، نشان میدهیم هزینهٔ خوشهبندی — مجموع مجذور فاصلهٔ هر نقطه تا مرکز خوشهاش — در هر گام بهتر میشود (گام نسبتدهی و گام بهروزرسانی هر دو این هزینه را کاهش میدهند)، پس دنبالهٔ مقادیر هزینه یک دنبالهٔ نزولی کراندار است و الگوریتم در تعداد متناهی گام متوقف میشود.
پیادهسازی پایتونی زیر همین الگوریتم است:
import numpy as np

def kmeans(data, k):
    # Initialize centroids randomly
    centroids = data[np.random.choice(range(len(data)), size=k, replace=False)]

    while True:
        # Assign each data point to the closest centroid
        labels = np.argmin(np.linalg.norm(data[:, np.newaxis] - centroids, axis=2), axis=1)

        # Compute new centroids as the mean of all data points assigned to each centroid
        new_centroids = np.array([data[labels == i].mean(axis=0) for i in range(k)])

        # Check for convergence
        if np.all(centroids == new_centroids):
            break

        centroids = new_centroids

    return centroids, labels
پیادهسازی شیءگرا از k-means
این نوتبوک ابتدا دادهٔ نمونه میسازد و سپس کلاسی به نام KMeansClustering تعریف میکند
که الگوریتم k-means را پیاده میکند. متد fit مرکزها را تصادفی مقداردهی میکند و سپس
تا همگرایی آنها را بهروز میکند.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans

# Generate some sample data
np.random.seed(0)
# n_samples = 100
# data = np.random.rand(n_samples, 2)

# Define the KMeans class
class KMeansClustering:
    def __init__(self, k):
        self.data = None
        self.k = k
        self.centroids = None
        self.labels = None

    def fit(self, data):

        self.data = data
        n_samples = len(self.data)
        # Initialize centroids randomly
        self.centroids = self.data[np.random.choice(range(n_samples), size=self.k, replace=False)]

        while True:
            # Assign each data point to the closest centroid
            self.labels = np.argmin(np.linalg.norm(self.data[:, np.newaxis] - self.centroids, axis=2), axis=1)

            # Compute new centroids as the mean of all data points assigned to each centroid
            new_centroids = np.array([self.data[self.labels == i].mean(axis=0) for i in range(self.k)])

            # Check for convergence
            if np.all(self.centroids == new_centroids):
                break

            self.centroids = new_centroids
اسکریپت زیر یک نمونه از کلاس KMeansClustering میسازد، مدل را روی داده برازش
میکند و داده را همراه با مرکزها و برچسبها رسم میکند.
from sklearn.datasets import make_blobs
from scipy.spatial import distance_matrix

# Create an instance of the KMeansClustering class
kmeans = KMeansClustering(k=3)

n_samples = 100
X, y = make_blobs(n_samples=n_samples, centers=3, n_features=2,
                  random_state=0)
# Fit the model to the data
kmeans.fit(X)

# Plot the data with centroids and labels
plt.scatter(X[:, 0], X[:, 1], c=kmeans.labels)
plt.scatter(kmeans.centroids[:, 0], kmeans.centroids[:, 1], marker='*', s=200, c='red')
plt.show()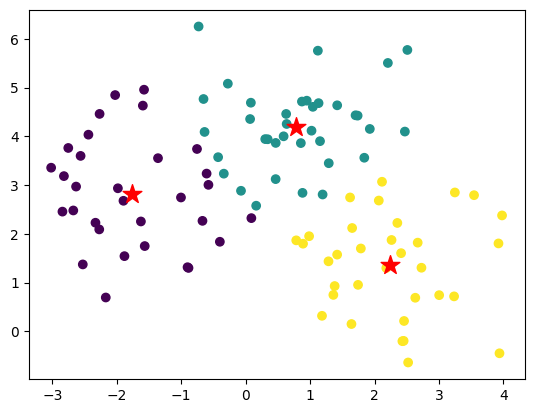
حالا با لم ۲ نشان میدهیم که مرکز، مجموع مجذور فاصلهها را کمینه میکند:
تابع lemma_2 لم ۲ را پیاده میکند: مجموع مجذور فاصلههای همهٔ جفتنقاط برابر است
با برابر مجموع مجذور فاصلهها تا مرکز. نوتبوک این اتحاد را روی زیرمجموعهای از داده
(خوشهٔ ۰) میآزماید و دو عدد چاپشده باید تقریباً برابر باشند.
def lemma_2(data, centroid):
    n = len(data)
    sum_squared_distances_to_centroid = np.sum((data - centroid) ** 2)
    # Compute pairwise distances
    distances = distance_matrix(data, data)
    sum_squared_distances_of_all_points = np.sum(distances**2)/2
    print(sum_squared_distances_of_all_points, n * sum_squared_distances_to_centroid)

# Test the lemma for  cluster 0
centroid = kmeans.centroids[0]
lemma_2(X[kmeans.labels == 0], centroid)
1812.8736866847603 1812.8736866847605
مطالب اختیاری دربارهٔ k-means
تمرینها
الگوریتم لوید را در کلاسی با متدهای
fitوpredictبستهبندی کنید و در یک آزمون بررسی کنید که دنبالهٔ SSE نزولی است. پیادهسازی اعشاری در کجا میتواند این ادعا را بشکند؟زمان یک تکرار را برای اندازه بگیرید و سپس با دو برابر کردن و تکرار کنید. پیشبینی را تأیید کنید و بگویید چه چیز دیگری با رشد میکند.
یک مجموعهٔ سهنقطهای و یک مقداردهی اولیه بسازید که الگوریتم لوید در آن به افرازی همگرا شود که کمینهٔ کلی نیست؛ سپس نشان دهید مقداردهی اولیهٔ دیگری افراز بهتر را پیدا میکند.