خوشهبندی (بخش ۱)
 گروه علوم کامپیوتر، دانشگاه فردوسی مشهد
الگوریتمهای خوشهبندی میکوشند از خواص داده، افراز یا برچسبگذاری گسسته و بهینهای برای گروههای نقطهها بیاموزند.
خوشهبندی، وظیفهٔ افراز نقطههای داده به گروههای طبیعی به نام خوشه است، بهگونهای که نقطههای درون یک گروه بسیار شبیه و نقطههای گروههای مختلف تا حد ممکن نامتشابه باشند zaki2020data.
بسته به داده و ویژگیهای مطلوب خوشهها، الگوهای گوناگونی از خوشهبندی داریم مانند نمایندهبنیان، سلسلهمراتبی، چگالیبنیان، گرافبنیان و طیفی. خوشهبندی رویکردی یادگیری بدوننظارت است، چون برای یادگیری پارامترهای مدل به مجموعهدادهٔ آموزشی جداگانه نیاز ندارد.
یک الگوریتم جستوجوی فراگیر برای یافتن خوشهبندی خوب این است که همهٔ افرازهای ممکن نقطه به خوشه را بسازیم، برای هر کدام نمرهٔ بهینگی را حساب کنیم و خوشهبندی با بهترین نمره را نگه داریم. ولی این کار آشکارا ناممکن است، چون تعداد خوشهبندیهای نقطه در گروه از مرتبهٔ است.
بسیاری از الگوریتمهای خوشهبندی در Scikit-Learn و جاهای دیگر هست، ولی شاید سادهترینشان برای فهم، الگوریتمی به نام خوشهبندی k-means است که در sklearn.cluster.KMeans پیاده شده است.
با وارد کردنهای استاندارد آغاز میکنیم:
Source
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('seaborn-v0_8-whitegrid')
import numpy as np
import warnings
warnings.filterwarnings("ignore")
معرفی k-means
الگوریتم k-means درون یک مجموعهدادهٔ چندبُعدی و بدون برچسب، تعداد از پیش تعیینشدهای خوشه میجوید. این کار را با تصوری ساده از خوشهبندی بهینه انجام میدهد:
مرکز خوشه میانگین حسابی همهٔ نقطههای آن خوشه است.
هر نقطه به مرکز خوشهٔ خودش نزدیکتر است تا به مرکزهای دیگر.
این دو فرض پایهٔ مدل k-means است. بهزودی میبینیم الگوریتم دقیقاً چگونه به این جواب میرسد؛ فعلاً یک مجموعهدادهٔ ساده را ببینیم.
نخست یک مجموعهدادهٔ دوبُعدی با چهار تودهٔ جدا میسازیم. برای تأکید بر اینکه الگوریتم بدوننظارت است، برچسبها را از نمودار بیرون میگذاریم (شکل زیر):
from sklearn.datasets import make_blobs
X, y_true = make_blobs(n_samples=300, centers=4,
                       cluster_std=0.60, random_state=0)

fig, ax = plt.subplots()
plt.scatter(X[:, 0], X[:, 1], s=20)
ax.set_aspect('equal')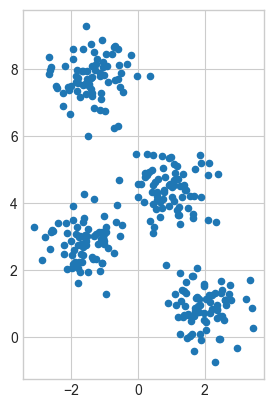
با چشم، جدا کردن چهار خوشه نسبتاً آسان است. الگوریتم k-means این کار را خودکار انجام میدهد و در Scikit-Learn با API معمول برآوردگر:
from sklearn.cluster import KMeans
kmeans = KMeans(n_clusters=4)
kmeans.fit(X)
y_kmeans = kmeans.predict(X)
بیایید نتیجه را با رنگکردن داده بر پایهٔ این برچسبها ببینیم (شکل زیر). همچنین مرکزهای خوشه را که برآوردگر k-means یافته است رسم میکنیم:
fig, ax = plt.subplots()
plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=20, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='black', s=100)
ax.set_aspect('equal')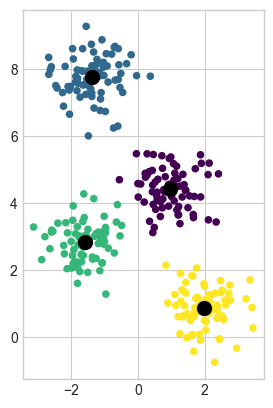
خبر خوب این است که الگوریتم k-means (دستکم در این حالت ساده) نقطهها را تقریباً همانگونه به خوشهها میدهد که با چشم میدادیم. ولی شاید بپرسید این الگوریتم چگونه این خوشهها را اینقدر سریع مییابد: تعداد ترکیبهای ممکن انتساب خوشه در تعداد نقطهها نمایی است — جستوجوی فراگیر بسیار بسیار گران میشد. خوشبختانه چنین جستوجویی لازم نیست: رویکرد معمول به k-means یک روش تکراری شهودی به نام امید ریاضی–بیشینهسازی است.
امید ریاضی–بیشینهسازی
امید ریاضی–بیشینهسازی (E–M) الگوریتمی نیرومند است که در بافتهای گوناگون علم داده سر بر میآورد. k-means کاربرد خاص ساده و آسانفهم این الگوریتم است و اینجا کوتاه مرورش میکنیم. خلاصه، رویکرد امید ریاضی–بیشینهسازی اینجا از این روند تشکیل میشود:
چند مرکز خوشه حدس بزن.
تا همگرایی تکرار کن:
گام E: هر نقطه را به نزدیکترین مرکز خوشه نسبت بده.
گام M: مرکزهای خوشه را میانگین نقطههای منتسب به خودشان بگذار.
اینجا گام E یا گام امید ریاضی نامیده میشود چون شامل بهروزرسانی امید ما از تعلق هر نقطه به یک خوشه است. گام M یا گام بیشینهسازی نام دارد چون شامل بیشینهسازی تابع برازندگیای است که جای مرکزهای خوشه را تعیین میکند — در این حالت، این بیشینهسازی با گرفتن میانگین سادهٔ دادهٔ هر خوشه انجام میشود.
دربارهٔ این الگوریتم نوشتههای فراوانی هست، ولی میتوان چنین خلاصه کرد: در شرایط معمول، هر تکرار گام E و M همیشه به برآورد بهتری از ویژگیهای خوشه میانجامد.
میتوانیم الگوریتم را مطابق شکل زیر مصور کنیم. برای مقدارهای آغازینِ همین مثال، خوشهها در تنها سه تکرار همگرا میشوند. (برای نسخهٔ تعاملی این شکل، کد پیوست آنلاین را ببینید.)
الگوریتم k-means آنقدر ساده است که میتوان در چند خط کد نوشت. پیادهسازی بسیار سادهٔ زیر را ببینید (شکل زیر):
from sklearn.metrics import pairwise_distances_argmin

def find_clusters(X, n_clusters, rseed=2):
    # 1. Randomly choose clusters
    rng = np.random.RandomState(rseed)
    i = rng.permutation(X.shape[0])[:n_clusters]
    centers = X[i]

    while True:
        # 2a. Assign labels based on closest center
        labels = pairwise_distances_argmin(X, centers)

        # 2b. Find new centers from means of points
        new_centers = np.array([X[labels == i].mean(0)
                                for i in range(n_clusters)])

        # 2c. Check for convergence
        if np.all(centers == new_centers):
            break
        centers = new_centers

    return centers, labels

centers, labels = find_clusters(X, 4)
fig, ax = plt.subplots()
plt.scatter(X[:, 0], X[:, 1], c=labels,
            s=20, cmap='viridis')
ax.set_aspect('equal') 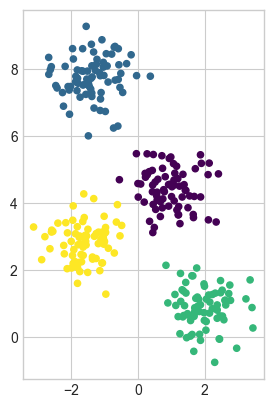
بیشتر پیادهسازیهای آزمودهشده کمی بیشتر از این کار میکنند، ولی تابع بالا جانِ رویکرد امید ریاضی–بیشینهسازی را میرساند.
چند نکتهٔ هشداردهنده هست که هنگام بهکارگیری الگوریتم امید ریاضی–بیشینهسازی باید در نظر داشت:
ممکن است نتیجهٔ بهینهٔ جهانی به دست نیاید
نخست، هرچند روند E–M تضمینشده در هر گام نتیجه را بهتر میکند، اطمینانی نیست که به جواب بهینهٔ جهانی برسد. برای نمونه اگر در رویهٔ سادهٔ خود از دانهٔ تصادفی دیگری استفاده کنیم، حدسهای آغازین خاص به نتیجههای ضعیفی میرسند (شکل زیر):
centers, labels = find_clusters(X, 4, rseed=0)
fig, ax = plt.subplots()
plt.scatter(X[:, 0], X[:, 1], c=labels,
            s=20, cmap='viridis')
ax.set_aspect('equal')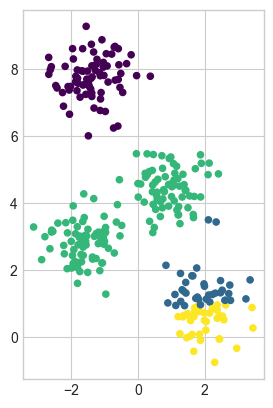
اینجا رویکرد E–M همگرا شده، ولی به پیکربندی بهینهٔ جهانی نرسیده است. به همین دلیل معمول است که الگوریتم را با چند حدس آغازین اجرا کنند، همانگونه که Scikit-Learn بهطور پیشفرض میکند (تعداد با پارامتر n_init تعیین میشود که پیشفرضش ۱۰ است).
تعداد خوشهها باید از پیش انتخاب شود
چالش رایج دیگر در k-means این است که باید بگویید چند خوشه انتظار دارید: نمیتواند تعداد خوشهها را از داده بیاموزد. برای نمونه اگر از الگوریتم بخواهیم شش خوشه بیابد، با خوشحالی بهترین شش خوشه را مییابد، همانگونه که در شکل ۴۷-۶ میبینید:
labels = KMeans(6, random_state=0).fit_predict(X)
fig, ax = plt.subplots()
plt.scatter(X[:, 0], X[:, 1], c=labels, s=20, cmap='viridis')
ax.set_aspect('equal')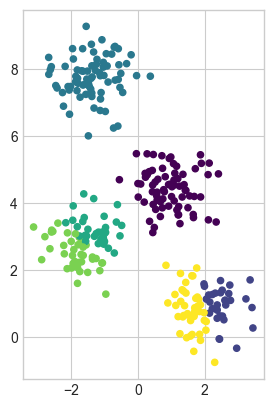
اینکه نتیجه معنادار هست یا نه پرسشی است که پاسخ قطعی به آن دشوار است؛ یک رویکرد نسبتاً شهودی که اینجا بیشتر دربارهاش بحث نمیکنیم تحلیل سیلوئت نام دارد.
بهجای آن میتوانید الگوریتم پیچیدهتری برگزینید که سنجهٔ کمّی بهتری برای برازندگی برحسب تعداد خوشه دارد (مثلاً مدلهای مخلوط گاوسی) یا میتواند تعداد مناسب خوشه را انتخاب کند (مثلاً DBSCAN، mean-shift یا affinity propagation که همه در زیرماژول sklearn.cluster هستند).
k-means به مرزهای خطی محدود است
فرضهای بنیادی مدل k-means (نقطهها به مرکز خوشهٔ خودشان نزدیکترند تا به بقیه) یعنی اگر خوشهها هندسهٔ پیچیده داشته باشند، الگوریتم اغلب کارآمد نیست.
بهویژه مرزهای میان خوشههای k-means همیشه خطیاند (مثل حالت ۱ در نظریهٔ تصمیم بیزی)، پس برای مرزهای پیچیدهتر شکست میخورد. دادهٔ زیر را با برچسبهای خوشهای که رویکرد معمول k-means مییابد ببینید (شکل زیر):
from sklearn.datasets import make_moons
X, y = make_moons(200, noise=.05, random_state=0)
labels = KMeans(2, random_state=0).fit_predict(X)
plt.scatter(X[:, 0], X[:, 1], c=labels, s=50, cmap='viridis')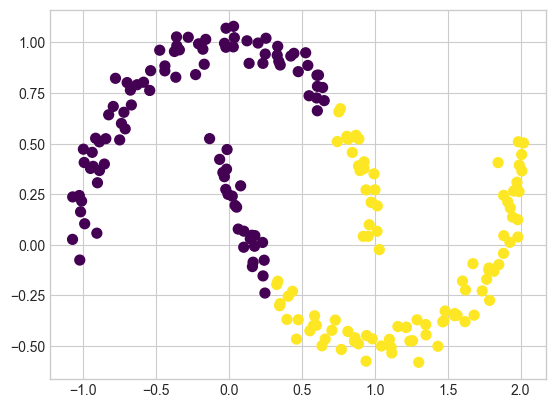
این وضعیت بحث فصلهای بعد را یاد میآورد که با یک تبدیل کرنل داده را به بُعدی بالاتر میبردیم که در آن جدایی خطی ممکن بود. میتوان تصور کرد همان ترفند را به کار ببریم تا k-means مرزهای غیرخطی را کشف کند.
یک نسخه از این k-means کرنلشده در Scikit-Learn در برآوردگر SpectralClustering پیاده شده است Fayaz2015SpectralNemati2018Gradient.
از گراف نزدیکترین همسایهها برای محاسبهٔ نمایشی ابعاد بالاتر از داده استفاده میکند و سپس با الگوریتم k-means برچسب میگذارد:
from sklearn.cluster import SpectralClustering
model = SpectralClustering(n_clusters=2, affinity='nearest_neighbors',
                           assign_labels='kmeans')
labels = model.fit_predict(X)
plt.scatter(X[:, 0], X[:, 1], c=labels, s=50, cmap='viridis')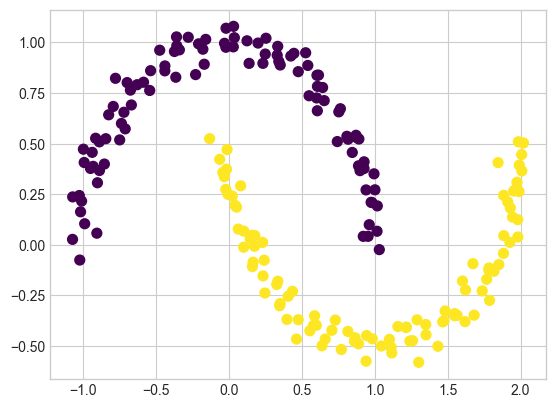
میبینیم که با این رویکرد تبدیل کرنل، k-means کرنلشده میتواند مرزهای غیرخطی پیچیدهتر میان خوشهها را بیابد.
k-means برای تعداد زیاد نمونه میتواند کند باشد
چون هر تکرار k-means باید به همهٔ نقطههای مجموعهداده دسترسی یابد، الگوریتم با رشد تعداد نمونهها نسبتاً کند میشود.
شاید بپرسید آیا میتوان این الزام به استفاده از همهٔ داده در هر تکرار را شل کرد؛ مثلاً فقط زیرمجموعهای از داده برای بهروزرسانی مرکزها در هر گام به کار رود.
این ایدهٔ الگوریتمهای k-means دستهای است که یک شکلش در sklearn.cluster.MiniBatchKMeans پیاده شده است.
رابط آن همان KMeans استاندارد است؛ در ادامه نمونهای از کاربردش را میبینیم.
مثالها
با در نظر داشتن این محدودیتهای الگوریتم، میتوانیم از k-means در موقعیتهای گوناگون به سود خود بهره بگیریم. حالا چند مثال را میبینیم.
مثال ۱: k-means روی ارقام
برای شروع، k-means را روی همان دادهٔ سادهٔ ارقام به کار میبریم که در درختهای تصمیم و جنگلهای تصادفی و تحلیل مؤلفههای اصلی هم به کار بردیم. اینجا میکوشیم با k-means ارقام مشابه را بدون استفاده از اطلاعات برچسب اصلی بیابیم؛ این میتواند شبیه گام اول استخراج معنا از مجموعهدادهای تازه باشد که هیچ اطلاعات برچسب پیشینی ندارید.
با بارگذاری مجموعهداده آغاز میکنیم و سپس خوشهها را مییابیم. یادآوری: مجموعهدادهٔ ارقام ۱٬۷۹۷ نمونه با ۶۴ ویژگی دارد که هر یک از این ۶۴ ویژگی روشنایی یک پیکسل در تصویر ۸×۸ است:
from sklearn.datasets import load_digits
digits = load_digits()
digits.data.shape
(1797, 64)خوشهبندی را همانگونه که پیشتر کردیم میتوان انجام داد:
kmeans = KMeans(n_clusters=10, random_state=0)
clusters = kmeans.fit_predict(digits.data)
kmeans.cluster_centers_.shape
(10, 64)نتیجه ۱۰ خوشه در ۶۴ بُعد است. دقت کنید که خود مرکزهای خوشه نقطههایی ۶۴-بُعدیاند و میتوان آنها را نمایندهٔ رقم «معمول» درون خوشه دانست. بیایید ببینیم این مرکزها چه شکلیاند (شکل زیر):
fig, ax = plt.subplots(2, 5, figsize=(8, 3))
centers = kmeans.cluster_centers_.reshape(10, 8, 8)
for axi, center in zip(ax.flat, centers):
    axi.set(xticks=[], yticks=[])
    axi.imshow(center, interpolation='nearest', cmap=plt.cm.binary)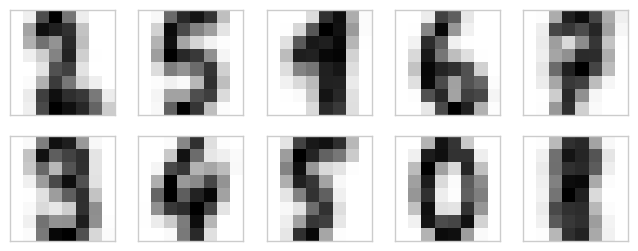
میبینیم که حتی بدون برچسبها هم KMeans میتواند خوشههایی بیابد که مرکزهایشان ارقام قابلشناساییاند، شاید بهجز ۱ و ۸.
چون k-means هیچ از هویت خوشهها نمیداند، برچسبهای ۰–۹ ممکن است جابهجا شوند. این را با تطبیق دادن هر برچسب خوشهٔ آموختهشده با برچسبهای واقعی یافتهشده در خوشهها اصلاح میکنیم:
from scipy.stats import mode

labels = np.zeros_like(clusters)
for i in range(10):
    mask = (clusters == i)
    labels[mask] = mode(digits.target[mask])[0]
اکنون میتوانیم ببینیم خوشهبندی بدوننظارتمان در یافتن ارقام مشابه چقدر دقیق بوده است:
from sklearn.metrics import accuracy_score
accuracy_score(digits.target, labels)0.7440178074568725با یک الگوریتم k-means ساده، گروهبندی درست را برای ۸۰٪ ارقام ورودی کشف کردیم! ماتریس درهمریختگی این کار را در شکل زیر ببینید:
from sklearn.metrics import confusion_matrix
import seaborn as sns
mat = confusion_matrix(digits.target, labels)
sns.heatmap(mat.T, square=True, annot=True, fmt='d',
            cbar=False, cmap='Blues',
            xticklabels=digits.target_names,
            yticklabels=digits.target_names)
plt.xlabel('true label')
plt.ylabel('predicted label');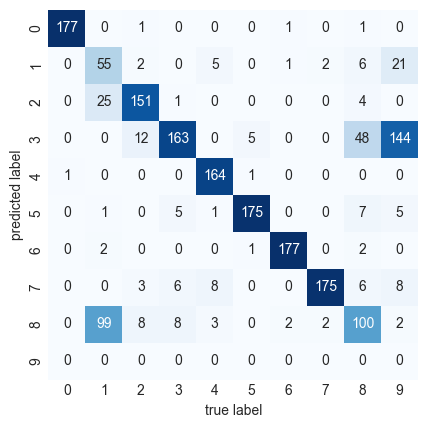
همانگونه که از مرکزهای خوشهٔ پیشین انتظار میرفت، نقطهٔ اصلی درهمریختگی میان هشتها و یکهاست. ولی این هم نشان میدهد با k-means میتوانیم در اساس یک دستهبند رقم بسازیم بدون هیچ ارجاعی به برچسبهای معلوم!
فقط برای تفریح، بیایید کمی جلوتر برویم. میتوانیم الگوریتم تعبیهٔ تصادفی همسایهٔ t-توزیعشده (t-SNE، که در یادگیری منیفلد آمد) را برای پیشپردازش داده پیش از k-means به کار ببریم. t-SNE الگوریتم تعبیهٔ غیرخطی است که بهویژه در نگه داشتن نقطههای درون خوشهها ماهر است. ببینیم چه میکند:
from sklearn.manifold import TSNE

# Project the data: this step will take several seconds
tsne = TSNE(n_components=2, init='random',
            learning_rate='auto',random_state=0)
digits_proj = tsne.fit_transform(digits.data)

# Compute the clusters
kmeans = KMeans(n_clusters=10, random_state=0)
clusters = kmeans.fit_predict(digits_proj)

# Permute the labels
labels = np.zeros_like(clusters)
for i in range(10):
    mask = (clusters == i)
    labels[mask] = mode(digits.target[mask])[0]

# Compute the accuracy
accuracy_score(digits.target, labels)0.9415692821368948این دقت دستهبندی است بدون استفاده از برچسبها. این توان یادگیری بدوننظارت است وقتی با احتیاط به کار رود: میتواند اطلاعاتی را از مجموعهداده بیرون بکشد که استخراجش با دست یا چشم دشوار است.
مثال ۲: k-means برای فشردهسازی رنگ
یکی از کاربردهای جالب خوشهبندی، فشردهسازی رنگ در تصویرهاست (این مثال از «کوانتیزهسازی رنگ با K-Means» در Scikit-Learn گرفته شده است. برای نمونه تصور کنید تصویری با میلیونها رنگ دارید. در بیشتر تصویرها تعداد زیادی از رنگها به کار نرفتهاند و بسیاری از پیکسلها رنگهای مشابه یا حتی یکسان دارند.
برای نمونه تصویر شکل زیر را در نظر بگیرید که از ماژول datasets در Scikit-Learn است (برای این کار باید بستهٔ PIL نصب باشد):
(برای نسخهٔ رنگی این تصویر و تصویرهای بعد، نسخهٔ آنلاین کتاب را ببینید).
# Note: this requires the PIL package to be installed
from sklearn.datasets import load_sample_image
china = load_sample_image("china.jpg")
ax = plt.axes(xticks=[], yticks=[])
ax.imshow(china);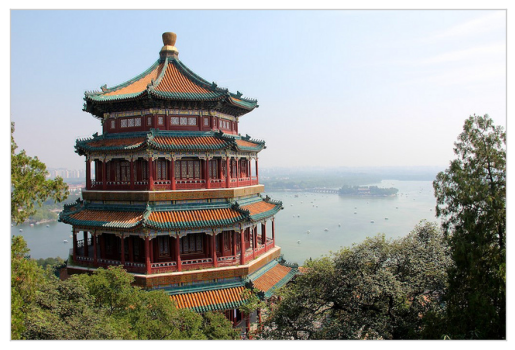
خود تصویر در آرایهای سهبُعدی با اندازهٔ (height, width, RGB) ذخیره شده است که سهم قرمز/آبی/سبز را بهصورت عدد صحیح از ۰ تا ۲۵۵ در بر دارد:
china.shape(427, 640, 3)یک راه دیدن این مجموعه پیکسل، ابری از نقطهها در فضای رنگ سهبُعدی است.
داده را به [n_samples, n_features] بازشکل میدهیم و رنگها را به بازهٔ ۰ تا ۱ میبریم:
data = china / 255.0  # use 0...1 scale
data = data.reshape(-1, 3)
data.shape
(273280, 3)میتوانیم این پیکسلها را در این فضای رنگ ببینیم و برای کارایی از زیرمجموعهای ۱۰٬۰۰۰ پیکسلی بهره ببریم (شکل زیر):
def plot_pixels(data, title, colors=None, N=10000):
    if colors is None:
        colors = data

    # choose a random subset
    rng = np.random.default_rng(0)
    i = rng.permutation(data.shape[0])[:N]
    colors = colors[i]
    R, G, B = data[i].T

    fig, ax = plt.subplots(1, 2, figsize=(16, 6))
    ax[0].scatter(R, G, color=colors, marker='.')
    ax[0].set(xlabel='Red', ylabel='Green', xlim=(0, 1), ylim=(0, 1))

    ax[1].scatter(R, B, color=colors, marker='.')
    ax[1].set(xlabel='Red', ylabel='Blue', xlim=(0, 1), ylim=(0, 1))

    fig.suptitle(title, size=20);
plot_pixels(data, title='Input color space: 16 million possible colors')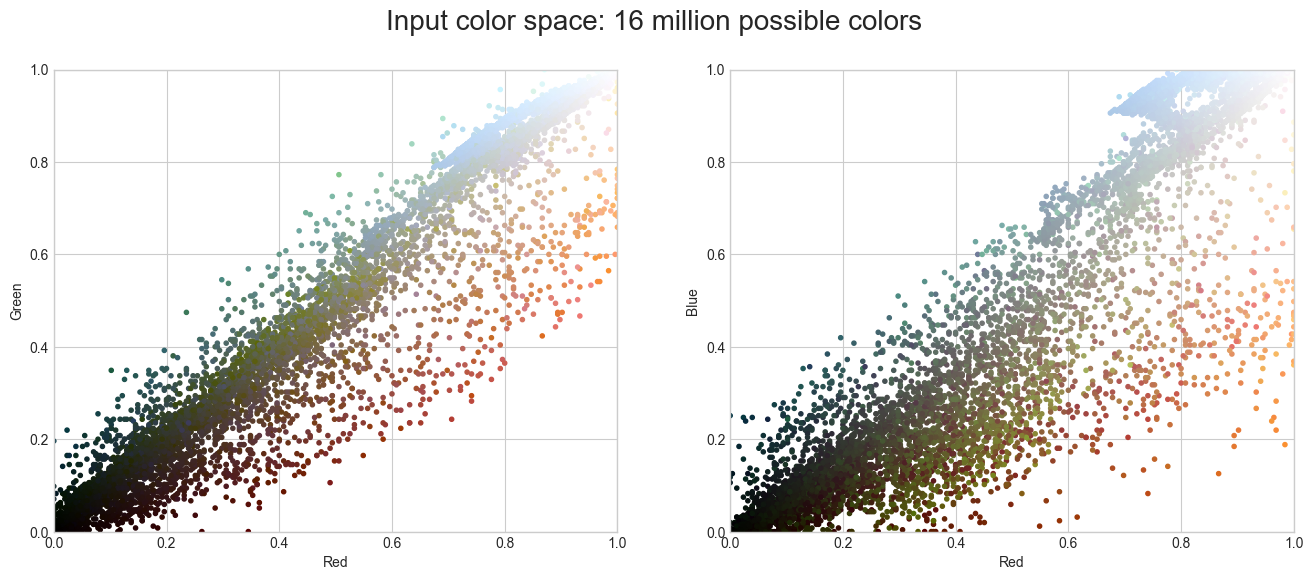
حالا با خوشهبندی k-means در فضای پیکسل، این ۱۶ میلیون رنگ را به ۱۶ رنگ کم میکنیم. چون با مجموعهدادهٔ بسیار بزرگی سروکار داریم، از k-means دستهای کوچک (mini-batch) بهره میبریم که روی زیرمجموعههایی از داده کار میکند و نتیجه (شکل زیر) را بسیار سریعتر از k-means استاندارد میدهد:
from sklearn.cluster import MiniBatchKMeans
kmeans = MiniBatchKMeans(16)
kmeans.fit(data)
new_colors = kmeans.cluster_centers_[kmeans.predict(data)]

plot_pixels(data, colors=new_colors,
            title="Reduced color space: 16 colors")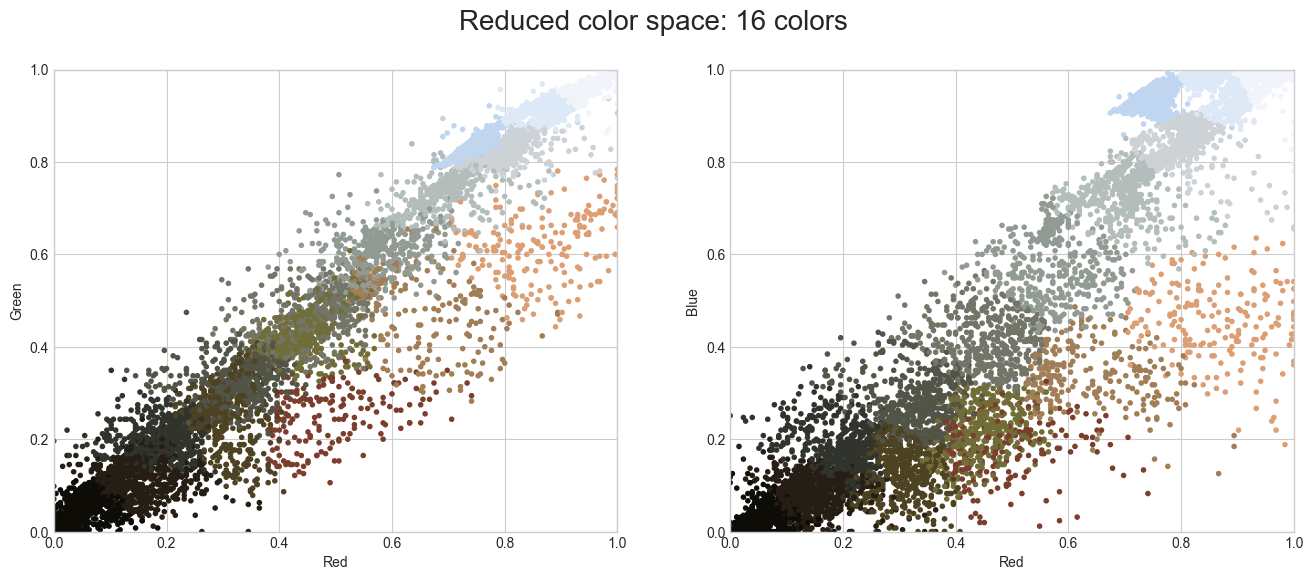
نتیجه بازرنگکردن پیکسلهای اصلی است که هر پیکسل رنگ نزدیکترین مرکز خوشهاش را میگیرد. رسم این رنگهای تازه در فضای تصویر (نه فضای پیکسل) اثر این کار را نشان میدهد (شکل زیر):
china_recolored = new_colors.reshape(china.shape)

fig, ax = plt.subplots(1, 2, figsize=(16, 6),
                       subplot_kw=dict(xticks=[], yticks=[]))
fig.subplots_adjust(wspace=0.05)
ax[0].imshow(china)
ax[0].set_title('Original Image', size=16)
ax[1].imshow(china_recolored)
ax[1].set_title('16-color Image', size=16);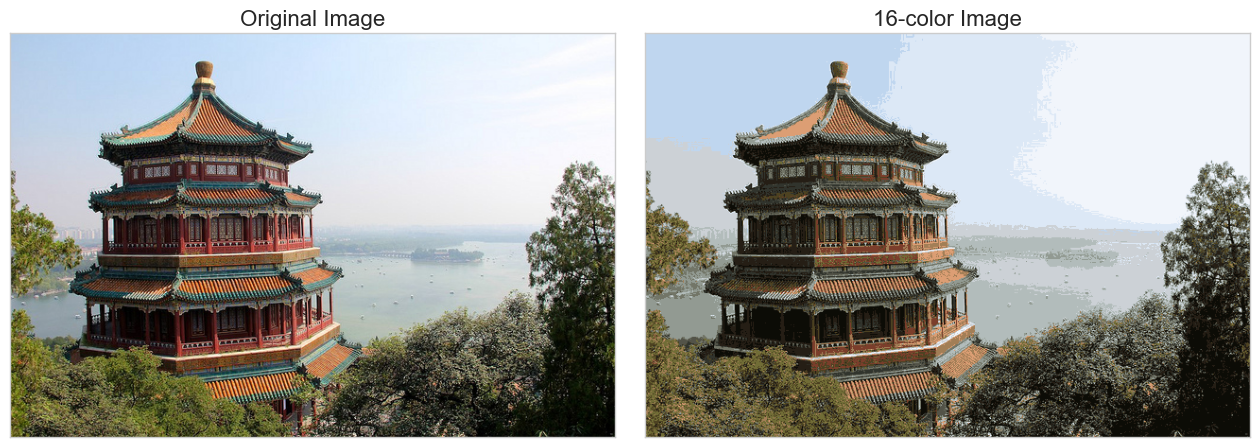
قطعاً پار بعضی جزئیات در پنل سمت راست از دست میرود، ولی تصویر کلی هنوز آسانقابلتشخیص است. از نظر بایت لازم برای ذخیرهٔ دادهٔ خام، تصویر سمت راست ضریب فشردهسازی حدود یک میلیون را بهدست میآورد! البته این رویکرد به وفاداری روشهای فشردهسازی تصویرِ ویژهٔ همین کار مانند JPEG نمیرسد، ولی مثال قدرت اندیشیدن بیرون از چارچوب با روشهای بدوننظارتی مانند k-means را نشان میدهد.
تمرینها
اتحاد را اثبات کنید و با آن نشان دهید نسبت دادن هر نقطه به نزدیکترین مرکز نمیتواند SSE را افزایش دهد.
نشان دهید برای یک افراز ثابت، SSE با مرکز (میانگین) کمینه میشود؛ با مشتق گرفتن نسبت به و صفر گذاشتن گرادیان. چرا این کار جواب بستهٔ کل مسئله را نمیدهد؟
k-means نوتبوک را روی ارقام با و پنج مقدار آغازین اجرا کنید؛ پراکندگی SSE نهایی و شاخص رند تعدیلشده را گزارش دهید. کدام بیشتر تغییر میکند و چرا؟
یک گام E و یک گام M را برای یک مخلوط گاوسی دوبؤلفهای یکبُعدی روی نقطههای دستی انجام دهید. مسئولیتها را با انتساب سختِ k-means مقایسه کنید.
مطالعهٔ بیشتر
Scikit-learn: مقایسهٔ الگوریتمهای مختلف خوشهبندی روی مجموعهدادههای اسباببازی