مدلهای مخلوط گاوسی، بخش 2
مطالب این بخش از فصل 13 کتاب Data Mining and Machine Learning نوشتهٔ محمد ج. زکی و واگنر مِیرا جونیور
(2020) گرفته شده است Zaki & Meira (2020)
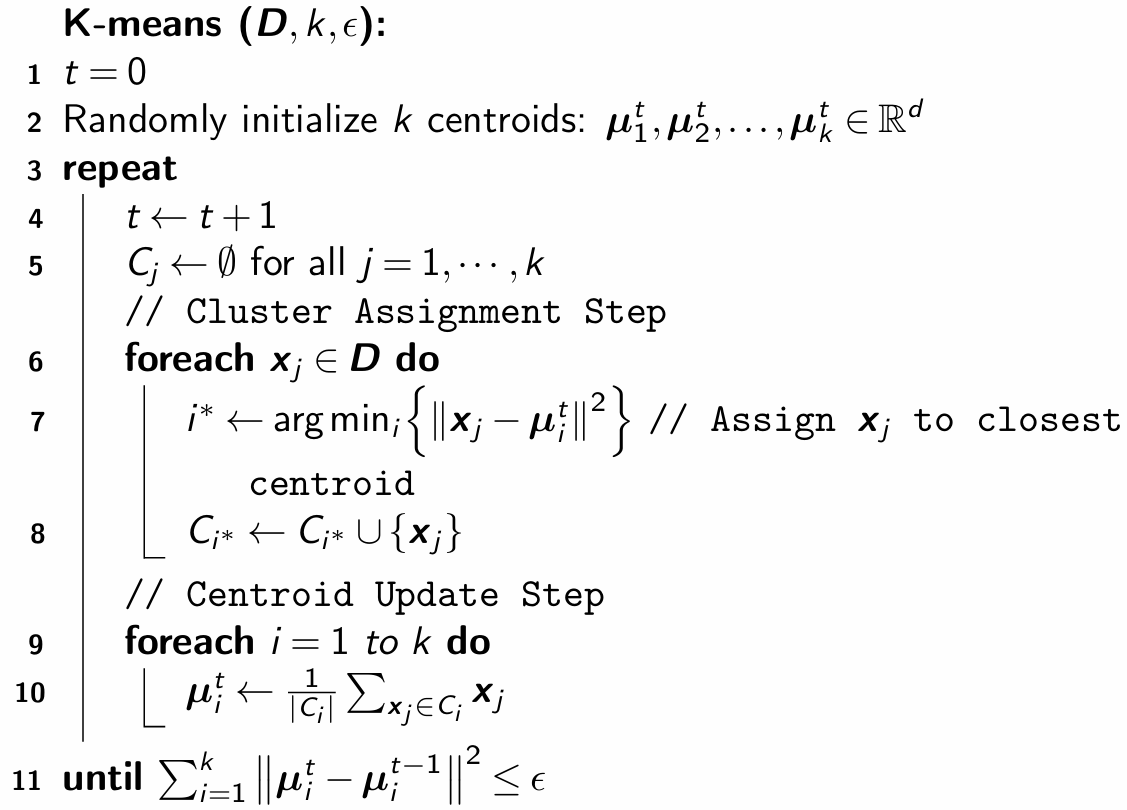
الگوریتم K-Means: مرور ¶ تابع امتیاز مجموع مربع خطا چنین تعریف میشود
S S E ( C ) = ∑ i = 1 k ∑ x j ∈ C i ∥ x j − μ i ∥ 2 SSE(\mathcal{C}) = \sum_{i=1}^{k}\sum_{\mathbf{x}_{j} \in
C_{i}}\|\mathbf{x}_{j}-\mathbf{\mu}_i\|^2 SSE ( C ) = i = 1 ∑ k x j ∈ C i ∑ ∥ x j − μ i ∥ 2 هدف یافتن خوشهبندیای است که امتیاز SSE را کمینه کند:
C ∗ = arg min C { S S E ( C ) } \mathcal{C}^* = \arg \min_{\mathcal{C}} \{ SSE(\mathcal{C}) \} C ∗ = arg C min { SSE ( C )} K-means رویکردی تکراری و حریصانه برای یافتن خوشهبندیای دارد که تابع هدف SSE را کمینه کند. از اینرو
میتواند به بهینهٔ محلی برسد، نه خوشهبندی بهینهٔ کلی.
الگوریتم K-Means: گامها ¶ K-means میانگین خوشهها را با تولید تصادفی k k k
تخصیص خوشه: هر نقطهٔ x j ∈ D \mathbf{x}_{j} \in \mathbf{D} x j ∈ D C i C_i C i μ i \mathbf{\mu}_i μ i
i ∗ = arg min i = 1 k { ∥ x j − μ i ∥ 2 } i^* = \arg \min_{i=1}^k \Bigl\{\|\mathbf{x}_{j} - \mathbf{\mu}_i\|^2\Bigr\} i ∗ = arg i = 1 min k { ∥ x j − μ i ∥ 2 } بهروزرسانی مرکز: مقدارهای میانگین تازه برای هر خوشه از نقطههای C i C_i C i
این گامها تا همگرایی به نقطهٔ ثابت یا کمینهٔ محلی تکرار میشوند.
الگوریتم K-Means ¶ خوشهبندی با امید-بیشینهسازی ¶ X a X_a X a a a a X = ( X 1 , X 2 , … , X d ) \mathbf{X} = (X_1, X_2, \dots, X_d) X = ( X 1 , X 2 , … , X d ) d d d x j \mathbf{x}_{j} x j X \mathbf{X} X
فرض میکنیم هر خوشهٔ C i C_i C i
f i ( x ) = f ( x ∣ μ i , Σ i ) = 1 ( 2 π ) d 2 ∣ Σ i ∣ 1 2 exp { − ( x − μ i ) T Σ i − 1 ( x − μ i ) 2 } f_i(\mathbf{x}) = f(\mathbf{x}|\mathbf{\mu}_i,\mathbf{\Sigma}_i)
= \frac{1}{(2\pi)^\frac{d}{2}|\mathbf{\Sigma}_i|^\frac{1}{2}}
\exp\left\{-\frac{(\mathbf{x}-\mathbf{\mu}_{i})^{T} \mathbf{\Sigma}_i^{-1}
(\mathbf{x}-\mathbf{\mu}_{i})}{2}\right\} f i ( x ) = f ( x ∣ μ i , Σ i ) = ( 2 π ) 2 d ∣ Σ i ∣ 2 1 1 exp { − 2 ( x − μ i ) T Σ i − 1 ( x − μ i ) } که μ i ∈ R d \mathbf{\mu}_i \in \mathbb{R}^d μ i ∈ R d Σ i ∈ R d × d \mathbf{\Sigma}_i \in \mathbb{R}^{d \times d} Σ i ∈ R d × d
تابع چگالی احتمال X \mathbf{X} X مدل مخلوط گاوسی روی همهٔ k k k
f ( x ) = ∑ i = 1 k f i ( x ) P ( C i ) = ∑ i = 1 k f ( x ∣ μ i , Σ i ) P ( C i ) f(\mathbf{x}) = \sum_{i=1}^k f_i(\mathbf{x}) P(C_i)
= \sum_{i=1}^k f(\mathbf{x} \mid \mathbf{\mu}_i, \mathbf{\Sigma}_i) P(C_i) f ( x ) = i = 1 ∑ k f i ( x ) P ( C i ) = i = 1 ∑ k f ( x ∣ μ i , Σ i ) P ( C i ) که احتمالهای پیشین P ( C i ) P(C_i) P ( C i ) پارامترهای مخلوط مینامند و باید شرط زیر را برآورده کنند:
∑ i = 1 k P ( C i ) = 1 \sum_{i=1}^k P(C_i) = 1 i = 1 ∑ k P ( C i ) = 1 برآورد بیشترین درستنمایی ¶ مجموعهٔ همهٔ پارامترهای مدل را بهصورت فشرده چنین مینویسیم:
θ = { μ 1 , Σ 1 , P ( C 1 ) , … , μ k , Σ k , P ( C k ) } \mathbf{\theta} = \left\{\mathbf{\mu}_1,\mathbf{\Sigma}_1,P(C_1), \dots, \mathbf{\mu}_k, \mathbf{\Sigma}_k, P(C_k)\right\} θ = { μ 1 , Σ 1 , P ( C 1 ) , … , μ k , Σ k , P ( C k ) } با داشتن مجموعهدادهٔ D \mathbf{D} D درستنمایی θ \mathbf{\theta} θ
P ( D ∣ θ ) = ∏ j = 1 n f ( x j ) P(\mathbf{D} | \mathbf{\theta}) = \prod_{j=1}^n f(\mathbf{x}_{j}) P ( D ∣ θ ) = j = 1 ∏ n f ( x j ) MLE θ \mathbf{\theta} θ
θ ∗ = arg max θ { ln P ( D ∣ θ ) } \mathbf{\theta}^* = \arg\max_{\mathbf{\theta}} \{\ln P(\mathbf{D} | \mathbf{\theta})\} θ ∗ = arg θ max { ln P ( D ∣ θ )} که تابع لگاریتم درستنمایی چنین است:
ln P ( D ∣ θ ) = ∑ j = 1 n ln f ( x j ) = ∑ j = 1 n ln ( ∑ i = 1 k f ( x j ∣ μ i , Σ i ) P ( C i ) ) \ln P(\mathbf{D} | \mathbf{\theta}) = \sum_{j=1}^n \ln f(\mathbf{x}_{j})
= \sum_{j=1}^n \ln \biggl( \sum_{i=1}^k f(\mathbf{x}_{j} | \mathbf{\mu}_i, \mathbf{\Sigma}_i)P(C_i)\biggr) ln P ( D ∣ θ ) = j = 1 ∑ n ln f ( x j ) = j = 1 ∑ n ln ( i = 1 ∑ k f ( x j ∣ μ i , Σ i ) P ( C i ) ) بیشینه کردن لگاریتم درستنمایی با امید-بیشینهسازی (EM) ¶ بیشینه کردن مستقیم لگاریتم درستنمایی روی θ \mathbf{\theta} θ جمع درون لگاریتم هست:
ln P ( D ∣ θ ) = ∑ j = 1 n ln ( ∑ i = 1 k f ( x j ∣ μ i , Σ i ) P ( C i ) ) \ln P(\mathbf{D} | \mathbf{\theta}) = \sum_{j=1}^n \ln \left( \sum_{i=1}^k f(\mathbf{x}_{j} | \mathbf{\mu}_i, \mathbf{\Sigma}_i) P(C_i) \right) ln P ( D ∣ θ ) = j = 1 ∑ n ln ( i = 1 ∑ k f ( x j ∣ μ i , Σ i ) P ( C i ) ) اگر تابع درستنمایی فقط یک گاوسی تنها داشت، مشتقگیری مستقیم سرراست بود. ولی در مدل مخلوط گاوسی،
حضور چند گاوسی درون جمع مشتقگیری را پیچیده میکند. چون هر نقطهٔ دادهٔ x j \mathbf{x}_j x j
EM چگونه کمک میکند؟ ¶ امید-بیشینهسازی رویکردی ساختیافته برای بیشینه کردن غیرمستقیم درستنمایی میدهد، با وارد کردن
متغیرهای پنهان — تخصیصهای خوشه w i j = P ( C i ∣ x j ) w_{ij} = P(C_i | \mathbf{x}_j) w ij = P ( C i ∣ x j ) گام امید این احتمالها را حساب
میکند و عملاً عضویتهای پنهان را برآورد میکند، و گام بیشینهسازی پارامترها را با این وزنها بهروز
میکند.
با تکرار میان این گامها، EM از پیچیدگی مشتقگیری مستقیم عبارت لگاریتمِ جمعِ تودرتو دوری میکند و برآورد
پارامترها را شدنی میسازد.
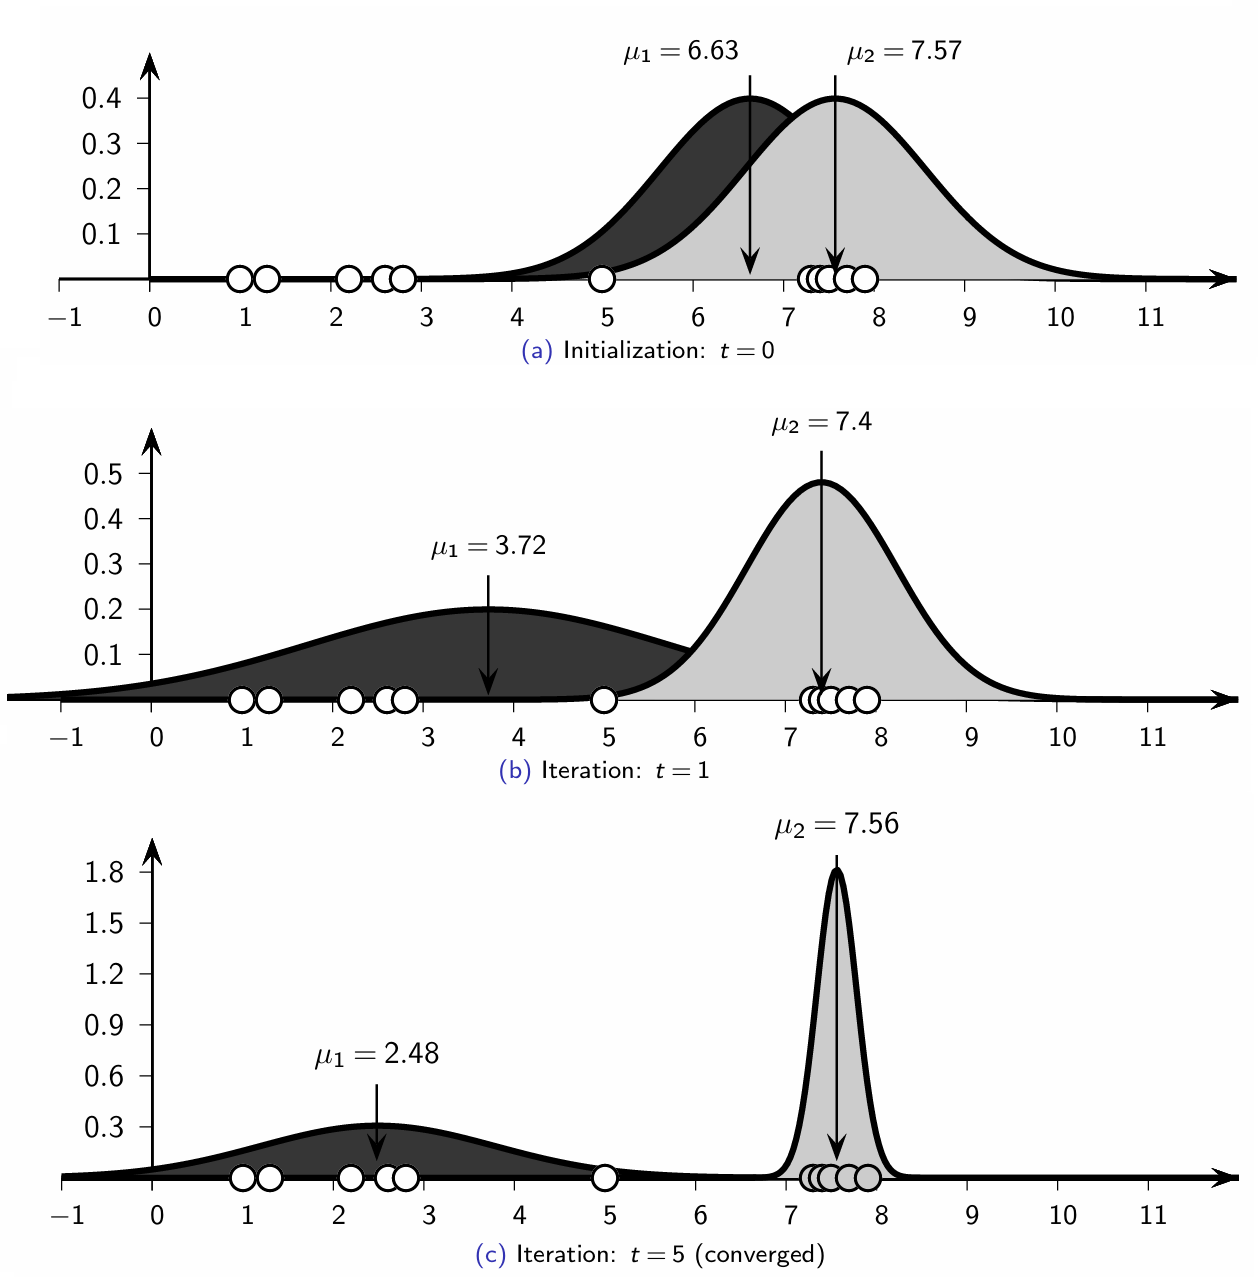
امید-بیشینهسازی برای مدلهای مخلوط گاوسی ¶ حالت یکبعدی: خوشهبندی نرمال تکمتغیره ¶ D \mathbf{D} D X X X x j ∈ R x_{j} \in \mathbb{R} x j ∈ R X X X
f i ( x ) = f ( x ∣ μ i , σ i 2 ) = 1 2 π σ i exp { − ( x − μ i ) 2 2 σ i 2 } f_i(x) = f(x | \mu_i, \sigma_i^2) =
\frac{1}{\sqrt{2\pi}\sigma_i} \exp \left\{-\frac{(x -
\mu_i)^2}{2\sigma_i^2} \right\} f i ( x ) = f ( x ∣ μ i , σ i 2 ) = 2 π σ i 1 exp { − 2 σ i 2 ( x − μ i ) 2 } که پارامترهای خوشه شامل μ i \mu_{i} μ i σ i 2 \sigma_{i}^2 σ i 2 P ( C i ) P(C_i) P ( C i )
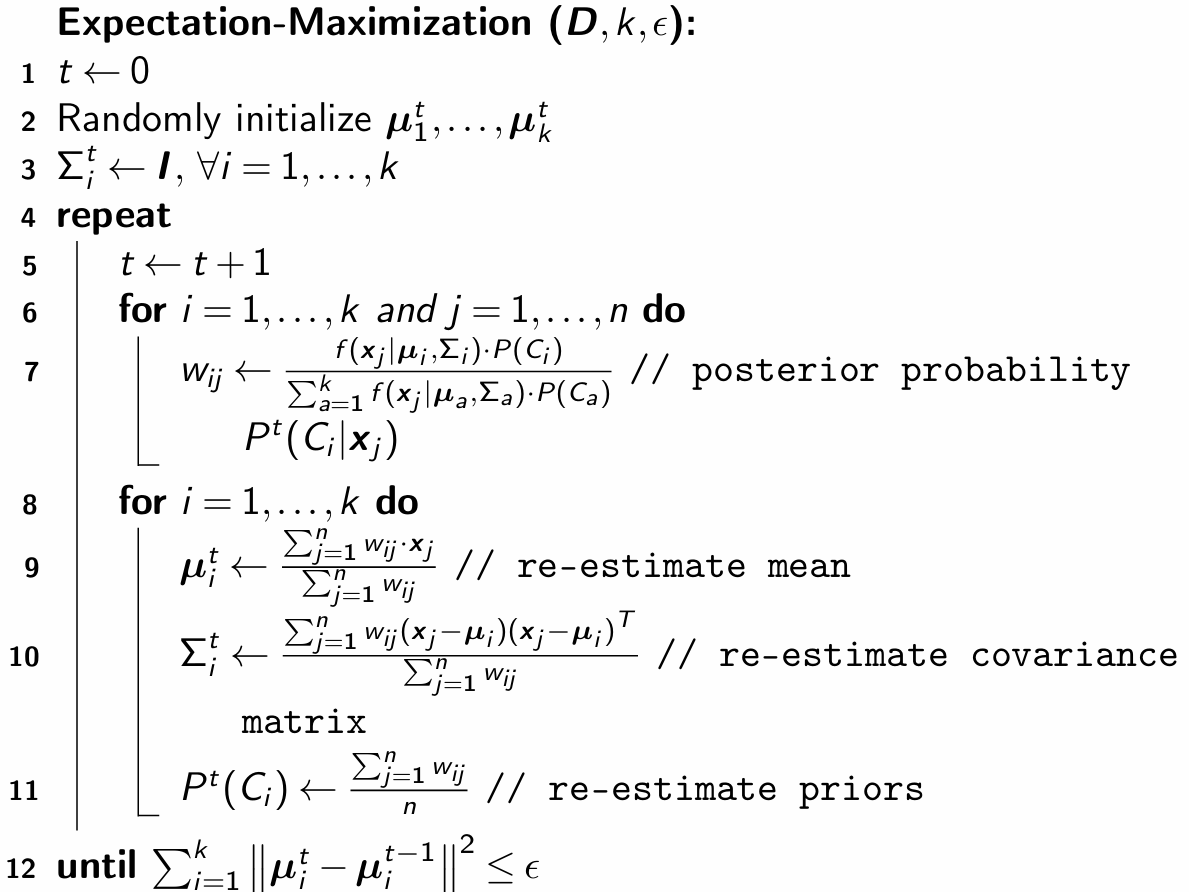
مقداردهی اولیه ¶ هر خوشهٔ C i C_i C i i = 1 , 2 , … , k i = 1, 2, \dots, k i = 1 , 2 , … , k μ i \mu_{i} μ i σ i 2 \sigma_{i}^2 σ i 2 P ( C i ) P(C_i) P ( C i )
گام امید ¶ با میانگین μ i \mu_i μ i σ i 2 \sigma_i^2 σ i 2 P ( C i ) P(C_i) P ( C i ) احتمال پسین خوشه با
قضیهٔ بیز حساب میشود:
w i j = P ( C i ∣ x j ) = f ( x j ∣ μ i , σ i 2 ) ⋅ P ( C i ) ∑ a = 1 k f ( x j ∣ μ a , σ a 2 ) ⋅ P ( C a ) w_{ij} = P(C_{i}|x_{j}) =
\frac{f(x_{j}|\mu_i,\sigma_i^2) \cdot P(C_{i})}
{\sum_{a=1}^k f(x_{j} |\mu_a, \sigma_a^2) \cdot P(C_{a})} w ij = P ( C i ∣ x j ) = ∑ a = 1 k f ( x j ∣ μ a , σ a 2 ) ⋅ P ( C a ) f ( x j ∣ μ i , σ i 2 ) ⋅ P ( C i ) گام بیشینهسازی ¶ با w i j w_{ij} w ij
بهروزرسانی میانگین (میانگین وزنی نقطهها):
μ i = ∑ j = 1 n w i j ⋅ x j ∑ j = 1 n w i j \mu_{i} = \frac{\sum_{j=1}^n w_{ij} \cdot x_{j}}
{\sum_{j=1}^n w_{ij}} μ i = ∑ j = 1 n w ij ∑ j = 1 n w ij ⋅ x j بهروزرسانی واریانس (واریانس وزنی نقطهها):
σ i 2 = ∑ j = 1 n w i j ( x j − μ i ) 2 ∑ j = 1 n w i j \sigma_{i}^{2} =
\frac{\sum_{j=1}^n w_{ij}(x_{j}-\mu_{i})^2}
{\sum_{j=1}^n w_{ij}} σ i 2 = ∑ j = 1 n w ij ∑ j = 1 n w ij ( x j − μ i ) 2 بهروزرسانی احتمال پیشین (کسر وزنهایی که به خوشه سهم میدهند):
P ( C i ) = ∑ j = 1 n w i j n P(C_{i}) =
\frac{\sum_{j=1}^n w_{ij}}{n} P ( C i ) = n ∑ j = 1 n w ij حالت چندمتغیره: مدل مخلوط گاوسی با کوواریانس کامل ¶ در حالت چندمتغیره ، هر خوشهٔ C i C_i C i
f i ( x ) = f ( x ∣ μ i , Σ i ) = 1 ( 2 π ) d 2 ∣ Σ i ∣ 1 2 exp { − ( x − μ i ) T Σ i − 1 ( x − μ i ) 2 } f_i(\mathbf{x}) = f(\mathbf{x}|\mathbf{\mu}_i,\mathbf{\Sigma}_i)
= \frac{1}{(2\pi)^\frac{d}{2}|\mathbf{\Sigma}_i|^\frac{1}{2}}
\exp\left\{-\frac{(\mathbf{x}-\mathbf{\mu}_{i})^{T} \mathbf{\Sigma}_i^{-1}
(\mathbf{x}-\mathbf{\mu}_{i})}{2}\right\} f i ( x ) = f ( x ∣ μ i , Σ i ) = ( 2 π ) 2 d ∣ Σ i ∣ 2 1 1 exp { − 2 ( x − μ i ) T Σ i − 1 ( x − μ i ) } که μ i ∈ R d \mathbf{\mu}_i \in \mathbb{R}^d μ i ∈ R d Σ i ∈ R d × d \mathbf{\Sigma}_i \in \mathbb{R}^{d \times d} Σ i ∈ R d × d
گام امید (چندمتغیره) ¶ مانند حالت تکمتغیره، احتمال پسین خوشه با قضیهٔ بیز حساب میشود:
w i j = P ( C i ∣ x j ) = f i ( x j ) ⋅ P ( C i ) ∑ a = 1 k f a ( x j ) ⋅ P ( C a ) w_{ij} = P(C_i | \mathbf{x}_{j}) = \frac{f_i(\mathbf{x}_{j}) \cdot P(C_{i})}
{\sum_{a=1}^k f_a(\mathbf{x}_{j}) \cdot P(C_{a})} w ij = P ( C i ∣ x j ) = ∑ a = 1 k f a ( x j ) ⋅ P ( C a ) f i ( x j ) ⋅ P ( C i ) گام بیشینهسازی (چندمتغیره) ¶ بهروزرسانی میانگین (میانگین وزنی نقطهها):
μ i = ∑ j = 1 n P ( C i ∣ x j ) ⋅ x j ∑ j = 1 n P ( C i ∣ x j ) \mathbf{\mu}_{i} = \frac{\sum_{j=1}^n P(C_i | \mathbf{x}_j) \cdot \mathbf{x}_{j}}
{\sum_{j=1}^n P(C_i | \mathbf{x}_j)} μ i = ∑ j = 1 n P ( C i ∣ x j ) ∑ j = 1 n P ( C i ∣ x j ) ⋅ x j بهروزرسانی کوواریانس (ماتریس کوواریانس وزنی روی ابعاد):
Σ i = ∑ j = 1 n P ( C i ∣ x j ) ( x j − μ i ) ( x j − μ i ) T ∑ j = 1 n P ( C i ∣ x j ) \mathbf{\Sigma}_{i} =
\frac{\sum_{j=1}^n P(C_i | \mathbf{x}_j) (\mathbf{x}_j - \mathbf{\mu}_i)(\mathbf{x}_j - \mathbf{\mu}_i)^T}
{\sum_{j=1}^n P(C_i | \mathbf{x}_j)} Σ i = ∑ j = 1 n P ( C i ∣ x j ) ∑ j = 1 n P ( C i ∣ x j ) ( x j − μ i ) ( x j − μ i ) T بهروزرسانی احتمال پیشین (کسر سهم کل در خوشه):
P ( C i ) = ∑ j = 1 n P ( C i ∣ x j ) n P(C_{i}) =
\frac{\sum_{j=1}^n P(C_i | \mathbf{x}_j)}{n} P ( C i ) = n ∑ j = 1 n P ( C i ∣ x j ) الگوریتم خوشهبندی با امید-بیشینهسازی ¶ K-Means بهعنوان حالت خاصی از امید-بیشینهسازی (EM) ¶ K-means را میتوان نسخهٔ سادهشدهٔ الگوریتم امید-بیشینهسازی (EM) دانست که در آن تخصیصهای خوشه
قطعیاند نه احتمالاتی. بهویژه در K-means هر نقطهٔ دادهٔ x j \mathbf{x}_{j} x j
P ( x j ∣ C i ) = { 1 if C i = arg min C a { ∥ x j − μ a ∥ 2 } 0 otherwise P(\mathbf{x}_{j} | C_i) =
\begin{cases}
1 & \text{if } C_i = \arg\min_{C_a} \left\{
\|\mathbf{x}_{j} - \mathbf{\mu}_a\|^2\right\}\\
0 & \text{otherwise}
\end{cases} P ( x j ∣ C i ) = { 1 0 if C i = arg min C a { ∥ x j − μ a ∥ 2 } otherwise احتمال پسین تخصیص خوشه با قضیهٔ بیز حساب میشود:
P ( C i ∣ x j ) = P ( x j ∣ C i ) P ( C i ) ∑ a = 1 k P ( x j ∣ C a ) P ( C a ) P(C_i | \mathbf{x}_{j}) = \frac{P(\mathbf{x}_{j} | C_i) P(C_i)}
{\sum_{a=1}^k P(\mathbf{x}_{j} | C_a) P(C_a)} P ( C i ∣ x j ) = ∑ a = 1 k P ( x j ∣ C a ) P ( C a ) P ( x j ∣ C i ) P ( C i ) چون K-means هر نقطه را قطعی به دقیقاً یک خوشه تخصیص میدهد، این به حالتهای زیر ساده میشود:
اگر P ( x j ∣ C i ) = 0 P(\mathbf{x}_{j} | C_i) = 0 P ( x j ∣ C i ) = 0 P ( C i ∣ x j ) = 0 P(C_i | \mathbf{x}_{j}) = 0 P ( C i ∣ x j ) = 0
اگر P ( x j ∣ C i ) = 1 P(\mathbf{x}_{j} | C_i) = 1 P ( x j ∣ C i ) = 1 a ≠ i a \neq i a = i P ( x j ∣ C a ) = 0 P(\mathbf{x}_{j} | C_a) = 0 P ( x j ∣ C a ) = 0
P ( C i ∣ x j ) = 1 ⋅ P ( C i ) 1 ⋅ P ( C i ) = 1. P(C_i | \mathbf{x}_{j}) = \frac{1 \cdot P(C_i)}{1 \cdot P(C_i)} = 1. P ( C i ∣ x j ) = 1 ⋅ P ( C i ) 1 ⋅ P ( C i ) = 1. پس در K-means عضویت خوشه دودویی است:
P ( C i ∣ x j ) = { 1 if x j ∈ C i , i.e., if C i = arg min C a { ∥ x j − μ a ∥ 2 } 0 otherwise P(C_i | \mathbf{x}_{j}) =
\begin{cases}
1 & \text{if } \mathbf{x}_{j} \in C_i, \text{i.e., if }
C_i = \arg\min_{C_a} \left\{ \|\mathbf{x}_{j} - \mathbf{\mu}_a\|^2\right\}\\
0 & \text{otherwise}
\end{cases} P ( C i ∣ x j ) = { 1 0 if x j ∈ C i , i.e., if C i = arg min C a { ∥ x j − μ a ∥ 2 } otherwise برخلاف EM که ماتریسهای کوواریانس را برای مدل کردن توزیع خوشهها به کار میبرد، K-means فقط مرکزهای
خوشه μ i \mathbf{\mu}_i μ i P ( C i ) P(C_i) P ( C i ) .
Zaki, M. J., & Meira, W. (2020). Data Mining and Machine Learning: Fundamental Concepts and Algorithms (2nd ed.). Cambridge University Press. https://www.cambridge.org/9781108497367