تحلیل مؤلفههای اصلی، بخش 1
تا اینجا برآوردگرهای یادگیری با نظارت را عمیق بررسی کردیم: برآوردگرهایی که بر پایهٔ دادهٔ آموزش برچسبدار برچسب پیشبینی میکنند. اینجا با چند برآوردگر بینظارت آشنا میشویم که میتوانند جنبههای جالب داده را بدون ارجاع به هیچ برچسب شناختهشدهای برجسته کنند.
در این فصل یکی از پرکاربردترین الگوریتمهای بینظارت را بررسی میکنیم: تحلیل مؤلفههای اصلی (PCA). PCA بنیاداً الگوریتم کاهش بُعد است، ولی میتواند ابزاری برای تجسم، پالایش نوفه، استخراج و مهندسی ویژگی و بسیار بیشتر باشد. پس از بحث مفهومی کوتاهی دربارهٔ الگوریتم PCA، چند مثال از این کاربردهای بیشتر را میبینیم.
با واردکردنهای استاندارد شروع میکنیم:
%matplotlib inline
import numpy as np
import matplotlib.pyplot as plt
plt.style.use('seaborn-whitegrid')
معرفی تحلیل مؤلفههای اصلی
تحلیل مؤلفههای اصلی روشی بینظارت، سریع و انعطافپذیر برای کاهش بُعد داده است. رفتارش را با نگاه به مجموعهدادهای دوبعدی آسانتر میتوان تجسم کرد. این 200 نقطه را در نظر بگیرید (شکل زیر):
rng = np.random.RandomState(1)
X = np.dot(rng.rand(2, 2), rng.randn(2, 200)).T
plt.scatter(X[:, 0], X[:, 1])
plt.axis('equal');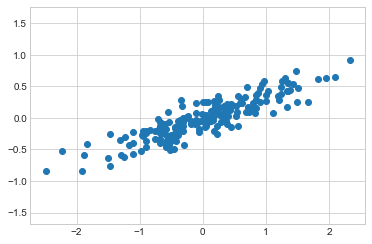
با چشم پیداست که رابطهای تقریباً خطی میان متغیرهای x و y هست. این یادآور دادهٔ رگرسیون خطی است که در صفحهٔ رگرسیون خطی دیدیم، ولی تنظیم مسئله اینجا کمی فرق دارد: بهجای کوشش برای پیشبینی مقدارهای y از مقدارهای x، مسئلهٔ یادگیری بینظارت میکوشد رابطهٔ میان x و y را یاد بگیرد.
در تحلیل مؤلفههای اصلی، این رابطه با یافتن فهرستی از محورهای اصلی در داده و توصیف مجموعهداده با
آن محورها کمّی میشود. با برآوردگر PCA در Scikit-Learn میتوانیم این را چنین حساب کنیم:
from sklearn.decomposition import PCA
pca = PCA(n_components=2)
pca.fit(X)PCA(n_components=2)این برازش چند کمیت از داده را یاد میگیرد، مهمترینشان مؤلفهها و واریانس توضیحدادهشده:
print(pca.components_)[[-0.94446029 -0.32862557]
[-0.32862557 0.94446029]]
print(pca.explained_variance_)[0.7625315 0.0184779]
برای دیدن معنای این عددها، آنها را بهصورت بردارهایی روی دادهٔ ورودی تجسم کنیم: مؤلفهها جهت بردار را و واریانس توضیحدادهشده مربع طول بردار را تعیین میکند (شکل زیر):
def draw_vector(v0, v1, ax=None):
    ax = ax or plt.gca()
    arrowprops=dict(arrowstyle='->', linewidth=2,
                    shrinkA=0, shrinkB=0)
    ax.annotate('', v1, v0, arrowprops=arrowprops)

# plot data
plt.scatter(X[:, 0], X[:, 1], alpha=0.2)
for length, vector in zip(pca.explained_variance_, pca.components_):
    v = vector * 3 * np.sqrt(length)
    draw_vector(pca.mean_, pca.mean_ + v)
plt.axis('equal');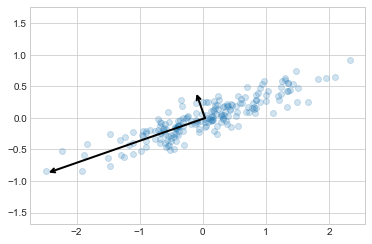
این بردارها محورهای اصلی داده را نشان میدهند و طول هر بردار نشانهٔ «اهمیت» آن محور در توصیف توزیع داده است — دقیقتر، سنجهای از واریانس داده وقتی روی آن محور تصویر شود. تصویر هر نقطهٔ داده روی محورهای اصلی، مؤلفههای اصلی داده است.
Notebook Cell
هرچند این الگوریتم یافتن مؤلفههای اصلی ممکن است کنجکاوی صرفاً ریاضی به نظر برسد، کاربردهای بسیار دوررسی در دنیای یادگیری ماشین و کاوش داده دارد.
PCA بهعنوان کاهش بُعد
استفاده از PCA برای کاهش بُعد یعنی صفر کردن یکی یا چند تا از کوچکترین مؤلفههای اصلی، که به تصویری کمبعد از داده میانجامد و بیشترین واریانس داده را نگه میدارد.
این نمونهای از استفاده از PCA بهعنوان تبدیل کاهش بُعد است:
pca = PCA(n_components=1)
pca.fit(X)
X_pca = pca.transform(X)
print("original shape:   ", X.shape)
print("transformed shape:", X_pca.shape)
original shape: (200, 2)
transformed shape: (200, 1)
دادهٔ تبدیلشده به یک بُعد کاهش یافته است. برای فهم اثر این کاهش بُعد، میتوانیم تبدیل وارون این دادهٔ کاهشیافته را انجام دهیم و آن را همراه با دادهٔ اصلی رسم کنیم (شکل زیر):
X_new = pca.inverse_transform(X_pca)
plt.scatter(X[:, 0], X[:, 1], alpha=0.2)
plt.scatter(X_new[:, 0], X_new[:, 1], alpha=0.8)
plt.axis('equal');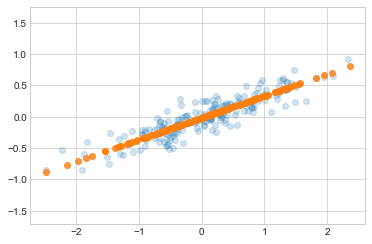
نقطههای روشن دادهٔ اصلی و نقطههای تیره نسخهٔ تصویرشدهاند. این روشن میکند کاهش بُعد با PCA چه معنایی دارد: اطلاعات روی کماهمیتترین محور یا محورهای اصلی حذف میشود و تنها مؤلفه(های) داده با بیشترین واریانس میماند. کسر واریانسی که بریده میشود (متناسب با پراکندگی نقطهها حول خط شکل پیشین) تقریباً سنجهٔ این است که در این کاهش بُعد چه مقدار «اطلاعات» دور ریخته میشود.
این مجموعهدادهٔ کمبعد به یک معنا «بهقدر کافی خوب» است تا مهمترین رابطههای میان نقطهها را رمز کند: با وجود کاهش 50 درصدی تعداد ویژگیهای داده، رابطههای کلی میان نقطههای داده تا حد زیادی حفظ میشوند.
PCA برای تجسم: ارقام دستنویس
سودمندی کاهش بُعد شاید در دو بُعد کاملاً روشن نباشد، ولی با نگاه به دادهٔ با ابعاد بالا آشکار میشود. برای دیدن این، نگاهی سریع به کاربرد PCA روی مجموعهدادهٔ ارقام بیندازیم.
با بارگذاری داده شروع میکنیم:
from sklearn.datasets import load_digits
digits = load_digits()
digits.data.shape
(1797, 64)یادآوری میکنیم مجموعهدادهٔ ارقام از تصویرهای 8×8 پیکسل تشکیل شده، یعنی 64-بعدی است. برای گرفتن شهودی از رابطههای میان این نقطهها، میتوانیم با PCA آنها را به تعداد قابل مدیریتتری بُعد، مثلاً دو، تصویر کنیم:
pca = PCA(2)  # project from 64 to 2 dimensions
projected = pca.fit_transform(digits.data)
print(digits.data.shape)
print(projected.shape)
(1797, 64)
(1797, 2)
اکنون میتوانیم دو مؤلفهٔ اصلی اول هر نقطه را رسم کنیم و دربارهٔ داده بیاموزیم، همانطور که در شکل زیر آمده است:
plt.scatter(projected[:, 0], projected[:, 1],
            c=digits.target, edgecolor='none', alpha=0.5,
            cmap=plt.cm.get_cmap('rainbow', 10))
plt.xlabel('component 1')
plt.ylabel('component 2')
plt.colorbar();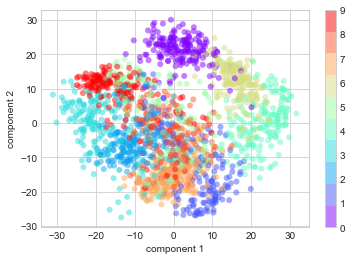
یادآوری کنید این مؤلفهها چه معنایی دارند: دادهٔ کامل ابری از نقطههای 64-بعدی است و این نقطهها تصویر هر نقطهٔ داده در جهتهای با بیشترین واریانساند. اساساً کشش و چرخش بهینه در فضای 64-بعدی را یافتهایم که به ما اجازه میدهد چیدمان داده را در دو بُعد ببینیم، و این کار را بهصورت بینظارت انجام دادهایم — یعنی بدون ارجاع به برچسبها.
مؤلفهها چه معنایی دارند؟
میتوانیم کمی جلوتر برویم و بپرسیم این ابعاد کاهشیافته چه معنایی دارند. این معنا را میتوان برحسب ترکیبهای بردارهای پایه فهمید. مثلاً هر تصویر در مجموعهٔ آموزش با مجموعهای از 64 مقدار پیکسل تعریف میشود که آن را بردار مینامیم:
یک راه فکر کردن به این، برحسب پایهٔ پیکسلی است. یعنی برای ساختن تصویر، هر درایهٔ بردار را در پیکسلی که توصیف میکند ضرب میکنیم و بعد نتیجهها را جمع میزنیم تا تصویر ساخته شود:
یک راه تصور کاهش بُعد این داده این است که همهٔ این بردارهای پایه بهجز چند تا صفر شوند. مثلاً اگر فقط هشت پیکسل اول را به کار ببریم، تصویری هشتبعدی از داده میگیریم (شکل زیر). ولی این تصویر بازتاب خوبی از کل تصویر نیست: تقریباً 90٪ پیکسلها را دور ریختهایم!
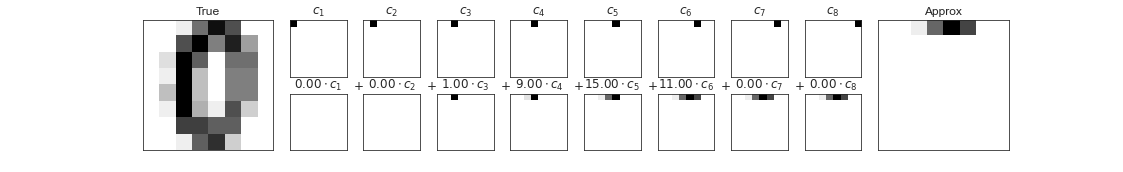
ردیف بالای پنلها پیکسلهای تکتک و ردیف پایین سهم تجمعی این پیکسلها در ساخت تصویر را نشان میدهد. با فقط هشت مؤلفه از پایهٔ پیکسلی، تنها بخش کوچکی از تصویر 64-پیکسلی ساخته میشود. اگر این دنباله را ادامه میدادیم و همهٔ 64 پیکسل را به کار میبردیم، تصویر اصلی را بازیابی میکردیم.
ولی نمایش پیکسلبهپیکسل تنها انتخاب پایه نیست. میتوانیم توابع پایهٔ دیگری هم به کار ببریم که هر کدام سهمی از پیش تعریفشده از هر پیکسل دارد و چیزی چنین بنویسیم:
PCA را میتوان فرایند انتخاب توابع پایهٔ بهینه دانست، چنان که جمع کردن فقط چند تای اولشان برای بازسازی مناسب بخش عمدهٔ عناصر مجموعهداده کافی باشد. مؤلفههای اصلی که نقش نمایش کمبعد داده را بازی میکنند، همان ضریبهایی هستند که هر یک از عناصر این مجموعه را ضرب میکنند. شکل زیر تصویر مشابهی از بازسازی همان رقم با میانگین بهعلاوهٔ هشت تابع پایهٔ اول PCA نشان میدهد.
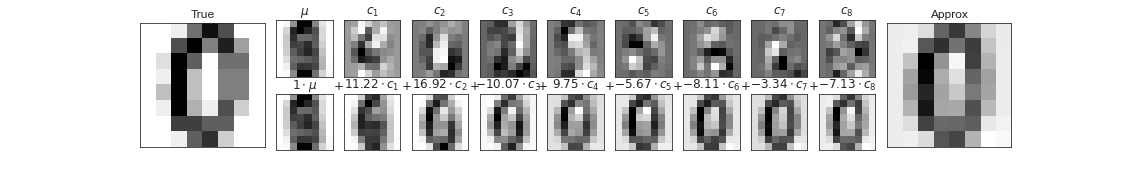
برخلاف پایهٔ پیکسلی، پایهٔ PCA به ما اجازه میدهد ویژگیهای برجستهٔ تصویر ورودی را فقط با یک میانگین بهعلاوهٔ هشت مؤلفه بازیابی کنیم! مقدار هر پیکسل در هر مؤلفه، نتیجهٔ جهت بردار در مثال دوبعدی ما است. PCA به این معنا نمایش کمبعد داده را میدهد: مجموعهای از توابع پایه را مییابد که از پایهٔ پیکسلی بومی دادهٔ ورودی کاراتر است.
انتخاب تعداد مؤلفهها
بخشی حیاتی از استفادهٔ عملی از PCA توانایی برآورد این است که برای توصیف داده چند مؤلفه لازم است. این را میتوان با نگاه به نسبت واریانس توضیحدادهشدهٔ تجمعی بهعنوان تابعی از تعداد مؤلفهها تعیین کرد (شکل زیر):
pca = PCA().fit(digits.data)
plt.plot(np.cumsum(pca.explained_variance_ratio_))
plt.xlabel('number of components')
plt.ylabel('cumulative explained variance');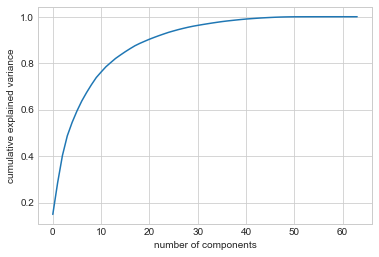
این منحنی کمّی میکند که چه مقدار از واریانس کل 64-بعدی در مؤلفهٔ اول هست. مثلاً میبینیم با دادهٔ ارقام، 10 مؤلفهٔ اول تقریباً 75٪ واریانس را دارند، در حالی که برای توصیف نزدیک به 100٪ واریانس حدود 50 مؤلفه لازم است.
این به ما میگوید تصویر دوبعدی ما اطلاعات زیادی را از دست میدهد (به سنجهٔ واریانس توضیحدادهشده) و برای نگه داشتن 90٪ واریانس حدود 20 مؤلفه لازم است. نگاه به این نمودار برای مجموعهدادهٔ با ابعاد بالا کمک میکند سطح افزونگی موجود در ویژگیهایش را بفهمید.
PCA بهعنوان پالایش نوفه
PCA را میتوان بهعنوان رویکردی برای پالایش دادهٔ نوفهدار هم به کار برد. ایده این است: هر مؤلفهای که واریانسش بسیار بزرگتر از اثر نوفه باشد باید نسبتاً از نوفه دستنخورده بماند. پس اگر داده را فقط با بزرگترین زیرمجموعهٔ مؤلفههای اصلی بازسازی کنید، ترجیحاً سیگنال را نگه میدارید و نوفه را دور میریزید.
ببینیم این با دادهٔ ارقام چه شکلی است. نخست چند نمونهٔ ورودی بینوفه را رسم میکنیم (شکل زیر):
def plot_digits(data):
    fig, axes = plt.subplots(4, 10, figsize=(10, 4),
                             subplot_kw={'xticks':[], 'yticks':[]},
                             gridspec_kw=dict(hspace=0.1, wspace=0.1))
    for i, ax in enumerate(axes.flat):
        ax.imshow(data[i].reshape(8, 8),
                  cmap='binary', interpolation='nearest',
                  clim=(0, 16))
plot_digits(digits.data)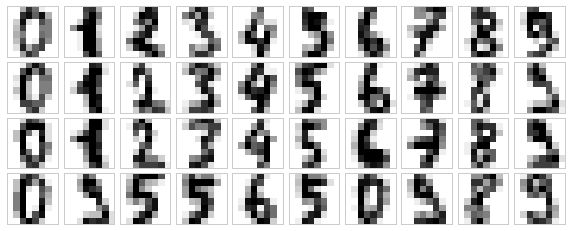
اکنون کمی نوفهٔ تصادفی میافزاییم تا مجموعهدادهٔ نوفهدار بسازیم و دوباره رسم کنیم (شکل زیر):
rng = np.random.default_rng(42)
rng.normal(10, 2)10.609434159508863rng = np.random.default_rng(42)
noisy = rng.normal(digits.data, 4)
plot_digits(noisy)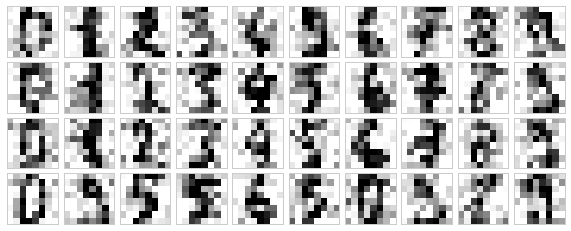
این تجسم حضور نوفهٔ تصادفی را روشن میکند. بیایید مدل PCA را روی دادهٔ نوفهدار آموزش دهیم و بخواهیم تصویر 50٪ واریانس را نگه دارد:
pca = PCA(0.50).fit(noisy)
pca.n_components_12اینجا 50٪ واریانس معادل 12 مؤلفهٔ اصلی از 64 ویژگی اولیه است. اکنون این مؤلفهها را حساب میکنیم و بعد وارون تبدیل را برای بازسازی ارقام پالایششده به کار میبریم؛ شکل زیر نتیجه را نشان میدهد:
components = pca.transform(noisy)
filtered = pca.inverse_transform(components)
plot_digits(filtered)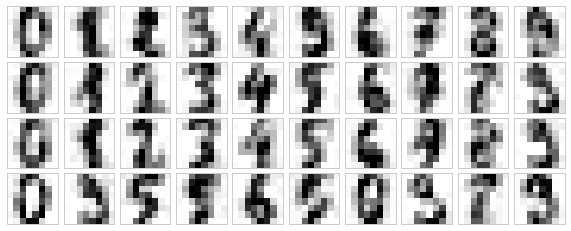
همین ویژگی حفظ سیگنال/پالایش نوفه PCA را به روالی بسیار سودمند برای انتخاب ویژگی تبدیل میکند — مثلاً بهجای آموزش دستهبند روی دادهٔ با ابعاد بسیار بالا، میتوانید دستهبند را روی نمایش کمبعد مؤلفههای اصلی آموزش دهید که بهطور خودکار نوفهٔ تصادفی ورودیها را پالایش میکند.
مثال: چهرههای ویژه
اینجا از تصویر PCA بهعنوان انتخابگر ویژگی برای بازشناسی چهره روی مجموعهدادهٔ «چهرههای برچسبدار در طبیعت» (LFW) استفاده میکنیم که از طریق Scikit-Learn در دسترس است:
from sklearn.datasets import fetch_lfw_people
faces = fetch_lfw_people(min_faces_per_person=60)
print(faces.target_names)
print(faces.images.shape)
['Ariel Sharon' 'Colin Powell' 'Donald Rumsfeld' 'George W Bush'
'Gerhard Schroeder' 'Hugo Chavez' 'Junichiro Koizumi' 'Tony Blair']
(1348, 62, 47)
نگاهی به محورهای اصلی که این مجموعهداده را میپوشانند بیندازیم. چون مجموعهداده بزرگی است، از
حلکنندهٔ ویژهٔ "random" در برآوردگر PCA استفاده میکنیم: روشی تصادفی برای تقریب سریعتر
مؤلفهٔ اصلی اول به قیمت کمی کاهش دقت. این مبادله میتواند برای دادهٔ با ابعاد بالا (اینجا ابعادی
نزدیک 3000) سودمند باشد. 150 مؤلفهٔ اول را میبینیم:
pca = PCA(150, svd_solver='randomized', random_state=42)
pca.fit(faces.data)
PCA(n_components=150, random_state=42, svd_solver='randomized')در این حالت دیدن تصویرهای مربوط به چند مؤلفهٔ اصلی اول میتواند جالب باشد (این مؤلفهها از نظر فنی بردارهای ویژه نامیده میشوند، پس این نوع تصویرها اغلب چهرههای ویژه نام دارند؛ همانطور که در شکل زیر میبینید، به همان ترسناکیِ نامشان هستند):
fig, axes = plt.subplots(3, 8, figsize=(9, 4),
                         subplot_kw={'xticks':[], 'yticks':[]},
                         gridspec_kw=dict(hspace=0.1, wspace=0.1))
for i, ax in enumerate(axes.flat):
    ax.imshow(pca.components_[i].reshape(62, 47), cmap='bone')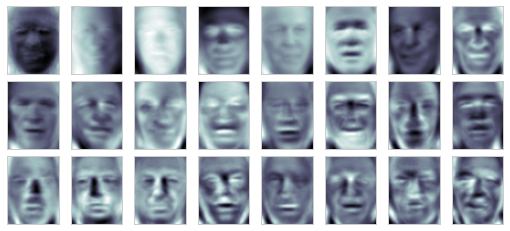
نتیجهها بسیار جالباند و بینشی از نحوهٔ تغییر تصویرها میدهند: مثلاً چند چهرهٔ ویژهٔ اول (از بالا چپ) به نظر با زاویهٔ نور روی چهره مرتبطند و بردارهای اصلی بعدی ویژگیهای مشخصی مثل چشم، بینی و لب را بیرون میکشند.
نگاهی به واریانس تجمعی این مؤلفهها بیندازیم تا ببینیم تصویر چه مقدار از اطلاعات داده را نگه میدارد (شکل زیر):
plt.plot(np.cumsum(pca.explained_variance_ratio_))
plt.xlabel('number of components')
plt.ylabel('cumulative explained variance');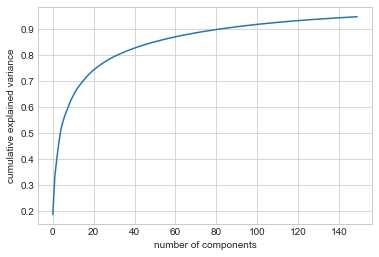
150 مؤلفهای که برگزیدهایم کمی بیش از 90٪ واریانس را توضیح میدهند. این ما را به این باور میرساند که با این 150 مؤلفه بیشتر ویژگیهای اساسی داده را بازیابی میکنیم. برای ملموستر کردن، میتوانیم تصویرهای ورودی را با تصویرهای بازسازیشده از این 150 مؤلفه مقایسه کنیم (شکل زیر):
# Compute the components and projected faces
pca = pca.fit(faces.data)
components = pca.transform(faces.data)
projected = pca.inverse_transform(components)
# Plot the results
fig, ax = plt.subplots(2, 10, figsize=(10, 2.5),
subplot_kw={'xticks':[], 'yticks':[]},
gridspec_kw=dict(hspace=0.1, wspace=0.1))
for i in range(10):
ax[0, i].imshow(faces.data[i].reshape(62, 47), cmap='binary_r')
ax[1, i].imshow(projected[i].reshape(62, 47), cmap='binary_r')
ax[0, 0].set_ylabel('full-dim\ninput')
ax[1, 0].set_ylabel('150-dim\nreconstruction');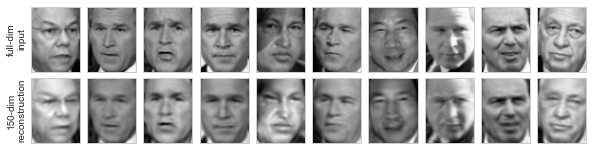
ردیف بالا تصویرهای ورودی و ردیف پایین بازسازی تصویرها از فقط 150 مؤلفه از حدود 3000 ویژگی اولیه را نشان میدهد. این تجسم روشن میکند چرا انتخاب ویژگی با PCA چنان موفق بود: هرچند بُعد داده را تقریباً 20 برابر کم میکند، تصویرهای تصویرشده اطلاعات کافی دارند که با چشم افراد هر تصویر را بازشناسیم. یعنی الگوریتم دستهبندی ما فقط باید روی دادهٔ 150-بعدی آموزش ببیند نه 3000-بعدی، که بسته به الگوریتم انتخابی میتواند به دستهبندی بسیار کاراتری بیانجامد.
جمعبندی
در این فصل کاربرد تحلیل مؤلفههای اصلی را برای کاهش بُعد، تجسم دادهٔ با ابعاد بالا، پالایش نوفه و انتخاب ویژگی در دادهٔ با ابعاد بالا بررسی کردیم. PCA بهدلیل چندکارگی و تفسیرپذیریاش در گسترهٔ وسیعی از زمینهها و رشتهها مؤثر بوده است. با هر مجموعهدادهٔ با ابعاد بالا، گرایش دارم با PCA شروع کنم تا رابطههای میان نقطهها را تجسم کنم (همانطور که با دادهٔ ارقام کردیم)، واریانس اصلی داده را بفهمم (همانطور که با چهرههای ویژه کردیم) و بُعد درونی را درک کنم (با رسم نسبت واریانس توضیحدادهشده). بیشک PCA برای هر مجموعهدادهٔ با ابعاد بالا سودمند نیست، ولی راهی روراست و کارا برای گرفتن بینش از دادهٔ با ابعاد بالا میدهد.
ضعف اصلی PCA این است که گرایش دارد بهشدت از دادههای پرت اثر بپذیرد. به همین دلیل چند نسخهٔ استوار
از PCA ساخته شده که بسیاریشان نقطههای دادهای را که با مؤلفههای اولیه بد توصیف میشوند بهطور
تکراری کنار میگذارند. Scikit-Learn چند نسخهٔ جالب از PCA را در زیرماژول sklearn.decomposition
دارد؛ یک نمونه SparsePCA است که یک جملهٔ تنظیمکننده وارد میکند (صفحهٔ رگرسیون خطی را ببینید) و
تُنُکی مؤلفهها را تحمیل میکند.
در فصلهای بعدی روشهای بینظارت دیگری را میبینیم که بر برخی ایدههای PCA بنا شدهاند.
تمرینها
ارقام را روی دو مؤلفهٔ اصلی اول تصویر کنید و نقطهها را بر پایهٔ برچسب رنگ کنید. توضیح دهید چرا دو رقم روی هم میافتند و کدام مؤلفهها آنها را جدا میکنند.
تعدادی مؤلفه را که 90٪ واریانس را نگه میدارد برگزینید و همان تعداد را با خطای بازسازی بسنجید. آیا این دو معیار توافق دارند؟
نشان دهید PCA نسبت به تغییر مقیاس ناوردا نیست: ویژگیها را استاندارد کنید، تحلیل را تکرار کنید و بگویید کدام مؤلفهها بیشتر تغییر میکنند.
جمعبندی
در این فصل کاربرد تحلیل مؤلفههای اصلی را برای کاهش بُعد، تجسم دادهٔ با ابعاد بالا، پالایش نوفه و انتخاب ویژگی در دادهٔ با ابعاد بالا بررسی کردیم. PCA بهدلیل چندکارگی و تفسیرپذیریاش در گسترهٔ وسیعی از زمینهها و رشتهها مؤثر بوده است. با هر مجموعهدادهٔ با ابعاد بالا، گرایش دارم با PCA شروع کنم تا رابطههای میان نقطهها را تجسم کنم (همانطور که با دادهٔ ارقام کردیم)، واریانس اصلی داده را بفهمم (همانطور که با چهرههای ویژه کردیم) و بُعد درونی را درک کنم (با رسم نسبت واریانس توضیحدادهشده). بیشک PCA برای هر مجموعهدادهٔ با ابعاد بالا سودمند نیست، ولی راهی روراست و کارا برای گرفتن بینش از دادهٔ با ابعاد بالا میدهد.
ضعف اصلی PCA این است که گرایش دارد بهشدت از دادههای پرت اثر بپذیرد. به همین دلیل چند نسخهٔ استوار
از PCA ساخته شده که بسیاریشان نقطههای دادهای را که با مؤلفههای اولیه بد توصیف میشوند بهطور
تکراری کنار میگذارند. Scikit-Learn چند نسخهٔ جالب از PCA را در زیرماژول sklearn.decomposition
دارد؛ یک نمونه SparsePCA است که یک جملهٔ تنظیمکننده وارد میکند (صفحهٔ رگرسیون خطی را ببینید) و
تُنُکی مؤلفهها را تحمیل میکند.
در فصلهای بعدی روشهای بینظارت دیگری را میبینیم که بر برخی ایدههای PCA بنا شدهاند.