مقایسهٔ LDA و PCA
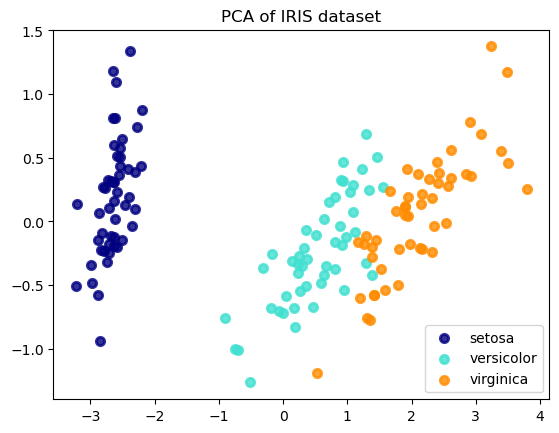
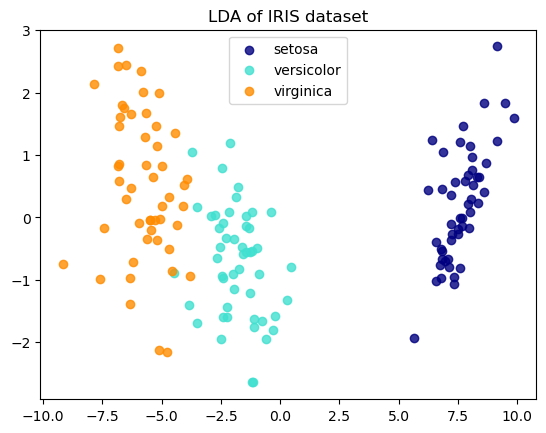
تصویر دوبعدی مجموعهدادهٔ Iris
%matplotlib inlineمجموعهدادهٔ Iris سه نوع گل زنبق (Setosa، Versicolour و Virginica) با 4 ویژگی نشان میدهد: طول کاسبرگ، عرض کاسبرگ، طول گلبرگ و عرض گلبرگ.
تحلیل مؤلفههای اصلی (PCA) روی این داده ترکیب ویژگیها (مؤلفههای اصلی، یا جهتهایی در فضای ویژگی) را مییابد که بیشترین واریانس داده را توضیح میدهند. اینجا نمونههای مختلف را روی دو مؤلفهٔ اصلی اول رسم میکنیم.
تحلیل تفکیکگر خطی (LDA) میکوشد ویژگیهایی را بیابد که بیشترین واریانس میان دستهها را توضیح میدهند. بهویژه، LDA برخلاف PCA روشی با نظارت است و از برچسبهای شناختهشدهٔ دسته استفاده میکند.
import matplotlib.pyplot as plt

from sklearn import datasets
from sklearn.decomposition import PCA
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis

iris = datasets.load_iris()

X = iris.data
y = iris.target
target_names = iris.target_names

pca = PCA(n_components=2)
X_r = pca.fit(X).transform(X)

lda = LinearDiscriminantAnalysis(n_components=2)
X_r2 = lda.fit(X, y).transform(X)

# Percentage of variance explained for each components
print('explained variance ratio (first two components): %s'
      % str(pca.explained_variance_ratio_))

plt.figure()
colors = ['navy', 'turquoise', 'darkorange']
lw = 2

for color, i, target_name in zip(colors, [0, 1, 2], target_names):
    plt.scatter(X_r[y == i, 0], X_r[y == i, 1], color=color, alpha=.8, lw=lw,
                label=target_name)
plt.legend(loc='best', shadow=False, scatterpoints=1)
plt.title('PCA of IRIS dataset')

plt.figure()
for color, i, target_name in zip(colors, [0, 1, 2], target_names):
    plt.scatter(X_r2[y == i, 0], X_r2[y == i, 1], alpha=.8, color=color,
                label=target_name)
plt.legend(loc='best', shadow=False, scatterpoints=1)
plt.title('LDA of IRIS dataset')

plt.show()
explained variance ratio (first two components): [0.92461872 0.05306648]
از تصویر به عدد
این دو نمودار پراکندگی قانعکننده به نظر میرسند، ولی «دستهها جدا به نظر میرسند» یک اندازهگیری نیست. اینجا سه دستهبند را روی همان دادهٔ Iris و همان تقسیمها مقایسه میکنیم:
رگرسیون لجستیک روی چهار ویژگی خام؛
PCA به دو مؤلفه و بعد رگرسیون لجستیک؛
LDA بهعنوان دستهبند — همزمان بُعد را کم و دستهبندی میکند.
دو عادت این مقایسه را صادق میکند:
پیش از تصویر کردن، استاندارد کن. PCA با واریانس رانده میشود، پس ویژگیای که پراکندگی عددی بزرگتری دارد بر مؤلفهها غلبه میکند. LDA هم مقیاسهای قابل مقایسه فرض میکند.
تصویر را درون حلقهٔ اعتبارسنجی متقاطع برازش کن. تصویر کردن کل مجموعهداده یک بار و بعد اعتبارسنجی متقاطع دستهبند، ساختار واریانس تای آزمون را به آموزش نشت میدهد.
Pipelineمقیاسکننده و تصویر را در هر تای دوباره برازش میدهد.
import numpy as np

from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_val_score, cross_val_predict
from sklearn.metrics import confusion_matrix

cv = StratifiedKFold(n_splits=10, shuffle=True, random_state=0)

models = {
    "logistic regression, 4 raw features":
        make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)),
    "standardize + PCA(2) + logistic":
        make_pipeline(StandardScaler(), PCA(n_components=2), LogisticRegression(max_iter=1000)),
    "standardize + LDA":
        make_pipeline(StandardScaler(), LinearDiscriminantAnalysis()),
}

for name, model in models.items():
    scores = cross_val_score(model, X, y, cv=cv, scoring="accuracy")
    print(f"{name:42s} accuracy = {scores.mean():.3f} +/- {scores.std():.3f}")
logistic regression, 4 raw features        accuracy = 0.953 +/- 0.043
standardize + PCA(2) + logistic            accuracy = 0.913 +/- 0.060
standardize + LDA                          accuracy = 0.980 +/- 0.031
اینجا LDA برنده است و دلیلش ساختاری است نه تصادفی: LDA برچسبها را میداند و جهتی را برمیگزیند که پراکندگی میاندستهای را نسبت به پراکندگی دروندستهای بیشینه میکند. PCA هیچ چیزی از دستهها نمیداند؛ جهتهای بزرگترین واریانس کل را نگه میدارد و بخشی از آن واریانس، پراکندگی درون هر دسته است.
این PCA را بدتر نمیکند — بینظارت بودنش را نشان میدهد. وقتی برچسبها نیستند، یا هدف فشردهسازی است نه جداسازی، PCA ابزار کار است.
Xs = StandardScaler().fit_transform(X)
pca_s = PCA(n_components=2).fit(Xs)

print("PCA on standardized features, cumulative explained variance:",
      pca_s.explained_variance_ratio_.cumsum()[-1].round(4))
print("PCA on raw features (the first figure above):               ",
      pca.explained_variance_ratio_.cumsum()[-1].round(4))

# LDA cannot exceed C-1 components: with 3 classes there are only 2 independent
# between-class directions, and both of them are used here.
lda_s = LinearDiscriminantAnalysis(n_components=2).fit(Xs, y)
print("LDA, cumulative explained variance (2 components):          ",
      lda_s.explained_variance_ratio_.cumsum()[-1].round(4))

try:
    LinearDiscriminantAnalysis(n_components=3).fit(Xs, y)
    print("3 LDA components accepted (sklearn would truncate)")
except ValueError as err:
    print("asking for 3 LDA components fails as expected:", str(err)[:110])
PCA on standardized features, cumulative explained variance: 0.9581
PCA on raw features (the first figure above):                0.9777
LDA, cumulative explained variance (2 components):           1.0
asking for 3 LDA components fails as expected: n_components cannot be larger than min(n_features, n_classes - 1).
یک جهت، دو معیار
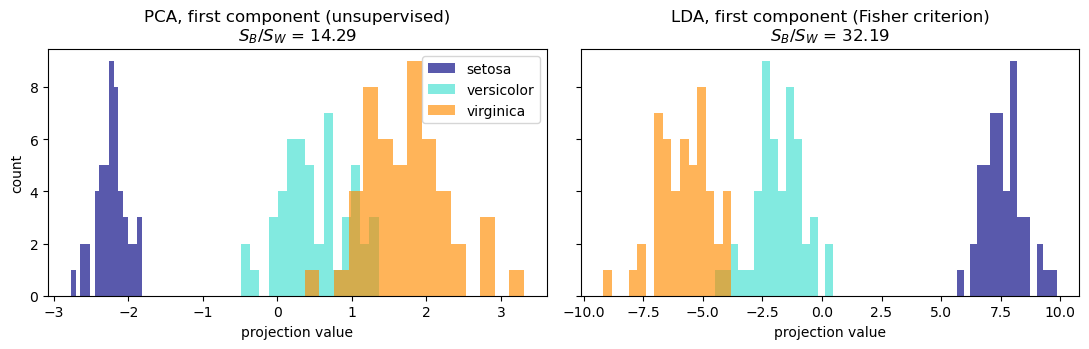
کاهش به یک بُعد تفاوت این دو معیار را روشنترین شکل نشان میدهد.
PCA جهت بیشینهٔ واریانس را میگیرد، که پراکندگی کل است. هیچ چیزی در این تابع هدف به دستهها اشاره نمیکند.
LDA جهتی را میگیرد که نسبت پراکندگی میاندستهای به دروندستهای را بیشینه میکند،
که همان معیار فیشر است. یک جهت میتواند واریانس کل زیادی داشته باشد و با این حال برای دستهبندی بیفایده باشد، اگر آن واریانس پراکندگی درون هر دسته باشد.
دو پنل زیر همان دادهٔ استانداردشده را به یک بُعد تصویر میکنند و را گزارش میکنند — بزرگتر یعنی بهتر جدا شده. بافتنگارهای همپوشان یعنی ابهام، هرچه دقت دستهبند حاصل باشد.
pca1 = PCA(n_components=1).fit_transform(Xs)
lda1 = LinearDiscriminantAnalysis(n_components=1).fit(Xs, y).transform(Xs)

def fisher_ratio(z):
    # between-class scatter over within-class scatter of a 1D projection
    z = z.ravel()
    overall = z.mean()
    sb = sum((z[y == k].mean() - overall) ** 2 * (y == k).sum() for k in np.unique(y))
    sw = sum(((z[y == k] - z[y == k].mean()) ** 2).sum() for k in np.unique(y))
    return sb / sw

fig, axes = plt.subplots(1, 2, figsize=(11, 3.6), sharey=True)
panels = [(axes[0], pca1, "PCA, first component (unsupervised)"),
          (axes[1], lda1, "LDA, first component (Fisher criterion)")]

for ax, z, title in panels:
    for color, k, name in zip(colors, range(3), target_names):
        ax.hist(z[y == k, 0], bins=15, alpha=.65, color=color, label=name)
    ax.set_title(f"{title}\n$S_B/S_W$ = {fisher_ratio(z):.2f}")
    ax.set_xlabel("projection value")

axes[0].set_ylabel("count")
axes[0].legend()
plt.tight_layout()
plt.show()
# Where does the remaining error go? Cross-validated LDA predictions.
y_pred = cross_val_predict(
    make_pipeline(StandardScaler(), LinearDiscriminantAnalysis()), X, y, cv=cv)

cm = confusion_matrix(y, y_pred)
print("rows = true, columns = predicted, order:", list(target_names))
print(cm)
for k, name in enumerate(target_names):
    print(f"recall({name:12s}) = {cm[k, k] / cm[k].sum():.3f}")
rows = true, columns = predicted, order: ['setosa', 'versicolor', 'virginica']
[[50  0  0]
 [ 0 48  2]
 [ 0  1 49]]
recall(setosa      ) = 1.000
recall(versicolor  ) = 0.960
recall(virginica   ) = 0.980
PCA یا LDA؟
| PCA | LDA | |
|---|---|---|
| به برچسب نیاز دارد | نه | بله |
| معیار | بیشینه کردن واریانس کل | بیشینه کردن |
| بیشترین تعداد مؤلفه | ||
| میتواند داده را بازسازی کند | بله | نه |
| کاربرد معمول | فشردهسازی، تجسم، نوفهزدایی | کاهش بُعد با نظارت، تجسم، دستهبند ارزان |
| حساس به مقیاس ویژگی | بله | بله |
LDA خطای بازسازیای برای کمینه کردن ندارد: جهتهایش برای جداسازی انتخاب میشوند، نه برای نمایندگی داده، پس نمیتوانید از LDA برای فشردهسازی یا نوفهزدایی استفاده کنید. برعکس، PCA بهآسانی میتواند جهتی را نگه دارد که دستهها را در هم میآمیزد؛ همین دلیل است که پنل PCA دو مؤلفه لازم داشت تا قانعکننده به نظر برسد، در حالی که LDA در یک بُعد هم خوب جدا میکرد.
سه نکته از این نوتبوک
با نظارت بودن یا نبودن خط جداکننده است: PCA واریانس را بیشینه میکند، LDA جداسازی را.
LDA حداکثر مؤلفه دارد. با سه دسته، ممیز سومی وجود ندارد.
استاندارد کن و درون حلقهٔ CV برازش بده. تصویر بخشی از مدل است، نه بخشی از داده. در پروژه، همین اشتباه — حساب کردن یک تصویر (یا یک آمارهٔ پنجرهای) روی همهٔ داده پیش از تقسیم — رایجترین راه رسیدن به امتیازی زیبا و بیمعنا است.