مدلهای مخلوط گاوسی، بخش 1
مدل خوشهبندی k-means که در فصل پیش دیدیم ساده و نسبتاً آسانفهم است، ولی همین سادگی در کاربرد چالشهای عملی میسازد. بهویژه، نااحتمالاتی بودن k-means و استفادهاش از فاصلهٔ ساده از مرکز خوشه برای تخصیص عضویت خوشه، در بسیاری از وضعیتهای واقعی به کارایی ضعیف میانجامد. در این فصل مدلهای مخلوط گاوسی را میبینیم که میتوان آنها را گسترش ایدههای پشت k-means دانست، ولی میتوانند ابزاری توانمند برای برآورد فراتر از خوشهبندی ساده هم باشند.
با واردکردنهای استاندارد شروع میکنیم:
%matplotlib inline
import matplotlib.pyplot as plt
plt.style.use('seaborn-whitegrid')
import numpy as np
انگیزهٔ مخلوطهای گاوسی: ضعفهای k-means
بیایید چند ضعف k-means را ببینیم و فکر کنیم مدل خوشه را چگونه میتوان بهتر کرد. همانطور که در فصل پیش دیدیم، با دادهٔ ساده و بهخوبی جدا، k-means نتایج خوشهبندی مناسبی مییابد.
مثلاً اگر خوشههای سادهای از داده داشته باشیم، الگوریتم k-means میتواند سریع آن خوشهها را برچسب بزند بهشکلی که با آنچه با چشم میکردیم نزدیک است (شکل زیر):
# Generate some data
from sklearn.datasets import make_blobs
X, y_true = make_blobs(n_samples=400, centers=4,
                       cluster_std=0.60, random_state=0)
X = X[:, ::-1] # flip axes for better plotting
# Plot the data with k-means labels
from sklearn.cluster import KMeans
kmeans = KMeans(4, random_state=0)
labels = kmeans.fit(X).predict(X)
plt.scatter(X[:, 0], X[:, 1], c=labels, s=40, cmap='viridis');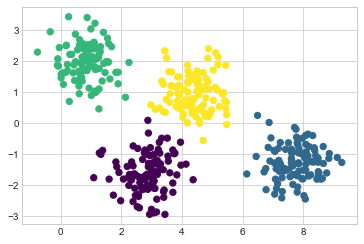
از نگاه شهودی، انتظار داریم تخصیص خوشهٔ بعضی نقطهها مطمئنتر از بقیه باشد: مثلاً بهنظر میرسد همپوشانی بسیار کمی میان دو خوشهٔ میانی هست، طوری که در تخصیص خوشهٔ نقطههای میانشان کاملاً مطمئن نباشیم. متأسفانه مدل k-means هیچ سنجهٔ درونیای برای احتمال یا عدمقطعیت تخصیص خوشه ندارد (هرچند ممکن است بتوان با رویکرد bootstrap این عدمقطعیت را برآورد کرد). برای این کار باید به تعمیم مدل بیندیشیم.
یک راه فکر کردن به مدل k-means این است که دایرهای (یا در ابعاد بالاتر، ابرکرهای) در مرکز هر خوشه میگذارد که شعاعش با دورترین نقطهٔ خوشه تعیین میشود. این شعاع برشی سخت برای تخصیص خوشه در مجموعهٔ آموزش است: هر نقطهٔ بیرون این دایره عضو خوشه شمرده نمیشود. میتوانیم این مدل خوشه را با تابع زیر تجسم کنیم (شکل زیر):
from sklearn.cluster import KMeans
from scipy.spatial.distance import cdist

def plot_kmeans(kmeans, X, n_clusters=4, rseed=0, ax=None):
    labels = kmeans.fit_predict(X)

    # plot the input data
    ax = ax or plt.gca()
    ax.axis('equal')
    ax.scatter(X[:, 0], X[:, 1], c=labels, s=40, cmap='viridis', zorder=2)

    # plot the representation of the KMeans model
    centers = kmeans.cluster_centers_
    radii = [cdist(X[labels == i], [center]).max()
             for i, center in enumerate(centers)]
    for c, r in zip(centers, radii):
        ax.add_patch(plt.Circle(c, r, ec='black', fc='lightgray',
                                lw=3, alpha=0.5, zorder=1))
kmeans = KMeans(n_clusters=4, random_state=0)
plot_kmeans(kmeans, X)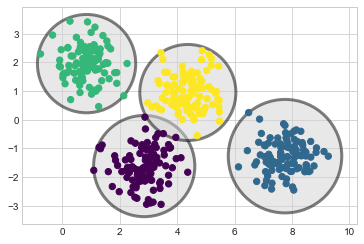
مشاهدهٔ مهم دربارهٔ k-means این است که این مدلهای خوشه باید دایرهای باشند: k-means هیچ راه درونساختی برای در نظر گرفتن خوشههای کشیده یا بیضیگون ندارد. مثلاً اگر همان داده را بگیریم و تبدیلش کنیم، تخصیصهای خوشه درهم میشود، همانطور که در شکل زیر میبینید:
rng = np.random.RandomState(13)
X_stretched = np.dot(X, rng.randn(2, 2))

kmeans = KMeans(n_clusters=4, random_state=0)
plot_kmeans(kmeans, X_stretched)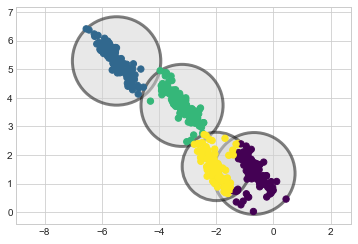
با چشم میفهمیم این خوشههای تبدیلشده دایرهای نیستند و پس خوشههای دایرهای برازش ضعیفی میدهند. با این حال k-means بهقدر کافی انعطاف ندارد که این را در نظر بگیرد و میکوشد داده را بهزور در چهار خوشهٔ دایرهای جا کند. نتیجه آمیختن تخصیصها است جایی که دایرههای حاصل همپوشانی دارند: بهویژه پایینراست این نمودار را ببینید. میتوان تصور کرد این وضعیت با پیشپردازش داده با PCA حل شود (صفحهٔ تحلیل مؤلفههای اصلی)، ولی در عمل تضمینی نیست که چنین عملیات کلی گروههای تکتک را دایرهای کند.
این دو اشکال k-means — نداشتن انعطاف در شکل خوشه و نداشتن تخصیص احتمالاتی — یعنی برای بسیاری از مجموعهدادهها (بهویژه مجموعهدادههای کمبعد) ممکن است آنقدر که امید دارید خوب عمل نکند.
میتوانید تصور کنید این ضعفها با تعمیم مدل k-means رفع شوند: مثلاً عدمقطعیت تخصیص خوشه را با مقایسهٔ فاصلهٔ هر نقطه تا همهٔ مرکزهای خوشه بسنجید، نه فقط نزدیکترین. همچنین میتوانید مرزهای خوشه را بیضی بهجای دایره بگیرید تا خوشههای غیردایرهای در نظر گرفته شوند. معلوم میشود اینها همان دو مؤلفهٔ اساسی نوع دیگری از مدل خوشهبندیاند: مدلهای مخلوط گاوسی.
تعمیم E–M: مدلهای مخلوط گاوسی
مدل مخلوط گاوسی (GMM) میکوشد مخلوطی از توزیعهای احتمال گاوسی چندبعدی بیابد که هر مجموعهدادهٔ ورودی را بهترین شکل مدل کند. در سادهترین حالت، GMM را میتوان مثل k-means برای یافتن خوشه به کار برد (شکل زیر):
from sklearn.mixture import GaussianMixture
gmm = GaussianMixture(n_components=4).fit(X)
labels = gmm.predict(X)
plt.scatter(X[:, 0], X[:, 1], c=labels, s=40, cmap='viridis');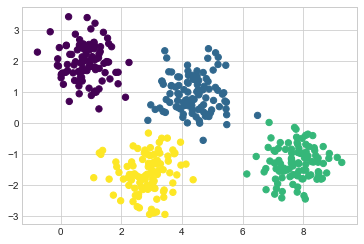
ولی چون GMM زیر پوستش مدلی احتمالاتی دارد، یافتن تخصیصهای احتمالاتی خوشه هم ممکن است — در Scikit-Learn
این کار با متد predict_proba انجام میشود. ماتریسی با اندازهٔ [n_samples, n_clusters] برمیگرداند
که احتمال تعلق هر نقطه به خوشهٔ دادهشده را میسنجد:
probs = gmm.predict_proba(X)
print(probs[:5].round(3))
[[0. 0.531 0.469 0. ]
[0. 0. 0. 1. ]
[0. 0. 0. 1. ]
[0. 1. 0. 0. ]
[0. 0. 0. 1. ]]
میتوانیم این عدمقطعیت را تجسم کنیم؛ مثلاً اندازهٔ هر نقطه را متناسب با قطعیت پیشبینیاش بگیریم. با نگاه به شکل زیر میبینیم دقیقاً نقطههای روی مرز میان خوشهها هستند که این عدمقطعیت تخصیص خوشه را نشان میدهند:
size = 50 * probs.max(1) ** 2  # square emphasizes differences
plt.scatter(X[:, 0], X[:, 1], c=labels, cmap='viridis', s=size);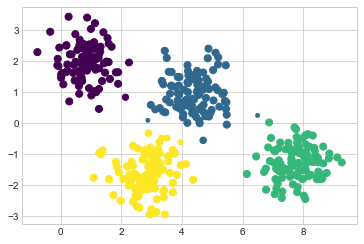
زیر پوست، مدل مخلوط گاوسی بسیار شبیه k-means است: از رویکرد امید-بیشینهسازی استفاده میکند که کیفی چنین کاری میکند:
حدسهای آغازین برای مکان و شکل برگزینید.
تا همگرایی تکرار کنید:
گام E: برای هر نقطه، وزنهایی بیابید که احتمال عضویت در هر خوشه را رمز کنند.
گام M: برای هر خوشه، مکان، نرمالسازی و شکلش را بر پایهٔ همهٔ نقطههای داده و با استفاده از وزنها بهروز کنید.
نتیجه این است که هر خوشه نه با کرهای سختلبه، بلکه با مدلی گاوسی و هموار همراه میشود. همانند رویکرد امید-بیشینهسازی k-means، این الگوریتم گاهی میتواند جواب بهینهٔ کلی را از دست بدهد و از اینرو در عمل چند مقداردهی اولیهٔ تصادفی به کار میرود.
تابعی بسازیم که به تجسم مکانها و شکلهای خوشههای GMM کمک کند، با رسم بیضی بر پایهٔ خروجی GMM:
from matplotlib.patches import Ellipse

def draw_ellipse(position, covariance, ax=None, **kwargs):
    """Draw an ellipse with a given position and covariance"""
    ax = ax or plt.gca()

    # Convert covariance to principal axes
    if covariance.shape == (2, 2):
        U, s, Vt = np.linalg.svd(covariance)
        angle = np.degrees(np.arctan2(U[1, 0], U[0, 0]))
        width, height = 2 * np.sqrt(s)
    else:
        angle = 0
        width, height = 2 * np.sqrt(covariance)

    # Draw the ellipse
    for nsig in range(1, 4):
        ax.add_patch(Ellipse(position, nsig * width, nsig * height,
                             angle, **kwargs))

def plot_gmm(gmm, X, label=True, ax=None):
    ax = ax or plt.gca()
    labels = gmm.fit(X).predict(X)
    if label:
        ax.scatter(X[:, 0], X[:, 1], c=labels, s=40, cmap='viridis', zorder=2)
    else:
        ax.scatter(X[:, 0], X[:, 1], s=40, zorder=2)
    ax.axis('equal')

    w_factor = 0.2 / gmm.weights_.max()
    for pos, covar, w in zip(gmm.means_, gmm.covariances_, gmm.weights_):
        draw_ellipse(pos, covar, alpha=w * w_factor)
با این آماده بودن، میتوانیم ببینیم GMM چهارمؤلفهای برای دادهٔ اولیهٔ ما چه میدهد (شکل زیر):
gmm = GaussianMixture(n_components=4, random_state=42)
plot_gmm(gmm, X)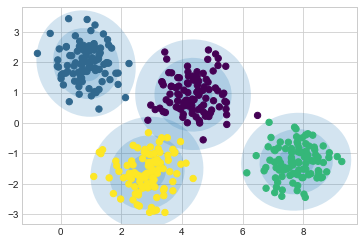
بههمینترتیب میتوانیم با رویکرد GMM مجموعهدادهٔ کشیدهٔ خود را برازش دهیم؛ با اجازه دادن به کوواریانس کامل، مدل حتی خوشههای بسیار کشیده و دراز را برازش میکند، همانطور که در شکل زیر میبینیم:
gmm = GaussianMixture(n_components=4, covariance_type='full', random_state=42)
plot_gmm(gmm, X_stretched)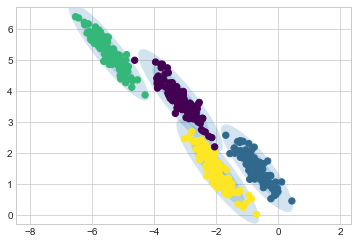
این روشن میکند GMM همان دو مسئلهٔ عملی اصلی k-means را که دیدیم حل میکند.
انتخاب نوع کوواریانس
اگر جزئیات برازشهای پیشین را ببینید، میبینید گزینهٔ covariance_type در هر کدام متفاوت تنظیم شده بود.
این ابرپارامتر درجهٔ آزادی شکل هر خوشه را کنترل میکند و برای هر مسئلهٔ دادهشده تنظیم دقیقش ضروری است.
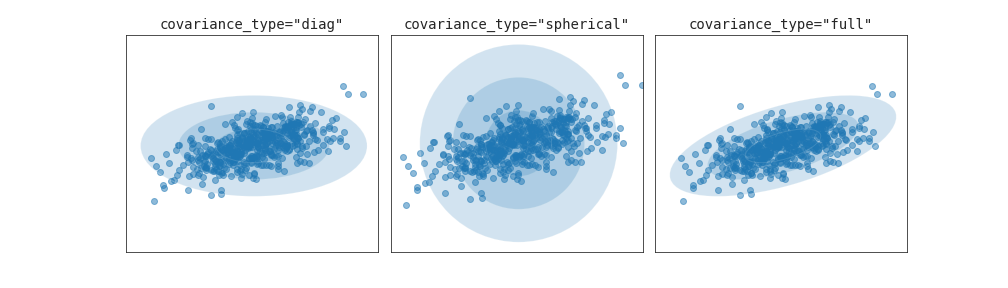
پیشفرض covariance_type="diag" است، یعنی اندازهٔ خوشه در هر بُعد مستقل تنظیم میشود و بیضی حاصل ناچار
با محورها همراستا میماند. مدل کمی سادهتر و سریعتر covariance_type="spherical" است که شکل خوشه را
چنان مقید میکند که همهٔ ابعاد برابر باشند. خوشهبندی حاصل ویژگیهایی شبیه k-means خواهد داشت، هرچند
کاملاً همارز نیست. مدل پیچیدهتر و از نظر محاسباتی گرانتر (بهویژه با رشد تعداد ابعاد)
covariance_type="full" است که به هر خوشه اجازه میدهد بیضیای با جهتگیری دلخواه باشد.
نمایش دیداری این سه انتخاب برای یک خوشهٔ تنها را در شکل زیر میبینیم:
مدلهای مخلوط گاوسی بهعنوان برآورد چگالی
هرچند GMM را اغلب الگوریتم خوشهبندی میدستهبندی میکنند، بنیاداً الگوریتمی برای برآورد چگالی است. یعنی نتیجهٔ برازش GMM به داده، از نظر فنی مدل خوشهبندی نیست، بلکه مدلی مولد و احتمالاتی است که توزیع داده را توصیف میکند.
مثلاً دادهای را در نظر بگیرید که با تابع make_moons در Scikit-Learn تولید شده (شکل زیر):
from sklearn.datasets import make_moons
Xmoon, ymoon = make_moons(200, noise=.05, random_state=0)
plt.scatter(Xmoon[:, 0], Xmoon[:, 1]);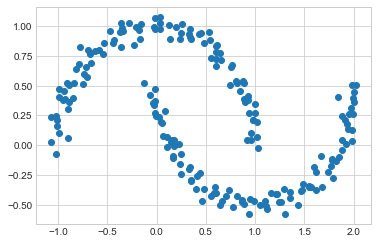
اگر این را با GMM دومؤلفهای بهعنوان مدل خوشهبندی برازش دهیم، نتایج چندان سودمند نیست (شکل زیر):
gmm2 = GaussianMixture(n_components=2, covariance_type='full', random_state=0)
plot_gmm(gmm2, Xmoon)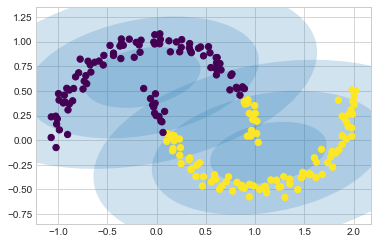
ولی اگر بهجای آن بسیار مؤلفههای بیشتری به کار ببریم و برچسبهای خوشه را نادیده بگیریم، برازشی مییابیم که به دادهٔ ورودی بسیار نزدیکتر است (شکل زیر):
gmm16 = GaussianMixture(n_components=16, covariance_type='full', random_state=0)
plot_gmm(gmm16, Xmoon, label=False)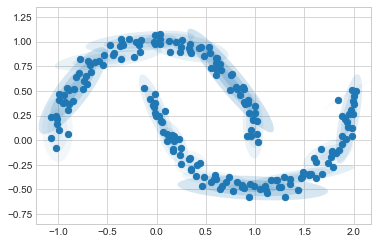
اینجا مخلوط 16 مؤلفهٔ گاوسی برای یافتن خوشههای جدای داده نیست، بلکه برای مدل کردن توزیع کلی دادهٔ ورودی است. این مدلی مولد برای توزیع است، یعنی GMM دستور ساخت دادهٔ تصادفی تازهٔ همتوزیع با ورودی را به ما میدهد. مثلاً اینجا 400 نقطهٔ تازه از این GMM 16-مؤلفهای برازششده به دادهٔ اصلی ما آمده است (شکل زیر):
Xnew, ynew = gmm16.sample(400)
plt.scatter(Xnew[:, 0], Xnew[:, 1]);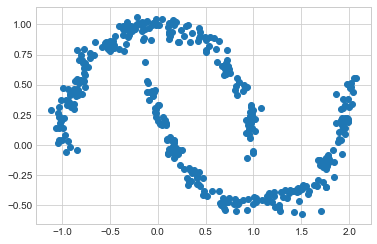
GMM ابزاری راحت برای مدل کردن توزیع چندبعدی دلخواه داده است.
چند مؤلفه؟
اینکه GMM مدلی مولد است راه طبیعی تعیین تعداد بهینهٔ مؤلفهها برای یک مجموعهداده را میدهد. مدل مولد
بنیاداً توزیع احتمالاتی مجموعهداده است، پس میتوانیم بهسادگی درستنمایی داده را زیر مدل ارزیابی کنیم
و از اعتبارسنجی متقاطع برای پرهیز از بیشبرازش بهره ببریم. راه دیگر جبران بیشبرازش تنظیم درستنماییهای
مدل با معیاری تحلیلی مثل معیار اطلاعات آکایکه (AIC)
یا معیار اطلاعات بیزی (BIC) است.
برآوردگر GaussianMixture در Scikit-Learn متدهای درونساختی برای محاسبهٔ هر دو دارد، پس کار با این
رویکرد بسیار آسان است.
بیایید AIC و BIC را در برابر تعداد مؤلفههای GMM برای مجموعهدادهٔ moons ببینیم (شکل زیر):
n_components = np.arange(1, 21)
models = [GaussianMixture(n, covariance_type='full', random_state=0).fit(Xmoon)
          for n in n_components]

plt.plot(n_components, [m.bic(Xmoon) for m in models], label='BIC')
plt.plot(n_components, [m.aic(Xmoon) for m in models], label='AIC')
plt.legend(loc='best')
plt.xlabel('n_components');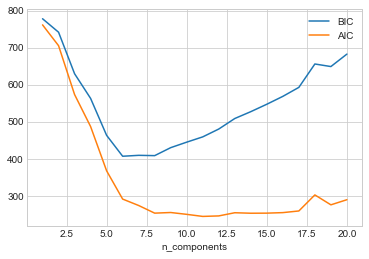
تعداد بهینهٔ خوشهها مقداری است که AIC یا BIC را کمینه میکند، بسته به اینکه کدام تقریب را بخواهیم. AIC میگوید انتخاب 16 مؤلفهای پیشین احتمالاً زیادی بوده: حدود 8 تا 12 مؤلفه انتخاب بهتری بود. همانند معمول این نوع مسئله، BIC مدل سادهتری را پیشنهاد میکند.
به نکتهٔ مهم توجه کنید: این انتخاب تعداد مؤلفهها میسنجد GMM بهعنوان برآوردگر چگالی چقدر خوب کار میکند، نه بهعنوان الگوریتم خوشهبندی. تشویق میکنم GMM را اول از همه برآوردگر چگالی بدانید و فقط وقتی مجموعهدادهٔ ساده توجیه میکند از آن برای خوشهبندی استفاده کنید.
مثال: GMM برای تولید دادهٔ تازه
همین حالا مثال سادهای از استفاده از GMM بهعنوان مدلی مولد دیدیم تا نمونههای تازه از توزیع تعریفشده با دادهٔ ورودی بسازیم. اینجا همین ایده را پیش میبریم و ارقام دستنویس تازه از پیکرهٔ استاندارد ارقام که پیشتر به کار بردهایم تولید میکنیم.
برای شروع، دادهٔ ارقام را با ابزارهای دادهٔ Scikit-Learn بار کنیم:
from sklearn.datasets import load_digits
digits = load_digits()
digits.data.shape
(1797, 64)حالا 50 تای اول را رسم کنیم تا دقیقاً یادمان بیاید چه چیزی را میبینیم (شکل زیر):
def plot_digits(data):
    fig, ax = plt.subplots(5, 10, figsize=(8, 4),
                           subplot_kw=dict(xticks=[], yticks=[]))
    fig.subplots_adjust(hspace=0.05, wspace=0.05)
    for i, axi in enumerate(ax.flat):
        im = axi.imshow(data[i].reshape(8, 8), cmap='binary')
        im.set_clim(0, 16)
plot_digits(digits.data)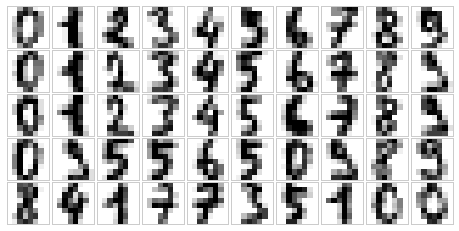
نزدیک 1800 رقم در 64 بُعد داریم و میتوانیم GMM را روی آنها بسازیم تا بیشتر تولید کنیم. GMM در چنین فضای پربعدی میتواند در همگرایی مشکل داشته باشد، پس با الگوریتمی وارونپذیر برای کاهش بُعد شروع میکنیم. اینجا از یک PCA سرراست استفاده میکنیم و میخواهیم 99٪ واریانس دادهٔ تصویرشده را نگه دارد:
from sklearn.decomposition import PCA
pca = PCA(0.99, whiten=True)
data = pca.fit_transform(digits.data)
data.shape
(1797, 41)نتیجه 41 بُعد است، کاهشی نزدیک به ۱/۳ با تقریباً هیچ از دست رفتن اطلاعاتی. با این دادهٔ تصویرشده، بیایید با AIC سنجشی از تعداد مؤلفههای GMMی که باید به کار ببریم بگیریم (شکل زیر):
n_components = np.arange(50, 210, 10)
models = [GaussianMixture(n, covariance_type='full', random_state=0)
          for n in n_components]
aics = [model.fit(data).aic(data) for model in models]
plt.plot(n_components, aics);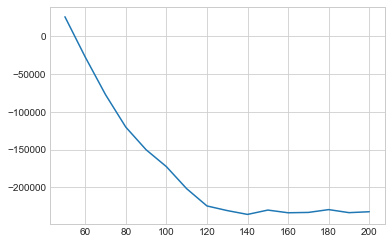
بهنظر میرسد حدود 140 مؤلفه AIC را کمینه میکند؛ از این مدل استفاده میکنیم. بیایید سریع آن را به داده برازش دهیم و تأیید کنیم که همگرا شده است:
gmm = GaussianMixture(140, covariance_type='full', random_state=0)
gmm.fit(data)
print(gmm.converged_)
True
اکنون میتوانیم نمونههایی از 100 نقطهٔ تازه در همین فضای تصویرشدهٔ 41-بعدی بکشیم و از GMM بهعنوان مدلی مولد استفاده کنیم:
data_new, label_new = gmm.sample(100)
data_new.shape
(100, 41)سرانجام میتوانیم با تبدیل وارون شیء PCA ارقام تازه را بسازیم (شکل زیر):
digits_new = pca.inverse_transform(data_new)
plot_digits(digits_new)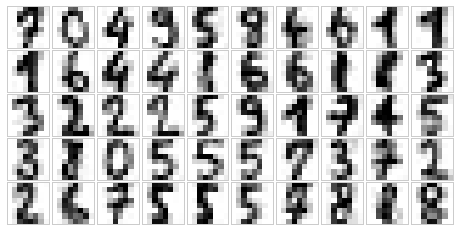
نتیجهها بیشترشان مثل رقمهای محتمل مجموعهداده به نظر میرسند!
به کاری که کردیم فکر کنید: با داشتن نمونهای از ارقام دستنویس، توزیع آن داده را چنان مدل کردیم که بتوانیم نمونههای کاملاً تازهای از رقمها بسازیم: اینها «ارقام دستنویس»ی هستند که هیچکدام بهتنهایی در مجموعهدادهٔ اصلی نیستند، بلکه ویژگیهای کلی دادهٔ ورودی را چنان که مدل مخلوط مدل کرده، میگیرند. چنین مدل مولد ارقام میتواند بهعنوان جزئی از یک دستهبند مولد بیزی بسیار سودمند باشد، همانطور که در فصل بعد میبینیم.