k-means: تابع هدف، لمها و الگوریتم لوید
این صفحه همراهِ نظریِ صفحهٔ خوشهبندی است (که هنوز به فارسی ترجمه نشده): آنجا با scikit-learn رقمها و رنگها خوشهبندی میشوند و الگوریتم تقریباً یک جعبهٔ سیاه است. اینجا میپرسیم k-means در واقع چه چیزی را کمینه میکند، چرا تابع هدف هرگز زیاد نمیشود، و الگوریتم را چگونه از صفر بنویسیم.
اهداف یادگیری. در پایان باید بتوانید
تابع هدف k-means را بنویسید و بگویید ، و در آن چه هستند؛
دو اتحادی را که پشت الگوریتم است اثبات کنید: اینکه مرکز، مجموع مربع فاصلهها را کمینه میکند (لم 1 و نتیجهٔ آن)، و اینکه همان کمیت را میتوان از فاصلههای دوبهدو حساب کرد (لم 2)؛
ثابت کنید الگوریتم لوید پایان مییابد؛
آن را ایمن پیاده کنید — تکرار محدود، خوشهٔ تهی، آغاز مناسب؛
توضیح دهید چرا نتیجه یک کمینهٔ محلی است و نه لزوماً کلی، چرا این موضوع چند راهاندازی دوباره را ضروری میکند، و نتیجه وقتی در برابر برچسبهای معلوم گذاشته شود چه میگوید.
تعریف خوشهبندی
خوشهبندی مجموعهای از نقطههای داده افرازی از این نقطهها به زیرمجموعهٔ جدا از هم (یا خوشه) است چنان که نقطههای یک گروه، به معنایی خاص که تحلیلگر تعیین میکند، به هم بیشتر شبیهاند تا به نقطههای گروههای دیگر.
خوشهبندی نمایندهمحور
با مجموعهدادهای با نقطه در فضای -بعدی، ، و با تعداد خوشهٔ مطلوب ، هدف خوشهبندی نمایندهمحور افراز مجموعهداده به گروه یا خوشه است که خوشهبندی نامیده و با نشان داده میشود.
برای هر خوشهٔ یک نقطهٔ نماینده وجود دارد که خوشه را خلاصه میکند؛ انتخاب رایج میانگین (که مرکز یا سنتروئید هم نامیده میشود) یعنی همهٔ نقطههای خوشه است، یعنی
که تعداد نقطههای خوشهٔ است.
تابع هدف k-means
k-means روشی نمایندهمحور است: نقطههای داده را بر اساس شباهتشان به مرکز هر خوشه به خوشه افراز میکند و افرازی را میجوید که مجموع مربع فاصلهٔ هر نقطه تا مرکز خوشهٔ تخصیصیافتهاش را کمینه کند.
لم 1: مجموع مربع فاصلهها تا یک نقطهٔ دلخواه
بگذارید مجموعهای از نقطههای داده و مرکز آنها باشد. مجموع مربع فاصلهٔ نقطهها تا هر نقطهٔ دلخواه برابر است با مجموع مربع فاصله تا مرکز بهعلاوهٔ تعداد نقطهها ضرب در مربع فاصلهٔ تا مرکز. یعنی
اثبات:
چون جملهٔ متقاطع صفر میشود: .
نتیجهٔ 1: مرکز مجموع مربع فاصلهها را کمینه میکند
برای مجموعهای ثابت از نقطهها، مجموع مربع فاصله تا با کمینه میشود و یکتای کمینهکننده است. به عبارت دیگر، مرکز بهترین نمایندهٔ خوشه زیر تابع هزینهٔ مربع خطاست.
اثبات:
در لم 1 دو جملهٔ اول سمت راست به بستگی ندارند. جملهٔ آخر، ، نامنفی است و فقط وقتی صفر میشود؛ پس یکتای کمینهکننده است.
لم 2: مجموع مربع فاصلهها میان همهٔ جفت نقطهها
بگذارید مجموعهای از نقطههای داده و مرکز آنها باشد. مجموع مربع فاصلهها میان همهٔ جفت نقطهها برابر ضرب در مجموع مربع فاصلهٔ نقطهها تا مرکز است. یعنی
اثبات:
الگوریتم لوید
الگوریتم کلاسیک k-means الگوریتم لوید است. با مرکز آغازین شروع میکند و دو گام را تا وقتی تخصیص دیگر عوض نشود یکی در میان انجام میدهد.
مرکز آغازین را آغاز کن (تصادفی یا با k-means++).
در هر تکرار این گامها را انجام بده:
هر نقطهٔ را به خوشهٔ تخصیص بده که مرکزش نزدیکترین است.
هر مرکز را به میانگین همهٔ نقطههای تخصیصیافته به آن بهروز کن.
گام 2 را تا همگرایی تکرار کن.
همگرایی الگوریتم لوید
تابع هدف — یعنی مجموع مربع خطاها (SSE) — را چنین بنویسید
و یک تکرار کامل را از جفت در نظر بگیرید.
گام تخصیص. مراکز ثابت میمانند و هر نقطه به نزدیکترین مرکز منتقل میشود. هر جملهٔ فقط میتواند کم شود یا ثابت بماند، پس SSE زیاد نمیشود.
گام بهروزرسانی. تخصیص ثابت میماند و هر مرکز با میانگین خوشهٔ خود جانشین میشود. با نتیجهٔ 1، برای همان خوشهٔ ثابت میانگین یکتای کمینهکنندهٔ است؛ SSE باز هم زیاد نمیشود.
پایان. افرازهای نقطه به خوشهٔ ناتهی متناهیاند و SSE نامنظم است، پس فقط تعداد متناهی بار میتواند مقدار عوض کند. وقتی یک تکرار کامل تخصیص را بیتغییر بگذارد، تکرار بعدی دقیقاً همان را بازتولید میکند و الگوریتم متوقف میشود.
دو نکته در عمل مهماند.
این استدلال همگرایی به یک کمینهٔ محلی را ثابت میکند — افرازی که هیچ نقطهٔ واحدی را نمیتوان چنان بازتخصیص داد که تابع هدف بهتر شود — نه به کمینهٔ کلی. نتیجه به مراکز آغازین و به نحوهٔ شکستن تساویها بستگی دارد.
دنباله فقط نامنظم است. اگر دو مرکز برای یک نقطه دقیقاً مساوی باشند، تخصیص میتواند میان دو افراز همکیفیت نوسان کند؛ پس پیادهسازیها بهجای آزمون برابری دقیق مراکز، با یک تحمل کوچک یا پس از تعداد ثابتی تکرار متوقف میشوند.
پیادهسازی k-means از صفر
کلاس زیر همان الگوریتم لوید است، چنان نوشته شده که دو حالت شکست نسخهٔ ساده پوشش داده شود. تکرار با
max_iter کراندار است و بهجای برابری دقیق مراکز با یک تحمل متوقف میشود، و خوشهٔ تهی مرکز پیشین
خود را نگه میدارد بهجای اینکه nan تولید کند (میانگین یک آرایهٔ تهی nan است و nan == nan
نادرست، پس آزمون برابری دقیق هرگز پایان نمییافت).
آغاز بهطور پیشفرض k-means++ است: اولین مرکز بهطور یکنواخت از داده گرفته میشود و هر مرکز
بعدی با احتمال متناسب با مجذور فاصلهاش تا نزدیکترین مرکز انتخابشده برگزیده میشود. این روش
پیشفرض sklearn.cluster.KMeans هم هست و در ادامه توضیح داده میشود.
import numpy as np
import matplotlib.pyplot as plt

SEED = 42


class KMeansClustering:
    """Lloyd's algorithm for k-means, with k-means++ initialisation."""

    def __init__(self, k, init="k-means++", seed=SEED):
        self.k = k
        self.init = init
        self.rng = np.random.default_rng(seed)
        self.centroids = None
        self.labels = None
        self.inertia = None

    def _initial_centroids(self, data):
        n = len(data)
        if self.init == "random":
            return data[self.rng.choice(n, size=self.k, replace=False)].copy()

        # k-means++: first centroid uniform, then D^2 sampling
        centroids = [data[self.rng.integers(n)]]
        for _ in range(1, self.k):
            d2 = ((data[:, None, :] - np.array(centroids)[None, :, :]) ** 2).sum(axis=2).min(axis=1)
            centroids.append(data[self.rng.choice(n, p=d2 / d2.sum())])
        return np.array(centroids, dtype=float)

    def fit(self, data, max_iter=300, tol=1e-9):
        data = np.asarray(data, dtype=float)
        self.centroids = self._initial_centroids(data)

        for iteration in range(max_iter):
            # 1. assignment step: each point to its nearest centroid
            distances = np.linalg.norm(data[:, None, :] - self.centroids[None, :, :], axis=2)
            self.labels = np.argmin(distances, axis=1)

            # 2. update step: each centroid to the mean of its cluster
            new_centroids = self.centroids.copy()
            for j in range(self.k):
                members = data[self.labels == j]
                if len(members) > 0:          # an empty cluster keeps its old centroid
                    new_centroids[j] = members.mean(axis=0)

            shift = np.max(np.abs(new_centroids - self.centroids))
            self.centroids = new_centroids
            if shift < tol:
                break

        self.n_iter_ = iteration + 1
        self.inertia = float(np.sum((data - self.centroids[self.labels]) ** 2))
        return self
اسکریپت زیر یک نمونه از کلاس KMeansClustering میسازد، مدل را روی داده برازش میدهد و داده را همراه با مراکز و برچسبها رسم میکند.
from sklearn.datasets import make_blobs

n_samples = 100
X, y = make_blobs(n_samples=n_samples, centers=3, n_features=2, random_state=SEED)

km = KMeansClustering(k=3).fit(X)

plt.figure(figsize=(6, 5))
plt.scatter(X[:, 0], X[:, 1], c=km.labels, cmap="viridis", s=30)
plt.scatter(km.centroids[:, 0], km.centroids[:, 1], marker="*", s=250, c="red",
            edgecolor="black", label="centroids")
plt.title(f"Lloyd's algorithm with k = 3 (SSE = {km.inertia:.1f}, {km.n_iter_} iterations)")
plt.legend(frameon=False)
plt.grid(alpha=0.3)
plt.show()

print("final centroids:")
print(np.round(km.centroids, 2))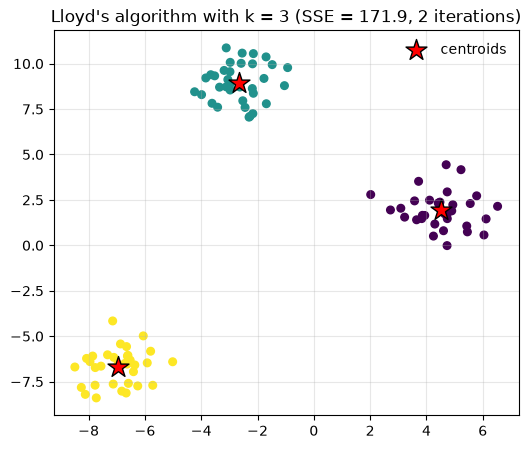
final centroids:
[[ 4.5   1.94]
 [-2.67  8.94]
 [-6.95 -6.68]]
بررسی عددی لم 2
لم 2 مقدار SSE یک مجموعه نقطه — همان کمیتی که k-means کمینه میکند — را برحسب فاصلههای دوبهدو بازنویسی میکند:
سمت چپ روی همهٔ جفت نقطه جمع میزند و سمت راست برابر مجموع مربع فاصلهٔ نقطهها تا مرکزشان است. این اتحاد هرجا به کار میآید که الگوریتمی فقط به فاصلههای دوبهدو دسترسی داشته باشد و نه به مختصات.
دقت کنید لم 2 چه چیزی را نمیگوید: این یک اتحاد است، نه یک گزارهٔ بهینگی. اینکه مرکز مجموع مربع فاصلهها را کمینه میکند، نتیجهٔ 1 لم 1 است. در ادامه بررسی میکنیم که دو طرف لم 2 برای یکی از خوشههای خوشهبندی بالا یک عدد میدهند.
from scipy.spatial.distance import cdist


def lemma_2(points):
    """Compute both sides of Lemma 2 and report whether they agree."""
    n = len(points)
    centroid = points.mean(axis=0)
    right = n * np.sum((points - centroid) ** 2)
    left = np.sum(cdist(points, points) ** 2) / 2
    print(f"pairwise sum                         = {left:.6f}")
    print(f"n * sum of squared distances to mean = {right:.6f}")
    print(f"relative difference                  = {abs(left - right) / right:.2e}")
    return left, right


points = X[km.labels == 0]
print(f"cluster 0 contains {len(points)} points")
lemma_2(points)
cluster 0 contains 33 points
pairwise sum = 2042.432698
n * sum of squared distances to mean = 2042.432698
relative difference = 2.23e-16
(np.float64(2042.4326981762324), np.float64(2042.4326981762329))آغازش k-means++ (خلاصه)
مقدار آغازین مراکز تعیین میکند الگوریتم لوید به کدام کمینهٔ محلی برسد: دو مرکز ممکن است داخل یک خوشهٔ طبیعی بیفتند و آن را دو نیم کنند، و بعد هیچ تکرار دیگری آن را درست نمیکند. k-means++ (Arthur و Vassilvitskii، ۲۰۰۷) مراکز آغازین را یکی پس از دیگری انتخاب میکند: مرکز اول یکنواخت و تصادفی از داده، و هر مرکز بعدی با احتمال متناسب با ، که فاصلهٔ نقطه تا نزدیکترین مرکز انتخابشده است، تا مرکز. نقطهای که از مراکز فعلی دور است سهم بیشتری از این توزیع دارد، پس مراکز در خوشههای مختلف پخش میشوند و گروهی که هنوز مرکزی ندارد رها نمیشود.
تضمین این روش تقریبی است، نه بهینگی: تابع هدف انتظاری اجرا در حد ضریبی از بهینه است
()، پس کمینهٔ بد را نامحتمل
میکند نه ناممکن؛ به همین دلیل پیادهسازیها چند بار راهاندازی میکنند (n_init در scikit-learn) و
اجرای با کمترین SSE را نگه میدارند. متن کامل، آزمایش ۱۰۰ اجرا و مقایسه با آغازش تصادفی در
پیوست آمده است.
هزینه
هر تکرار است: گام تخصیص فاصله تا هر یک از مرکز در فضای -بعدی را حساب میکند و گام بهروزرسانی هر نقطه را یک بار لمس میکند. تعداد تکرارها در عمل کم است (چند ده) ولی کران بدترین حالتِ سودمندی ندارد، به همین دلیل آن را محدود میکنیم. نسخهٔ دقیق را میتوان با درخت -d یا با کرانهای نامساوی مثلثی، که بیشتر محاسبههای فاصله را رد میکنند، سریعتر کرد؛ و برای بزرگ میتوان تخصیص دقیق را با یک کوچکدستهٔ تصادفی جانشین کرد. هر دو در پیوست کار شدهاند، همراه با آغازش k-means++ که نسخهٔ پیشین این صفحه داشت.
مثال: بازیابی بافت تومور با k-means
نظریهٔ بالا میگوید k-means چه چیزی را بهینه میکند؛ نمیگوید پاسخش روی دادهٔ واقعی چه ارزشی دارد. آزمون کلاسیک آن، دادهٔ میکرواری تومور انسانی در Hastie et al. (2009) (بند ۱۴.۳.۸، صص ۵۱۲–۵۱۴) است که در آن کتاب برای نمایش خوشهبندی با ابعاد بالا به کار رفته:
ماتریس ۶۸۳۰ ژن × ۶۴ نمونه از اندازهگیریهای بیان ژن است؛
چیزی که خوشهبندی میشود نمونهها است، پس نمونهٔ نقطهای در است و دو نمونه وقتی نزدیکاند که کل پروفایلشان بخواند، نه وقتی یک ژن بخواند؛
هر نمونه یک برچسب آسیبشناسی هم دارد — سینه، CNS، رودهٔ بزرگ، K562، لوسمی، MCF7، ملانوما، NSCLC، تخمدان، پروستات، کلیه، نامعلوم — که هنگام خوشهبندی پنهان میماند و فقط بعد از آن به کار میآید تا بپرسیم هر خوشه چه چیزی در خود دارد.
نخستین درس این مثال این است که در داده نیست. اگر مجموع مربع فاصلههای درونخوشهای را برحسب رسم کنیم، زانوی روشنی ندارد (شکل ۱۴.۸ کتاب)، پس بهعنوان یک درشتنماییِ عمدی انتخاب میشود: یازده نوع بافت در سه جعبه جا داده میشود.
اجرای k-means با و سپس شمردن اینکه کدام برچسبها کجا افتادند، جدول ۱۴.۲ کتاب را میدهد — همان شکلی که هر وقت برچسب وجود دارد باید نتیجه را با آن گزارش کرد، چون هم گروههای پاک را نشان میدهد و هم اشتباهها را:
| خوشه | سینه | CNS | رودهٔ بزرگ | K562 | لوسمی | MCF7 | ملانوما | NSCLC | تخمدان | پروستات | کلیه | نامعلوم |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ۱ | ۳ | ۵ | ۰ | ۰ | ۰ | ۰ | ۱ | ۷ | ۶ | ۲ | ۹ | ۱ |
| ۲ | ۲ | ۰ | ۰ | ۲ | ۶ | ۲ | ۷ | ۲ | ۰ | ۰ | ۰ | ۰ |
| ۳ | ۲ | ۰ | ۷ | ۰ | ۰ | ۰ | ۰ | ۰ | ۰ | ۰ | ۰ | ۰ |
آن را سطری بخوانید. خوشهٔ ۳ عملاً همان سرطانهای رودهٔ بزرگ است: هر هفت نمونه، بهعلاوهٔ دو نمونهٔ سینه، و هیچ نمونهٔ رودهٔ بزرگی جای دیگری نیست. خوشهٔ ۲ تومورهای خون و پوست را جمع میکند — شش لوسمی با ردههای سلولی K562 و MCF7، ملانوماها، و دو نمونهٔ NSCLC. خوشهٔ ۱ باقی مانده است (CNS، تخمدان، کلیه، پروستات، بیشتر NSCLC)، بزرگترین و ناخالصترین گروه، که وقتی یازده نوع در سه جعبه فشرده شود همین انتظار میرود. الگوریتم حتی یک برچسب هم ندید.
این مثال چه ارزشی دارد و چه چیزی را روشن نمیکند
آن دو نمونهٔ سینه در خوشهٔ ۲ بعداً معلوم شد ملانوماهایی با متاستاز بودهاند؛ خوشهبندی در برابر برچسب درست بود. خوب است دقیق باشیم که این یعنی چه: الگوریتم یک گمان تولید کرد — این پروفایلها شبیه آن گروهاند، نه شبیه گروهی که برچسبشان ادعا میکند — و بررسی آسیبشناسی بعداً آن را تأیید کرد. بدون آن بازبینی، نتیجهٔ صادقانه این بود: «دو نمونه با برچسب خود ناسازگارند، به دلایلی نامعلوم». یادگیری بینظارت میتواند در برابر برچسبها درست باشد، ولی فقط یک پیگیری این را به دانش تبدیل میکند.
دو محدودیت روش در همان جدول دیده میشود:
ترتیبی درون خوشه نیست: خوشهٔ ۱ را فقط میشود الفبایی فهرست کرد، و این هیچ نمیگوید کدام اعضایش بیشتر به هم شبیهاند؛
تودرتویی بین ها نیست: جواب لزوماً ریزترکردن جواب نیست، پس جدولی که برای یک ساخته شده با تغییر تعداد گروهها گسترشپذیر نیست.
هر دو با یک تغییر در شکل گزارش درمان میشوند: دندروگرام نمونهها را روی یک خط مرتب میکند و خانوادهای تودرتو از افرازها میدهد؛ به همین دلیل کتاب برای این کاربرد خوشهبندی سلسلهمراتبی را ترجیح میدهد. باقی ماجرا احتیاطهای کوچک است: با یک نمونهٔ نامتعارف مرکزی را جابهجا میکند و جدول را دیدنی عوض میکند، انتخاب ژنها و پیشپردازش همهٔ فاصلهها را جابهجا میکند، و یک اجرای تنها با آغازش تصادفی چیزی را ثابت نمیکند — نگهبان کار چند راهاندازی دوباره است، یا آغازش بهترِ کارشده در پیوست.
جمعبندی
k-means تابع SSE یعنی را روی افرازها به خوشهٔ ناتهی کمینه میکند.
لم 1 مجموع مربع فاصلهها تا یک نقطهٔ دلخواه را تجزیه میکند؛ نتیجهٔ آن، مرکز را بهعنوان یکتای کمینهکننده معرفی میکند و همین گام بهروزرسانی را توجیه میکند.
لم 2 همان SSE را برحسب فاصلههای دوبهدو بازنویسی میکند. این یک اتحاد است، نه گزارهٔ بهینگی.
الگوریتم لوید تخصیص و بهروزرسانی را یکی در میان انجام میدهد، پس SSE هرگز زیاد نمیشود؛ دنبالهٔ نامنظم روی مجموعهٔ متناهی افرازها باید متوقف شود، و در یک کمینهٔ محلی متوقف میشود.
نتیجه به آغازش بستگی دارد، پس پیادهسازیها کل روش را چند بار تکرار میکنند و اجرای با کمترین SSE را نگه میدارند؛ k-means++ و آزمایش پشتش در پیوست آمدهاند.
در مثال میکرواری تومور، k-means بدون دیدن هیچ برچسبی بافت منشأ را بازیابی میکند، و نتیجه همان جدول توافقی است، نه خود خوشهها.
انتخاب مسئلهٔ جدایی است که در اعتبارسنجی خوشهبندی بررسی میشود.
مطالب اختیاری دربارهٔ k-means
بقیهٔ مطالب کجاست
دو صفحهٔ پیوست بخشهایی از این موضوع را دارند که اینجا جا نشدند:
پیوست: سنجههای بیشتر خوشهبندی و گونههای k-means — NMI و مشکل تصحیحنشدنش برای شانس، آمارهٔ شکاف که زانو را به یک تصمیم تبدیل میکند، مسئلهٔ تخصیص پشت امتیاز جفتسازی بیشینه، آغازش k-means++ همراه آزمایش ۱۰۰ اجرایش، و mini-batch k-means با مقایسهٔ زمانش با نسخهٔ دقیق.
پیوست: چرا k-means با مشتقگیری حل نمیشود — همان تابع هدف، این بار با مشتقگیری باز میشود: مشتق نسبت به مرکز، گام تخصیص که در خطی است و کمینهاش روی رأس رخ میدهد، اینکه تناوب این دو گام همان الگوریتم لوید است، شکل ماتریسی و پیشنمایش معادلات نرمال رگرسیون، و یک پیادهسازی روی Iris که همهٔ فرمولها را عددی چک میکند.
هر دو پیوست فعلاً فقط به انگلیسی هستند.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer.