
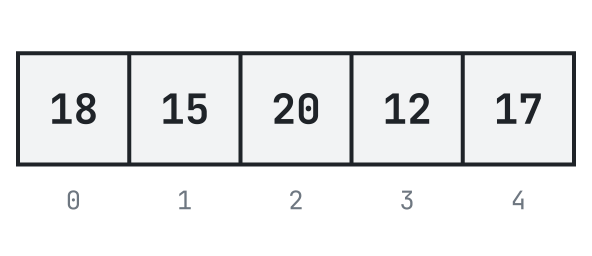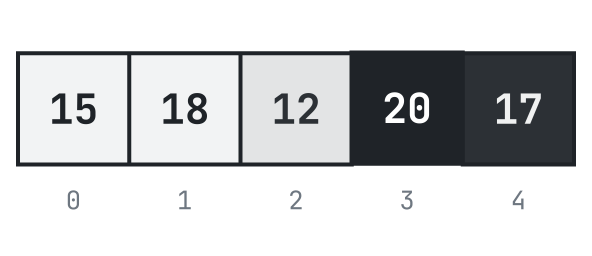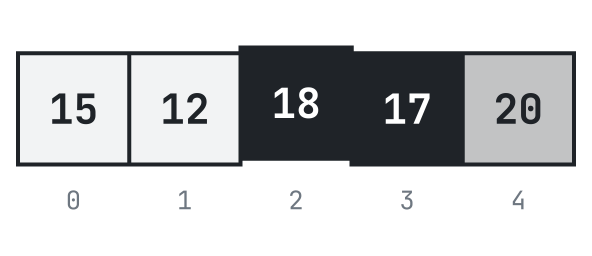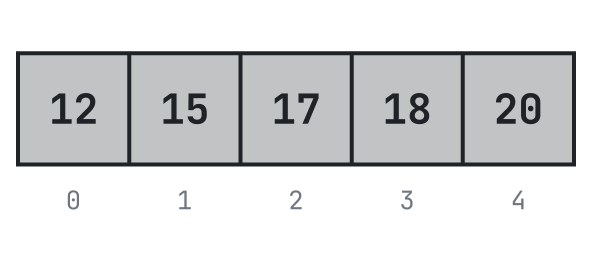

بخش پنجم : ساختارهای داده پایه
مقدمه
تا اینجای درس، با متغیرهای ساده کار کردهایم: یک عدد صحیح، یک عدد اعشاری، یک کاراکتر. اما دنیای واقعی اینطور نیست. وقتی میخواهیم نمرات ۵۰۰ دانشجو را ذخیره کنیم، دمای هوا را در ۳۶۵ روز سال نگه داریم، یا نام صد کاربر یک سیستم را در حافظه داشته باشیم، تعریف ۵۰۰ متغیر جداگانه به نامهای score1، score2، ...، score500 نهتنها خستهکننده بلکه عملاً غیرممکن است. مشکل تکنیکی مشخص است: ما به راهی نیاز داریم که مجموعهای از دادههای همنوع را زیر یک نام واحد نگه داریم و بتوانیم با استفاده از یک عدد (نه یک نام جدید) به هرکدام از آنها دسترسی پیدا کنیم.
این بخش دقیقاً همین مسئله و راهحل آن را دنبال میکند. مسیر حرکت ما اینطور است: ابتدا آرایهها (Arrays) را معرفی میکنیم تا بتوانیم مجموعهای از دادهها را نگه داریم و پیمایش کنیم. سپس با داشتن این مجموعه داده، دو سؤال طبیعی پیش میآید: «چطور یک مقدار خاص را در این مجموعه پیدا کنیم؟» که به جستجو (Searching) میرسیم، و «چطور این مجموعه را مرتب کنیم؟» که به مرتبسازی (Sorting) میرسیم. در نهایت متوجه میشویم که رشتههای متنی (Strings) در زبان C چیزی نیستند جز یک نوع خاص از آرایه، آرایهای از کاراکترها با یک قانون پایانی خاص.
در طول این بخش، از یک سناریوی واحد استفاده میکنیم تا مفاهیم پراکنده نمانند: سیستم مدیریت نمرات دانشجویان. نمرات را در آرایه ذخیره میکنیم، در آنها جستجو میکنیم، آنها را مرتب میکنیم، و در نهایت نام دانشجویان را بهعنوان رشته مدیریت میکنیم.
نقشه کلی بخش:
متغیر معمولی → Array → Index → Traversal → Operations
                                              │
                              ┌───────────────┴──────────────────┐
		                    Search                              Sort
                              │                                  │
                        Linear Search                Bubble /Selection / Insertion
                              │                                  │
                              └────────► Binary Search ◄─────────┘
                                        (نیازمند آرایه مرتب)

Character Array → '\0' → String → strlen / strcpy / strcmp / strcat
فصل ۱۱ : Arrays
11.1 چرا به آرایه نیاز داریم؟
فرض کنید استاد درس «مبانی کامپیوتر» میخواهد میانگین نمرات ۵ دانشجو را در یک کوییز محاسبه کند. با دانش فعلیمان مینویسیم:
%%writefile src/p05_c11_01_array_naive_avg.c

#include <stdio.h>

int main(void)
{
    int score1 = 18, score2 = 15, score3 = 20, score4 = 12, score5 = 17;
    double average = (score1 + score2 + score3 + score4 + score5) / 5.0;

    printf("Average: %.2f\n", average);
    return 0;
}!gcc -Wall -o bin/p05_c11_01_array_naive_avg src/p05_c11_01_array_naive_avg.c && ./bin/p05_c11_01_array_naive_avgAverage: 16.40
برای ۵ دانشجو این کد قابل تحمل است. اما چند سؤال را از خودتان بپرسید:
اگر تعداد دانشجویان ۵۰۰ نفر بود، باید ۵۰۰ متغیر تعریف میکردیم؟
اگر بخواهیم نمره دانشجوی شماره ۲۳۷ را پیدا کنیم، چطور با نام متغیر به آن دسترسی پیدا کنیم وقتی این عدد از ورودی کاربر میآید و در زمان نوشتن برنامه معلوم نیست؟
اگر بخواهیم روی همه نمرات یک حلقه بزنیم (مثلاً همه را چاپ کنیم)، با ۵۰۰ متغیر مجزا اصلاً حلقهزدن معنا ندارد؛ حلقه روی چه چیزی تکرار میشود؟
مشکل اصلی این است: متغیرهای معمولی هرکدام یک «نام» مستقل دارند و هیچ ارتباط ساختاریافتهای بین آنها وجود ندارد که برنامه بتواند بهصورت برنامهنویسیشده (نه دستی) بین آنها حرکت کند. ما به سازهای نیاز داریم که:
مجموعهای از مقادیر همنوع را زیر یک نام واحد نگه دارد.
به هر عضو این مجموعه با یک عدد (نه یک نام جدید) دسترسی داده شود.
بتوان با یک حلقه، روی تمام اعضای آن حرکت کرد.
این دقیقاً همان چیزی است که آرایه (Array) فراهم میکند.
11.2 مفهوم آرایه و Index
آرایه را میتوان مثل یک ردیف از جعبههای هماندازه و چسبیدهبههم تصور کرد که همه زیر یک برچسب واحد قرار دارند. هر جعبه یک مقدار نگه میدارد، و برای رسیدن به جعبهی مورد نظر، بهجای نام، از شماره جعبه استفاده میکنیم. این شماره را اندیس (Index) مینامیم.
نکتهای که در همین ابتدا باید کاملاً جا بیفتد: در زبان C، شمارهگذاری جعبهها از صفر شروع میشود، نه از یک. یعنی اگر آرایهای ۵ عنصر داشته باشد، اندیسهای معتبر آن 0، 1، 2، 3، 4 هستند، نه 1 تا 5. این یکی از رایجترین منابع خطا برای دانشجویان تازهکار است و در ادامه به آن بازمیگردیم. توجه کنید تشبیه «ردیف جعبهها» فقط یک مدل ذهنی است برای کمک به تصور اولیه؛ در بخش «آرایه و حافظه» دقیقاً میبینیم این تشبیه در سطح حافظه واقعی به چه معناست.
11.3 تعریف و مقداردهی در C
برای تعریف یک آرایه در C، باید سه چیز را مشخص کنیم: نوع دادهی عناصر، نام آرایه، و تعداد عناصر (اندازه آرایه):
int scores[5];این خط میگوید: «۵ عدد صحیح پشتسرهم در حافظه رزرو کن و نام این مجموعه را scores بگذار.»
توجه کنید در این حالت، مقادیر داخل scores مقداردهی نشدهاند؛ یعنی مقادیر آن نامشخص (Indeterminate) هستند، نه لزوماً صفر. اگر آرایه در سطح تابع (Local) تعریف شود و مقداردهی اولیه نگیرد، نباید انتظار داشته باشیم مقدار خاصی مثل صفر در آن باشد؛ این یکی از جاهایی است که نباید رفتار Undefined را با رفتاری «قابل پیشبینی» اشتباه گرفت.
برای مقداردهی اولیه همزمان با تعریف:
int scores[5] = {18, 15, 20, 12, 17};اگر تعداد مقادیر دادهشده کمتر از اندازه آرایه باشد:
int scores[5] = {18, 15};در این حالت سه عنصر باقیمانده (اندیسهای ۲، ۳ و ۴) بهصورت خودکار با صفر مقداردهی میشوند. این رفتار فقط مخصوص مقداردهی اولیه (Initialization) با آکولاد است، نه رفتار عمومی آرایهها.
یک نکته Clean Code:
بهجای نوشتن عدد
5بهصورت مستقیم (Magic Number) در چند جای برنامه، بهتر است از یک ثابت نامگذاریشده استفاده کنیم:
#define STUDENT_COUNT 5

int scores[STUDENT_COUNT];
چرا این بهتر از نوشتن مستقیم 5 است؟
چون اگر بعداً تعداد دانشجویان تغییر کند، فقط کافیست یک عدد را در یک خط عوض کنیم؛ در غیر این صورت باید در تمام برنامه دنبال عدد 5 بگردیم و ریسک فراموش کردن یک مورد وجود دارد. همچنین STUDENT_COUNT برای خواننده کد معنادارتر از یک عدد تنها است.
11.4 دسترسی و تغییر عناصر
برای خواندن یا نوشتن یک عنصر خاص، از نام آرایه به همراه اندیس داخل کروشه استفاده میکنیم:
printf("%d\n", scores[0]);   // چاپ اولین عنصر
scores[2] = 19;              // تغییر سومین عنصر
اینجا scores[0] یعنی «اولین جعبه»، و scores[2] یعنی «سومین جعبه»؛ چون شمارش از صفر شروع میشود. اگر آرایهای n عنصر داشته باشد، آخرین اندیس معتبر آن همیشه n - 1 است، نه n. این نکته آنقدر مهم است که دوباره در بخش خطاهای رایج به آن بازم
تمرین درون فصل ۱۱.۱
نوع تمرین: Predict the Output
int arr[4] = {5, 10, 15};
printf("%d\n", arr[3]);
بدون اجرای کد، خروجی را پیشبینی کنید و دلیل بیاورید.
%%writefile src/p05_c11_02_array_traversal.c

#include <stdio.h>
#define STUDENT_COUNT 5

int main(void)
{
    int scores[STUDENT_COUNT] = {18, 15, 20, 12, 17};

    for (int i = 0; i < STUDENT_COUNT; i++) {
        printf("Student %d: %d\n", i, scores[i]);
    }

    return 0;
}!gcc -Wall -o bin/p05_c11_02_array_traversal src/p05_c11_02_array_traversal.c && ./bin/p05_c11_02_array_traversalStudent 0: 18
Student 1: 15
Student 2: 20
Student 3: 12
Student 4: 17
چرا حلقه از i = 0 شروع میشود؟
چون اگر بعداً تعداد دانشجویان تغییر کند، فقط کافیست یک عدد را در یک خط عوض کنیم؛ در غیر این صورت باید در تمام برنامه دنبال عدد 5 بگردیم و ریسک فراموش کردن یک مورد وجود دارد. همچنین STUDENT_COUNT برای خواننده کد معنادارتر از یک عدد تنها است.
این خطا را Out-of-Bounds Access مینامند و در C بهصورت خودکار تشخیص داده نمیشود؛ کامپایلر معمولاً هیچ خطایی نمیدهد، اما برنامه ممکن است رفتار نامشخص (Undefined Behavior) از خود نشان دهد: گاهی یک مقدار بیمعنی چاپ میشود، گاهی برنامه کرش میکند، و گاهی بهظاهر کار میکند ولی حافظهای را که متعلق به داده دیگری است دستکاری میکند. همین غیرقابلپیشبینی بودن است که این خطا را خطرناک میکند.
جریان اجرای Traversal
مسیر تصمیمگیری حلقهی بالا (بررسی شرط، انجام کار، افزایش i، و بازگشت به بررسی شرط) یک الگوی تکرارشونده است که در تقریباً تمام الگوریتمهای این بخش (جستجو، مرتبسازی، پیمایش رشته) دوباره دیده میشود. دیدن آن بهصورت Flowchart از همینجا به فهم بهتر آنها کمک میکند:
تمرین درون فصل ۱۱.۲: چرا خطای مرزی خطرناک است؟
نوع تمرین: Quick Reasoning
int arr[5] = {1, 2, 3, 4, 5};
printf("%d\n", arr[5]);
این کد را کامپایل و اجرا کنید (یا در ذهن تحلیل کنید). آیا کامپایلر خطایی میدهد؟ چرا با وجود اینکه arr[5] خارج از محدودهی معتبر آرایه است (اندیسهای معتبر فقط 0 تا 4 هستند)، ممکن است برنامه بدون هیچ پیام خطایی یک عدد بیمعنی چاپ کند؟ توضیح دهید چرا این سکوت کامپایلر و اجرای برنامه، خطای Out-of-Bounds را خطرناکتر از یک خطای کامپایل میکند.
11.6 عملیات پایه روی آرایه
با پیمایش، حالا میتوانیم محاسبات معناداری روی مجموعه داده انجام دهیم.
Example A - Simple: جمع و میانگین
%%writefile src/p05_c11_03_array_sum_avg.c

#include <stdio.h>
#define STUDENT_COUNT 5

int main(void)
{
    int scores[STUDENT_COUNT] = {18, 15, 20, 12, 17};
    int sum = 0;

    for (int i = 0; i < STUDENT_COUNT; i++) {
        sum += scores[i];
    }

    double average = sum / (double)STUDENT_COUNT;
    printf("Sum: %d, Average: %.2f\n", sum, average);

    return 0;
}!gcc -Wall -o bin/p05_c11_03_array_sum_avg src/p05_c11_03_array_sum_avg.c && ./bin/p05_c11_03_array_sum_avgSum: 82, Average: 16.40
چرا sum / (double)STUDENT_COUNT و نه sum / STUDENT_COUNT؟
چون هر دو sum و STUDENT_COUNT از نوع int هستند، و تقسیم دو عدد صحیح در C بهصورت تقسیم صحیح انجام میشود (قسمت اعشاری دور ریخته میشود). با تبدیل صریح (Cast) یکی از آنها به double، کل عبارت بهصورت اعشاری محاسبه میشود.
Example B — Real: پیدا کردن بیشترین نمره
%%writefile src/p05_c11_04_array_max.c

#include <stdio.h>
#define STUDENT_COUNT 5

int main(void)
{
    int scores[STUDENT_COUNT] = {18, 15, 20, 12, 17};
    int max = scores[0];

    for (int i = 1; i < STUDENT_COUNT; i++) {
        if (scores[i] > max) {
            max = scores[i];
        }
    }

    printf("Max grade: %d\n", max);
    return 0;
}!gcc -Wall -o bin/p05_c11_04_array_max src/p05_c11_04_array_max.c && ./bin/p05_c11_04_array_maxMax grade: 20
چرا max را با scores[0] مقداردهی اولیه میکنیم، نه با 0؟
اگر همه نمرات منفی بودند (مثلاً در یک مسئله دیگر با اعداد منفی)، مقداردهی اولیه با 0 باعث میشد max هرگز بهدرستی بهروزرسانی نشود، چون هیچ عددی از 0 بزرگتر نمیشد در حالی که همه اعداد واقعی منفی هستند. با شروع از scores[0]، همیشه یک مقدار واقعی از خود آرایه را بهعنوان نقطه شروع داریم. به همین دلیل هم حلقه از i = 1 شروع میشود، نه i = 0؛ چون عنصر صفرم را از قبل در max قرار دادهایم و بررسی دوبارهی آن ضروری نیست (هرچند اگر از i = 0 هم شروع میشد، نتیجه اشتباه نمیشد، فقط یک مقایسه اضافه انجام میشد).
Example C - Tricky: آرایه تکعنصری
اگر STUDENT_COUNT برابر ۱ باشد چه اتفاقی میافتد؟
در کد Max بالا، max = scores[0] مقداردهی میشود و حلقه for (i = 1; i < 1; ...) اصلاً اجرا نمیشود؛ که کاملاً درست است، چون تنها عنصر موجود همان مقدار ماکزیمم است. این مثال نشان میدهد چرا الگوی «مقداردهی اولیه با عنصر صفرم، سپس حلقه از یک» در برابر حالتهای مرزی (Edge Case) هم درست عمل میکند؛ نکتهای که در طراحی الگوریتمهای بعدی هم بارها میبینیم.
11.7 آرایه و حافظه
حالا وقت آن است که تشبیه «ردیف جعبهها» را با واقعیت فنیتری جایگزین کنیم. وقتی مینویسیم:
int scores[5];کامپایلر یک بلوک پیوسته (Contiguous) از حافظه به اندازهی «۵ برابر اندازه یک int» رزرو میکند. روی اکثر سیستمهای رایج امروزی، اندازهی int برابر ۴ بایت است (این مقدار طبق استاندارد C ثابت نیست و به Implementation بستگی دارد؛ برای اطمینان از اندازه واقعی روی یک سیستم مشخص از عملگر sizeof استفاده میشود). یعنی حافظهای شبیه این تخصیص مییابد:
Index:     0      1      2      3      4
        ┌──────┬──────┬──────┬──────┬──────┐
Value:  │  18  │  15  │  20  │  12  │  17  │
        └──────┴──────┴──────┴──────┴──────┘
Address: 1000    1004   1008   1012   1016   (فرضی، وابسته به سیستم)
نکته کلیدی: چون عناصر پشتسرهم و بدون فاصله در حافظه قرار دارند، کامپایلر میتواند آدرس هر عنصر را فقط با یک محاسبه ساده پیدا کند: آدرس شروع + (اندیس × اندازه هر عنصر). این دقیقاً همان چیزی است که دسترسی به scores[i] را در زمان ثابت (بدون وابستگی به اندازه آرایه) ممکن میکند؛ نکتهای که بعداً هنگام بحث درباره Complexity به آن اشاره میکنیم.
برای گرفتن اندازهی واقعی یک آرایه بر حسب بایت، از sizeof استفاده میشود:
int scores[5] = {18, 15, 20, 12, 17};
printf("%zu\n", sizeof(scores));          // اندازه کل آرایه بر حسب بایت
printf("%zu\n", sizeof(scores) / sizeof(scores[0]));  // تعداد عناصر
الگوی sizeof(array) / sizeof(array[0]) برای محاسبهی «تعداد عناصر» رایج است، اما فقط در محدودهای معتبر است که scores واقعاً یک آرایه باشد (نه یک اشارهگر که از تابع دیگری دریافت شده). این تفاوت در بخش بعد روشن میشود.
فاصلهی هر دو خانهی متوالی همواره برابر sizeof(int) = 4 بایت است.
دقیقاً به همین دلیل، آدرس هر عنصر با یک محاسبهی ساده از آدرس شروع بهدست میآید:
address(scores[i]) = address(scores[0]) + i * sizeof(int)
11.8 آرایه و توابع
فرض کنید میخواهیم محاسبهی جمع را در یک تابع جدا قرار دهیم:
%%writefile src/p05_c11_05_array_func_param.c

#include <stdio.h>
#define STUDENT_COUNT 5

int sumArray(int arr[], int size)
{
    int sum = 0;
    for (int i = 0; i < size; i++) {
        sum += arr[i];
    }
    return sum;
}

int main(void)
{
    int scores[STUDENT_COUNT] = {18, 15, 20, 12, 17};
    printf("Sum: %d\n", sumArray(scores, STUDENT_COUNT));
    return 0;
}!gcc -Wall -o bin/p05_c11_05_array_func_param src/p05_c11_05_array_func_param.c && ./bin/p05_c11_05_array_func_paramSum: 82
نکته بسیار مهم اینجاست: چرا size را بهعنوان یک پارامتر جداگانه به تابع پاس میدهیم؟ چرا تابع خودش نمیتواند اندازهی آرایه را بفهمد؟
دلیل این است که وقتی یک آرایه بهعنوان آرگومان به تابعی پاس داده میشود، در عمل فقط آدرس اولین عنصر آن منتقل میشود، نه خودِ آرایه (به این رفتار Array Decay گفته میشود؛ جزئیات دقیقتر آن را در فصل اشارهگرها خواهیم دید). به همین دلیل، تابع دیگر نمیداند آرایهی ورودی اصلاً چند عنصر دارد. برای همین اگر داخل sumArray بنویسیم sizeof(arr)، نتیجه اندازهی یک اشارهگر خواهد بود (مثلاً ۸ بایت روی بسیاری از سیستمهای ۶۴ بیتی)، نه اندازهی کل آرایه؛ یک اشتباه بسیار رایج. به همین دلیل، همیشه باید اندازهی آرایه را بهصورت جداگانه و صریح به تابع پاس بدهیم.
11.9 خطاهای رایج در آرایه یکبعدی
❌ اشتباه ۱: شروع اندیس از یک
for (int i = 1; i <= STUDENT_COUNT; i++) {
    printf("%d\n", scores[i]);
}
چرا اشتباه است؟
این حلقه از scores[1] شروع میشود (که در واقع دومین عنصر است، نه اولین) و تا scores[STUDENT_COUNT] پیش میرود که یک اندیس خارج از محدوده است. چه اتفاقی ممکن است بیفتد؟ اولین عنصر واقعی (scores[0]) هرگز چاپ نمیشود، و در انتها یک دسترسی خارج از محدوده رخ میدهد که رفتار آن نامشخص است.
✅ نسخه صحیح
for (int i = 0; i < STUDENT_COUNT; i++) {
    printf("%d\n", scores[i]);
}
چرا صحیح است؟
حلقه دقیقاً از اولین اندیس معتبر (0) شروع شده و درست قبل از رسیدن به اولین اندیس نامعتبر (STUDENT_COUNT) متوقف میشود.
❌ اشتباه ۲: فرض کردن مقداردهی خودکار به صفر
int arr[10];
printf("%d\n", arr[3]);   // انتظار چاپ 0
چرا اشتباه است؟
اگر arr یک آرایه محلی (Local) در یک تابع باشد و بهصورت صریح مقداردهی نشده باشد، محتوای آن نامشخص است؛ ممکن است هر عددی چاپ شود.
✅ نسخه صحیح
int arr[10] = {0}; // تمام عناصر با صفر مقداردهی میشوند
printf("%d\n", arr[3]);چرا صحیح است؟
نوشتن {0} در مقداردهی اولیه باعث میشود اولین عنصر صفر شود و طبق قانونی که در بخش ۱۱.۳ دیدیم، بقیه عناصر هم بهصورت خودکار صفر میشوند.
تمرینهای پایانی زیربخش: آرایه یکبعدی
★ سطح پایه
Complete the Code:
آرایهای ۶ عنصری از نمرات تعریف کنید و تابعی بنویسید که مجموع تمام عناصر را برگرداند.Predict the Output:
int arr[3] = {7};
printf("%d %d %d\n", arr[0], arr[1], arr[2]);
خروجی را پیشبینی کرده و دلیل آن را با استناد به قانون مقداردهی جزئی توضیح دهید.
★★ سطح متوسط
Find the Bug:
int arr[5] = {3, 7, 1, 9, 4};
int max = 0;
for (int i = 0; i < 5; i++) {
    if (arr[i] > max) max = arr[i];
}
اگر تمام مقادیر آرایه منفی باشند، این کد چه نتیجهی اشتباهی تولید میکند؟ چرا؟ (راهنمایی: به بخش ۱۱.۶، Example B بازگردید.)
Small Implementation:
تابعی بنویسید که یک آرایهی عددی و اندازهی آن را دریافت کند و کوچکترین عنصر آرایه را برگرداند. سپس آن را برای آرایهای با یک عنصر و آرایهای با عناصر تکراری تست کنید.Trace:
برای آرایهیarr = {2, 4, 6, 8}، مقدارsumرا بعد از هر iteration حلقهی جمعکننده مشخص کنید.
★★★ سطح چالشی
Explain Why:
توضیح دهید چرا در تابع زیر، آخرین اندیس معتبر همیشهsize - 1است، نهsize:
void printLast(int arr[], int size)
{
    printf("%d\n", arr[size - 1]);
}
اگر کسی بهاشتباه از arr[size] استفاده کند، چه نوع خطایی رخ میدهد و چرا ممکن است این خطا بلافاصله خودش را نشان ندهد؟
Design:
تابعی طراحی و پیادهسازی کنید که یک آرایه از نمرات را دریافت کند و تعداد نمراتی که بالای میانگین کل هستند را برگرداند. دقت کنید ابتدا باید میانگین را محاسبه کنید، سپس در یک پیمایش دوم مقایسه انجام دهید.
11.10 آرایه چندبعدی و Matrix
چرا به آرایه چندبعدی نیاز داریم؟
فرض کنید حالا میخواهیم نه فقط نمرهی یک کوییز، بلکه نمرات ۴ کوییز مختلف را برای ۳ دانشجو ذخیره کنیم. میتوانیم برای هر کوییز یک آرایه یکبعدی جدا تعریف کنیم، اما این کار دادهای که ذاتاً دوبعدی است (دانشجو × کوییز) را بهصورت مصنوعی تکهتکه میکند. راهحل طبیعیتر، یک آرایه دوبعدی است: نوعی «جدول» با سطر (Row) و ستون (Column)، که سطر معمولاً نشاندهندهی یک دانشجو و ستون نشاندهندهی یک کوییز است.
تعریف و مقداردهی در C
int scores[3][4] = {
    {18, 15, 20, 17},   // دانشجوی ۰
    {12, 14, 16, 18},   // دانشجوی ۱
    {20, 19, 18, 20}    // دانشجوی ۲
};
اینجا scores یک آرایهی ۳ در ۴ است: ۳ سطر (دانشجو) و ۴ ستون (کوییز). دسترسی به یک خانهی مشخص با دو اندیس انجام میشود:
printf("%d\n", scores[1][2]); // نمره کوییز شماره ۲ برای دانشجوی شماره ۱ → 16پیمایش با حلقههای تودرتو
%%writefile src/p05_c11_06_matrix_traversal.c

#include <stdio.h>
#define ROWS 3
#define COLS 4

int main(void)
{
    int scores[ROWS][COLS] = {
        {18, 15, 20, 17},
        {12, 14, 16, 18},
        {20, 19, 18, 20}
    };

    for (int i = 0; i < ROWS; i++) {
        for (int j = 0; j < COLS; j++) {
            printf("%d ", scores[i][j]);
        }
        printf("\n");
    }

    return 0;
}!gcc -Wall -o bin/p05_c11_06_matrix_traversal src/p05_c11_06_matrix_traversal.c && ./bin/p05_c11_06_matrix_traversal18 15 20 17
12 14 16 18
20 19 18 20
حلقهی بیرونی (i) روی سطرها حرکت میکند و حلقهی داخلی (j) برای هر سطر روی تمام ستونها حرکت میکند. این الگوی «حلقه در حلقه» را باید کاملاً بشناسید، چون دوباره در الگوریتمهای مرتبسازی میبینیدش.
مثال کاربردی: میانگین نمرات هر دانشجو
for (int i = 0; i < ROWS; i++) {
    int sum = 0;
    for (int j = 0; j < COLS; j++) {
        sum += scores[i][j];
    }
    printf("Student %d average: %.2f\n", i, sum / (double)COLS);
}
تمرین درون فصل ۱۱.۳
نوع تمرین: Trace
برای آرایهی زیر، خروجی کد پیمایش دوبعدی را دستی روی کاغذ بنویسید:
int arr[2][3] = {{1, 2, 3}, {4, 5, 6}};Memory Layout: Row-Major Order
یک سؤال طبیعی این است: آرایه دوبعدی در حافظه چگونه ذخیره میشود، وقتی حافظه خودش یکبعدی (یک ردیف پیوسته از بایتها) است؟
پاسخ: کامپایلرهای C از روشی به نام Row-Major Order استفاده میکنند؛ یعنی تمام عناصر سطر اول، سپس تمام عناصر سطر دوم، و به همین ترتیب، پشتسرهم در حافظه چیده میشوند:
Row 0: 18  15  20  17
Row 1: 12  14  16  18
Row 2: 20  19  18  20

در حافظه به ترتیب:
18 15 20 17 | 12 14 16 18 | 20 19 18 20عناصر یک آرایهی دوبعدی 3×4 در حافظه بهصورت پیوسته و در ترتیب Row-Major ذخیره میشوند؛ بنابراین در مجموع ۱۲ عنصر int در این آرایه وجود دارد. کامپایلر با محاسبهی آدرس شروع + (i × تعداد_ستون + j) × اندازه_عنصر به خانهی [i][j] دسترسی پیدا میکند. لازم نیست این فرمول را حفظ کنید، اما درک اینکه آرایه دوبعدی در سطح حافظه یک ساختار پیوستهی یکبعدی است، به فهم بهتر مفاهیم پیشرفتهتر در آینده کمک میکند.
تمرین درون فصل ۱۱.۴ : ترتیب دسترسی در Row-Major
نوع تمرین: Trace
برای ماتریس زیر:
int m[2][3] = {{10, 20, 30}, {40, 50, 60}};اگر دو حلقهی تودرتوی زیر را اجرا کنیم:
for (int j = 0; j < 3; j++) {
    for (int i = 0; i < 2; i++) {
        printf("%d ", m[i][j]);
    }
}
ترتیب دقیق چاپ مقادیر چیست؟ (دقت کنید اینبار حلقهی بیرونی روی ستون و حلقهی داخلی روی سطر حرکت میکند؛ برخلاف الگوی معمول متن.) این ترتیب را با ترتیب Row-Major که در حافظه ذخیره شده مقایسه کنید.
خطاهای رایج در آرایه دوبعدی
❌ اشتباه: جابهجا کردن اندیس سطر و ستون
printf("%d\n", scores[COLS][ROWS]); // اشتباه در ترتیب و در مقدارچرا اشتباه است؟
اندیس اول همیشه سطر و اندیس دوم همیشه ستون است؛ استفاده از COLS و ROWS بهجای مقادیر واقعی اندیس، هم مفهوماً و هم از نظر محدوده (چون COLS و ROWS خودشان اندازهی آرایهاند، نه یک اندیس معتبر) اشتباه است و منجر به دسترسی خارج از محدوده میشود.
پیچیدگی زمانی (Complexity) پیمایش دوبعدی
اگر آرایه m سطر و n ستون داشته باشد، پیمایش کامل آن با دو حلقهی تودرتو نیازمند بررسی m × n خانه است؛یعنی زمان اجرا متناسب با حاصلضرب تعداد سطرها در تعداد ستونهاست، نه فقط مجموع آنها.
جستجو در Matrix
همان ایدهی Linear Search که در فصل بعد بهطور کامل میبینیم، روی آرایهی دوبعدی هم قابل استفاده است: کافیست بهجای پیمایش ساده، در هر خانه مقدار را با هدف مقایسه کنیم و در صورت برابری، هر دو اندیس (سطر و ستون) را گزارش دهیم.
نکته (Preview): برای اینکه تابع بتواند همزمان دو مقدار (سطر و ستون) را به تابع صدازننده گزارش دهد، از پارامترهایی مانند
int *found_rowاستفاده شده است. این یک نگاه اجمالی و زودهنگام به مفهوم اشارهگر (Pointer) است که بهطور کامل در بخشهای بعدی آموزش داده میشود؛ فعلاً همینقدر کافیست بدانید که*found_row = i;یعنی «مقدارiرا در همان متغیری که تابع صدازننده به آدرسش اشاره کرده، بنویس»؛ راهی برای اینکه یک تابع بتواند بیش از یک مقدار را از طریق پارامترهایش برگرداند، نه فقط از طریقreturn.
#include <stdbool.h>

bool searchMatrix(int mat[ROWS][COLS], int target, int *found_row, int *found_col)
{
    for (int i = 0; i < ROWS; i++) {
        for (int j = 0; j < COLS; j++) {
            if (mat[i][j] == target) {
                *found_row = i;
                *found_col = j;
                return true;
            }
        }
    }
    return false;
}
چرا بهجای بازگرداندن یک اندیس تنها (مثل Linear Search روی آرایه یکبعدی)، اینجا دو مقدار خروجی (found_row و found_col) از طریق اشارهگر برگردانده میشوند؟
چون موقعیت یک عنصر در Matrix با یک جفت اندیس مشخص میشود، نه یک عدد تنها؛ تابعی که فقط یک int برمیگرداند نمیتواند هر دو مختصات را همزمان منتقل کند. از نظر Complexity، در بدترین حالت باید تمام m × n خانه بررسی شوندO(m × n) دقیقاً مشابه پیمایش کامل.
تمرینهای پایانی زیربخش: آرایه دوبعدی
★ سطح پایه
Small Implementation:
ماتریس3×3از نمرات کوییز تعریف کنید و مجموع تمام عناصر ماتریس را با یک حلقهی تودرتو محاسبه کنید.Predict the Output:
int m[2][2] = {{1}};
printf("%d\n", m[1][0]);
خروجی را پیشبینی کرده و دلیل آن را با استناد به قانون مقداردهی جزئی توضیح دهید.
★★ سطح متوسط
Small Implementation:
تابعی بنویسید که برای هر سطر یک ماتریسm×n، مجموع عناصر همان سطر را چاپ کند.Small Implementation:
تابعی بنویسید که برای هر ستون یک ماتریسm×n، مجموع عناصر همان ستون را چاپ کند. (راهنمایی: اینبار حلقهی بیرونی باید روی ستونها و حلقهی داخلی روی سطرها حرکت کند.)Find the Bug:
int m[3][4];
for (int i = 0; i < 4; i++) {
    for (int j = 0; j < 3; j++) {
        m[i][j] = 0;
    }
}
این کد قرار است تمام عناصر ماتریس 3×4 را صفر کند، اما دچار خطای Out-of-Bounds میشود. خطا را پیدا کرده و اصلاح کنید.
★★★ سطح چالشی
Small Implementation:
در یک ماتریسn×n، مقدار روی قطر اصلی (یعنی خانههایی که اندیس سطر برابر اندیس ستون است) را پیدا کرده و مجموع آنها را چاپ کنید.Modify the Algorithm:
تابعsearchMatrixرا طوری تغییر دهید که بهجای توقف در اولین برخورد، تعداد کل وقوعهای مقدار هدف را در کل ماتریس بشمارد و برگرداند (بدون اینکه موقعیت هیچکدام را ذخیره کند).Explain Why:
توضیح دهید چرا پیمایش کامل یک ماتریسm×nاز نظر Complexity (پیچیدگی زمانی) برابرO(m × n)است و نهO(m + n). یک مثال عددی بزنید تا تفاوت این دو را نشان دهید.Compare Approaches:
تفاوت اصلی بین یک آرایهی یکبعدی و یک آرایهی دوبعدی را از سه جنبه توضیح دهید:
نحوهی دسترسی به یک عنصر
نحوهی پیمایش
نحوهی ذخیرهسازی واقعی در حافظه
11.11 کاربردهای واقعی آرایه
ذخیرهی خواندهشدههای حسگرها (Sensor Readings) در بازههای زمانی منظم برای پردازش بعدی.
نگهداری نمرات، حقوقها، یا هر مجموعه دادهی عددی همنوع.
نمایش تصویر دیجیتال بهصورت آرایهی دوبعدی (یا سهبعدی برای رنگ) از مقادیر پیکسل.
پیادهسازی جداول و ماتریسها در محاسبات علمی و مهندسی.
...
تمرینهای پایانی فصل ۱۱
توجه: این تمرینها با آنچه در تمرینهای زیربخش دیدید تفاوت دارند و آرایهی یکبعدی، ماتریس، حافظه، پیمایش، و توابع را با هم ترکیب میکنند.
Predict the Output:
int arr[5] = {3, 6};
printf("%d %d %d\n", arr[0], arr[2], arr[4]);
خروجی را پیشبینی کنید و توضیح دهید چرا سه عنصر آخر همگی صفر هستند.
Trace:
برای آرایهیint arr[4] = {7, 2, 9, 4};، حلقهی زیر را دستی دنبال کنید و مقدارsumرا بعد از هر iteration بنویسید:
int sum = 0;
for (int i = 0; i < 4; i++) {
    sum += arr[i];
}
Find the Bug:
void fillZero(int arr[], int n)
{
    for (int i = 1; i <= n; i++) {
        arr[i] = 0;
    }
}
خطای این تابع را پیدا کنید و توضیح دهید برای چه مقدار n این خطا خودش را بهصورت خرابی یا رفتار نامشخص نشان میدهد.
Complexity Reasoning:
توضیح دهید چرا دسترسی بهarr[i]برای یک آرایهی یکبعدیO(1)است، اما پیمایش کامل یک ماتریسm×nبرای پیدا کردن یک مقدار خاصO(m×n)است.Design + Implementation:
تابعی بنویسید که یک آرایهی دوبعدیn×n(ماتریس مربعی) دریافت کند و بررسی کند آیا ماتریس متقارن (Symmetric) است یا نه؛ یعنی آیا برای همهیiوj، مقدارmatrix[i][j]برابرmatrix[j][i]است.Explain Why:
توضیح دهید چرا وقتی یک آرایه به یک تابع پاس داده میشود، تغییر عناصر آن داخل تابع در تابع صدازننده (Caller) هم دیده میشود، در حالی که تغییر یک متغیر عددی معمولی که به تابع پاس داده شده، اینطور نیست.Edge Case Reasoning:
برای هرکدام از موارد زیر توضیح دهید تابع پیمایش چه رفتاری از خود نشان میدهد:
آرایهای با فقط یک عنصر
ماتریسی با فقط یک سطر
ماتریسی با فقط یک ستون.
Refactoring:
کد زیر را با استفاده از یک ثابت نامگذاریشده (#define) بهجای عدد مستقیم بازنویسی کنید و توضیح دهید چرا این تغییر خوانایی و نگهداری کد را بهتر میکند:
int scores[10];
for (int i = 0; i < 10; i++) {
    scores[i] = 0;
}
Retrieval Practice فصل ۱۱
چرا اندیس آرایه در C از صفر شروع میشود، نه از یک؟
اگر آرایهای
nعنصر داشته باشد، آخرین اندیس معتبر آن چیست؟چرا دسترسی به یک عنصر آرایه از نظر Complexity برابر
O(1)است؟چرا هنگام پاس دادن آرایه به تابع، باید اندازه را جداگانه ارسال کنیم؟
در آرایهی دوبعدی، Row-Major Order به چه معناست؟
چرا پیمایش کامل یک ماتریس
m×nاز نظر Complexity برابرO(m×n)است؟
11.12 جمعبندی فصل ۱۱
در این فصل یاد گرفتیم چرا متغیرهای مجزا برای مجموعهدادههای بزرگ کافی نیستند، و چگونه آرایه این مشکل را با نگهداشتن دادههای همنوع زیر یک نام و دسترسی از طریق اندیس (با شروع از صفر) حل میکند. دیدیم که آرایه در حافظه بهصورت پیوسته ذخیره میشود، که هم دسترسی سریع به هر عنصر را ممکن میکند و هم منشأ خطای «خارج از محدوده» است. همچنین دیدیم که هنگام پاس دادن آرایه به تابع، باید اندازه را جداگانه ارسال کنیم، چون آرایه به یک اشارهگر تنزل پیدا میکند. در نهایت، آرایهی دوبعدی را بهعنوان تعمیم طبیعی این ایده برای دادههای جدولی معرفی کردیم.
حالا که میتوانیم مجموعهای از دادهها را نگه داریم و پیمایش کنیم، سؤال طبیعی بعدی این است: چطور یک مقدار خاص را در این مجموعه پیدا کنیم؟ این موضوع فصل بعدی است.
فصل ۱۲ : Searching and Sorting (جستجو و مرتبسازی)
12.1 مسئله جستجو
در سیستم مدیریت نمرات، فرض کنید استاد میخواهد بداند آیا نمرهی ۱۹ در بین نمرات یک کلاس وجود دارد یا نه، و اگر وجود دارد، متعلق به کدام دانشجوست (یعنی در کدام اندیس قرار دارد). این کار را میتوان بهصورت دستی روی یک لیست کوچک انجام داد، اما وقتی تعداد عناصر به هزاران برسد، نیاز به یک روش سیستماتیک و قابلبرنامهنویسی داریم. به این مسئلهی عمومی (آیا مقدار x در مجموعهی داده وجود دارد، و اگر بله در کدام موقعیت؟) جستجو (Search) گفته میشود.
12.2 Linear Search (جستجوی خطی)
ایده الگوریتم
سادهترین راه ممکن: از اولین عنصر شروع کن، آن را با مقدار هدف مقایسه کن؛ اگر برابر بود، اندیس آن را برگردان؛ اگر نبود، برو سراغ عنصر بعدی. این کار را تا رسیدن به انتهای آرایه یا پیدا شدن مقدار ادامه بده.
Example A - مثال دستی
آرایه: [12, 15, 18, 20, 17]، هدف: 18
i=0: arr[0]=12 → 12 ≠ 18، ادامه بده
i=1: arr[1]=15 → 15 ≠ 18، ادامه بده
i=2: arr[2]=18 → 18 = 18 ✓ پیدا شد در اندیس 2Pseudocode
function LINEAR_SEARCH(array, n, target):
    for i from 0 to n - 1:
        if array[i] = target:
            return i
return NOT_FOUND // معمولاً -1Flowchart
Implementation در C
%%writefile src/p05_c12_01_linear_search.c

#include <stdio.h>

int linearSearch(int arr[], int n, int target)
{
    for (int i = 0; i < n; i++) {
        if (arr[i] == target) {
            return i;
        }
    }
    return -1;
}

int main(void)
{
    int scores[] = {12, 15, 18, 20, 17};
    int n = sizeof(scores) / sizeof(scores[0]);

    int result = linearSearch(scores, n, 18);

    if (result != -1) {
        printf("Found at index %d\n", result);
    } else {
        printf("Not found\n");
    }

    return 0;
}!gcc -Wall -o bin/p05_c12_01_linear_search src/p05_c12_01_linear_search.c && ./bin/p05_c12_01_linear_searchFound at index 2
تحلیل کد
چرا مقدار بازگشتی -1 برای «پیدا نشد» انتخاب شده است؟
چون -1 هرگز یک اندیس معتبر آرایه نیست (اندیسها همیشه 0 یا مثبت هستند)، بنابراین میتوان با اطمینان آن را از یک اندیس واقعی تشخیص داد.
چرا تابع بلافاصله بعد از پیدا کردن مقدار return میکند و ادامهی حلقه را اجرا نمیکند؟
چون همین که یک نمونه پیدا شد، دیگر نیازی به بررسی بقیهی عناصر نیست. این کار زمان اجرا را در حالتهایی که مقدار زودتر پیدا میشود کاهش میدهد.
Example B - واقعی: عنصر تکراری
اگر آرایه [18, 15, 18, 20, 18] باشد و هدف 18، تابع فقط اولین وقوع (اندیس 0) را برمیگرداند، نه همهی آنها. این یک تصمیم طراحی است، نه محدودیت زبان. اگر بخواهیم همهی موقعیتها را پیدا کنیم، باید الگوریتم را تغییر دهیم (مثلاً بهجای return، اندیس را در یک آرایهی دیگر ذخیره کنیم و حلقه را کامل اجرا کنیم).
Example C - Tricky: آرایهی تکعضوی و آرایهی خالی
اگر آرایه فقط یک عنصر داشته باشد (n = 1)، حلقه دقیقاً یک بار اجرا میشود که رفتار درستی است. توجه کنید اگر تابع با n = 0 فراخوانی شود، هیچ عنصری برای بررسی وجود ندارد؛ در این حالت حلقهی for حتی یک بار هم اجرا نمیشود (چون شرط 0 < 0 نادرست است) و تابع بلافاصله -1 برمیگرداند؛ رفتاری کاملاً منطقی بدون نیاز به بررسی جداگانه. توجه کنید که اینجا دربارهی مقدار n در فراخوانی تابع صحبت میکنیم، نه تعریف یک آرایهی معمولی با اندازهی صفر در C.
Complexity
در بدترین حالت (Worst Case)، مقدار هدف یا اصلاً در آرایه نیست یا آخرین عنصر است؛ در این حالت باید تمام n عنصر بررسی شوند، پس زمان اجرا متناسب با n است یعنی O(n). در بهترین حالت (Best Case)، مقدار هدف همان اولین عنصر است و فقط یک مقایسه لازم است یعنی O(1). بهطور متوسط (Average Case)، اگر فرض کنیم مقدار هدف با احتمال یکسان در هر موقعیت باشد، انتظار میرود حدود نیمی از عناصر بررسی شوند، که باز هم از نظر Order of Growth با n رشد میکند یعنی O(n).
خطاهای رایج
❌ اشتباه: فراموش کردن بررسی «پیدا نشد»
int idx = linearSearch(scores, n, 100);
printf("Found at %d\n", idx); // چاپ -1 بهعنوان اندیس!چرا اشتباه است؟
اگر مقدار پیدا نشود، idx برابر -1 است، اما کد بدون بررسی این حالت، مستقیماً -1 را بهعنوان یک اندیس معتبر چاپ میکند که گمراهکننده است.
✅ نسخه صحیح
int idx = linearSearch(scores, n, 100);
if (idx != -1) {
    printf("Found at %d\n", idx);
} else {
    printf("Value not found\n");
}
تمرین درون فصل ۱۲.۱
نوع تمرین: Find the Bug
int linearSearch(int arr[], int n, int target)
{
    for (int i = 0; i <= n; i++) {
        if (arr[i] == target) return i;
    }
    return -1;
}
خطای این کد را پیدا کرده و توضیح دهید چرا مشکلساز است.
تمرین درون فصل ۱۲.۲ : چرا Linear Search نیازی به مرتب بودن ندارد؟
نوع تمرین: Explain Why
توضیح دهید چرا Linear Search حتی روی یک آرایهی کاملاً نامرتب هم درست کار میکند، در حالی که در فصل بعد میبینیم Binary Search به این شرط وابسته است. به عبارت الگوریتم Linear Search در ۱۲.۲ نگاه کنید: کدام بخش از آن به ترتیب عناصر وابسته است؟
تمرینهای پایانی زیربخش: Linear Search
★ سطح پایه
Trace:
برای آرایهی[9, 4, 7, 2, 11]و هدف2، مقدارiرا در هر iteration حلقه بنویسید تا زمانی که مقدار پیدا شود.Predict the Output:
int arr[] = {5, 5, 5, 5};
int idx = linearSearch(arr, 4, 5);
printf("%d\n", idx);
با توجه به اینکه تابع linearSearch فقط اولین وقوع را برمیگرداند، خروجی را پیشبینی کنید.
★★ سطح متوسط
Edge Case Implementation:
تابعlinearSearchرا برای سه ورودی زیر (بهصورت جداگانه) تست کنید و نتیجهی هرکدام را پیشبینی کنید:
هدف اولین عنصر آرایه است.
هدف آخرین عنصر آرایه است.
هدف در آرایه وجود ندارد.
Trace + Reasoning:
آرایهای با یک عنصر تعریف کنید (n = 1) و هر دو حالت «هدف موجود است» و «هدف موجود نیست» را دستی Trace کنید. توضیح دهید حلقه در هرکدام دقیقاً چند بار اجرا میشود.Complexity:
توضیح دهید چرا Best Case Linear Search برابرO(1)است اما نمیتوان روی این حالت در طراحی برنامه حساب باز کرد.
★★★ سطح چالشی
Modify the Algorithm:
تابعlinearSearchرا طوری تغییر دهید که بهجای اولین وقوع، آخرین وقوع مقدار هدف را در آرایه پیدا کند (اگر مقدار چند بار تکرار شده باشد).Modify the Algorithm:
تابعی بنویسید که تعداد کل وقوعهای یک مقدار هدف را در آرایه برمیگرداند (نه فقط اولین اندیس آن).Reverse Engineering:
کد زیر را بررسی کنید و توضیح دهید دقیقاً چه مسئلهای را حل میکند:
int findIndex(int arr[], int n, int target)
{
    for (int i = n - 1; i >= 0; i--) {
        if (arr[i] == target) return i;
    }
    return -1;
}
Small Implementation:
تابعی به نامcontainsبنویسید که یک آرایه، اندازهی آن، و یک مقدار هدف دریافت کند و بهجای اندیس، فقط یک مقدار Boolean (trueیاfalse) برگرداند که نشان میدهد آیا هدف در آرایه وجود دارد یا نه (از منطق Linear Search استفاده کنید، اما بدون نیاز به دانستن اندیس دقیق).
12.3 Binary Search (جستجوی دودویی)
فرض کنید اینبار نمرات دانشجویان را بهصورت از قبل مرتبشده در اختیار داریم (مثلاً پس از اعمال یکی از الگوریتمهای مرتبسازی همین فصل). ایدهی اصلی Binary Search این است: بهجای بررسی عناصر یکییکی از ابتدا، عنصر میانی بازهی جستجو را بررسی میکنیم. سه حالت ممکن است پیش بیاید:
اگر مقدار موردنظر برابر عنصر میانی باشد، هدف پیدا شده است.
اگر مقدار موردنظر از عنصر میانی کوچکتر باشد، دیگر لازم نیست نیمهی راست را بررسی کنیم؛ چون آرایه مرتب است، هر چیزی که کوچکتر از عنصر میانی باشد فقط میتواند در نیمهی چپ باشد.
اگر مقدار موردنظر از عنصر میانی بزرگتر باشد، به همین ترتیب فقط نیمهی راست را بررسی میکنیم.
در هر مرحله، نیمی از فضای جستجو کنار گذاشته میشود؛ به همین دلیل این الگوریتم Binary (دودویی) نام دارد.
برای دیدن این ایده در عمل، آرایهی مرتب زیر را در نظر بگیرید:
[10, 20, 30, 40, 50, 60, 70]فرض کنید میخواهیم مقدار 60 را پیدا کنیم:
ابتدا کل بازه (اندیسهای
0تا6) را در نظر میگیریم؛ عنصر میانی40است. چون60بزرگتر از40است، نیمهی چپ (شامل خود40) کنار گذاشته میشود.بازهی جدید فقط
[50, 60, 70]است؛ عنصر میانی همین بازه60است.چون
60برابر عنصر میانی است، هدف پیدا شد؛ فقط در دو مرحله، بدون بررسی تکتک عناصر.
حالا که ایدهی کلی روشن شد، ببینیم دقیقاً همین سرعت از کجا میآید:
چرا Binary Search سریعتر است؟
جستجوی خطی در بدترین حالت باید تکتک تمام عناصر را بررسی کند. اما اگر آرایه از قبل مرتب (Sorted) باشد، میتوانیم از این ترتیب به نفع خودمان استفاده کنیم: بهجای بررسی یکییکی، هر بار نیمی از فضای جستجو را کنار بگذاریم.
شرط اصلی: آرایه باید مرتب باشد
این نکته آنقدر حیاتی است که باید بهصورت مجزا تأکید شود: Binary Search فقط روی آرایهی مرتبشده کار میکند. اگر آرایه مرتب نباشد، مقایسهی عنصر میانی با هدف و نتیجهگیری «پس هدف باید در نیمهی چپ یا راست باشد» دیگر معتبر نیست، چون هیچ تضمینی وجود ندارد که مقادیر بزرگتر همیشه در یک سمت مشخص قرار داشته باشند.
مفهوم بازه جستجو: low، high، mid
الگوریتم سه متغیر را نگه میدارد: low (کوچکترین اندیس بازهی فعلی)، high (بزرگترین اندیس بازهی فعلی)، و mid (اندیس وسط بازه). در هر مرحله:
midرا محاسبه کن.اگر
array[mid]برابر هدف بود، پیدا شد.اگر
array[mid]کوچکتر از هدف بود، هدف (در صورت وجود) باید در نیمهی راست باشد، پسlowرا بهmid + 1تغییر بده.اگر
array[mid]بزرگتر از هدف بود، هدف باید در نیمهی چپ باشد، پسhighرا بهmid - 1تغییر بده.این کار را تکرار کن تا
lowازhighبزرگتر شود (یعنی دیگر بازهای برای جستجو نمانده) یا هدف پیدا شود.
مثال دستی مرحلهبهمرحله
آرایهی مرتب: [5, 8, 12, 15, 20, 25, 30] (اندیسهای 0 تا 6)، هدف: 20
مرحله ۱: low=0, high=6, mid=(0+6)/2=3 → array[3]=15
         15 < 20 → هدف در نیمه راست → low = mid + 1 = 4

مرحله ۲: low=4, high=6, mid=(4+6)/2=5 → array[5]=25
         25 > 20 → هدف در نیمه چپ → high = mid - 1 = 4

مرحله ۳: low=4, high=4, mid=(4+4)/2=4 → array[4]=20
20 = 20 ✓ پیدا شد در اندیس 4Pseudocode
function BINARY_SEARCH(array, n, target):
    low ← 0
    high ← n - 1

    while low ≤ high:
        mid ← low + (high - low) / 2

        if array[mid] = target:
            return mid
        else if array[mid] < target:
            low ← mid + 1
        else:
            high ← mid - 1

return NOT_FOUNDFlowchart
Implementation در C
%%writefile src/p05_c12_02_binary_search.c

#include <stdio.h>

int binarySearch(int arr[], int n, int target)
{
    int low = 0;
    int high = n - 1;

    while (low <= high) {
        int mid = low + (high - low) / 2;

        if (arr[mid] == target) {
            return mid;
        } else if (arr[mid] < target) {
            low = mid + 1;
        } else {
            high = mid - 1;
        }
    }

    return -1;
}

int main(void)
{
    int scores[] = {5, 8, 12, 15, 20, 25, 30};
    int n = sizeof(scores) / sizeof(scores[0]);

    int result = binarySearch(scores, n, 20);

    if (result != -1) {
        printf("Found at index %d\n", result);
    } else {
        printf("Not found\n");
    }

    return 0;
}!gcc -Wall -o bin/p05_c12_02_binary_search src/p05_c12_02_binary_search.c && ./bin/p05_c12_02_binary_searchFound at index 4
تحلیل کد
چرا mid = low + (high - low) / 2 و نه mid = (low + high) / 2؟
این دو عبارت از نظر ریاضی برابرند، اما از نظر پیادهسازی تفاوت مهمی دارند. اگر low و high هر دو اعداد بزرگی باشند، جمع مستقیم low + high در برخی زبانها و در شرایط خاص میتواند از محدودهی مجاز نوع int سرریز (Overflow) کند. نوشتن low + (high - low) / 2 همان مقدار وسط را محاسبه میکند بدون اینکه نیاز باشد دو عدد بزرگ مستقیماً با هم جمع شوند. در این درس لازم نیست وارد جزئیات دقیق Overflow شوید، اما دانستن اینکه این فرم نوشتاری، یک عادت ایمنتر و رایج در کد حرفهای است، ارزشمند است.
حالتهای Edge Case
عنصر اول: برای آرایهی [5, 8, 12, 15, 20] و هدف 5، الگوریتم باید بتواند بازه را آنقدر باریک کند که mid دقیقاً به اندیس 0 برسد.
عنصر آخر: مشابه بالا، اما برای آخرین اندیس.
آرایهی تکعضوی: اگر n = 1، ابتدا low = 0 و high = 0؛ شرط low ≤ high برقرار است، mid هم برابر 0 میشود و تنها عنصر بررسی میشود.
عنصر غیرموجود: برای هدف 100 در آرایهی بالا، بازهی جستجو مرتب باریکتر میشود تا جایی که low از high بزرگتر شود؛ در این لحظه حلقه متوقف شده و -1 بازگردانده میشود.
تعداد زوج و فرد عناصر: توجه کنید فرمول mid = low + (high - low) / 2 مستقل از زوج یا فرد بودن تعداد عناصر درست کار میکند، چون تقسیم صحیح همیشه یک اندیس معتبر بین low و high تولید میکند.
Complexity: چرا O(log n)؟
در هر مرحله از Binary Search، تقریباً نیمی از فضای جستجوی باقیمانده کنار گذاشته میشود. یعنی اگر ابتدا n عنصر برای بررسی داشته باشیم، بعد از یک مرحله حدود n/2 عنصر باقی میماند، بعد از دو مرحله حدود n/4، و به همین ترتیب. سؤال این است: چند بار باید n را نصف کنیم تا به یک عنصر برسیم؟ پاسخ این سؤال دقیقاً همان چیزی است که در ریاضیات با log₂(n) نشان داده میشود. به همین دلیل، زمان اجرای Binary Search در بدترین حالت متناسب با log n است یعنیO(log n)؛ که برای آرایههای بزرگ تفاوت چشمگیری با O(n) دارد. برای مثال، جستجو در آرایهای با یک میلیون عنصر، با Linear Search در بدترین حالت نیازمند یک میلیون مقایسه است، اما با Binary Search حدود ۲۰ مقایسه کافی است.
اما این سرعت، رایگان نیست: Binary Search فقط زمانی قابل استفاده است که آرایه از قبل مرتب باشد؛ اگر داده مرتب نباشد، ابتدا باید هزینهی مرتبسازی (که موضوع فصل بعد است) پرداخت شود.
تمرین درون فصل ۱۲.۳
نوع تمرین: Complexity Reasoning
اگر آرایهای ۱۰۲۴ عنصر داشته باشد، Binary Search در بدترین حالت چند بار مقدار array[mid] را با target مقایسه میکند؟ استدلال خود را بنویسید (راهنمایی: 2^10 = 1024؛ دقت کنید که «تعداد نصفشدنهای بازه» با «تعداد واقعی مقایسهها در حلقه» یکی نیست).
خطاهای رایج در محاسبه mid، low، high
❌ اشتباه: بهروزرسانی نکردن low یا high
while (low <= high) {
    int mid = low + (high - low) / 2;
    if (arr[mid] == target) return mid;
    else if (arr[mid] < target) low = mid;      // باید mid + 1 باشد
    else high = mid;                             // باید mid - 1 باشد
}
چرا اشتباه است؟
اگر low را بهجای mid + 1 برابر mid قرار دهیم، ممکن است بازهی جستجو هرگز کوچک نشود (چون mid میتواند دوباره همان مقدار قبلی را تولید کند) و برنامه وارد حلقهی بینهایت شود.
✅ نسخه صحیح
if (arr[mid] < target) low = mid + 1;
else high = mid - 1;
چرا صحیح است؟
با این تغییر، بازهی [low, high] در هر مرحله واقعاً کوچکتر میشود، چون mid را از بازهی جدید کنار میگذاریم (دیگر نیازی به بررسی دوبارهی آن نیست، چون قبلاً بررسی شده).
تمرین درون فصل ۱۲.۴ : اگر آرایه مرتب نباشد چه میشود؟
نوع تمرین: Explain Why
آرایهی [15, 3, 20, 8, 5] را (که مرتب نیست) در نظر بگیرید و فرض کنید میخواهیم با Binary Search بهدنبال مقدار 8 بگردیم. مراحل الگوریتم را دستی دنبال کنید (low=0, high=4). دقیقاً کدام فرض بنیادین Binary Search اینجا نقض میشود و چرا نتیجهی نهایی نمیتواند قابلاعتماد باشد؟
تمرینهای پایانی زیربخش: Binary Search
★ سطح پایه
Trace بدون اجرا:
برای آرایهی مرتب[2, 5, 9, 14, 20, 27, 33]و هدف27، مقادیرlow،high، وmidرا در هر مرحله (بدون اجرای برنامه) روی کاغذ محاسبه کنید تا هدف پیدا شود.Predict the Output:
برای همان آرایه بالا و هدف1، پیشبینی کنید حلقه چند بار اجرا میشود قبل از اینکه تابع-1برگرداند.
★★ سطح متوسط
Edge Case Trace:
برای آرایهی[4, 8, 15, 16, 23, 42]، Binary Search را برای این سه هدف جداگانه Trace کنید: (الف)4(عنصر اول)، (ب)42(عنصر آخر)، (ج)16(عنصر وسط دقیق).Trace تکعضوی:
برای آرایهی[7](فقط یک عنصر)، Binary Search را برای هدف7و سپس برای هدف3Trace کنید. توضیح دهید چرا در هر دو حالت حلقه حداکثر یک بار اجرا میشود.Find the Bug:
int mid = low + (high - low) / 2;
if (arr[mid] < target) {
    low = mid;          // اشتباه است
}
خطای این کد را پیدا کرده، توضیح دهید چرا منجر به حلقهی بینهایت میشود، و اصلاح کنید.
★★★ سطح چالشی
Complexity Reasoning:
اگر آرایهای ۱۰۰۰۰۰ عنصر داشته باشد، تقریباً چند مقایسه برای Binary Search در بدترین حالت لازم است؟ استدلال خود را با استفاده ازlog₂توضیح دهید و آن را با تعداد مقایسههای Linear Search در بدترین حالت مقایسه کنید.Modify the Algorithm:
تابعbinarySearchرا طوری تغییر دهید که بهجای جستجوی یک مقدار دقیق، کوچکترین عنصری که بزرگتر یا مساوی هدف است را پیدا کند (اگر خود هدف در آرایه نبود). توضیح دهید کدام بخش از منطقlow/high/midباید تغییر کند.Duplicate Values:
اگر آرایهی مرتب[3, 5, 5, 5, 8, 10]باشد و هدف5، Binary Search چه اندیسی را برمیگرداند؟ آیا تضمینی وجود دارد که همیشه اولین وقوع مقدار تکراری برگردانده شود؟ چرا؟Small Implementation:
تابعی به نامbinarySearchBoolبنویسید که با همان منطق Binary Search، بهجای اندیس، فقط یک مقدار Boolean (trueیاfalse) برگرداند که نشان میدهد آیا هدف در آرایهی مرتب وجود دارد یا نه.
12.4 مقایسه Linear Search و Binary Search
انتخاب بین Linear Search و Binary Search فقط به «کدام سریعتر است» ختم نمیشود؛ چند عامل واقعی در این تصمیم دخیلاند. اول اینکه آیا داده از قبل مرتب است یا نه؛ اگر مرتب نیست و بخواهیم از Binary Search استفاده کنیم، باید هزینهی مرتبسازی را هم بهحساب بیاوریم. دوم، حجم داده چقدر است؛ روی چند ده عنصر، تفاوت بین O(n) و O(log n) عملاً قابلحس نیست، اما روی میلیونها عنصر این تفاوت بسیار مهم میشود. سوم، اینکه قرار است جستجو چند بار تکرار شود؛ اگر فقط یکبار جستجو لازم است، معمولاً هزینهی مرتبسازی یک آرایهی نامرتب فقط برای همان یک جستجو بهصرفه نیست. چهارم، آیا هزینهی مرتبسازی اولیه (از نظر زمان اجرا و پیچیدگی برنامه) قابل قبول است؟ و پنجم، آیا داده در آینده هم مرتب باقی میماند یا هر بار دادهی جدید و نامرتب به آن اضافه میشود؟ اگر داده مرتب بماند و بارها جستجو شود، هزینهی مرتبسازی فقط یکبار پرداخت میشود و Binary Search بارها سود میدهد؛ اما اگر داده مدام تغییر کند و نامرتب باقی بماند، این معادله میتواند برعکس شود.
| ویژگی | Linear Search | Binary Search |
|---|---|---|
| نیاز به مرتب بودن آرایه | خیر | بله |
| Complexity بدترین حالت | O(n) | O(log n) |
| سادگی پیادهسازی | بسیار ساده | نیازمند دقت بیشتر |
| مناسب برای | دادهی نامرتب یا کوچک | دادهی مرتب و بزرگ |
نکتهی مهم: سریعتر بودن Binary Search فقط زمانی معنا دارد که هزینهی مرتبسازی از قبل پرداخت شده باشد یا داده بهطور طبیعی مرتب تولید شود. اگر قرار است فقط یکبار جستجو انجام شود روی دادهای که مرتب نیست، مرتبسازی آن فقط برای یک جستجو معمولاً بهصرفه نیست؛ اما اگر قرار است بارها روی همان مجموعه جستجو انجام شود، مرتبسازی یکبار و سپس استفادهی مکرر از Binary Search بسیار مقرونبهصرفهتر است.
تمرینهای پایانی زیربخش : مقایسه و تصمیمگیری Search
نوع تمرین: Choose the Algorithm
برای هر سناریوی زیر مشخص کنید Linear Search مناسبتر است یا Binary Search، و دلیل بیاورید:
لیستی از ۲۰ نام دانشجو که هر ترم فقط یکبار برای گزارشگیری جستوجو میشود.
پایگاهدادهای مرتب از یک میلیون کد ملی که روزانه هزاران بار جستوجو میشود.
آرایهای از دمای هوا در ۲۴ ساعت گذشته که هنوز مرتب نشده و فقط یکبار برای پیدا کردن بالاترین دما بررسی میشود (راهنمایی: این اصلاً مسئلهی Search نیست؛ چرا؟).
لیستی از شمارههای سریال محصولات که هم مرتب هستند و هم هزاران بار در روز جستوجو میشوند، اما هر روز چند مورد جدید هم به انتهای لیست نامرتب اضافه میشود.
12.5 خطاهای رایج در جستجو (جمعبندی)
استفاده از Binary Search روی آرایهی مرتبنشده. نتیجهی آن غیرقابلاعتماد است، نه لزوماً خطای اجرایی آشکار.
فراموش کردن بررسی مقدار بازگشتی
-1قبل از استفاده از آن بهعنوان اندیس.در Binary Search، بهروزرسانی نادرست
lowیاhighکه منجر به حلقهی بینهایت میشود.
12.6 مسئله مرتبسازی
در بخش قبل دیدیم که Binary Search فقط روی دادهی مرتب کار میکند، و مرتبسازی بهطور کلی برای گزارشگیری، رتبهبندی، و نمایش خواناتر داده هم لازم است. سؤال این است: چگونه یک آرایهی نامرتب را به یک آرایهی مرتب تبدیل کنیم؟ در این بخش سه الگوریتم پایهای را میبینیم که هرکدام از زاویهای متفاوت به این مسئله نگاه میکنند.
12.7 Bubble Sort (مرتبسازی حبابی)
ایده الگوریتم
ایدهی اصلی ساده است: هر دو عنصر مجاور را با هم مقایسه کن؛ اگر به ترتیب اشتباه بودند (بزرگتر قبل از کوچکتر)، جایشان را عوض کن. این کار را روی کل آرایه تکرار کن. با هر بار عبور کامل روی آرایه (که به آن Pass میگویند)، بزرگترین عنصر باقیمانده مثل یک حباب به انتهای آرایه «بالا میآید»؛ از همینجا نام الگوریتم گرفته شده است.
مثال دستی
آرایه: [5, 2, 8, 1]
Pass 1:
  مقایسه 5,2 → 5>2 → جابجا: [2, 5, 8, 1]
  مقایسه 5,8 → 5<8 → بدون تغییر: [2, 5, 8, 1]
  مقایسه 8,1 → 8>1 → جابجا: [2, 5, 1, 8]
  (8 در جای نهایی خود قرار گرفت)

Pass 2:
  مقایسه 2,5 → بدون تغییر: [2, 5, 1, 8]
  مقایسه 5,1 → جابجا: [2, 1, 5, 8]
  (5 در جای نهایی خود قرار گرفت)

Pass 3:
  مقایسه 2,1 → جابجا: [1, 2, 5, 8]
  (2 در جای نهایی خود قرار گرفت)

نتیجه نهایی: [1, 2, 5, 8]
توجه کنید بعد از هر Pass، حداقل یک عنصر بزرگ به انتهای بخش نامرتبمانده میرود، بنابراین در Passهای بعدی نیازی به بررسی دوبارهی آن انتهای مرتبشده نیست.
Pseudocode
function BUBBLE_SORT(array, n):
    for i from 0 to n - 2:
        for j from 0 to n - 2 - i:
            if array[j] > array[j+1]:
swap(array[j], array[j+1])Flowchart
Implementation در C
%%writefile src/p05_c12_03_bubble_sort.c

#include <stdio.h>

void bubbleSort(int arr[], int n)
{
    for (int i = 0; i < n - 1; i++) {
        for (int j = 0; j < n - 1 - i; j++) {
            if (arr[j] > arr[j + 1]) {
                int temp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = temp;
            }
        }
    }
}

void printArray(int arr[], int n)
{
    for (int i = 0; i < n; i++) {
        printf("%d ", arr[i]);
    }
    printf("\n");
}

int main(void)
{
    int scores[] = {18, 15, 20, 12, 17};
    int n = sizeof(scores) / sizeof(scores[0]);

    bubbleSort(scores, n);
    printArray(scores, n);

    return 0;
}!gcc -Wall -o bin/p05_c12_03_bubble_sort src/p05_c12_03_bubble_sort.c && ./bin/p05_c12_03_bubble_sort12 15 17 18 20
تحلیل کد
چرا حلقهی داخلی تا n - 1 - i پیش میرود، نه تا n - 1؟
چون بعد از هر Pass کامل (هر مقدار i)، یکی از عناصر بزرگ به انتهای آرایه رسیده و در جای نهایی خودش قرار گرفته است؛ پس نیازی نیست دوباره آن بخش مرتبشده را بررسی کنیم. این کاهش، الگوریتم را کمی کارآمدتر میکند (هرچند Complexity کلی تغییر نمیکند).
چرا برای جابجایی از یک متغیر موقت (temp) استفاده میکنیم؟
چون بدون آن، هنگام نوشتن arr[j] = arr[j+1]، مقدار اصلی arr[j] از بین میرود و دیگر نمیتوان آن را در arr[j+1] قرار داد.
تمرین درون فصل ۱۲.۵
نوع تمرین: Trace
آرایهی [4, 2, 7, 1] را با Bubble Sort دستی مرتب کنید و وضعیت آرایه را بعد از هر Pass بنویسید.
بهینهسازی با Flag
یک بهبود آموزشی مفید: اگر در یک Pass کامل هیچ جابجایی رخ ندهد، یعنی آرایه از قبل مرتب شده و میتوانیم زودتر متوقف شویم:
void bubbleSortOptimized(int arr[], int n)
{
for (int i = 0; i < n - 1; i++) {
int swapped = 0;
for (int j = 0; j < n - 1 - i; j++) {
if (arr[j] > arr[j + 1]) {
int temp = arr[j];
arr[j] = arr[j + 1];
arr[j + 1] = temp;
swapped = 1;
}
}
if (swapped == 0) {
break; // آرایه از قبل مرتب است، ادامهی حلقه لازم نیست
}
}
}تمرین درون فصل ۱۲.۶ : نسخه معمولی در مقابل نسخه بهینهشده
نوع تمرین: Compare Approaches
آرایهی از قبل مرتب [1, 2, 3, 4, 5] را در نظر بگیرید. تعداد Passهای کامل را برای bubbleSort (نسخهی معمولی بدون swapped) و برای bubbleSortOptimized (نسخهی بهینه با swapped) بهصورت جداگانه مشخص کنید. چرا نسخهی معمولی همچنان تمام Passها را کامل اجرا میکند، در حالیکه نسخهی بهینهشده زودتر متوقف میشود؟
Complexity
در بدترین حالت (آرایهی کاملاً معکوسمرتب)، هیچ جابجایی زودهنگامی رخ نمیدهد و الگوریتم باید همهی Passها را کامل طی کند. در Pass اول n-1 مقایسه انجام میشود، در Pass دوم n-2 مقایسه (چون یک عنصر دیگر در انتها جا افتاده)، و به همین ترتیب تا آخرین Pass که فقط ۱ مقایسه دارد. مجموع کل مقایسهها برابر است با:
(n-1) + (n-2) + ... + 1
که این مجموع با n² متناسب رشد میکند، پس Worst Case برابر O(n²) است. در بهترین حالت (آرایهی از قبل مرتب) با استفاده از نسخهی بهینهشده با Flag، در همان Pass اول هیچ جابجاییای رخ نمیدهد و swapped صفر باقی میماند، پس الگوریتم بعد از همین یک Pass متوقف میشود؛ اما توجه کنید که همان یک Pass هم باید تمام n-1 مقایسهی خودش را انجام دهد تا مطمئن شود جابجاییای لازم نیست؛ پس Best Case برابر O(n) است، نه O(1).
خطاهای رایج
❌ اشتباه: جابجایی بدون متغیر موقت
arr[j] = arr[j + 1];
arr[j + 1] = arr[j];   // arr[j] از قبل بازنویسی شده!
چرا اشتباه است؟
در خط دوم، arr[j] دیگر مقدار اصلی خودش را ندارد، چون در خط اول بازنویسی شده. نتیجه این است که هر دو خانه مقدار یکسانی میگیرند و مقدار اصلی گم میشود.
تمرینهای پایانی زیربخش: Bubble Sort
★ سطح پایه
Trace:
آرایهی[3, 1, 4, 2]را باbubbleSort(نسخهی معمولی) دستی مرتب کنید و وضعیت آرایه را بعد از هر Pass بنویسید.Predict the Output:
برای آرایهی[1, 2, 3, 4](که از قبل مرتب است)، پیشبینی کنیدbubbleSortOptimizedچند بار وارد حلقهی بیرونی میشود قبل از توقف.
★★ سطح متوسط
Find the Bug:
void bubbleSortOptimized(int arr[], int n)
{
    for (int i = 0; i < n - 1; i++) {
        for (int j = 0; j < n - 1 - i; j++) {
            if (arr[j] > arr[j + 1]) {
                int temp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = temp;
            }
        }
    }
}
این تابع ادعا میکند نسخهی بهینهشده با Flag است، اما متغیر swapped را ندارد. توضیح دهید چرا Best Case این نسخه هنوز O(n²) است، نه O(n)، و اصلاح کنید تا واقعاً بهینه شود.
Complexity Reasoning:
برای همان تابع بهینهنشدهی سؤال قبل (بدونswapped)، آیا صحیح است ادعا کنیم Best Case آنO(n)است؟ چرا نه؟
★★★ سطح چالشی
Modify the Algorithm:
تابعbubbleSortرا طوری تغییر دهید که آرایه را بهصورت نزولی (بزرگ به کوچک) مرتب کند.Design:
تابعی بنویسید که با استفاده از منطق مشابه Bubble Sort، فقط بررسی کند که آیا یک آرایه از قبل مرتب است یا نه (بدون مرتب کردن آن) و مقدار1یا0برگرداند.Edge Case:
برای آرایهای با یک عنصر (n = 1)،bubbleSortرا Trace کنید. حلقهی بیرونی چند بار اجرا میشود؟ چرا این رفتار منطقی است؟
12.8 Selection Sort (مرتبسازی انتخابی)
ایده الگوریتم
بهجای مقایسهی مکرر عناصر مجاور، اینبار در هر مرحله کل بخش نامرتب باقیمانده را بررسی میکنیم تا کوچکترین عنصر را پیدا کنیم، و آن را با اولین عنصر بخش نامرتب جابجا میکنیم.
مدل ذهنی این الگوریتم را میتوان اینطور تصور کرد: در هر لحظه، آرایه به دو بخش تقسیم شده است.
[ بخش مرتبشده | بخش نامرتب ]و در هر Pass، این چهار قدم تکرار میشود:
بخش نامرتب باقیمانده را در نظر میگیریم.
کوچکترین عنصر همین بخش را پیدا میکنیم.
آن را با اولین عنصر بخش نامرتب جابجا میکنیم.
آن خانه اکنون بخشی از قسمت مرتبشده است؛ در Pass بعدی فقط بخش نامرتبِ باقیمانده (که یک خانه کوچکتر شده) بررسی میشود.
بهطور خلاصه، Selection Sort در هر Pass مسئلهی خودش را به این شکل حل میکند: پیدا کردن Minimum، بهعلاوهی حداکثر یک Swap.
مثال دستی
آرایه: [5, 2, 8, 1]
Pass 1: بخش نامرتب [5, 2, 8, 1] (اندیس 0 تا 3)
کوچکترین = 1 در اندیس 3
جابجایی arr[0] و arr[3] → [1, 2, 8, 5]
Pass 2: بخش نامرتب [2, 8, 5] (اندیس 1 تا 3)
کوچکترین = 2 در اندیس 1 (از قبل در جای درست)
جابجایی arr[1] و arr[1] → [1, 2, 8, 5]
Pass 3: بخش نامرتب [8, 5] (اندیس 2 تا 3)
کوچکترین = 5 در اندیس 3
جابجایی arr[2] و arr[3] → [1, 2, 5, 8]
نتیجه نهایی: [1, 2, 5, 8]مفهوم min_index
در هر Pass، بهجای جابجایی فوری هر بار که عنصر کوچکتری دیدیم، ابتدا فقط اندیس کوچکترین عنصر دیدهشده تا این لحظه را در متغیری به نام min_index نگه میداریم، و فقط در پایان هر Pass، یک جابجایی واحد انجام میدهیم.
Pseudocode
function SELECTION_SORT(array, n):
    for i from 0 to n - 2:
        min_index ← i
        for j from i + 1 to n - 1:
            if array[j] < array[min_index]:
                min_index ← j
swap(array[i], array[min_index])Flowchart
Implementation در C
%%writefile src/p05_c12_04_selection_sort.c

#include <stdio.h>

void selectionSort(int arr[], int n)
{
    for (int i = 0; i < n - 1; i++) {
        int min_index = i;

        for (int j = i + 1; j < n; j++) {
            if (arr[j] < arr[min_index]) {
                min_index = j;
            }
        }

        int temp = arr[i];
        arr[i] = arr[min_index];
        arr[min_index] = temp;
    }
}

int main(void)
{
    int scores[] = {18, 15, 20, 12, 17};
    int n = sizeof(scores) / sizeof(scores[0]);

    selectionSort(scores, n);

    for (int i = 0; i < n; i++) {
        printf("%d ", scores[i]);
    }
    printf("\n");

    return 0;
}!gcc -Wall -o bin/p05_c12_04_selection_sort src/p05_c12_04_selection_sort.c && ./bin/p05_c12_04_selection_sort12 15 17 18 20
تحلیل کد
چرا حلقهی داخلی از i + 1 شروع میشود، نه از i؟
چون خود arr[i] را از قبل بهعنوان کاندیدای اولیهی کوچکترین مقدار در min_index قرار دادهایم؛ مقایسهی آن با خودش بیفایده است.
چرا جابجایی فقط یکبار در انتهای هر Pass انجام میشود (برخلاف Bubble Sort)؟
چون در طول حلقهی داخلی فقط اندیس بهترین کاندیدا را بهروزرسانی میکنیم، نه محتوای آرایه را؛ تعداد جابجاییهای واقعی معمولاً کم است (جزئیات مقایسه با Bubble Sort را در بخش بعد میبینید).
در این پیادهسازی، ممکن است وقتی min_index == i است، یک self-swap بیاثر انجام شود؛ یعنی عنصر عملاً با خودش جابهجا میشود. برای جلوگیری از این کار میتوان پیش از جابجایی نوشت if (min_index != i).
تمرین درون فصل ۱۲.۷
نوع تمرین: Complete the Code
تابع selectionSort را طوری تغییر دهید که آرایه را بهصورت نزولی (بزرگ به کوچک) مرتب کند.
مقایسه با Bubble Sort
هر دو الگوریتم از نظر تعداد مقایسهها O(n²) هستند، اما Selection Sort معمولاً جابجاییهای کمتری انجام میدهد، چون در هر Pass حداکثر یک جابجایی دارد در حالی که Bubble Sort میتواند در هر Pass چندین جابجایی داشته باشد. این تفاوت زمانی اهمیت پیدا میکند که هزینهی جابجایی (نه مقایسه) گران باشد.
Complexity
مستقل از اینکه آرایه از قبل مرتب باشد یا کاملاً معکوس، Selection Sort همیشه تمام مقایسههای ممکن را انجام میدهد (چون برای پیدا کردن کوچکترین عنصر باقیمانده، باید کل بخش نامرتب را بررسی کند)؛ به همین دلیل Best Case، Average Case و Worst Case آن همگی O(n²) هستند، برخلاف Bubble Sort که در بهترین حالت میتواند به O(n) برسد.
خطاهای رایج
❌ اشتباه: جابجایی داخل حلقهی داخلی بهجای بعد از آن
for (int j = i + 1; j < n; j++) {
    if (arr[j] < arr[min_index]) {
        int temp = arr[i];      // جابجایی زودهنگام و اشتباه
        arr[i] = arr[j];
        arr[j] = temp;
        min_index = j;
    }
}
چرا اشتباه است؟
این کد در هر بار پیدا شدن یک مقدار کوچکتر بلافاصله جابجایی انجام میدهد، که اصلاً ایدهی Selection Sort را نقض میکند (که باید فقط یک جابجایی در پایان هر Pass داشته باشد) و منجر به نتیجهی نادرست میشود.
تمرین درون فصل ۱۲.۸ : چرا فقط عناصر مجاور جابجا نمیشوند؟
نوع تمرین: Explain Why
در Bubble Sort، هر جابجایی فقط بین دو عنصر مجاور رخ میدهد. اما در Selection Sort، swap(array[i], array[min_index]) میتواند دو عنصری را جابجا کند که فاصلهی زیادی از هم دارند. برای آرایهی [8, 1, 6, 3]، Pass اول را دستی اجرا کنید و توضیح دهید چرا Selection Sort الزاماً عناصر مجاور را جابجا نمیکند.
تمرینهای پایانی زیربخش: Selection Sort
★ سطح پایه
Trace:
آرایهی[6, 3, 9, 1]را با Selection Sort دستی مرتب کنید. در هر Pass، مقدارiوmin_indexو وضعیت آرایهی بعد از جابجایی را بنویسید.Predict the Output:
برای آرایهی[5, 5, 5](همه عناصر برابر)، پیشبینی کنید Selection Sort چند جابجایی واقعی (نه مقایسه) انجام میدهد.
★★ سطح متوسط
Complexity Reasoning:
توضیح دهید چرا Selection Sort حتی روی آرایهی از قبل مرتبشده هم دقیقاً به همان تعداد مقایسه نیاز دارد که روی آرایهی کاملاً معکوس نیاز دارد.Explain Why (نه لزوماً یک Bug):
for (int i = 0; i < n; i++) {          // آیا این حلقه اشتباه است؟
    int min_index = i;
    for (int j = i + 1; j < n; j++) {
        if (arr[j] < arr[min_index]) min_index = j;
    }
    ...
}
اگر حلقهی بیرونی تا n (بهجای n - 1) پیش برود، در آخرین iteration (وقتی i = n - 1) چه اتفاقی میافتد؟ آیا این باعث دسترسی خارج از محدوده (مثل arr[n]) میشود، یا نتیجهی نهایی اشتباه میشود، یا فقط یک iteration اضافه و بیفایده انجام میشود؟ (راهنمایی: در آخرین iteration، حلقهی داخلی از j = n شروع میشود؛ آیا اصلاً وارد بدنهی حلقه میشود؟)
★★★ سطح چالشی
Compare Approaches:
برای آرایهی[9, 8, 7, 6, 5]، تعداد جابجاییهای واقعی Bubble Sort (نسخهی معمولی) را با تعداد جابجاییهای Selection Sort مقایسه کنید. کدامیک جابجایی کمتری دارد؟Modify the Algorithm:
تابع Selection Sort را طوری تغییر دهید که بهجای پیدا کردن کوچکترین عنصر باقیمانده، بزرگترین را پیدا کند و در انتهای بخش نامرتب قرار دهد (یعنی آرایه را از سمت انتها مرتب کند).
12.9 Insertion Sort (مرتبسازی درجی)
ایده الگوریتم و مثال «کارتها در دست»
تصور کنید در حال مرتب کردن دستهای از کارتهای بازی در دست خود هستید. کارتها را یکییکی از روی میز برمیدارید؛ هر کارت جدید را در جای درست بین کارتهای از قبل مرتبشده در دستتان قرار میدهید. این دقیقاً همان ایدهی Insertion Sort است: آرایه را به دو بخش تصور کن؛ بخش مرتبشده (سمت چپ) و بخش نامرتب (سمت راست). هر بار اولین عنصر بخش نامرتب را بردار (به آن key میگوییم) و آن را در جای مناسبش در بخش مرتبشده قرار بده.
مثال دستی
آرایه: [5, 2, 8, 1]
شروع: بخش مرتب [5] | بخش نامرتب [2, 8, 1]

Pass 1: key = 2
        2 < 5 → 5 را یک خانه به راست جابجا کن
        2 را در اندیس 0 قرار بده
        نتیجه: [2, 5, 8, 1]

Pass 2: key = 8
        8 > 5 → جابجایی لازم نیست
        نتیجه: [2, 5, 8, 1]

Pass 3: key = 1
        1 < 8 → 8 را جابجا کن
        1 < 5 → 5 را جابجا کن
        1 < 2 → 2 را جابجا کن
        1 را در اندیس 0 قرار بده
نتیجه: [1, 2, 5, 8]Pseudocode
function INSERTION_SORT(array, n):
    for i from 1 to n - 1:
        key ← array[i]
        j ← i - 1
        while j ≥ 0 and array[j] > key:
            array[j+1] ← array[j]
            j ← j - 1
array[j+1] ← keyFlowchart
Implementation در C
%%writefile src/p05_c12_05_insertion_sort.c
#include <stdio.h>

void insertionSort(int arr[], int n)
{
    for (int i = 1; i < n; i++) {
        int key = arr[i];
        int j = i - 1;

        while (j >= 0 && arr[j] > key) {
            arr[j + 1] = arr[j];
            j--;
        }

        arr[j + 1] = key;
    }
}

int main(void)
{
    int scores[] = {18, 15, 20, 12, 17};
    int n = sizeof(scores) / sizeof(scores[0]);

    insertionSort(scores, n);

    for (int i = 0; i < n; i++) {
        printf("%d ", scores[i]);
    }
    printf("\n");

    return 0;
}!gcc -Wall -o bin/p05_c12_05_insertion_sort src/p05_c12_05_insertion_sort.c && ./bin/p05_c12_05_insertion_sort12 15 17 18 20
تحلیل کد
چرا حلقهی بیرونی از i = 1 شروع میشود، نه از i = 0؟
چون یک آرایهی تکعنصری (arr[0] بهتنهایی) همیشه «مرتب» محسوب میشود؛ پس بخش مرتبشده را با همان یک عنصر شروع میکنیم و از عنصر دوم (اندیس ۱) به بعد است که باید تصمیم بگیریم آن را کجا قرار دهیم. چرا شرط while هم j >= 0 و هم arr[j] > key را با عملگر && بررسی میکند؟
این یک نکتهی بسیار مهم دربارهی ترتیب ارزیابی در C است: عملگر && از چپ به راست ارزیابی میشود و اگر شرط اول (j >= 0) نادرست باشد، شرط دوم اصلاً بررسی نمیشود (Short-Circuit Evaluation). این یعنی وقتی j به -1 میرسد (یعنی به ابتدای آرایه رسیدهایم)، کد هرگز تلاش نمیکند arr[-1] را بخواند؛ که یک دسترسی خارج از محدوده و خطرناک بود. خود مقدار j == -1 مشکلی ندارد؛ مشکل زمانی ایجاد میشود که از j بهعنوان اندیس آرایه استفاده کنیم. اگر ترتیب این دو شرط برعکس میشد (arr[j] > key && j >= 0)، در همان لحظه که j برابر -1 است، ابتدا arr[j] ارزیابی میشد که یک خطای جدی بود.
تمرین درون فصل ۱۲.۹
نوع تمرین: Explain the Reason
توضیح دهید چرا در شرط while (j >= 0 && arr[j] > key)، ترتیب دو عبارت اهمیت دارد و نمیتوان جای آنها را عوض کرد.
Complexity
بدترین حالت: اگر آرایه کاملاً معکوسمرتب باشد، هر عنصر جدید باید تا ابتدای بخش مرتبشده جابجا شود، که در مجموع متناسب با n² است یعنی O(n²). بهترین حالت: اگر آرایه از قبل کاملاً مرتب باشد، برای هر عنصر جدید، شرط arr[j] > key در همان اولین بررسی نادرست است (چون عنصر قبلی از key کوچکتر یا مساوی است)؛ در نتیجه بدنهی حلقهی while اصلاً اجرا نمیشود و هیچ Shiftای رخ نمیدهد. چون همین یک بررسی برای هر یک از n عنصر تکرار میشود، مجموع کار متناسب با n رشد میکند، یعنی O(n).
چرا Insertion Sort برای دادهی تقریباً مرتب مناسب است؟
وقتی داده از قبل تقریباً مرتب است (مثلاً فقط چند عنصر جابهجا شدهاند)، هر key جدید فاصلهی کمی تا جایگاه درست خودش دارد، پس حلقهی while داخلی خیلی زود متوقف میشود. این ویژگی باعث میشود Insertion Sort در عمل برای این نوع داده بسیار سریعتر از پیچیدگی نظری O(n²) عمل کند؛ برخلاف Selection Sort که همیشه، حتی روی دادهی تقریباً مرتب، تمام مقایسهها را انجام میدهد.
خطاهای رایج
❌ اشتباه: فراموش کردن کاهش j
while (j >= 0 && arr[j] > key) {
    arr[j + 1] = arr[j];
    // فراموش شده: j--;
}
چرا اشتباه است؟
بدون j--، مقدار j هرگز تغییر نمیکند و شرط حلقه همیشه برقرار میماند، که منجر به حلقهی بینهایت میشود.
تمرین درون فصل ۱۲.۱۰ : Shift در مقابل Swap
نوع تمرین: Explain Why
در Insertion Sort، خط arr[j + 1] = arr[j]; یک shift است، نه یک swap کامل مثل آنچه در Bubble Sort یا Selection Sort دیدیم. توضیح دهید تفاوت مفهومی بین «جابجایی دو مقدار با استفاده از یک متغیر موقت (swap)» و «انتقال یک مقدار به یک خانهی مجاور بدون بازگرداندن آن (shift)» چیست. چرا Insertion Sort برخلاف Bubble/Selection Sort به یک متغیر temp جداگانه برای هر جابجایی نیاز ندارد؟
تمرین درون فصل ۱۲.۱۱ : بخش مرتب و نامرتب بعد از هر Iteration
نوع تمرین: Trace
برای آرایهی [6, 2, 9, 4]، بعد از هر iteration حلقهی بیرونی Insertion Sort (یعنی بعد از هر Pass)، مشخص کنید:
بخش sorted آرایه (سمت چپ) شامل چه مقادیری است؟
بخش unsorted آرایه (سمت راست) شامل چه مقادیری است؟
تمرینهای پایانی زیربخش : Insertion Sort
★ سطح پایه
Trace:
آرایهی[4, 1, 5, 2]را با Insertion Sort دستی مرتب کنید و مقدارkeyرا در هر Pass بنویسید.Predict the Output:
برای آرایهی[1, 2, 3, 4, 5](از قبل مرتب)، پیشبینی کنید حلقهیwhileداخلی در هر Pass چند بار اجرا میشود.
★★ سطح متوسط
Find the Bug:
for (int i = 1; i < n; i++) {
    int key = arr[i];
    int j = i - 1;
    while (arr[j] > key && j >= 0) {   // ترتیب اشتباه!
        arr[j + 1] = arr[j];
        j--;
    }
    arr[j + 1] = key;
}
خطای این کد را پیدا کنید. برای چه ورودیای این خطا خودش را نشان میدهد و چرا خطرناک است؟
Complexity Reasoning:
توضیح دهید چرا Insertion Sort روی آرایهای که فقط یک عنصر جای اشتباه دارد (بقیه کاملاً مرتب هستند)، در عمل بسیار نزدیک بهO(n)عمل میکند، نهO(n²).
★★★ سطح چالشی
Design:
تابع Insertion Sort را طوری تغییر دهید که آرایه را بهصورت نزولی مرتب کند.Compare Approaches:
برای آرایهی تقریباً مرتب[1, 2, 4, 3, 5](فقط دو عنصر جابهجا شدهاند)، تعداد جابجاییهای (shift) واقعی Insertion Sort را با تعداد مقایسههای Selection Sort روی همان آرایه مقایسه کنید. کدام الگوریتم روی این ورودی خاص کار کمتری انجام میدهد؟
12.10 مقایسه الگوریتمهای مرتبسازی
یک آرایه، سه نگاه متفاوت
پیش از مقایسهی انتزاعی، بیایید ببینیم هر سه الگوریتم روی یک آرایهی مشترک در همان اولین مرحله دقیقاً به چه چیزی «فکر میکنند». آرایه: [5, 2, 4, 1]
| الگوریتم | در اولین Pass چه اتفاقی میافتد؟ | نتیجهی قابل مشاهده |
|---|---|---|
| Bubble Sort | فقط به دو همسایهی کنار هم نگاه میکند: 5 و 2 → جابجا؛ سپس 5 و 4 → جابجا؛ سپس 5 و 1 → جابجا | بعد از Pass 1: [2, 4, 1, 5] ← فقط بزرگترین عنصر به جای نهایی رسید |
| Selection Sort | کل آرایه را نگاه میکند تا کوچکترین را پیدا کند: 1 در اندیس 3؛ فقط یک جابجایی: arr[0] و arr[3] | بعد از Pass 1: [1, 2, 4, 5] ← کوچکترین عنصر به جای نهایی رسید |
| Insertion Sort | فقط به عنصر دوم (2) نگاه میکند و آن را در بخش مرتبشدهی [5] جای میدهد | بعد از Pass 1: [2, 5, 4, 1] ← فقط دو عنصر اول با هم مرتب شدند |
این مقایسه یک تفاوت مفهومی مهم را نشان میدهد: Bubble Sort در هر Pass چند جابجایی محلی انجام میدهد و یک عنصر بزرگ را به انتها میفرستد؛ Selection Sort کل بخش نامرتب را میبیند اما فقط یک جابجایی انجام میدهد؛ Insertion Sort فقط داخل بخش مرتبشده کار میکند و آن را قدمبهقدم بزرگتر میکند. سه الگوریتم، سه استراتژی کاملاً متفاوت برای رسیدن به همان مقصد.
| Algorithm | ایده اصلی | Best | Average | Worst | Stable | In-place |
|---|---|---|---|---|---|---|
| Bubble Sort | مقایسه و جابجایی عناصر مجاور | O(n) | O(n²) | O(n²) | بله | بله |
| Selection Sort | پیدا کردن کوچکترین و جابجایی با ابتدای بخش نامرتب | O(n²) | O(n²) | O(n²) | خیر | بله |
| Insertion Sort | قرار دادن هر عنصر در جای درست در بخش مرتبشده | O(n) | O(n²) | O(n²) | بله | بله |
توضیحات جدول: منظور از Stable این است که آیا عناصر با مقدار برابر، ترتیب نسبی اصلی خود را نسبت به هم حفظ میکنند یا نه. در پیادهسازی معمول مورد بحث در این فصل، Bubble Sort و Insertion Sort پایدارند چون هرگز دو عنصر برابر را از هم عبور نمیدهند؛ Selection Sort معمولاً پایدار نیست، چون به دلیل جابجایی مستقیم میتواند این ترتیب را بههم بزند. منظور از In-place این است که آیا الگوریتم به حافظهی کمکی قابلتوجهی (غیر از چند متغیر ساده) نیاز دارد یا نه؛ هر سه الگوریتم اینجا In-place هستند، چون مرتبسازی را مستقیماً درون همان آرایهی ورودی انجام میدهند.
چرا این تفاوتها وجود دارند؟
هر سه الگوریتم در بدترین حالت O(n²) هستند، اما رفتار آنها با دادهی واقعی متفاوت است چون استراتژی متفاوتی برای رسیدن به آرایهی مرتب دارند: Bubble Sort عناصر را قدمبهقدم و محلی جابهجا میکند؛ Selection Sort در هر Pass بهترین انتخاب ممکن را با هزینهی جستجوی کامل بخش نامرتب پیدا میکند؛ Insertion Sort با فرض اینکه بخش مرتبشده از قبل درست است، فقط محل درست عنصر جدید را پیدا میکند.
چه الگوریتمی برای چه شرایطی مناسبتر است؟
اگر داده تقریباً مرتب است، Insertion Sort بهترین انتخاب عملی است. اگر هزینهی جابجایی (نه مقایسه) گران است (مثلاً جابجایی رکوردهای بزرگ)، Selection Sort با تعداد جابجایی کمترش مناسبتر است. Bubble Sort عمدتاً برای اهداف آموزشی و درک مفهوم مرتبسازی ارزشمند است و در عمل کمتر از دو الگوریتم دیگر استفاده میشود.
باید بین تعداد دفعات اجرای عملیات swap و تعداد جابهجاییهای واقعی بین دو موقعیت متفاوت تفاوت قائل شویم؛ وقتی min_index == i باشد، swap میتواند self-swap باشد و جابهجایی واقعی رخ نمیدهد.
چرا «سریعتر بودن» فقط به اسم الگوریتم مربوط نیست؟
نام یک الگوریتم بهتنهایی رفتار آن روی دادهی خاص شما را تضمین نمیکند. الگوریتمی که از نظر نظری O(n²) است (مثل Insertion Sort) میتواند روی دادهی تقریباً مرتب بسیار سریعتر از یک الگوریتم دیگر با همان مرتبهی نظری عمل کند. به همین دلیل، شناخت ویژگیهای دادهی واقعی (مرتب بودن نسبی، اندازه، هزینهی مقایسه در مقابل جابجایی) بهاندازهی شناخت خود الگوریتم اهمیت دارد.
تعداد گامهای 'تغییر در آرایه' (نه تعداد مقایسهها):
Bubble Sort : 6
Selection Sort : 2
Insertion Sort : 9
12.11 کاربردهای واقعی جستجو و مرتبسازی
جستجوی سریع در پایگاهدادههای مرتب (مثل جستجوی کد ملی یا شماره دانشجویی).
رتبهبندی (Ranking) نتایج مسابقات یا امتحانات.
تولید گزارشهای مرتبشده بر اساس تاریخ، نام، یا مقدار.
آمادهسازی داده برای Binary Search.
نمایش خواناتر داده به کاربر نهایی (مثلاً فهرست دانشجویان به ترتیب حروف الفبا).
تمرینهای پایانی فصل ۱۲
توجه: این تمرینها با آنچه در متن و در تمرینهای زیربخش دیدید تفاوت دارند، عمق یا ترکیب بیشتری میطلبند، و جستجو و مرتبسازی را با هم پوشش میدهند.
Complete the Code:
تابعbinarySearchرا طوری تغییر دهید که علاوه بر اندیس، تعداد مقایسههای انجامشده را هم برگرداند (با یک پارامتر اشارهگر خروجی).Algorithm Design:
تابعی بنویسید که آرایهای از نمرات را دریافت کند و بدون اینکه بدانیم مرتب است یا نه، ابتدا بررسی کند آرایه مرتب است یا خیر و سپس بر اساس نتیجه، از Linear Search یا Binary Search استفاده کند.Find the Bug:
int binarySearch(int arr[], int n, int target)
{
    int low = 0, high = n;   // اشتباه: باید n - 1 باشد
    while (low <= high) {
        int mid = low + (high - low) / 2;
        if (arr[mid] == target) return mid;
        else if (arr[mid] < target) low = mid + 1;
        else high = mid - 1;
    }
    return -1;
}
خطای این کد را پیدا کنید. برای چه ورودیای این خطا خودش را بهصورت یک دسترسی خارج از محدوده نشان میدهد؟
Compare Approaches:
فرض کنید یک آرایهی نامرتب با ۵۰ عنصر داریم و باید ۳ بار روی آن جستجو کنیم. آیا مرتب کردن آرایه (با هزینهیO(n log n)یا حتیO(n²)) و سپس استفاده از Binary Search سهبار، از سهبار اجرای مستقیم Linear Search سریعتر است؟ استدلال کنید (بدون نیاز به محاسبهی دقیق عددی).Trace ترکیبی:
آرایهی[9, 3, 6, 1, 8]را با هر سه الگوریتم (Bubble، Selection، Insertion) بهصورت جداگانه دستی مرتب کنید و مراحل هرکدام را بنویسید. مشخص کنید در هر الگوریتم، بعد از Pass اول چه بخشی از آرایه «تثبیت» شده است.Compare on Reversed Input:
آرایهی معکوسمرتب[10, 8, 6, 4, 2]را در نظر بگیرید. برای هرکدام از سه الگوریتم، تخمین بزنید کدامیک بیشترین تعداد جابجایی را انجام میدهد و کدامیک کمترین را. دلیل بیاورید.Compare on Near-Sorted Input:
آرایهی تقریباً مرتب[1, 2, 3, 5, 4]را در نظر بگیرید. توضیح دهید چرا Insertion Sort روی این ورودی بسیار سریعتر از Selection Sort عمل میکند، در حالیکه هر دو از نظر نظریO(n²)هستند.Explain Why:
توضیح دهید چرا Selection Sort حتی روی آرایهی از قبل مرتبشده همO(n²)مقایسه انجام میدهد، اما Insertion Sort در همین حالتO(n)است.Refactoring:
تابعbubbleSortرا طوری بازنویسی کنید که بهجای مرتبسازی صعودی، آرایه را نزولی مرتب کند.Design:
تصور کنید دادهی ورودی شما همیشه «تقریباً مرتب» است (مثلاً فهرست روزانهی دما که هر روز فقط کمی تغییر میکند). کدام یک از سه الگوریتم را برای این کاربرد توصیه میکنید؟ چرا؟
Retrieval Practice فصل ۱۲
بدون نگاه به متن، توضیح دهید چرا Binary Search روی آرایهی نامرتب قابلاستفاده نیست.
چرا مقدار بازگشتی
-1برای «پیدا نشد» انتخاب میشود؟بدون نگاه به متن، ایدهی اصلی هرکدام از سه الگوریتم مرتبسازی را در یک جمله توضیح دهید.
چرا Insertion Sort برای دادهی تقریباً مرتب مناسبتر از Selection Sort است؟
چرا معمولاً قبل از استفاده از Binary Search، باید یکبار هزینهی مرتبسازی پرداخت شود؟
چرا Selection Sort، برخلاف Bubble Sort، در بهترین حالت هم نمیتواند به
O(n)برسد؟
فصل ۱۳ : Strings (رشتهها در C)
13.1 Character Array
تا اینجا با آرایههایی از نوع int کار کردهایم. اما در سیستم مدیریت نمرات، علاوه بر نمرات، به نام دانشجویان هم نیاز داریم؛ یعنی دادهای متنی. سؤال این است: زبان C چگونه یک رشتهی متنی مثل "Ali" را نگه میدارد؟
String بهطور کلی چیست؟
پیش از پرداختن به C، بهتر است مفهوم String را در حالت کلی روشن کنیم. String یعنی یک دنباله از کاراکترها؛ مثلاً نام یک شخص، یک جمله، یا هر متنی که از کنار هم قرار گرفتن چند کاراکتر ساخته شده باشد. این یک مفهوم عمومی در برنامهنویسی است، نه مختص یک زبان خاص.
نکتهی مهم این است که هر زبان برنامهنویسی، String را به روش خودش نمایش میدهد. برخی زبانها (مثل Python یا Java) یک نوع دادهی مستقل و آماده به نام String دارند که جزئیات نگهداری کاراکترها را از دید برنامهنویس پنهان میکند. C اینطور نیست.
C String دقیقاً چیست؟
پاسخ برای C این است: C نوع دادهی مستقلی به نام String ندارد. آنچه در C بهعنوان رشته به کار میرود، یک قرارداد مشخص است، نه یک نوع دادهی جدید. تعریف دقیق آن به این صورت است:
یک دنبالهی متوالی از کاراکترها که با کاراکتر
'\0'پایان مییابد.
این دنباله معمولاً در یک آرایه از نوع char ذخیره میشود؛ یعنی همان مفهومی که در فصل ۱۱ یاد گرفتیم (آرایه، اندیس، پیمایش) عیناً برای رشته هم صدق میکند، با این تفاوت که علاوه بر نوع عناصر (char بهجای int)، یک قرارداد اضافه هم باید رعایت شود: وجود '\0' در انتها. به همین دلیل باید دقیق بود و نگفت «String در C همان char array است»؛ عبارت درستتر این است:
در C نوع دادهی مستقلی به نام String وجود ندارد؛ یک C String یک دنبالهی کاراکتری است که با
'\0'پایان مییابد و معمولاً در یکchar arrayذخیره میشود.
یک Character، یک Character Array، و یک C String
این سه مورد را با هم مقایسه میکنیم، چون دانشجویان تازهکار معمولاً آنها را با هم اشتباه میگیرند:
char c = 'A';                       // (۱) فقط یک کاراکتر تنها - اصلاً String نیست
char a[3] = {'A', 'l', 'i'};        // (۲) یک آرایه از char - اما C String معتبر نیست
char s[] = "Ali";                   // (۳) یک آرایه از char که یک C String معتبر است
(۱)
cفقط یک مقدار از نوعcharاست؛ یک کاراکتر تنها، نه یک رشته.(۲)
aیک آرایه از سهcharاست، اما چون هیچ'\0'ـی در آن قرار نگرفته، C String معتبر نیست. توابعی مثلprintf("%s", ...)یاstrlenروی چنین آرایهای رفتار درستی نخواهند داشت، چون نمیدانند کجا باید متوقف شوند.(۳)
sنیز یک آرایه ازcharاست، اما کامپایلر هنگام مقداردهی با"Ali"بهصورت خودکار یک'\0'در انتهای آن قرار میدهد؛ یعنی محتوای واقعی آن'A','l','i','\0'است. به همین دلیلsیک C String معتبر را در خود نگه میدارد.
این مقایسه یک اصل مهم را نشان میدهد:
هر C String را میتوان در قالب یک دنباله از
charها ذخیره کرد، اما هرchar arrayلزوماً C String نیست. شرط لازم برای C String بودن، وجود'\0'در انتهای دنبالهی معتبر کاراکترهاست.
String Literal چیست؟
عبارتی مثل "Ali" (داخل دابلکوتیشن) یک String Literal نامیده میشود و کاملاً با 'A' (داخل تککوتیشن) که یک مقدار تنهای char است، تفاوت دارد:
'A' // یک مقدار از نوع char
"Ali" // یک String Literal - یعنی متنی که قرار است بهصورت C String نمایش داده شودوقتی مینویسیم:
char name[] = "Ali";کامپایلر این String Literal را در قالب یک آرایهی char ذخیره میکند و بهصورت خودکار یک '\0' هم در انتهای آن اضافه میکند:
Index:    0    1    2    3
        ┌────┬────┬────┬────┐
        │ A  │ l  │ i  │\0  │
        └────┴────┴────┴────┘
وجود همین '\0' است که این آرایه را از یک char array معمولی به یک C String معتبر تبدیل میکند؛ این کاراکتر پایانی بخش جداییناپذیر قرارداد C String است.
تمرین درون فصل ۱۳.۱ : کدامیک C String معتبر است؟
نوع تمرین: Explain Why
char a[3] = {'A', 'l', 'i'};
char b[] = "Ali";کدامیک از این دو آرایه یک C String معتبر است؟ چرا؟ (راهنمایی: به تفاوت محتوای واقعی دو آرایه از نظر وجود یا عدم وجود '\0' فکر کنید.)
13.2 Null Terminator: '\0'
مشکل: آرایه چگونه میداند کجا تمام میشود؟
فرض کنید آرایهای از ۱۰ کاراکتر تعریف کردهایم اما نام دانشجو فقط ۳ حرف دارد (Ali). آرایه هنوز ۱۰ خانه دارد؛ اگر بخواهیم رشته را چاپ کنیم یا طولش را بشماریم، باید بدانیم که رشتهی واقعی در کجا «تمام میشود» و باقی خانهها بخشی از دادهی معتبر نیستند.
راهحل C این است: در پایان هر رشته، یک کاراکتر خاص به نام Null Terminator با نماد '\0' قرار میگیرد که یعنی «رشته اینجا تمام شد».
char name[] = "Ali";از نظر مفهومی، حافظهی این آرایه اینطور است:
Index:     0      1      2      3
        ┌──────┬──────┬──────┬──────┐
Value:  │ 'A'  │ 'l'  │ 'i'  │ '\0' │
        └──────┴──────┴──────┴──────┘
توجه کنید هرچند فقط ۳ حرف در "Ali" نوشته شده، کامپایلر بهصورت خودکار یک خانهی چهارم برای '\0' اضافه میکند. این یعنی آرایهی name در واقع ۴ عنصر دارد، نه ۳؛ نکتهای که هنگام تعیین اندازهی آرایههای کاراکتری باید همیشه در نظر گرفته شود.
چرا '\0' لازم است؟
بدون Null Terminator، هیچ تابعی (مثل printf با %s) نمیداند رشته کجا تمام میشود؛ چنین تابعی باید تا جایی که به '\0' برسد، خانههای حافظه را بخواند. اگر این کاراکتر پایانی وجود نداشته باشد، تابع همچنان به خواندن خانههای بعدی حافظه ادامه میدهد (که ممکن است متعلق به دادهای کاملاً بیربط باشند) تا جایی که بهطور تصادفی یک بایت صفر پیدا کند یا برنامه با خطا متوقف شود.
تفاوت '\0' با '0'
این دو کاملاً متفاوتند و اشتباه گرفتن آنها یکی از رایجترین خطاهای دانشجویان تازهکار است:
'\0'کاراکتر Null است که مقدار عددی آن صفر است (در جدول ASCII).'0'کاراکتر رقمِ صفر است که مقدار عددی آن ۴۸ است (در جدول ASCII).
if (str[i] == '\0') { ... } // بررسی پایان رشته - درست
if (str[i] == '0') { ... } // بررسی اینکه کاراکتر رقم صفر است - کاملاً معنای متفاوتی داردتفاوت '\0' با NULL
این دو نیز مفاهیم متفاوتی هستند: '\0' یک کاراکتر با مقدار صفر است که برای پایان رشته استفاده میشود، در حالی که NULL معمولاً برای نشان دادن اینکه یک اشارهگر به هیچ آدرس معتبری اشاره نمیکند به کار میرود. در این درس با مفهوم اشارهگر و NULL بهطور کامل آشنا نشدهایم؛ همینجا کافیست بدانید این دو مفهوم مربوط به دو موضوع متفاوتند و نباید آنها را بهجای هم استفاده کرد.
ظرفیت آرایه در مقابل طول رشته
یک تمایز کلیدی دیگر: ظرفیت (Capacity) آرایه یعنی چند خانهی حافظه برایش رزرو شده، در حالی که طول (Length) رشته یعنی چند کاراکتر واقعی قبل از '\0' قرار دارد.
char name[20] = "Ali";اینجا ظرفیت آرایه 20 خانه است، اما طول رشته فقط 3 است (کاراکترهای A, l, i؛ '\0' جزو طول محسوب نمیشود). خانههای باقیمانده (اندیس ۴ تا ۱۹) رزرو شدهاند اما بخشی از محتوای معتبر رشته نیستند.
پیمایش رشته تا '\0'
پیش از آنکه سراغ توابع آمادهی کتابخانهای برویم، ارزش دارد ببینیم پیمایش دستی یک رشته دقیقاً چه شکلی است؛ چون هر یک از strlen، strcpy، strcmp و strcat در پسزمینه دقیقاً همین الگو را دنبال میکنند: تا وقتی به '\0' نرسیدهای، جلو برو.
int i = 0;
while (name[i] != '\0') {
    printf("%c\n", name[i]);
    i++;
}
تفاوت این حلقه با پیمایش آرایهی معمولی (فصل ۱۱) این است که شرط توقف دیگر یک عدد ثابت مثل n نیست، بلکه خود داده (رسیدن به '\0') شرط توقف را تعیین میکند. به همین دلیل است که رشته را میتوان بدون دانستن اندازهی دقیق آن از قبل پیمایش کرد. کافیست بدانیم کجا تمام میشود.
طول منطقی رشته (strlen) = 3 | ظرفیت واقعی حافظه (sizeof) = 4 (شامل '\0')
تمرین درون فصل ۱۳.۲ : 'A' در مقابل "A"
نوع تمرین: Spot the Difference
char c = 'A';
char s[] = "A";
تفاوت این دو خط را از نظر نوع داده، اندازهی حافظهی اشغالشده، و معنای مفهومی توضیح دهید. اگر بنویسیم printf("%c", 'A') و printf("%s", "A")، چرا هر دو خروجی یکسان (A) را چاپ میکنند با وجود اینکه از نظر نوع کاملاً متفاوتند؟
13.3 تابع strlen: طول رشته
چه کاری انجام میدهد؟
تابع strlen (از کتابخانهی <string.h>) از ابتدای رشته حرکت میکند و کاراکترها را میشمارد تا به '\0' برسد؛ عدد بازگشتی، همان تعداد کاراکترهای شمردهشده قبل از رسیدن به '\0' است.
%%writefile src/p05_c13_01_strlen.c

#include <stdio.h>
#include <string.h>

int main(void)
{
    char name[] = "Ali";
    printf("%zu\n", strlen(name));   // خروجی: 3

    return 0;
}!gcc -Wall -o bin/p05_c13_01_strlen src/p05_c13_01_strlen.c && ./bin/p05_c13_01_strlen3
چرا '\0' در نتیجه شمرده نمیشود؟
چون strlen معنای «طول رشته» را دقیقاً همان «تعداد کاراکترهای واقعی محتوا» تعریف میکند، نه اندازهی کل حافظهی رزروشده. '\0' فقط یک نشانهی پایانی است، نه بخشی از محتوای رشته.
خطاهای رایج
❌ اشتباه: اشتباه گرفتن strlen با sizeof
char name[20] = "Ali";
printf("%zu\n", sizeof(name));    // 20 → اندازه کل آرایه بر حسب بایت
printf("%zu\n", strlen(name));    // 3  → طول واقعی رشته
چرا مهم است؟
عملگر sizeof روی یک آرایه، اندازهی کل حافظهی رزروشده را برمیگرداند (که در زمان کامپایل مشخص است)، در حالی که strlen باید در زمان اجرا رشته را بخواند تا '\0' را پیدا کند و طول واقعی محتوا را برگرداند. برای یک آرایهی char که یک C String معتبر را در خود نگه میدارد، این دو مقدار زمانی برابرند که آخرین خانهی آرایه '\0' باشد و تمام خانههای قبل از آن بخشی از رشته باشند.
تمرینهای پایانی زیربخش: String پایه و strlen
★ سطح پایه
Predict the Output:
char s[] = "";
printf("%zu\n", strlen(s));
آیا strlen روی یک رشتهی خالی ("") خطا میدهد یا مقدار مشخصی برمیگرداند؟ توضیح دهید چرا.
Predict the Output:
char s[] = "C";
printf("%zu %zu\n", strlen(s), sizeof(s));
خروجی را پیشبینی کرده و دلیل آن را بیان کنید.
★★ سطح متوسط
Small Implementation:
بدون استفاده ازstrlen، تابعی بنویسید که با پیمایش دستی (تا رسیدن به'\0') طول یک رشته را محاسبه کند.Edge Case:
اگر آرایهی کاراکتری بدون'\0'مقداردهی شود (مثلchar name[3] = {'A', 'l', 'i'};که در تمرین ۱۳.۱ دیدید)، فراخوانیstrlen(name)چه رفتاری از خود نشان میدهد؟ چرا نتیجهی این فراخوانی «نامشخص» است، نه لزوماً یک خطای فوری؟
★★★ سطح چالشی
Design:
تابعی بنویسید که یک رشته دریافت کند و بررسی کند آیا رشته یک Palindrome است یا نه (یعنی از دو طرف یکسان خوانده میشود، مثل"radar"). ازstrlenبرای پیدا کردن انتهای رشته استفاده کنید.
13.4 strcpy: کپی کردن رشته
مفهوم Copy: مقصد و مبدأ
تابع strcpy(dest, src) محتوای رشتهی src (مبدأ) را (شامل '\0' پایانی) در dest (مقصد) کپی میکند. از نظر Complexity، strcpy باید تکتک کاراکترهای src را بخواند و بنویسد، پس زمان اجرای آن متناسب با طول رشتهی src است؛ یعنی O(length(src)).
%%writefile src/p05_c13_02_strcpy.c

#include <stdio.h>
#include <string.h>

int main(void)
{
    char source[] = "Ali";
    char destination[20];

    strcpy(destination, source);
    printf("%s\n", destination);

    return 0;
}!gcc -Wall -o bin/p05_c13_02_strcpy src/p05_c13_02_strcpy.c && ./bin/p05_c13_02_strcpyAli
خطر Buffer Overflow
نکتهی بسیار مهم: strcpy هیچ بررسیای روی ظرفیت مقصد انجام نمیدهد. اگر آرایهی مقصد کوچکتر از طول رشتهی مبدأ (بههمراه '\0') باشد، strcpy همچنان تلاش میکند تمام کاراکترها را بنویسد و از مرزهای آرایهی مقصد عبور میکند؛ این خطا Buffer Overflow نام دارد و میتواند حافظهی متعلق به دادههای دیگر برنامه را خراب کند.
char destination[3];              // فقط ۳ خانه ظرفیت
char source[] = "Ali";            // "Ali" نیازمند ۴ خانه است (شامل '\0')

strcpy(destination, source);      // خطرناک: نوشتن خارج از محدوده destination
نکات ایمنی
همیشه باید مطمئن شویم آرایهی مقصد حداقل به اندازهی طول رشتهی مبدأ بهعلاوهی یک خانه برای '\0' ظرفیت دارد. در دورههای پیشرفتهتر با توابع و تکنیکهای امنتری برای کپی رشته آشنا خواهید شد؛ فعلاً مهمترین نکته همین است که پیش از هر strcpy، ظرفیت مقصد را آگاهانه بررسی کنید.
تمرین درون فصل ۱۳.۳
نوع تمرین: Find the Bug
char dest[4];
char src[] = "Ali";
strcpy(dest, src);
آیا این کد صحیح است؟ ظرفیت dest (۴ خانه) را با نیاز واقعی src (شامل '\0') مقایسه کنید و توضیح دهید چرا این کد برخلاف ظاهرش، بدون Buffer Overflow کار میکند.
تمرینهای پایانی زیربخش : strcpy
★ سطح پایه
Predict the Output:
char dest[10] = "XXXXXXXXX";
char src[] = "Hi";
strcpy(dest, src);
printf("%s\n", dest);
آیا خروجی Hi است یا HiXXXXXXX؟ توضیح دهید چرا strcpy محتوای قبلی dest را بعد از کاراکترهای کپیشده پاک نمیکند، اما %s همچنان فقط Hi را چاپ میکند. بهصورت مفهومی، حافظهی dest بعد از این عملیات چیزی شبیه این است:
H i \0 X X X X X X Xیعنی strcpy فقط رشتهی src را از ابتدای dest کپی میکند و '\0' را درست بعد از آن مینویسد؛ کاراکترهای قدیمی بعد از این '\0' همچنان در حافظه باقی ماندهاند، اما %s فقط تا رسیدن به همان '\0' را بهعنوان رشته چاپ میکند.
★★ سطح متوسط
Find the Bug:
char dest[5];
char src[] = "Hello";
strcpy(dest, src);
خطای این کد را پیدا کرده و دقیقاً بگویید چند بایت کم دارد.
★★★ سطح چالشی
Small Implementation:
بدون استفاده ازstrcpy، تابعی بنویسید که با پیمایش دستی، محتوای یک رشته را (شامل'\0') در آرایهای دیگر کپی کند.
13.5 تابع strcmp: مقایسه رشتهها
تابعstrcmp چیست؟
برای مقایسهی محتوای دو C String (یعنی اینکه آیا از نظر کاراکترها با هم برابرند یا کدامیک از نظر الفبایی زودتر میآید) از تابع strcmp (از کتابخانهی <string.h>) استفاده میشود:
%%writefile src/p05_c13_03_strcmp.c

#include <stdio.h>
#include <string.h>

int main(void)
{
    char str1[] = "Ali";
    char str2[] = "Ali";

    if (strcmp(str1, str2) == 0) {
        printf("Equal\n");
    } else {
        printf("Not equal\n");
    }

    return 0;
}!gcc -Wall -o bin/p05_c13_03_strcmp src/p05_c13_03_strcmp.c && ./bin/p05_c13_03_strcmpEqual
مقدار بازگشتی strcmp
تابع strcmp کاراکتر به کاراکتر دو رشته را مقایسه میکند و یکی از سه حالت زیر را برمیگرداند:
صفر: اگر دو رشته کاملاً یکسان باشند.
عددی کوچکتر از صفر: اگر رشتهی اول از نظر ترتیب واژهای (Lexicographic) قبل از رشتهی دوم باشد.
عددی بزرگتر از صفر: اگر رشتهی اول از نظر ترتیب واژهای بعد از رشتهی دوم باشد.
تابعstrcmp رشتهها را بهصورت واژهای (lexicographically) بر اساس مقادیر کاراکترهای آنها مقایسه میکند؛ بنابراین این ترتیب لزوماً همان ترتیب الفبایی انسانی نیست.
strcmp("Ali", "Ali"); // 0 → برابرند
strcmp("Ali", "Bahram"); // منفی → "Ali" زودتر از "Bahram" میآید
strcmp("Bahram", "Ali"); // مثبت → "Bahram" بعد از "Ali" میآیدنکتهی مهم: مقدار دقیق بازگشتی (مثلاً -1 یا -2) به Implementation بستگی دارد و نباید روی آن حساب باز کرد؛ تنها چیزی که تضمینشده است، علامت (مثبت، منفی، یا صفر) نتیجه است. به همین دلیل هم در کد بالا فقط با == 0 بررسی میکنیم که آیا برابرند یا نه، نه مقدار دقیق آن.
از نظر Complexity، strcmp بهمحض رسیدن به اولین کاراکتر متفاوت (یا به '\0' یکی از دو رشته) متوقف میشود؛ در بدترین حالت وقتی دو رشته کاملاً یکسان یا فقط در آخرین کاراکتر متفاوت باشند باید تقریباً تمام کاراکترها بررسی شوند، پس Worst-case برابر O(n) است (که n طول رشتهی کوتاهتر یا تعداد کاراکترهای مشترک است).
چرا == برای مقایسه محتوای رشته کار نمیکند؟
حالا که strcmp را میشناسیم، ارزش دارد ببینیم چرا اصلاً نمیتوان بهجای آن از == استفاده کرد؛ یکی از رایجترین اشتباهات دانشجویان تازهکار همین است:
char str1[] = "Ali";
char str2[] = "Ali";

if (str1 == str2) {      // این مقایسه محتوای رشته نیست!
    printf("Equal\n");
}
عبارت str1 == str2 محتوای دو رشته را مقایسه نمیکند؛ در این عبارت، نام آرایهها به اشارهگر به اولین عنصرشان تبدیل میشوند و دو آدرس با هم مقایسه میشوند. چون str1 و str2 در واقع نام دو آرایهی متفاوت هستند و در زمینهی این مقایسه، به آدرس شروع هرکدام تنزل پیدا میکنند (همان Array Decay که در فصل ۱۱ دیدیم)، در این مثال نتیجه false است. عبارت str1 == str2 یعنی «آیا این دو آرایه در یک آدرس حافظه شروع میشوند؟» نه «آیا محتوای این دو رشته یکسان است؟» و از آنجا که str1 و str2 دو آرایهی جداگانهاند، آدرسهای آنها متفاوت است، حتی اگر محتوایشان کاملاً یکسان باشد. به همین دلیل همیشه باید برای مقایسهی محتوای دو رشته از strcmp استفاده کرد، نه ==.
تمرینهای پایانی زیربخش: strcmp
★ سطح پایه
Predict the Output:
برای هرکدام از فراخوانیهای زیر، فقط علامت (مثبت / منفی / صفر) نتیجه را پیشبینی کنید:
strcmp("apple", "banana");
strcmp("banana", "apple");
strcmp("apple", "apple");
★★ سطح متوسط
Find the Bug:
if (strcmp(str1, str2) == 1) {
    printf("Equal\n");
}
خطای مفهومی این کد چیست؟ چرا نباید فرض کنیم مقدار بازگشتی برابری دقیقاً 1 یا -1 است؟ اصلاح کنید.
Explain Why:
توضیح دهید چراstrcmp("Apple", "apple")مقداری غیر صفر برمیگرداند، با وجود اینکه هر دو کلمه از نظر معنایی «یکسان» بهنظر میرسند. (راهنمایی: به کدهای ASCII حروف بزرگ و کوچک فکر کنید.)
★★★ سطح چالشی
Design:
با استفاده ازstrcmp، تابعی بنویسید که سه رشته دریافت کند و رشتهای را که از نظر الفبایی زودتر از دو رشتهی دیگر میآید برگرداند.
13.6 تابع strcat: اتصال رشتهها
مفهوم اتصال (Concatenation)
تابع strcat(dest, src) محتوای src را به انتهای dest میچسباند (درست قبل از '\0' قبلی dest، و '\0' جدید در انتهای نتیجه قرار میگیرد). از نظر Complexity، strcat ابتدا باید طول dest را برای پیدا کردن '\0' بپیماید و سپس کاراکترهای src را کپی کند، پس زمان اجرای آن متناسب با هر دو طول است یعنی O(length(dest) + length(src)).
%%writefile src/p05_c13_04_strcat.c

#include <stdio.h>
#include <string.h>

int main(void)
{
    char fullName[30] = "Ali";
    strcat(fullName, " Rezaei");

    printf("%s\n", fullName);   // خروجی: Ali Rezaei

    return 0;
}!gcc -Wall -o bin/p05_c13_04_strcat src/p05_c13_04_strcat.c && ./bin/p05_c13_04_strcatAli Rezaei
ظرفیت مقصد
درست مانند strcpy، تابع strcat هم هیچ بررسیای روی ظرفیت dest انجام نمیدهد. dest باید از ابتدا بهاندازهی کافی برای نگهداشتن محتوای فعلی خودش بهعلاوهی محتوای src بهعلاوهی یک '\0' پایانی، ظرفیت داشته باشد.
خطاهای رایج
❌ اشتباه: ظرفیت ناکافی برای strcat
char firstName[5] = "Ali";     // فقط ۵ خانه ظرفیت
strcat(firstName, " Rezaei");  // نیاز به فضای بسیار بیشتر از ۵ خانه دارد
چرا اشتباه است؟
رشته first_name فقط ۵ خانه ظرفیت دارد که برای نگهداشتن "Ali" (۴ خانه شامل '\0') بهسختی کافی است؛ اتصال " Rezaei" به آن قطعاً باعث Buffer Overflow میشود.
✅ نسخه صحیح
char firstName[30] = "Ali";
strcat(firstName, " Rezaei");
چرا صحیح است؟
ظرفیت ۳۰ خانهای بهاندازهی کافی بزرگ است تا هم "Ali" و هم " Rezaei" و هم '\0' پایانی را در خود جای دهد.
تمرین درون فصل ۱۳.۴
نوع تمرین: Find the Bug
char message[10];
strcpy(message, "Hello World");
خطای این کد را توضیح دهید.
تمرینهای پایانی زیربخش: strcat
★ سطح پایه
Predict the Output:
خروجی کد زیر را پیشبینی کنید.
char greeting[20] = "Hello";
strcat(greeting, ", World!");
printf("%s\n", greeting);
★★ سطح متوسط
Find the Bug:
char a[6] = "Hello";
char b[] = "!";
strcat(a, b);
ظرفیت a را دقیقاً محاسبه کنید ("Hello" نیازمند ۶ خانه شامل '\0' است) و توضیح دهید چرا اضافه کردن حتی یک کاراکتر دیگر باعث Buffer Overflow میشود.
Explain Why:
توضیح دهید چراstrcatباید ابتدا'\0'انتهایdestرا پیدا کند قبل از اینکه بتواند شروع به نوشتن کاراکترهایsrcکند. این یعنیstrcatاز نظر Complexity به طول هر دو رشته وابسته است، نه فقط طولsrc.
★★★ سطح چالشی
Small Implementation:
بدون استفاده ازstrcat، تابعی بنویسید که با پیمایش دستی، محتوای رشتهی دوم را به انتهای رشتهی اول اضافه کند (فرض کنید ظرفیت رشتهی اول کافی است).Debugging Reasoning:
برنامهای دارید که بهصورت متناوب و در یک حلقه، چند بارstrcatرا روی همان آرایهی مقصد فراخوانی میکند تا چند کلمه را به هم بچسباند. بدون اجرای برنامه، توضیح دهید چرا این الگو مستعد Buffer Overflow است اگر اندازهی نهایی رشته از قبل تخمین زده نشده باشد.
13.7 خطاهای رایج در کار با String (جمعبندی)
استفاده از
==بهجایstrcmpبرای مقایسهی محتوای دو رشته.فراموش کردن اینکه آرایهی مقصد باید فضای کافی برای
'\0'هم داشته باشد.اشتباه گرفتن
sizeof(اندازهی کل آرایه) باstrlen(طول محتوای واقعی).استفاده از
strcpyیاstrcatبدون اطمینان از ظرفیت کافی مقصد، که منجر به Buffer Overflow میشود.
13.8 کاربردهای واقعی String
ذخیرهی نام کاربران و رمزهای عبور (در سطح مفهومی؛ ذخیرهی امن رمز عبور نیازمند تکنیکهای دیگری فراتر از این درس است).
پردازش متن ورودی کاربر در برنامههای خطفرمان.
خواندن و نوشتن محتوای فایلهای متنی.
تولید پیامهای خروجی پویا (مثل اتصال نام و نامخانوادگی).
13.9 Array of Strings : اتصال Arrays و Strings
تا اینجا هر رشته را در یک آرایهی جداگانهی char نگه داشتهایم (مثلاً یک آرایه برای نام یک دانشجو). اما در سیستم مدیریت نمرات، معمولاً به فهرستی از نامها با هم نیاز داریم؛ یعنی «آرایهای که هر عضوش خودش یک رشته است». برای این کار میتوانیم دقیقاً از همان مفهوم آرایهی دوبعدی که در فصل ۱۱ دیدیم استفاده کنیم، با این تفاوت که نوع عناصر آن char است:
char names[5][20];این خط یک آرایهی دوبعدی از char تعریف میکند: ۵ سطر و ۲۰ ستون. نکتهی کلیدی این است که هر سطر این آرایه (یعنی names[i]) خودش یک آرایهی ۲۰خانهای از char است؛ دقیقاً همان چیزی که در فصل ۱۳ بهعنوان «رشته» شناختیم. پس names[0] رشتهی اول است، names[1] رشتهی دوم است، و به همین ترتیب. درست مثل هر رشتهی دیگری که تا اینجا دیدیم، هر سطر هم باید '\0' داشته باشد تا یک C String معتبر باشد؛ تنها تفاوت این است که حالا ۵ رشتهی مستقل، هرکدام با '\0' خودشان، کنار هم و زیر یک نام واحد قرار گرفتهاند.
مقداردهی و دسترسی
%%writefile src/p05_c13_05_array_of_strings.c

#include <stdio.h>
#include <string.h>

int main(void)
{
    char names[5][20] = {"Ali", "Sara", "Reza", "Mina", "Hasan"};

    for (int i = 0; i < 5; i++) {
        printf("%s\n", names[i]);
    }

    return 0;
}!gcc -Wall -o bin/p05_c13_05_array_of_strings src/p05_c13_05_array_of_strings.c && ./bin/p05_c13_05_array_of_stringsAli
Sara
Reza
Mina
Hasan
اینجا names[i] یک رشتهی کامل است (نه یک کاراکتر تنها)، پس با %s چاپ میشود؛ دقیقاً مثل هر متغیر رشتهای دیگر. توجه کنید strcpy(names[2], "Jafar") هم معتبر است، چون names[2] یک آرایهی char با ظرفیت ۲۰ خانه است و میتواند مقصد strcpy باشد.
جستجوی یک نام با strcmp
چون هر عنصر این آرایه یک رشته است، نمیتوان از == برای مقایسه استفاده کرد (همان دلیلی که در ۱۳.۵ دیدیم) و باید از strcmp استفاده کنیم:
int findName(char names[][20], int n, const char target[])
{
    for (int i = 0; i < n; i++) {
        if (strcmp(names[i], target) == 0) {
            return i;
        }
    }
    return -1;
}
این تابع دقیقاً همان الگوی Linear Search فصل ۱۲ است، با یک تفاوت: بهجای arr[i] == target، از strcmp(names[i], target) == 0 استفاده میکند، چون هدف مقایسهی محتوای دو رشته است، نه محتوای دو عدد.
Trace کوتاه
برای names = {"Ali", "Sara", "Reza"} و target = "Reza":
i=0: strcmp("Ali", "Reza")  → غیر صفر → ادامه بده
i=1: strcmp("Sara", "Reza") → غیر صفر → ادامه بده
i=2: strcmp("Reza", "Reza") → صفر → پیدا شد در اندیس 2نکتهی مهم دربارهی Scope: آنچه در این بخش لازم است همین سطح از درک است؛ آرایهای که هر سطرش یک رشته است، و پیمایش/جستجوی آن با ابزارهایی که قبلاً یاد گرفتیم. جزئیات پیشرفتهتر (مثل اشارهگر به اشارهگر یا char **) خارج از سرفصل این درس است و در دورههای بعدی که با اشارهگرها بهطور کامل آشنا میشوید، به آن بازخواهید گشت.
تمرینهای پایانی فصل ۱۳
توجه: این تمرینها با آنچه در تمرینهای زیربخش دیدید تفاوت دارند و بیشتر چند مفهوم را با هم ترکیب میکنند.
Predict the Output + Explain:
خروجی کد زیر را پیشبینی کنید و توضیح دهید چرا مقدار دقیق عددی مهم نیست، فقط علامت آن:
char a[] = "Data";
char b[] = "Data";
printf("%d\n", strcmp(a, b));
Write Pseudocode:
بدون استفاده ازstrlen، Pseudocode یک تابع بنویسید که طول یک رشته را با پیمایش دستی تا رسیدن به'\0'محاسبه کند.Convert Pseudocode to C:
Pseudocode بخش قبل را به کد C واقعی تبدیل کنید.Edge Case Reasoning:
برای هرکدام از موارد زیر توضیح دهیدstrlenچه مقداری برمیگرداند:
رشتهی خالی
""رشتهی یکحرفی
"x"رشتهای که فقط از فاصله (space) تشکیل شده مثل
" ".
Design + Implementation:
تابعی بنویسید که یک آرایه از نامهای دانشجویان (آرایهای از رشتهها) دریافت کند و با استفاده ازstrcmp، نامهایی را که از نظر الفبایی زودتر از یک نام مرجع میآیند شمارش کند.Debugging Reasoning:
فرض کنید کدی رشتهای را از ورودی کاربر باscanf("%s", buffer)در یک آرایهی با ظرفیت ثابت میخواند، اما هرگز طول ورودی کاربر را محدود نمیکند. بدون نیاز به دانستن جزئیاتscanf، توضیح دهید چرا این الگو از نظر مفهومی همان خطر Buffer Overflow را دارد که درstrcpyدیدیم.Compare Approaches:
برایchar name[20] = "Ali";، مقدارsizeof(name)وstrlen(name)را جداگانه مشخص کنید و توضیح دهید این دو عدد در چه شرایطی میتوانند با هم برابر شوند.Small Implementation:
تابعی بنویسید که دو نام کوچک و نامخانوادگی را (هرکدام یک رشتهی جداگانه) دریافت کند و با ترکیب دستیstrlen،strcpy، وstrcat، یک رشتهی نام کامل (با یک فاصله بین آنها) در یک آرایهی مقصد با ظرفیت کافی بسازد.Trace:
برایchar names[4][10] = {"Sara", "Ali", "Reza", "Mina"};وtarget = "Ali"، مراحلfind_name(بخش ۱۳.۹) را دستی دنبال کنید و بنویسید در کدام iteration و با کدام مقایسهیstrcmpنتیجه پیدا میشود.
Retrieval Practice فصل ۱۳
بدون نگاه به متن، توضیح دهید چرا
str1 == str2روش درستی برای مقایسهی محتوای دو رشته نیست.تفاوت
'\0'و'0'را در یک جمله توضیح دهید.چرا
strlenیک رشتهی بدون'\0'معتبر، رفتار نامشخص از خود نشان میدهد؟تفاوت
sizeof(name)وstrlen(name)روی یک آرایهی کاراکتری چیست؟چرا
strcpyوstrcatمیتوانند باعث Buffer Overflow شوند؟چرا
char name[3] = {'A', 'l', 'i'};یک C String معتبر نیست؟در
char names[5][20]، عبارتnames[i]دقیقاً به چه معناست؟
جمعبندی بخش پنجم
نقشه مفهومی
متغیر معمولی
│
▼
Array
(Index از صفر شروع میشود)
│
┌───────────────┼────────────────┐
▼ ▼ ▼
Traversal Multidim Array Character Array
│ (Matrix) │
┌─────────┴─────────┐ ▼
▼ ▼ '\0' + String
Search Sort │
│ │ ┌─────────┼─────────┐
▼ ▼ ▼ ▼ ▼
Linear Search Bubble/Selection/ strlen strcpy strcmp/strcat
│ Insertion Sort
│ │
│ ▼
│ Sorted Array
│ │
└───────────────────┴──────► Binary Search (O(log n))هر پیکان در این نقشه یک وابستگی مفهومی نشان میدهد: Search و Sort هر دو روی مفهوم Traversal بنا شدهاند؛ Binary Search به یک آرایهی از قبل مرتبشده نیاز دارد که محصول Sort است؛ و String چیزی نیست جز یک کاربرد خاص از همان مفهوم Array که در ابتدای فصل یاد گرفتیم.
جدول مرور سریع
| مفهوم | نکته کلیدی | Complexity (در صورت وجود) |
|---|---|---|
| Array | اندیس از صفر شروع میشود؛ حافظه پیوسته است | دسترسی به یک عنصر: O(1) |
| Array + Function | آرایه به اشارهگر تنزل پیدا میکند (Array Decay)؛ اندازه را جدا پاس بده | - |
| Multidim Array | Row-Major Order در حافظه | پیمایش کامل: O(m×n) |
| Linear Search | نیازی به مرتب بودن ندارد | O(n) |
| Binary Search | فقط روی آرایهی مرتب؛ هر مرحله نیمی از فضا حذف میشود | O(log n) |
| Bubble Sort | مقایسه و جابجایی عناصر مجاور | O(n²)، بهترین حالت با Flag: O(n) |
| Selection Sort | پیدا کردن کوچکترین و یک جابجایی در پایان هر Pass | همیشه O(n²) |
| Insertion Sort | قرار دادن هر عنصر در جای درست در بخش مرتب | O(n²)، بهترین حالت: O(n) |
| String | آرایهای از char که با '\0' تمام میشود | strlen: O(n) |
| strcpy | کپی src (شامل '\0') در dest؛ بدون بررسی ظرفیت مقصد | O(n) - متناسب با طول src |
| strcmp | مقایسهی محتوای دو رشته با استفاده از علامت نتیجه (نه مقدار دقیق) | Worst-case: O(n) |
| strcat | اتصال src به انتهای dest؛ بدون بررسی ظرفیت مقصد | O(length(dest) + length(src)) |
Retrieval Practice جامع بخش پنجم
اگر آرایهای ۸ عنصر داشته باشد، آخرین اندیس معتبر آن چیست؟
چرا باید اندازهی آرایه را هنگام پاس دادن به تابع، جداگانه ارسال کرد؟
چرا Binary Search روی آرایهی نامرتب قابلاستفاده نیست؟
چرا Insertion Sort روی دادهی تقریباً مرتب سریعتر از حالت نظری
O(n²)عمل میکند؟چرا
str1 == str2روش درستی برای مقایسهی محتوای دو رشته نیست؟
تمرینهای نهایی بخش پنجم
توجه: این تمرینها با مثالهای داخل درس متفاوتاند و نیازمند ترکیب چند مفهوم هستند.
Level 1 : Fundamental
آرایهای از ۱۰ عدد صحیح تعریف کنید، آن را با مقادیر دلخواه مقداردهی کنید، و مجموع اعداد زوج داخل آن را چاپ کنید.
تابعی بنویسید که یک رشته دریافت کند و بدون استفاده از
strlen، تعداد کاراکترهای آن را برگرداند.با استفاده از Linear Search، اندیس اولین عدد منفی در یک آرایه را پیدا کنید (اگر عدد منفی وجود نداشت،
-1برگردانید).
Level 2 : Intermediate
آرایهای از نمرات دانشجویان را با Selection Sort مرتب کنید، سپس با Binary Search بررسی کنید آیا نمرهی مشخصی در آن وجود دارد یا نه.
تابعی بنویسید که دو رشته دریافت کند و بدون استفاده از
strcat، رشتهی دوم را به انتهای رشتهی اول بچسباند (با پیمایش دستی).آرایهی دوبعدی نمرات (دانشجو × کوییز) را دریافت کرده و برای هر دانشجو مشخص کنید آیا میانگین او بالای ۱۵ است یا نه.
Level 3 : Advanced
برنامهای بنویسید که فهرستی از نام دانشجویان (آرایهای از رشتهها) را با استفاده از
strcmpبه ترتیب الفبایی مرتب کند (با یکی از الگوریتمهای مرتبسازی این فصل، تطبیقدادهشده برای مقایسهی رشته بهجای عدد).تابعی بنویسید که بررسی کند آیا یک آرایه از قبل مرتب است یا نه (بدون مرتب کردن آن)، و از آن برای تصمیمگیری بین استفاده از Linear Search یا Binary Search استفاده کنید.
Level 4 : Challenge
سیستمی طراحی کنید که نام و نمرهی ۱۰ دانشجو را در دو آرایهی موازی (یک آرایهی رشته برای نامها، یک آرایهی عدد برای نمرات) نگه دارد، آنها را بر اساس نمره مرتب کند (بهطوریکه نام و نمرهی متناظر همزمان جابجا شوند)، و در نهایت امکان جستجوی نام یک دانشجو و نمایش نمرهی او را با Linear Search فراهم کند.
Final Challenge : مسئله جامع بخش پنجم
سیستم مدیریت نمرات کلاس
برنامهای بنویسید که:
نام و نمرهی ۵ دانشجو را در دو آرایهی موازی ذخیره کند (نامها بهصورت آرایهای از رشتهها؛ مثلاً
char names[5][20]، همان الگوی بخش ۱۳.۹ و نمرات بهصورت آرایهای از اعداد صحیح).میانگین کل کلاس را محاسبه و چاپ کند.
دانشجویان را بر اساس نمره به ترتیب نزولی مرتب کند (نامها هم باید همزمان با نمرات جابجا شوند تا تناظر حفظ شود).
از کاربر یک نام دریافت کند و با استفاده از
strcmpو Linear Search، نمرهی آن دانشجو را پیدا و چاپ کند (یا پیام «یافت نشد» را نمایش دهد).با استفاده از Binary Search روی آرایهی نمرات مرتبشده، بررسی کند آیا نمرهی خاصی (مثلاً ۱۸) در بین نمرات وجود دارد.
این مسئله عمداً چند مفهوم فصل را ترکیب میکند: دانشجو باید تشخیص دهد که برای مرتبسازی موازی، هر جابجایی باید همزمان روی هر دو آرایه (نام و نمره) اعمال شود؛ که برای جستجوی نام باید از strcmp (نه ==) استفاده شود؛ و که Binary Search فقط بعد از مرتبسازی معنا دارد.
پیش از دیدن راهحل، سعی کنید مسئله را خودتان تحلیل و پیادهسازی کنید. اگر گیر کردید، از راهنماییهای زیر بهترتیب استفاده کنید:
Hint 1:
برای مرتبسازی موازی، از یکی از الگوریتمهای همین فصل (مثلاً Selection Sort) روی آرایهی نمرات استفاده کنید، اما هر بار که دو نمره جابجا میشوند، بلافاصله همان دو اندیس را در آرایهی نامها هم جابجا کنید؛ یعنی دو swap همزمان، نه یک swap.
Hint 2:
برای جستوجوی نام دانشجو، بهجای ==، از strcmp(names[i], inputName) == 0 در یک حلقهی Linear Search استفاده کنید؛ چون آرایهی نامها بعد از مرتبسازی بر اساس نمره مرتب شده، نه بر اساس نام، پس جستوجوی نام همچنان باید Linear باشد، نه Binary.
Hint 3:
برای بررسی وجود یک نمرهی خاص با Binary Search، باید حتماً آرایهی نمرات (که در مرحلهی ۳ مرتب کردهاید) را به binarySearch بدهید؛ نه آرایهی نامها که اصلاً عددی نیست.
با پایان این بخش، شما اکنون ابزارهای پایهای برای نگهداری مجموعهداده (Array)، پیدا کردن یک مقدار در آن (Search)، مرتب کردن آن (Sort)، و کار با دادهی متنی (String) را در اختیار دارید. این چهار مفهوم پایهی بسیاری از برنامههای واقعیتری هستند که در ترمهای بعدی با آنها روبهرو خواهید شد.
نگاهی به یک دانشمند تأثیرگذار در این حوزه
خب، حالا که با مفهوم آرایهها، جستوجو و مرتبسازی آشنا شدیم، بد نیست کمی هم با دانشمندی آشنا شویم که یکی از الگوریتمهای مشهور مرتبسازی را در پاسخ به یک مسئلهی واقعی به وجود آورد.
تونی هور (Tony Hoare)، دانشمند علوم کامپیوتر بریتانیایی، در سال ۱۹۵۹ زمانی که در دانشگاه دولتی مسکو مشغول مطالعهی ترجمهی ماشینی بود، با مسئلهای مواجه شد که ارتباط جالبی با مطالب همین فصل داشت. برای ترجمهی واژههای یک جملهی روسی، لازم بود واژهها به ترتیبی مرتب شوند که بتوان آنها را به شکل کارآمدتری در یک فرهنگ لغت ذخیرهشده روی نوار مغناطیسی پیدا کرد.
هور ابتدا به سراغ روشی شبیه Insertion Sort رفت، اما متوجه شد که برای دادههای بزرگ، زمان اجرای آن میتواند بهسرعت افزایش پیدا کند. همین مسئله باعث شد به دنبال روش سریعتری برای مرتبسازی باشد و ایدهای را مطرح کند که بعدها با نام Quicksort شناخته شد. او این الگوریتم را نخستینبار در سال ۱۹۶۱ منتشر کرد و مقالهی مفصلتر آن نیز در سال ۱۹۶۲ منتشر شد.
جالب است که اگر به کاری که در این فصل انجام دادیم نگاه کنیم، مسیر فکری هور چندان دور از آن نیست: یک مسئلهی واقعی ← بررسی روش موجود ← توجه به محدودیت آن ← پیدا کردن ایدهای برای انجام سریعتر کار. همین نگاه، یکی از بخشهای مهم تفکر الگوریتمی در علوم کامپیوتر است.
البته فعالیتهای هور به Quicksort محدود نشد. او بعدها در زمینهی زبانهای برنامهنویسی و بررسی درستی برنامهها نیز کارهای مهمی انجام داد و در سال ۱۹۸۰ جایزهی تورینگ را برای مشارکتهای بنیادی خود در تعریف و طراحی زبانهای برنامهنویسی دریافت کرد.
شاید یکی از نکات جالب این داستان این باشد که Quicksort از یک سؤال کاملاً عملی شروع شد: «چطور میتوان این دادهها را سریعتر مرتب کرد؟»
بسیاری از ایدههای مهم علوم کامپیوتر نیز دقیقاً از همین جنس سؤالها شروع میشوند؛ مسئلهای واقعی که ما را مجبور میکند روش بهتری برای حل آن پیدا کنیم.
تیم تهیه و تدوین
این بخش حاصل همکاری مجموعهای از دانشجویان، دستیاران آموزشی و ویراستاران است که هر یک بخشی از فرایند طراحی، تولید و بازبینی محتوا را بر عهده داشتهاند.
هدف از این همکاری، صرفاً گردآوری مطالب نبوده است؛ تلاش شده محتوای آموزشی از نظر دقت علمی، کیفیت کدنویسی، ساختار آموزشی، خوانایی و کاربردپذیری بهصورت مشترک بررسی و بهبود داده شود.
اعضای تیم
👤 علیرضا زارع بیدکی
نقش:
طراحی ساختار و معماری محتوای فصل
تدوین و یکپارچهسازی محتوای آموزشی
بازبینی نهایی و کنترل کیفیت مطالب
نوع مشارکت: تدوین، طراحی آموزشی و ویرایش نهایی.
👤 سجاد باقریون
نقش:
طراحی ساختار کلی مطالب
بررسی خوانایی و ارائهی مطالب
ایدهپرداز و مشاوره محتوایی
نوع مشارکت: طراحی، ایدهپردازی و مشاوره محتوایی
👤 علیرضا سالاری
نقش:
بررسی صحت و دقت مفاهیم علمی
شناسایی و اصلاح خطاهای علمی و فنی
مشارکت در بازبینی و اصلاح محتوای آموزشی
نوع مشارکت: ویراستاری علمی و کنترل کیفیت محتوا
فرایند تولید و بازبینی
تدوین این بخش حاصل یک فرایند چندمرحلهای شامل طراحی محتوا، نگارش، پیادهسازی و بررسی مثالهای C، بازبینی آموزشی، ویرایش و کنترل نهایی بوده است.
در کنار مشارکت اعضای تیم، از ابزارهای هوش مصنوعی (AI) نیز بهعنوان ابزار کمکی در بخشهایی مانند بازبینی و بهبود متن استفاده شده است. خروجیهای تولیدشده توسط AI بهعنوان محتوای نهایی تلقی نشدهاند و محتوای نهایی پس از بررسی و ویرایش اعضای تیم تنظیم شده است.
🤝 حاصل یک کار تیمی
این محتوا نتیجهی مشارکت افراد با نقشها و تخصصهای متفاوت است؛ از طراحی و نگارش محتوا گرفته تا بررسی مثالها، کدها و جزئیات آموزشی.
از تمام افرادی که در شکلگیری، بازبینی و بهبود این بخش مشارکت داشتهاند، سپاسگزاریم.